- CS231n Lecture 17 - Robot Learning reinforcement learning, model-based planning, imitation learning, vision-language-action models Robot learning은 action으로 환경을 바꾸며 장기적인 reward를 높이는 policy를 학습하는 sequential decision-making 문제이다. Supervised learning은 고정된 데이터셋의 입력 에서 label 를 예측한다.
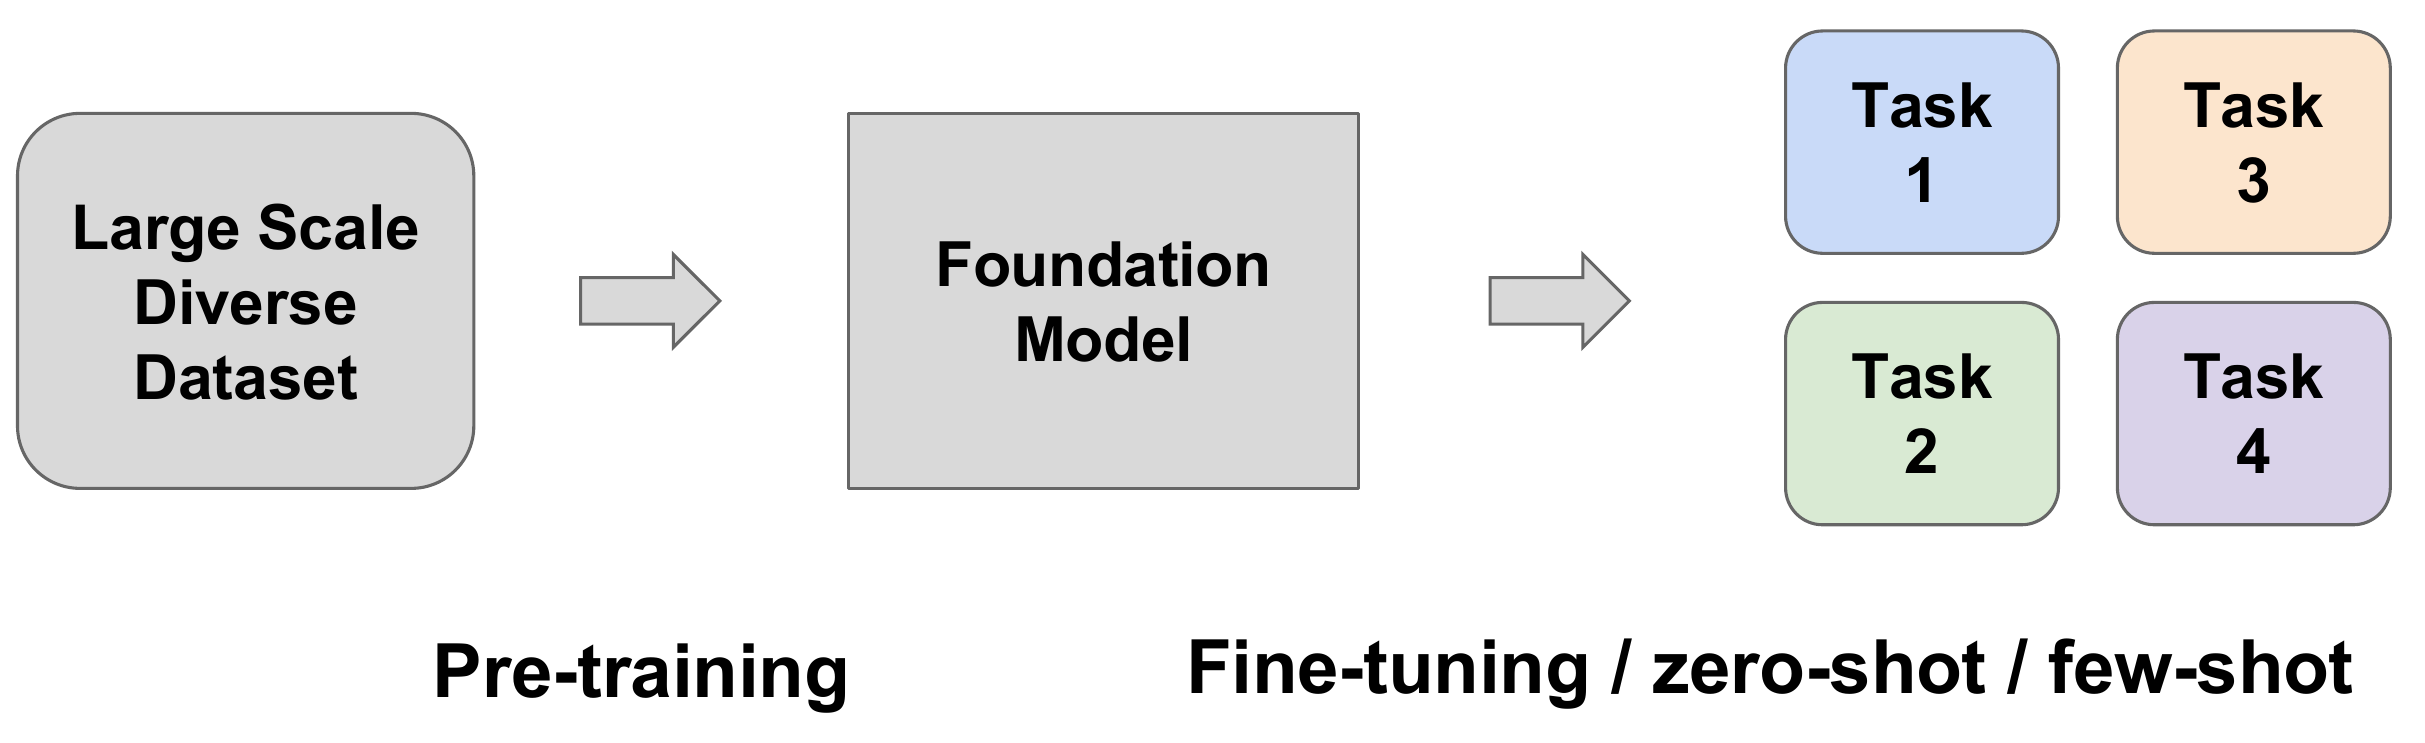
- CS231n Lecture 16 - Vision and Language CLIP, multimodal language models, grounding, model chaining Vision-language foundation model은 이미지와 텍스트를 공통 representation으로 정렬하거나 visual token을 language model의 context로 주입해 여러 과제를 하나의 pretrained model로 풀며, grounding과 promptable output, tool chaining을 더해 텍스트 응답을 실제 픽셀과 전문 vision model의 동작으로 연결한다. 전통적인 computer vision pipeline은 과제마다 데이터셋과 모델을 따로 만든다.
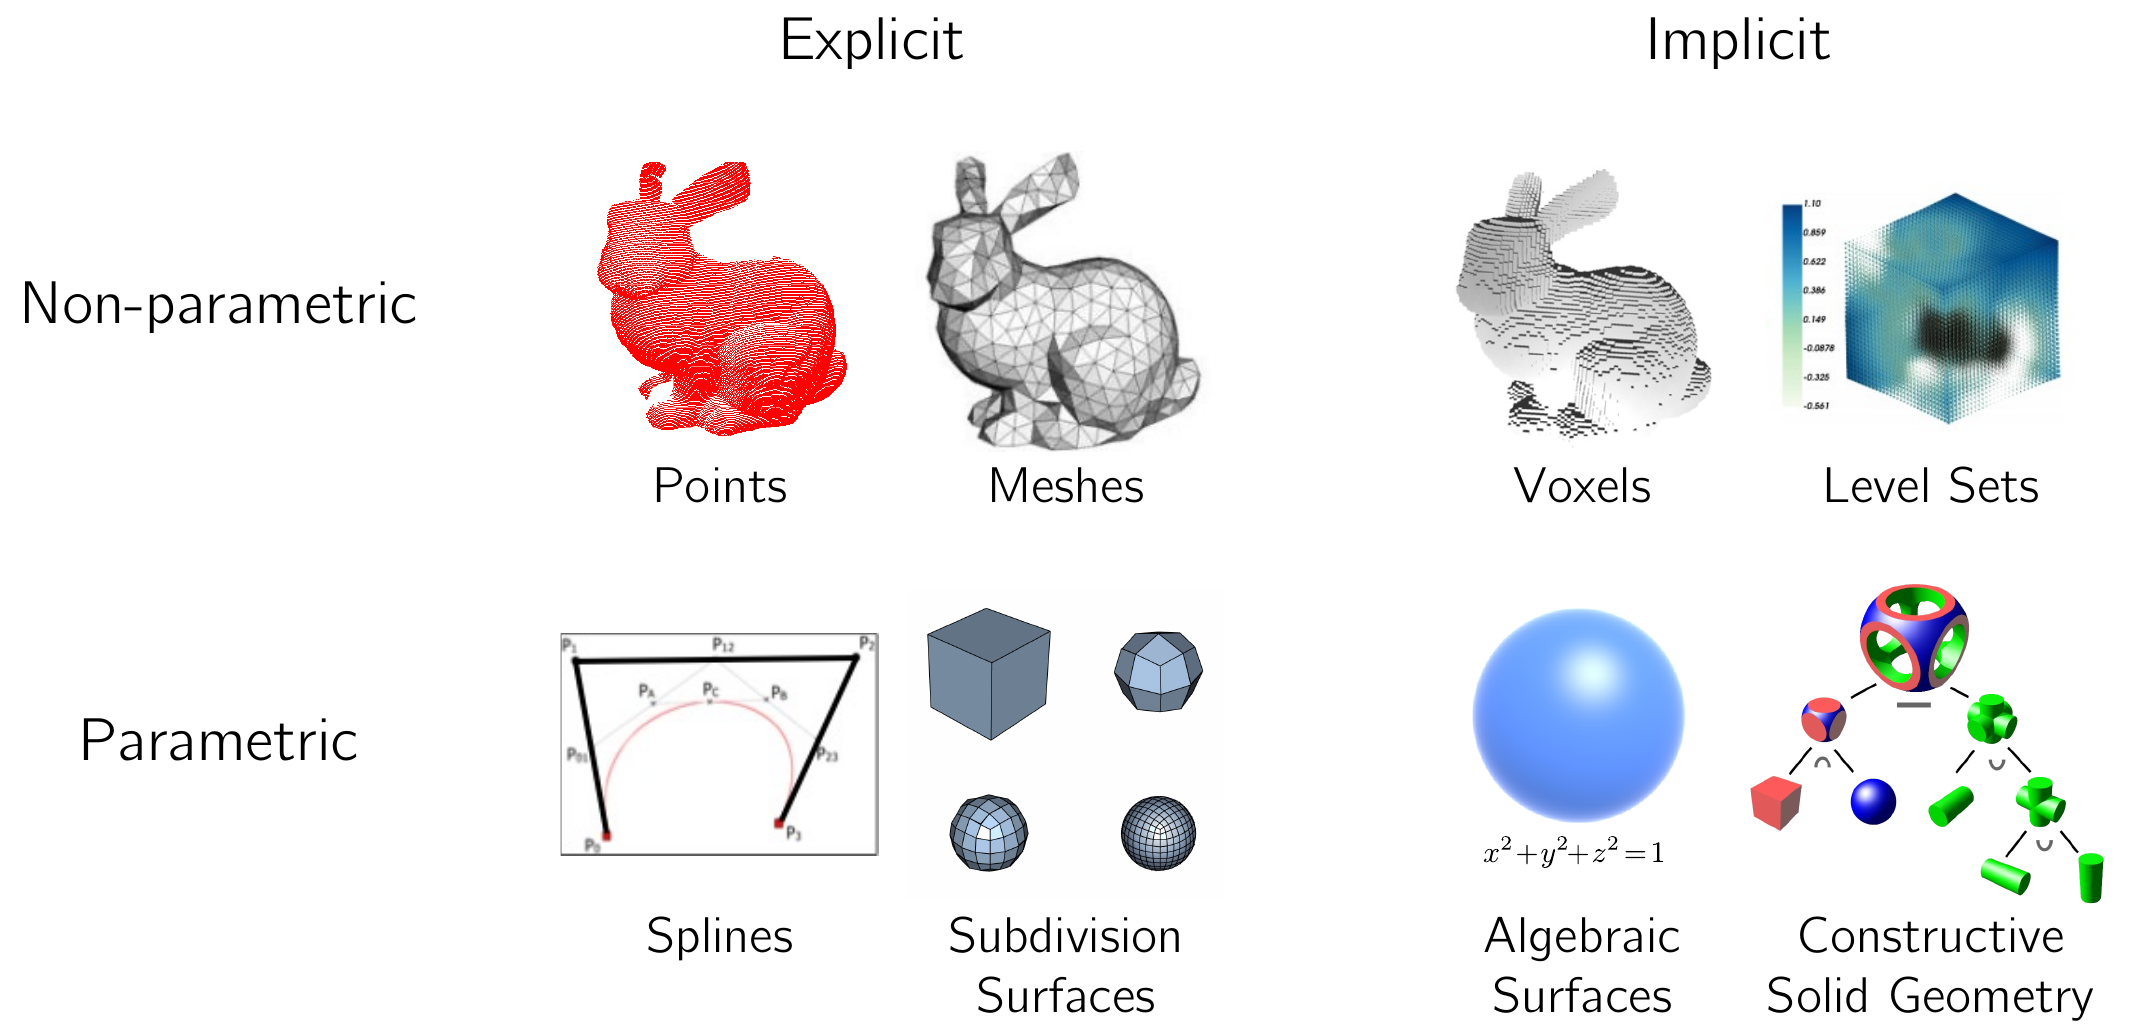
- CS231n Lecture 15 - 3D Vision 3D representations, neural fields, NeRF, Gaussian splatting 3D vision은 geometry와 appearance를 point cloud, mesh, voxel, implicit function 등으로 표현하고, 2D·3D 관측에서 이를 학습해 장면 복원과 새로운 시점의 이미지 합성에 사용한다. 2D 이미지는 보통 일정한 grid 위의 pixel tensor로 표현한다. 반면 3D 물체는 geometry뿐 아니라 질감, 재질, 조명에 따른 appearance까지 포함하며, 이를 표현하는 표준적인 형식이 하나로 정해져 있지 않다.
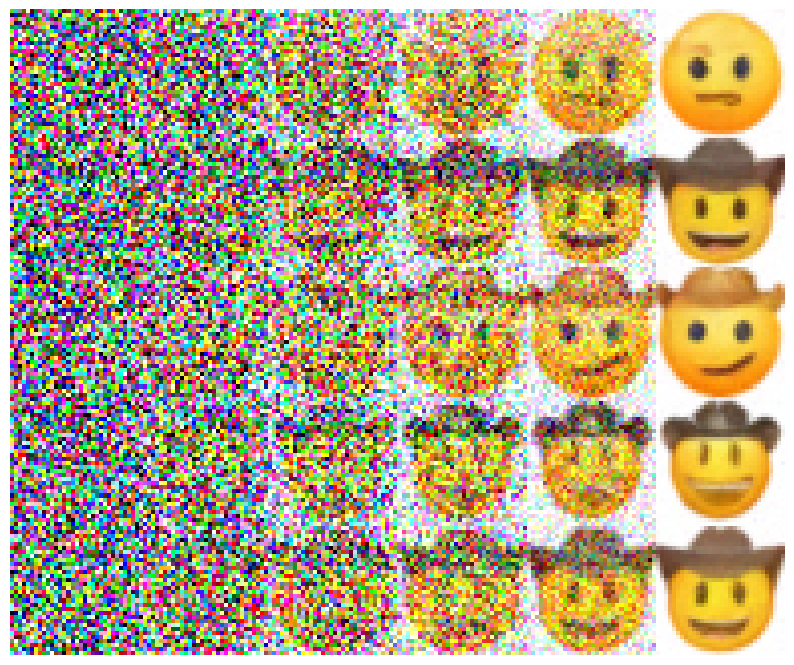
- Assignment 3-3: Denoising Diffusion Probabilistic Models Forward Diffusion, Reverse Diffusion, U-Net 기반 Noise Prediction, Reverse Sampling, Classifier-Free Guidance 구현 및 평가 이번 과제에서는 Denoising Diffusion Probabilistic Model(DDPM)의 핵심 구성요소를 구현하고, noisy image를 점진적으로 denoise하여 이미지를 생성하는 과정을 배운다. DDPM은 데이터 분포에서 바로 샘플을 생성하는 대신, 먼저 실제 이미지에 Gaussian noise를 점진적으로 추가하는 Forward Diffusion을 정의하고, 반대로 노이즈에서 이미지를 복원하는 Reverse Diffusion을 학습한다. Forward process 자체는 고정된 noise schedule에 의해 결정되며, 실제로 학습되는 부분은 각 timestep에서 noisy image를 보고 노이즈 또는 원본 이미지를 예측하는 denoising model이다. 이 denoising model로 U-Net을 사용한다.
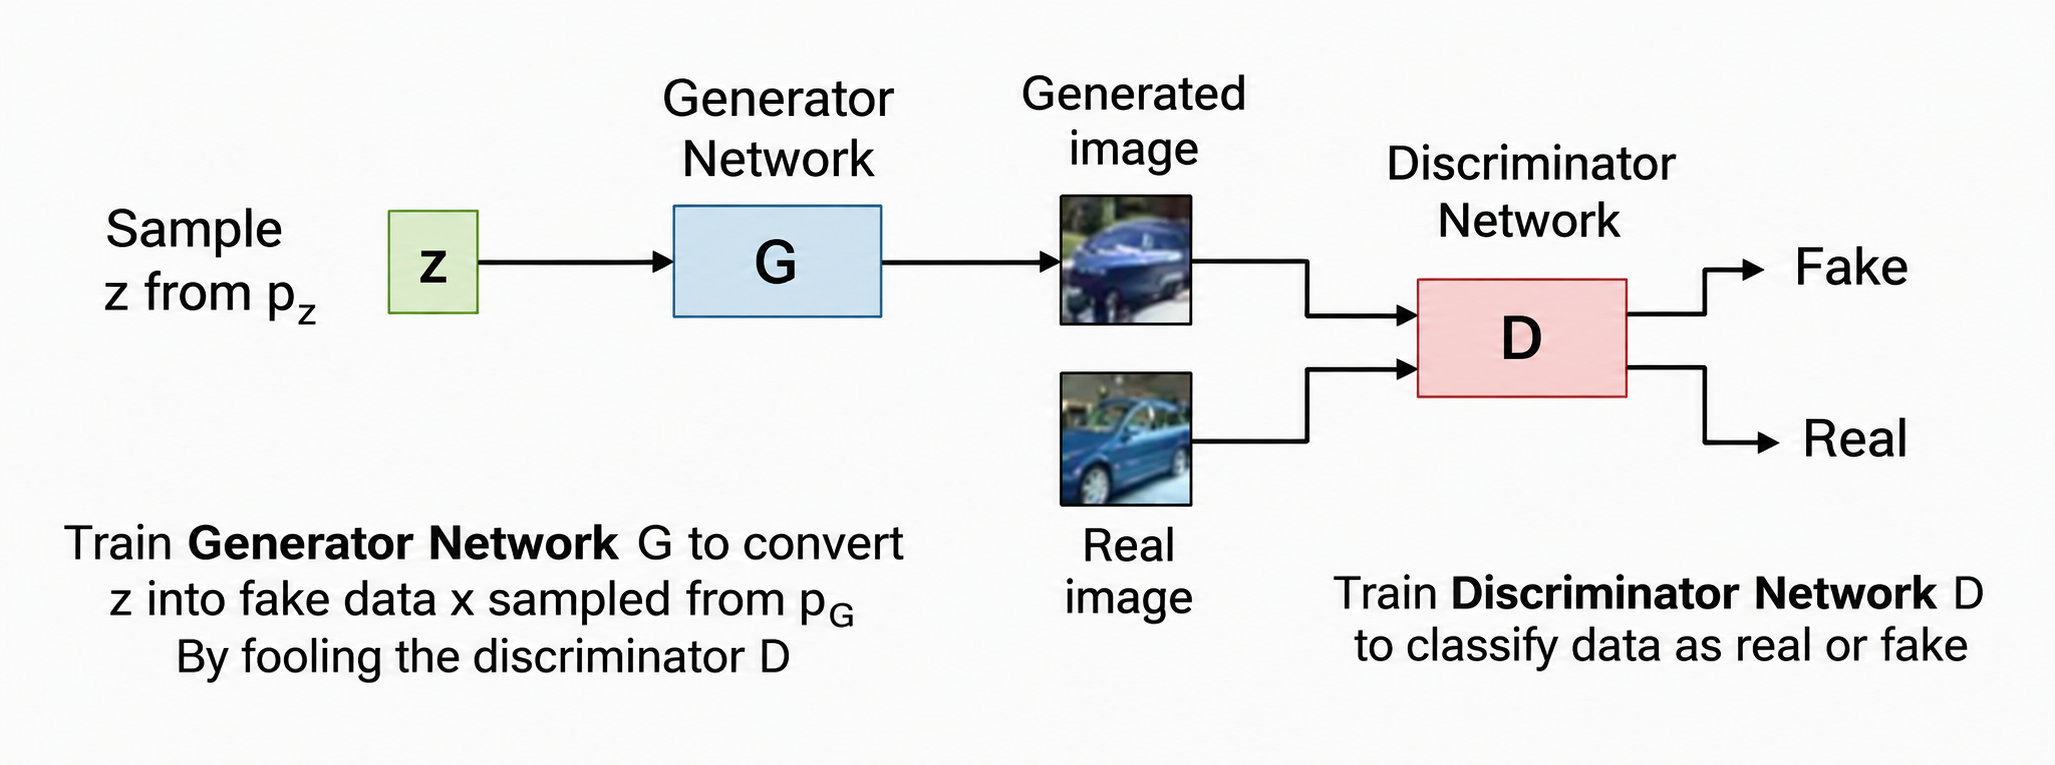
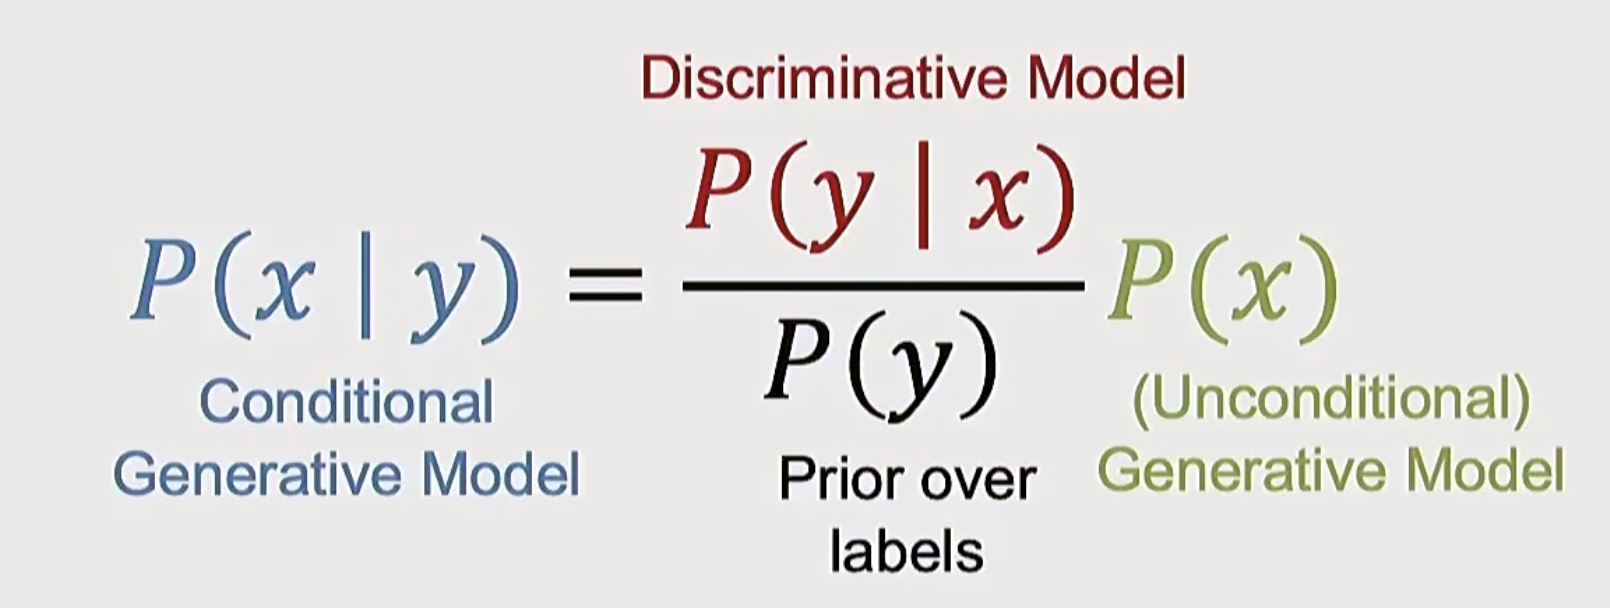
- CS231n Lecture 14 - Generative Models 2 Generative adversarial networks, rectified flow, latent diffusion GAN은 discriminator와 generator의 adversarial game으로 data distribution을 암묵적으로 맞추고, diffusion과 rectified flow는 노이즈와 데이터 사이의 경로를 학습해 반복적인 reverse process로 샘플을 생성한다. 명시적 밀도 모델(explicit density model)은 데이터 에 대한 확률밀도 를 명시적으로 정의한다. Autoregressive model은 이를 정확하게 계산하고, VAE는 로그우도의 하한인 ELBO를 계산한다.
- CS231n Lecture 13 - Generative Models 1 Maximum likelihood, autoregressive models, variational autoencoders Generative model은 data를 만든 probability distribution을 학습하는 모델이며, autoregressive model은 chain rule로 exact likelihood를 계산하고 VAE는 latent variable과 ELBO를 도입해 tractable한 lower bound로 학습한다. Supervised learning에서는 input과 target의 pair가 주어진다.
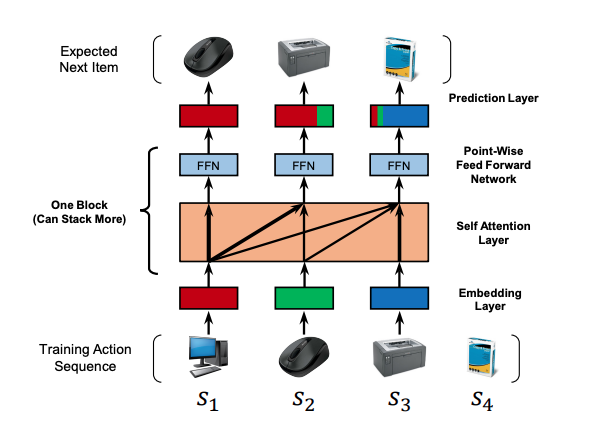
- 논문 리뷰: Self-Attentive Sequential Recommendation SASRec 리뷰 논문: Self-Attentive Sequential Recommendation 저자: Wang-Cheng Kang, Julian McAuley 학회: IEEE International Conference on Data Mining (ICDM) 연도: 2018 논문 링크: arXiv:1808.09781 ---
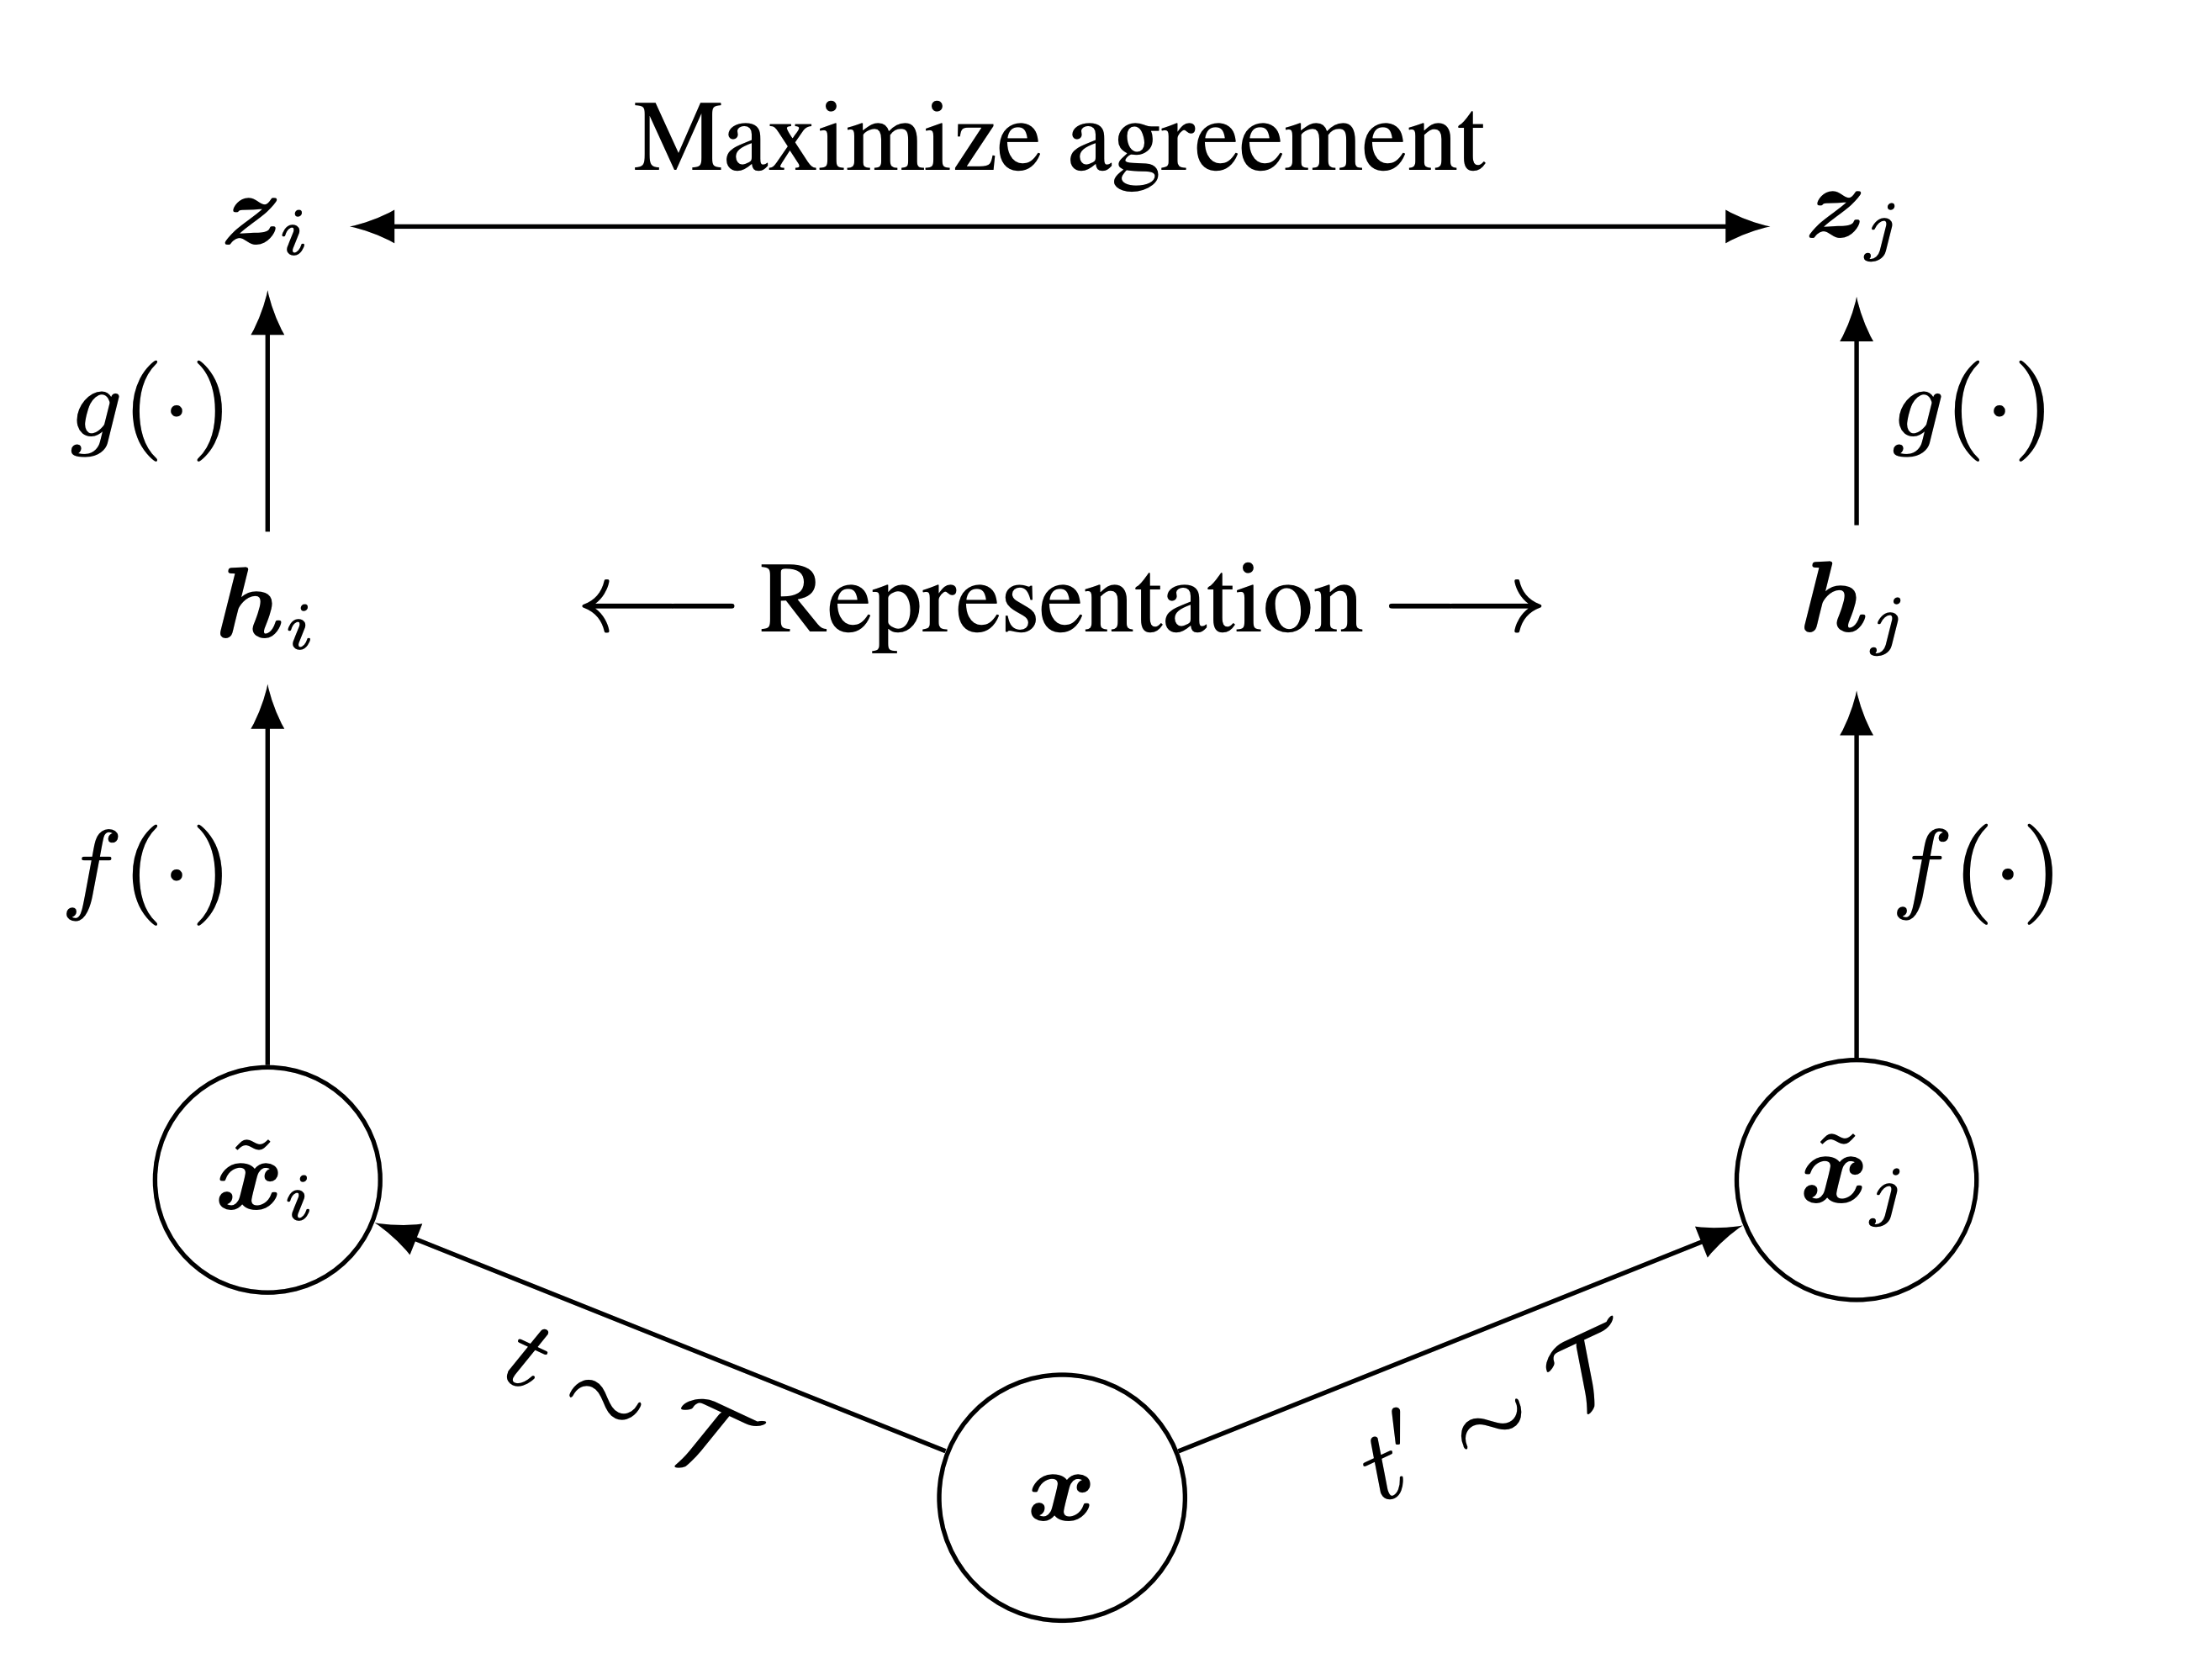
- Assignment 3-2: Self-Supervised Learning for Image Classification SimCLR의 data augmentation, NT-Xent loss 구현과 self-supervised representation의 image classification 평가 이번 과제에서는 label 없이 image representation을 학습하는 self-supervised learning과 SimCLR의 contrastive learning을 구현하고, 학습된 representation이 downstream image classification에 얼마나 유용한지 평가한다. Supervised learning은 이미지와 사람이 붙인 class label의 관계를 학습한다. 반면 self-supervised learning은 data 자체에서 학습 신호를 만든다. SimCLR에서는 같은 이미지에 서로 다른 random augmentation을 적용해 두 view를 만들고, 이 둘을 positive pair로 취급한다. Model은 positive pair의 representation을 가깝게 만들고, batch 안의 다른 이미지에서 나온 view는 멀어지게 학습한다.
- [Google Recommendation Systems 06] Retrieval, Scoring, Re-ranking 추천 시스템의 retrieval, scoring, re-ranking 파이프라인과 freshness, diversity, fairness Google 공식 원문: Retrieval, Scoring, Re-ranking, Course summary 대규모 추천 시스템은 corpus 전체를 하나의 복잡한 모델로 정렬하지 않는다. 수백만 개 이상의 item을 요청마다 모두 평가하면 latency와 compute 비용을 감당하기 어렵기 때문이다. 대신 대상을 단계적으로 줄이는 funnel 구조를 사용한다. Retrieval 또는 candidate generation: 전체 corpus에서 관련 가능성이 있는 candidate 수백수천 개를 빠르게 가져온다. Scoring과 ranking: 더 많은 feature와 복잡한 모델로 candidate의 relevance를 평가하고 순서를 정한다. Re-ranking: freshness, diversity, fairness, 정책 같은 추가 기준과 제약을 반영해 최종 노출 목록을 만든다.
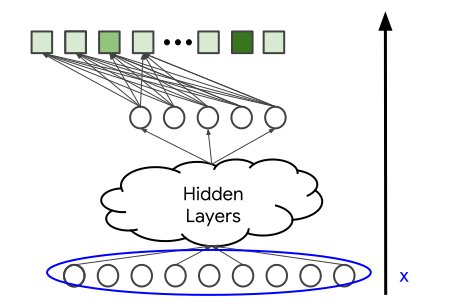
- [Google Recommendation Systems 05] Softmax DNN과 Two-Tower Softmax DNN 추천 모델의 구조와 embedding 해석, negative sampling, two-tower 모델 Google 공식 원문: Deep neural network models, Softmax training 이전 글의 matrix factorization은 사용자와 item마다 하나의 embedding을 학습하고, 두 embedding의 내적으로 선호도를 예측했다. 단순하고 대규모 corpus에도 잘 확장되지만 다음과 같은 한계가 있다. user ID와 item ID 이외의 side feature를 모델에 넣기 어렵다. 학습 데이터에 없던 새로운 user나 item을 바로 처리하기 어렵다. dot product를 그대로 사용하면 norm이 큰 인기 item이 많은 사용자에게 반복해서 추천되기 쉽다. 사용자의 현재 문맥이나 구체적인 관심사를 세밀하게 반영하기 어렵다.
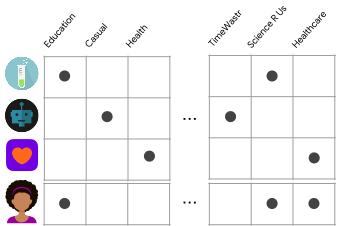
- [Google Recommendation Systems 04] Collaborative filtering과 matrix factorization User-item interaction에서 latent embedding을 학습하는 collaborative filtering과 weighted matrix factorization 공식 원문: Collaborative filtering: Basics, Matrix factorization, Advantages & disadvantages Collaborative filtering은 여러 사용자의 user–item interaction을 함께 이용해 user와 item의 latent embedding을 자동으로 학습하며, matrix factorization은 feedback matrix 를 저차원 행렬 와 의 곱으로 근사해 관측되지 않은 선호를 예측하는 대표적인 collaborative filtering 방법이다.
- [Google Recommendation Systems 03] Content-based filtering Item feature와 user profile의 유사도로 추천하는 content-based filtering의 원리와 장단점 공식 원문: Content-based filtering: Basics, Advantages & disadvantages Content-based filtering은 item과 사용자를 같은 feature space의 vector로 표현하고 두 vector의 similarity로 candidate의 relevance를 계산하는 방법이며, 다른 사용자의 행동 없이 개인의 취향을 세밀하게 반영할 수 있지만 추천 품질이 사람이 설계한 feature와 사용자의 기존 관심사에 크게 제한된다.
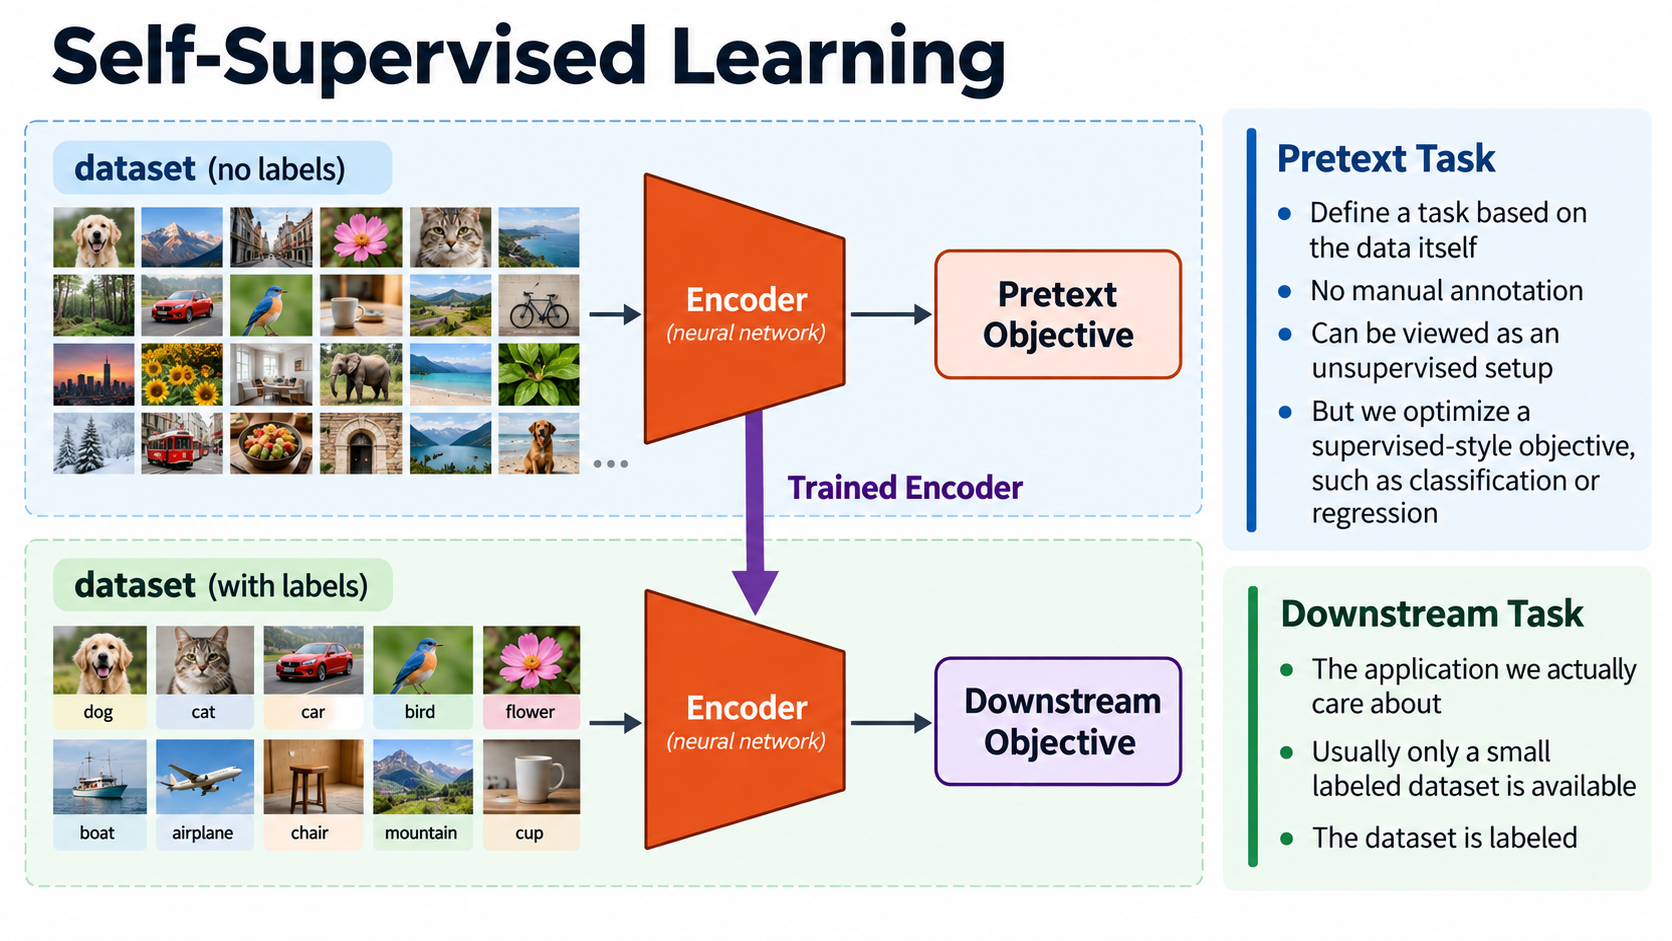
- CS231n Lecture 12 - Self-Supervised Learning Pretext task, MAE, contrastive representation learning Self-supervised learning(자기지도학습)은 label이 없는 data 자체에서 학습 목표를 만들고, reconstruction이나 contrastive objective를 통해 다양한 downstream task에 재사용할 수 있는 representation을 학습하는 방법이다. Supervised learning은 input과 사람이 만든 label의 쌍을 사용한다. Image classification의 class label도 비용이 들지만, object detection의 bounding box나 semantic segmentation의 pixel label은 훨씬 더 많은 작업을 요구한다. 새로운 domain으로 옮길 때마다 같은 규모의 label을 다시 만드는 것도 어렵다.
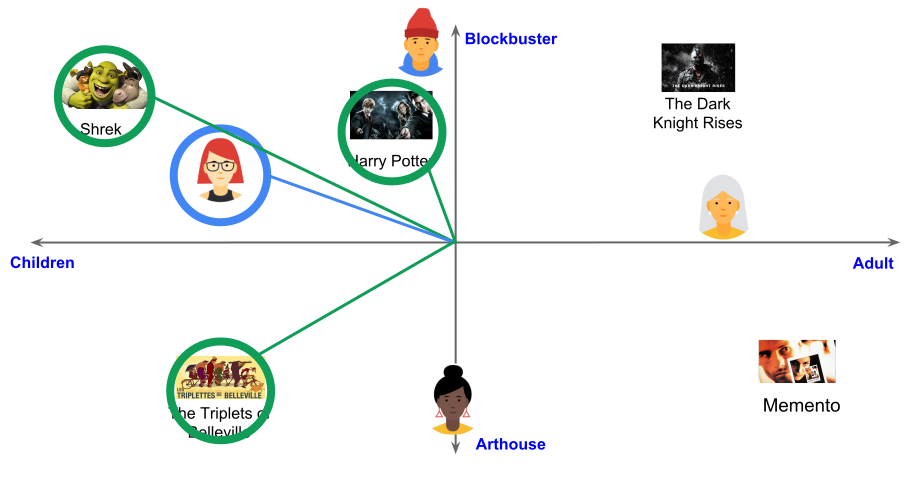
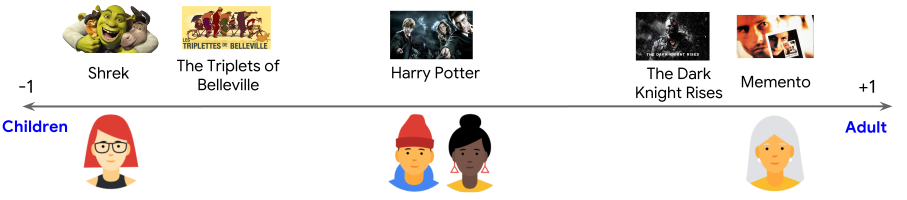
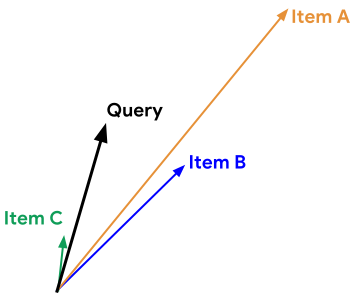
- [Google Recommendation Systems 02] Candidate generation과 embedding 추천 후보를 생성하는 두 가지 접근과 embedding 공간의 의미, cosine/dot product/Euclidean distance의 차이와 선택 기준 Google 공식 원문: Candidate generation overview Candidate generation은 전체 corpus에서 현재 query와 관련 있을 가능성이 높은 item을 빠르게 추려내는 추천 시스템의 첫 단계이다. 대규모 서비스에서는 모든 item을 정교한 scoring model에 넣을 수 없으므로, 이 단계가 수백만∼수십억 개의 item을 수백∼수천 개 수준의 후보로 줄인다.
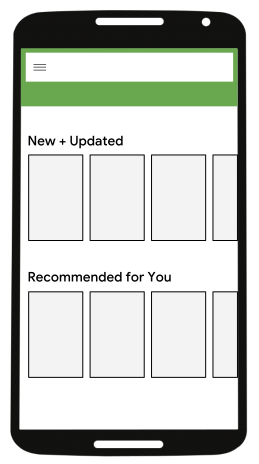
- [Google Recommendation Systems 01] 추천 시스템 개요 대규모 추천 시스템이 필요한 이유와 item, query, embedding의 의미, candidate generation부터 re-ranking까지의 전체 구조 Google 공식 원문: Recommendation Systems 과정, Large-scale recommendation systems, Terminology, Recommendation systems overview 추천 시스템은 사용 가능한 전체 콘텐츠 가운데 현재 사용자에게 보여줄 만한 item을 골라 순서를 정하는 시스템이다. YouTube가 다음에 볼 영상을 제안하거나 Google Play가 홈 화면에 앱을 배열하는 과정이 대표적인 예이다.
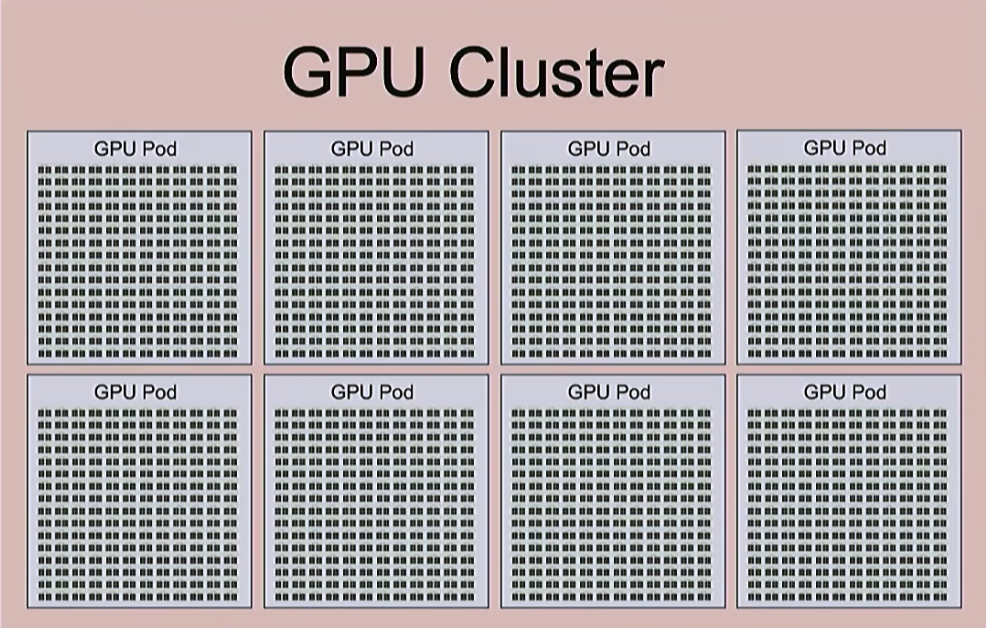
- CS231n Lecture 11 - Large-Scale Distributed Training GPU cluster의 memory, communication, parallelism Large-scale distributed training은 거대한 model과 batch를 여러 accelerator에 나누는 것만으로 끝나지 않으며, GPU와 cluster의 계층적인 memory bandwidth에 맞춰 computation과 communication을 겹치고 data, parameter, sequence, layer 축의 parallelism을 조합해 Model FLOPs Utilization을 높이는 문제이다. Computer가 수행하는 작업은 크게 computation과 communication으로 나눌 수 있다. Computation은 input bit로부터 새로운 output bit를 계산하는 작업이다. Communication은 data를 한 memory 또는 device에서 다른 곳으로 옮기는 작업이다.
- RMS 정규화 RMSNorm의 수식과 LayerNorm과의 차이, Transformer에서 자주 사용하는 이유 RMS 정규화(Root Mean Square Layer Normalization, RMSNorm)는 입력의 평균을 빼지 않고, 제곱 평균의 제곱근인 RMS를 이용해 입력의 크기만 조절하는 정규화 방법이다. 하나의 token에 대응하는 입력 vector를 라고 하자. 입력의 RMS는 다음과 같다.
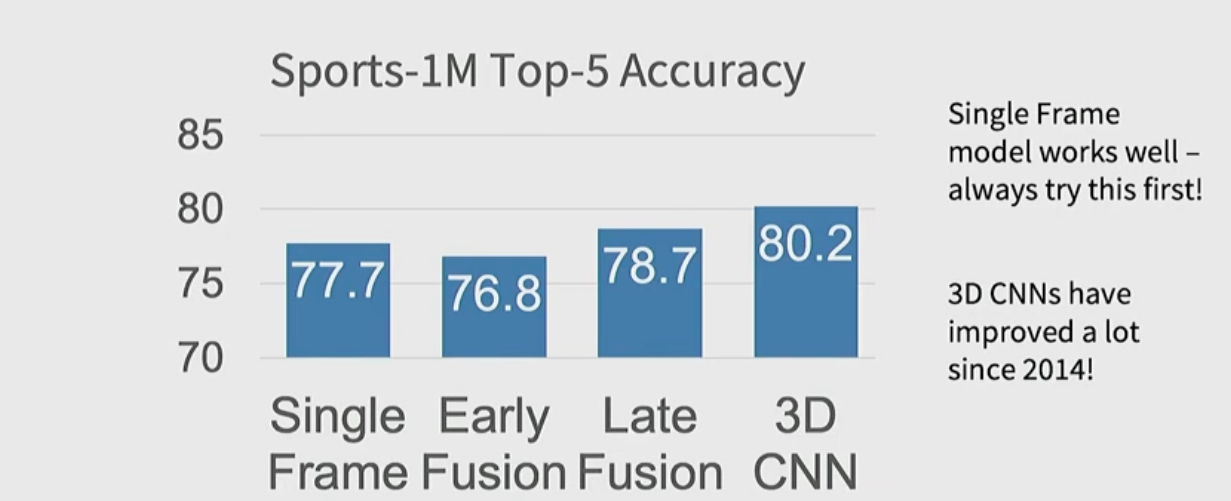
- CS231n Lecture 10 - Video Understanding Spatiotemporal representation과 action recognition Video understanding은 image에 time dimension을 더한 spatiotemporal data에서 appearance와 motion을 함께 표현하는 문제이며, frame pooling부터 3D CNN, optical flow 기반 two-stream network, recurrent model, space-time attention까지의 차이는 결국 temporal information을 언제 어떻게 결합하느냐에 있다. RGB image 한 장은 일반적으로 다음과 같이 표현한다.
- CS231n Lecture 9 - Object Detection, Image Segmentation, and Visualization Dense prediction과 모델 시각화 Image segmentation과 object detection은 image-level classification을 pixel, region, object 단위의 dense prediction으로 확장한 문제이며, saliency map과 CAM(Class Activation Mapping) 계열 기법은 예측 score를 다시 image 공간에 연결해 model이 어느 영역을 사용했는지 해석한다. 같은 image를 입력받더라도 무엇을 출력하느냐에 따라 task가 달라진다.
- Sinusoidal Positional Encoding의 원리 여러 주기의 sin과 cos를 이용해 token의 위치를 embedding과 같은 차원의 vector로 표현하는 원리 Transformer의 self-attention은 입력 vector 사이의 관계를 계산하지만, token이 원래 몇 번째 위치에 있었는지는 스스로 알 수 없다. 따라서 token embedding에 위치정보를 별도로 넣어주어야 한다. Sinusoidal positional encoding은 token의 위치 를 여러 주파수의 sin과 cos로 변환하여 차원 vector 하나로 표현하는 방법이다.
- Assignment 3-1: Image Captioning with Transformers Attention 및 Transformer Block 구현, Image Captioning Transformer 의 Multi-Headed Attention 을 구현하고, Positional Encoding 의 원리와 구현, Transformer Block 을 만들고 COCO Dataset 으로 이미지 캡셔닝과 ViT를 구현한다. Multi-Headed Attention은 embedding을 여러 head로 나누어 각 head가 서로 다른 표현 공간에서 token 사이의 관계를 포착하도록 한다.
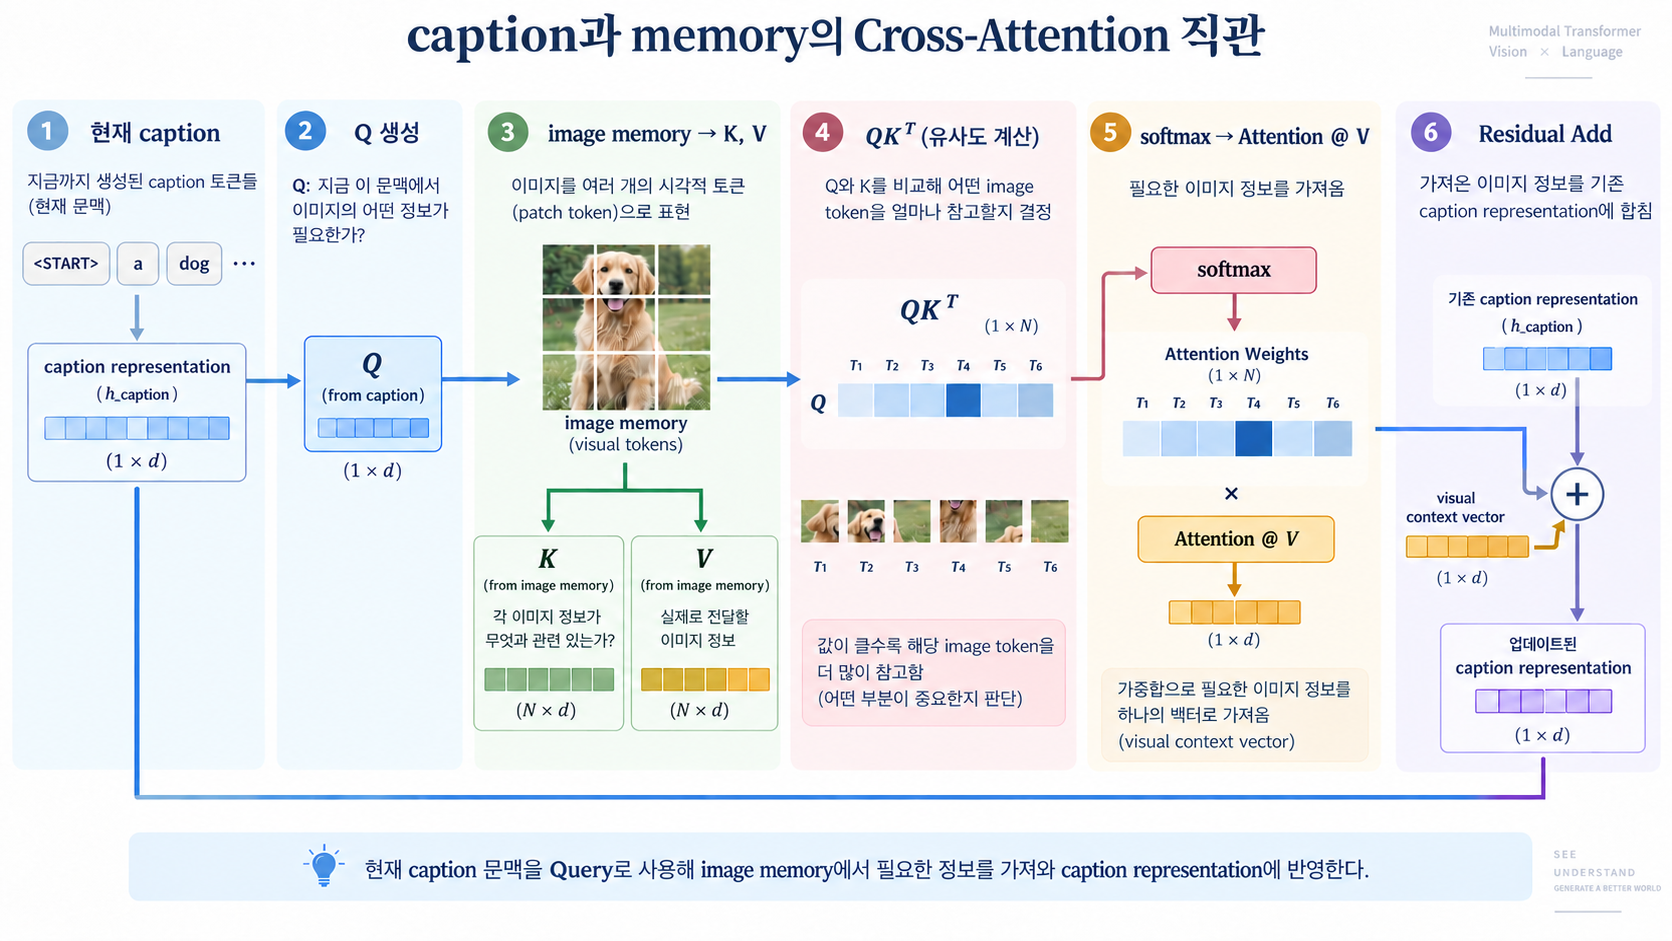
- CS231n Lecture 8 - Attention and Transformers Attention 연산과 Transformer 구조 Attention은 query와 key의 유사도로 value를 가중합하는 연산이며, Transformer는 self-attention으로 token 사이의 정보를 섞고 FFN으로 각 token을 독립적으로 변환하는 block을 반복해 sequence를 처리한다. Sequence-to-sequence model은 길이가 다른 두 sequence 사이의 mapping을 학습한다. 기계번역에서는 영어 문장을 입력받아 이탈리아어 문장을 출력할 수 있으며, 두 문장의 단어 수와 어순은 서로 다를 수 있다.
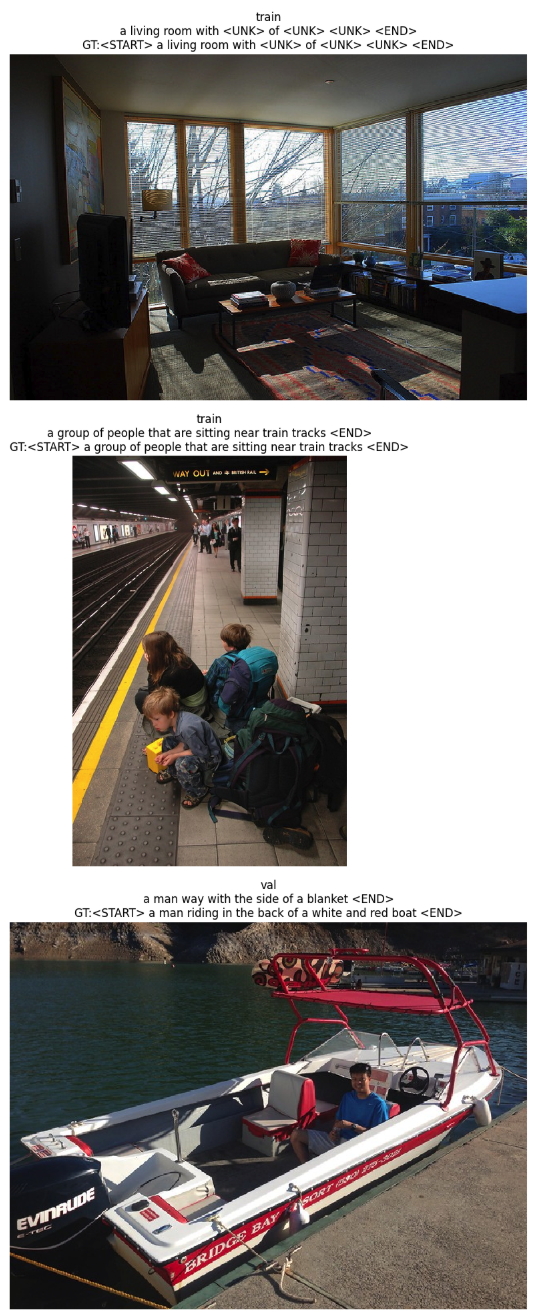
- Assignment 2-5: RNN Captioning COCO image feature와 RNN language model을 연결한 image captioning 구현 미리 추출한 image feature를 초기 hidden state로 투영하고, 한 timestep씩 어긋난 caption을 teacher forcing으로 학습하여 매 시점의 다음 token을 예측하는 RNN image captioning model을 구현한다. 이번 과제는 2014 COCO Dataset의 image-caption pair를 사용한다. Image는 ImageNet으로 사전 학습한 VGG-16의 fc7 feature를 사용하며, 4096차원 feature를 PCA로 줄인 512차원 입력을 model에 넣는다. Caption은 각 word를 integer ID로 바꾼 sequence로 처리한다.
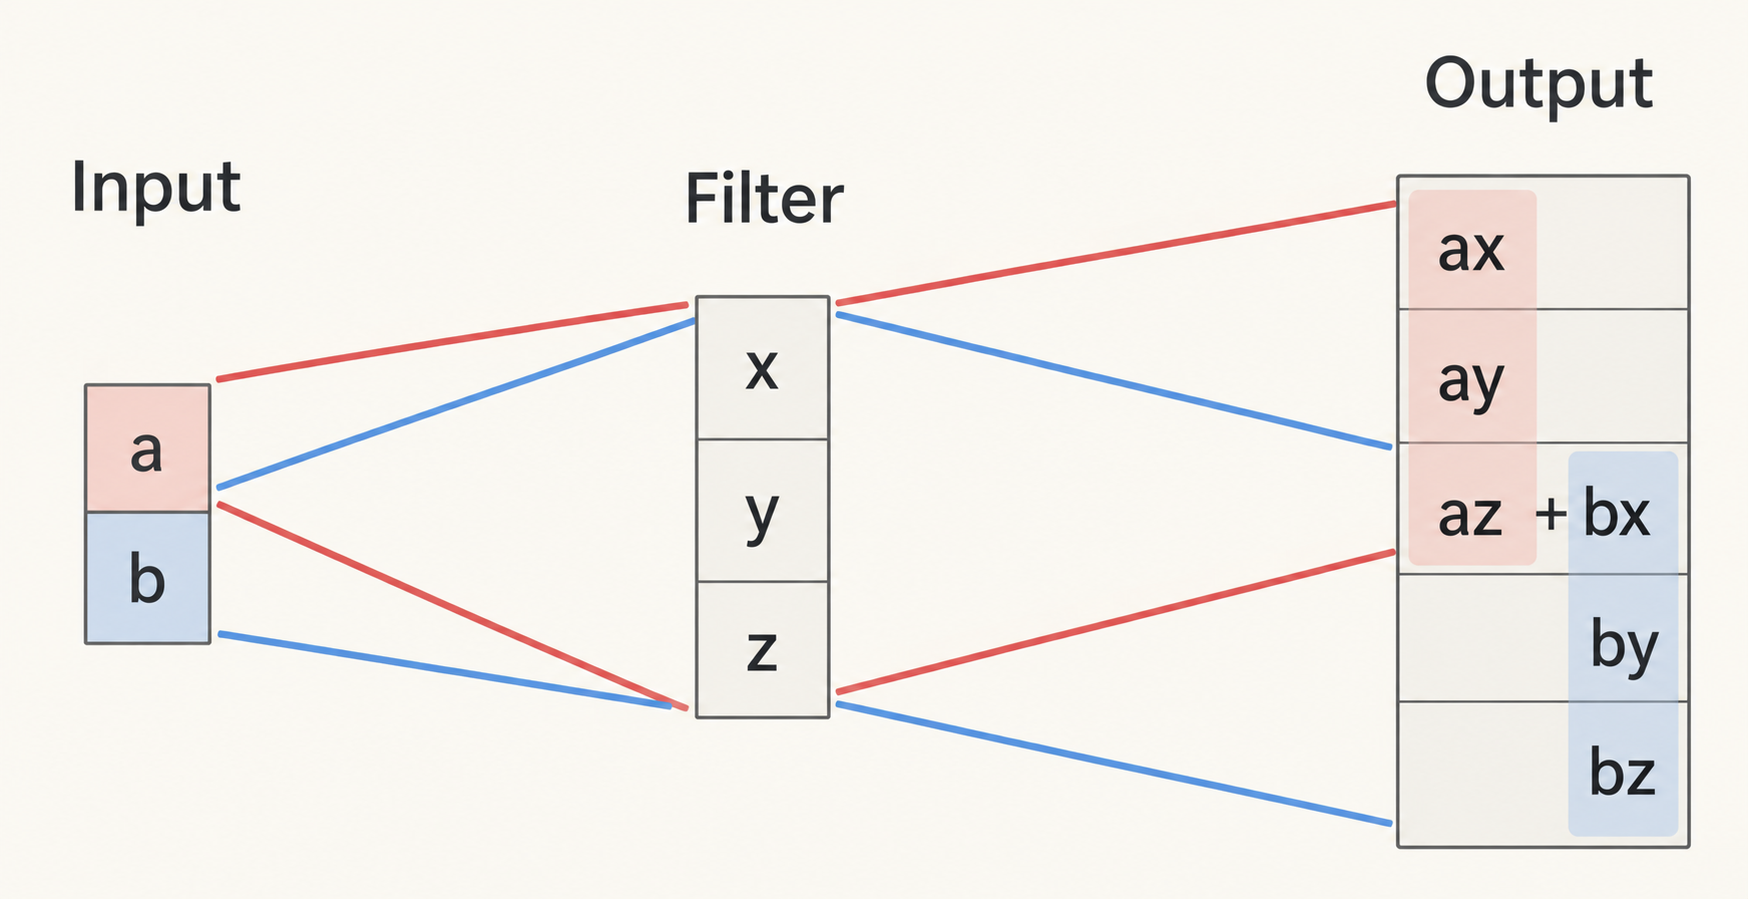
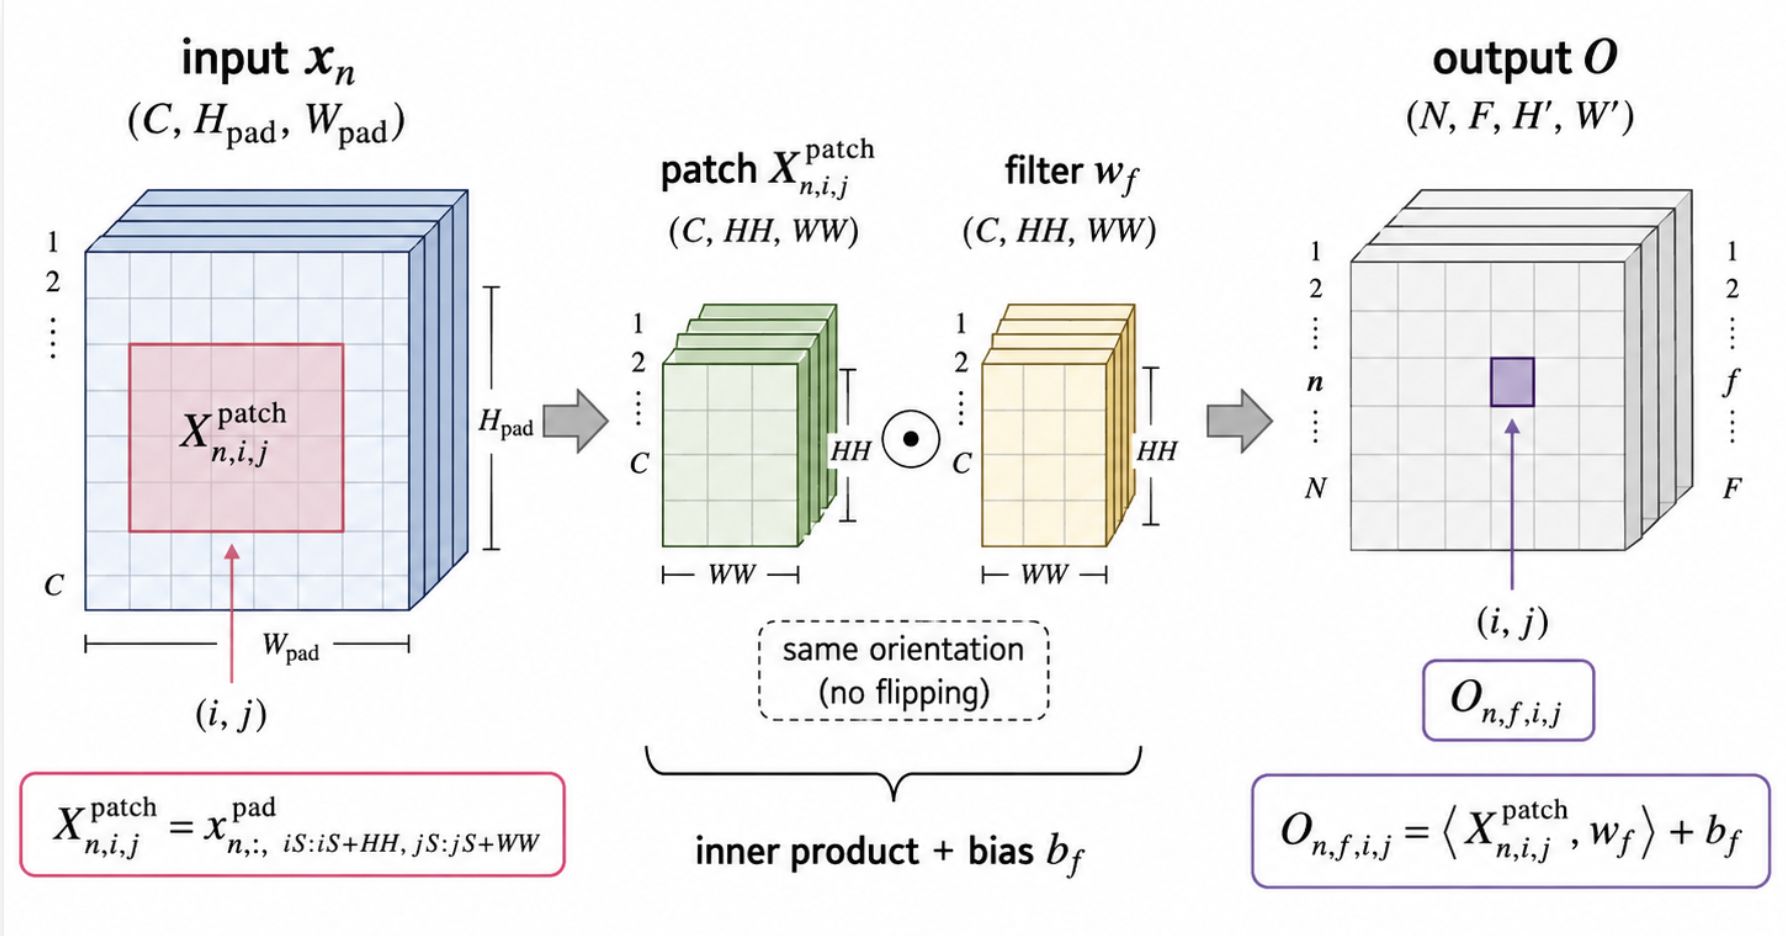
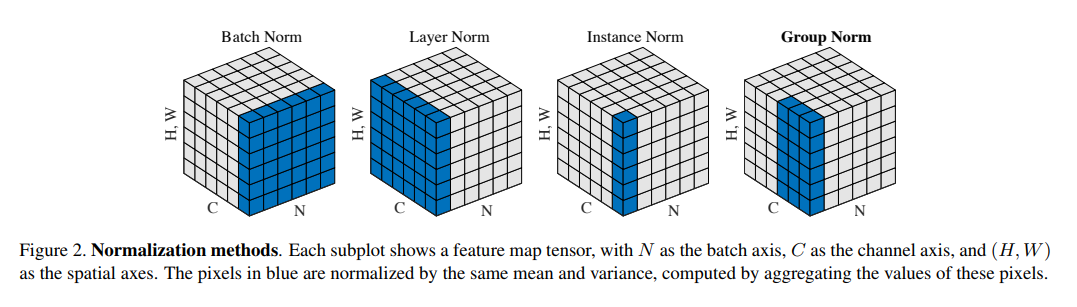
- Assignment 2-3: Convolutional Networks Convolution, Max Pooling, Spatial Batch Normalization, Group Normalization 구현 이번 과제에서는 CNN을 구성하는 convolution과 max pooling layer의 forward, backward를 직접 구현한다. 이어서 CNN의 activation shape인 에 맞춰 Spatial Batch Normalization을 구현하고, 채널을 여러 group으로 나누어 정규화하는 Spatial Group Normalization까지 구현한다.
- CS231n Lecture 7 - Recurrent Neural Networks RNN 구조와 sequence modeling RNN은 이전 hidden state와 현재 입력을 같은 가중치로 반복 처리해 가변 길이 sequence를 모델링하며, BPTT로 시간축을 따라 학습하지만 순차 계산과 vanishing gradient라는 한계가 있어 LSTM과 현대적인 state space model로 발전했다. 일반적인 image classifier는 하나의 고정된 크기 입력을 받아 하나의 고정된 크기 출력을 만든다. Sequence modeling에서는 입력이나 출력이 가변 길이 sequence가 될 수 있다.
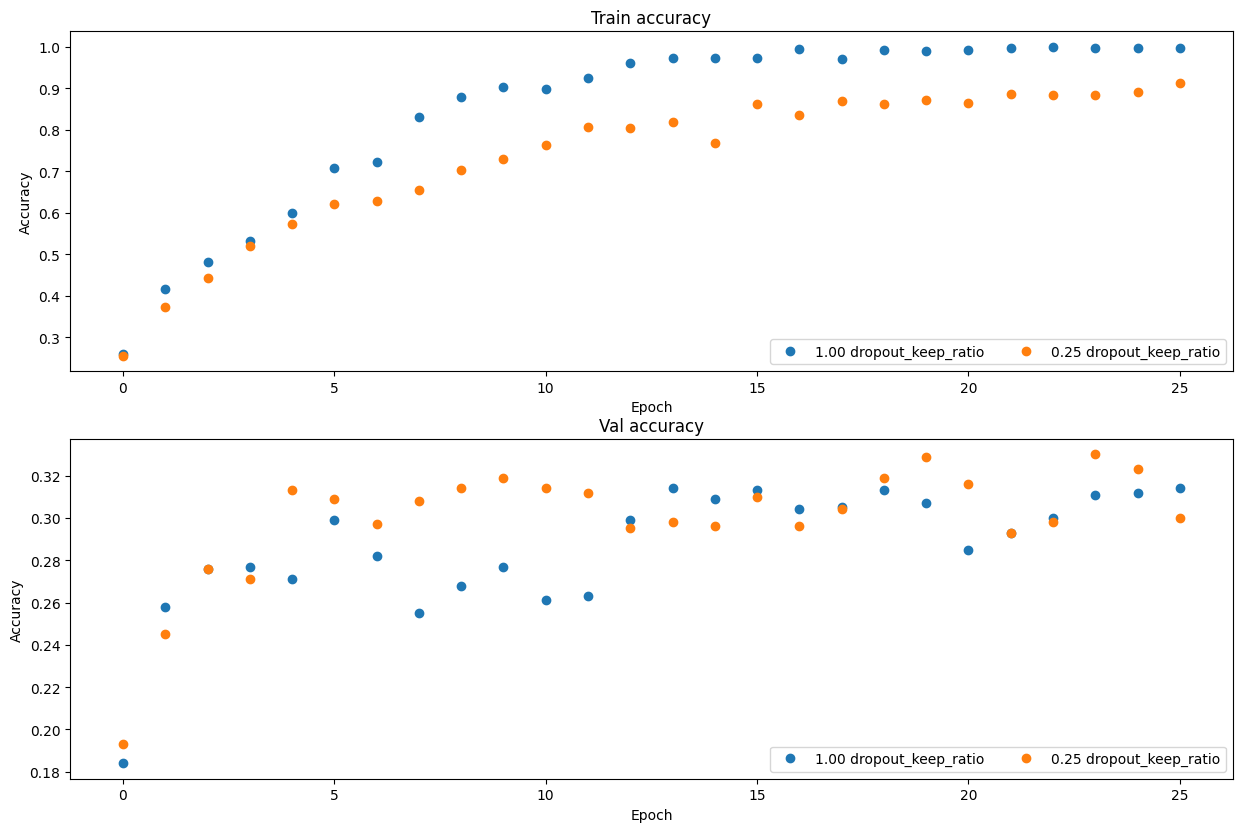
- Assignment 2-2: Dropout Dropout 개념 및 구현 드롭아웃의 개념과 효과, 순전파 및 역전파를 구현한다. 드롭아웃(Dropout)은 훈련 시 drop probability 만큼 뉴런의 출력을 무작위로 0으로 만드는 규제 기법이다.
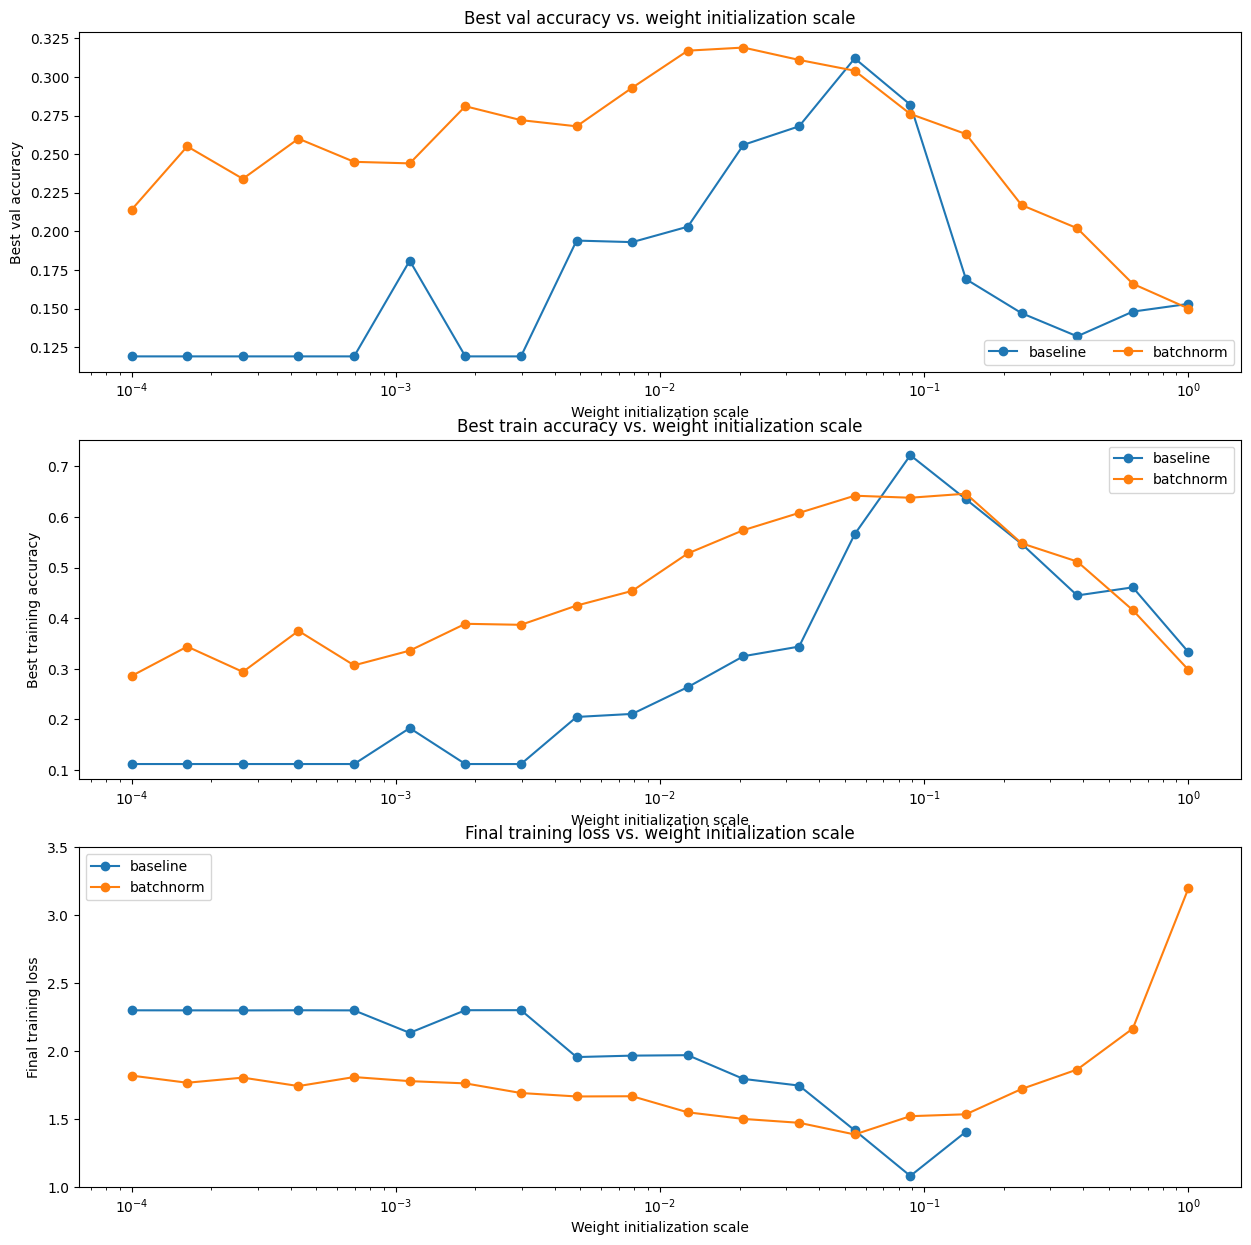
- Assignment 2-1: Batch Normalization Batch Norm, Layer Norm 이번 과제에서는 Batch Normalization 의 개념과 BatchNorm 레이어의 forward, backward 를 구현한다. 또한 Batch Norm과 Weight Initialization 의 관계, Batch Norm과 Batch Size와의 관계를 Baseline 기반으로 비교한다.
- CS231n Lecture 6 - Training CNNs and CNN Architectures CNN 구성 요소와 아키텍처, 초기화, 데이터 증강, 전이 학습, 학습 방법 CNN을 안정적으로 학습하려면 합성곱만 쌓는 것이 아니라 정규화, Dropout, 활성화 함수를 목적에 맞게 배치하고, 잔차 연결과 Kaiming 초기화로 깊은 신경망의 최적화를 안정화하며, 데이터 증강과 전이 학습, 올바른 디버깅 절차까지 하나의 학습 과정으로 연결해야 한다. CNN을 다룰 때는 두 문제를 구분해야 한다. 어떤 계층을 어떤 순서와 형태로 연결해 아키텍처를 만들 것인가? 만들어진 아키텍처가 실제 데이터에서 안정적으로 학습되도록 어떻게 준비하고 검증할 것인가?
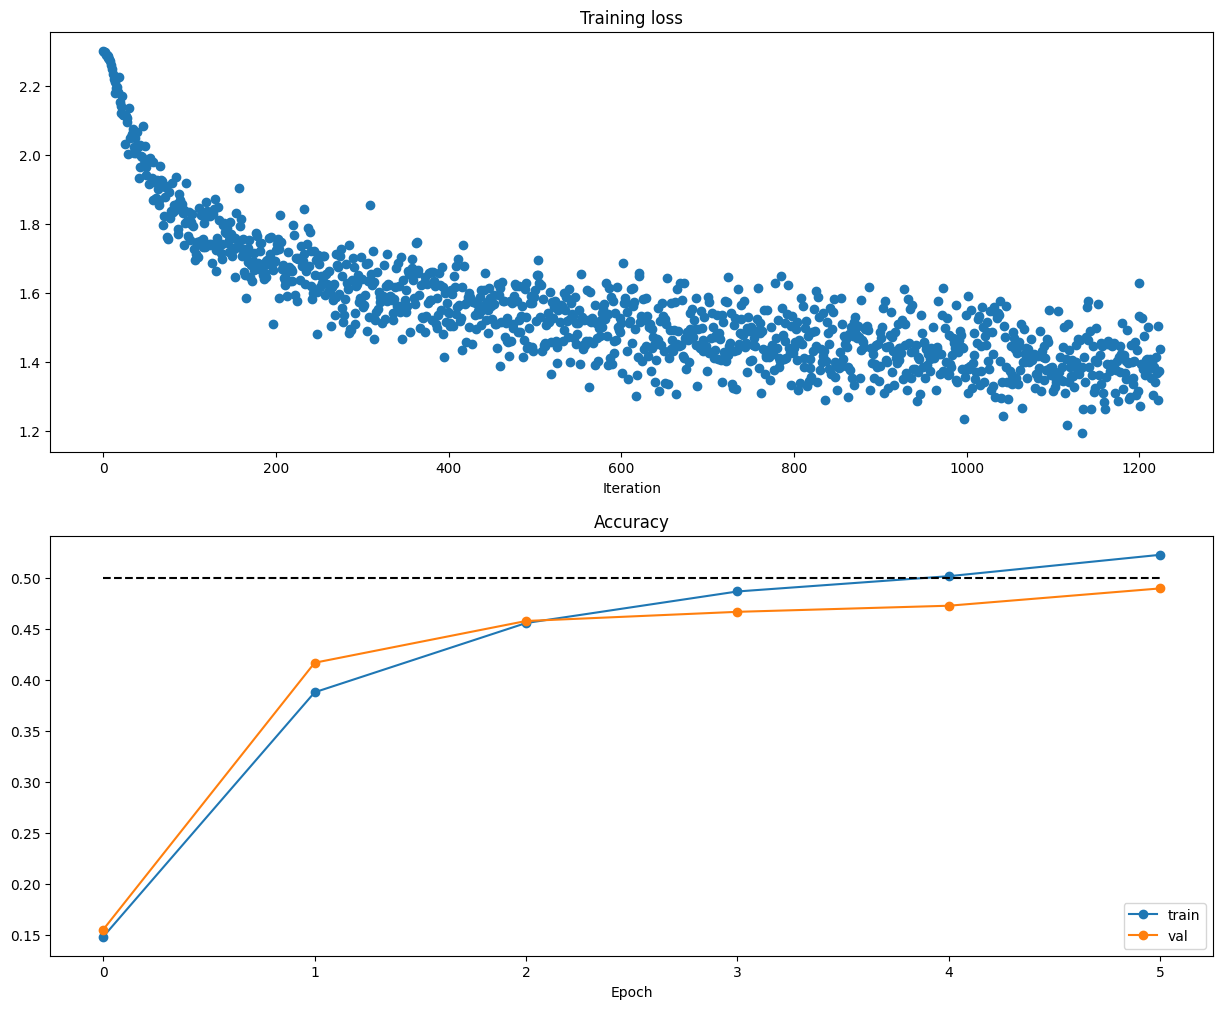
- Assignment 1-5: Training a fully connected network FullyConnectedNet 구현, Momentum, RMSProp, Adam 이번 과제에서는 임의의 개수의 hidden layer를 갖는 FullyConnectedNet을 구현하고, 여러 optimizer를 직접 구현해본다. 앞에서 만든 TwoLayerNet이 하나의 hidden layer만 갖는 구조였다면, 여기서는 hidden layer 개수를 리스트로 받아 더 깊은 fully-connected network를 구성한다. 기본 구조는 다음과 같다.
- CS231n Lecture 5 - Image Classification with CNNs CNN 이미지 분류 CNN은 작은 필터를 이미지 전체에 공유하며 적용해 공간 구조를 보존하고, 단순한 경계부터 복잡한 물체 특징까지 계층적으로 학습하는 신경망이다. 앞선 강의에서는 이미지 분류를 예제로 딥러닝 시스템을 구성하는 기본 요소를 배웠다. 전체 흐름은 다음과 같이 정리할 수 있다. 입력과 출력을 텐서로 표현한다. 입력으로부터 출력 점수를 계산하는 모델을 정의한다. 모델의 예측이 얼마나 나쁜지를 측정하는 손실 함수를 정의한다. 역전파로 손실에 대한 파라미터의 기울기를 계산한다. 경사하강법 기반 최적화 알고리즘으로 파라미터를 갱신한다.
- Assignment 1-4: Higher Level Representations: Image Features HOG, HSV feature 추출과 feature 기반 분류기 학습 이번 과제에서는 원본 픽셀을 그대로 사용하는 대신, 이미지에서 hand-crafted feature를 추출한 뒤 분류기를 학습한다. 사용한 feature는 Histogram of Oriented Gradients, HOG와 HSV color histogram이다. 전체 흐름은 다음과 같다. 각 이미지에서 HOG feature를 추출한다. 각 이미지에서 HSV hue channel 기반 color histogram을 추출한다. 두 feature vector를 이어 붙여 하나의 feature vector로 만든다. 추출된 feature 위에서 Softmax linear classifier를 학습한다. 같은 feature 위에서 TwoLayerNet을 학습한다.
- Assignment 1-3: Two-Layer Neural Network 완전연결계층 구현 Fully-Connected Neural Nets 과제에서는 neural network를 구성하는 기본 layer들을 모듈 단위로 구현한다. 이번 과제에서 직접 구현한 핵심은 affineforward, affinebackward, reluforward, relubackward, softmaxloss, 그리고 이들을 조합한 TwoLayerNet이다. 전체 구조는 다음과 같다.
- CS231n Lecture 4 - Neural Networks and Backpropagation Neural Networks, Backprop Neural network는 여러 linear transformation 사이에 nonlinearity를 넣어 복잡한 함수를 표현하고, backpropagation은 chain rule을 이용해 loss가 각 parameter에 미치는 영향을 효율적으로 계산하는 방법이다. Lecture 3에서는 loss function을 정의하고, regularization과 optimization으로 좋은 weight를 찾는 방법을 봤다. 하지만 지금까지의 모델은 여전히 linear classifier라서, 선 하나로 나눌 수 없는 데이터에는 한계가 있다.
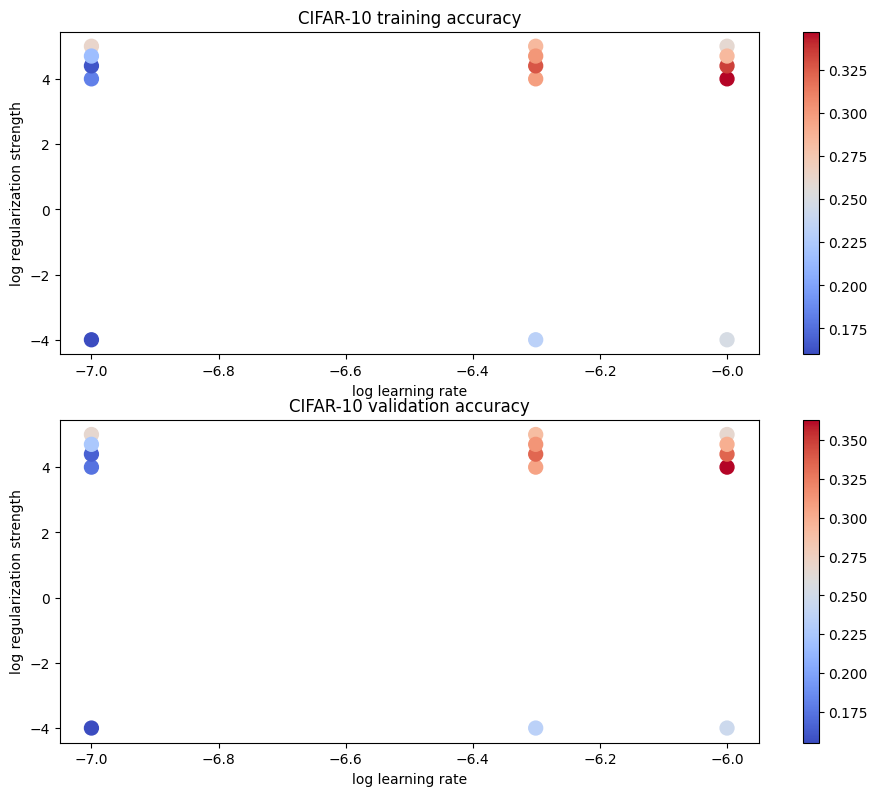
- Assignment 1-2: Implement a Softmax classifier softmaxloss 구현, SGD 구현 softmaxloss 에 대해서 이해하고, svm loss와 softmaxloss의 차이를 확인하고, SGD를 적용해서 훈련을 수행하고, 검증 데이터로 하이퍼파라미터 결정하기 softmaxloss 는 모델이 정답 클래스에 얼마나 높은 확률을 부여했는지를 기준으로 손실을 계산하는 방법이다. score를 softmax로 변환하여 각 클래스의 확률을 계산 정답 클래스의 확률이 1에 가까울수록 loss가 작아짐 SVM loss와 달리 margin을 넘겨도 정답 확률을 더 키우는 방향으로 계속 학습 수식: logit(점수):
- CS231n Lecture 3 - Regularization and Optimization Regularization의 목적, L1/L2 정규화, gradient descent, SGD, momentum, RMSProp, Adam과 learning rate schedule Regularization은 모델이 training data에 너무 잘 맞는 것을 막아 test data에서 더 잘 동작하게 만드는 장치이고, optimization은 loss를 줄이는 방향으로 파라미터 를 찾는 과정이다. 이번 강의의 흐름은 loss function -> regularization -> gradient descent -> SGD -> momentum / RMSProp / Adam -> learning rate schedule로 이어진다.
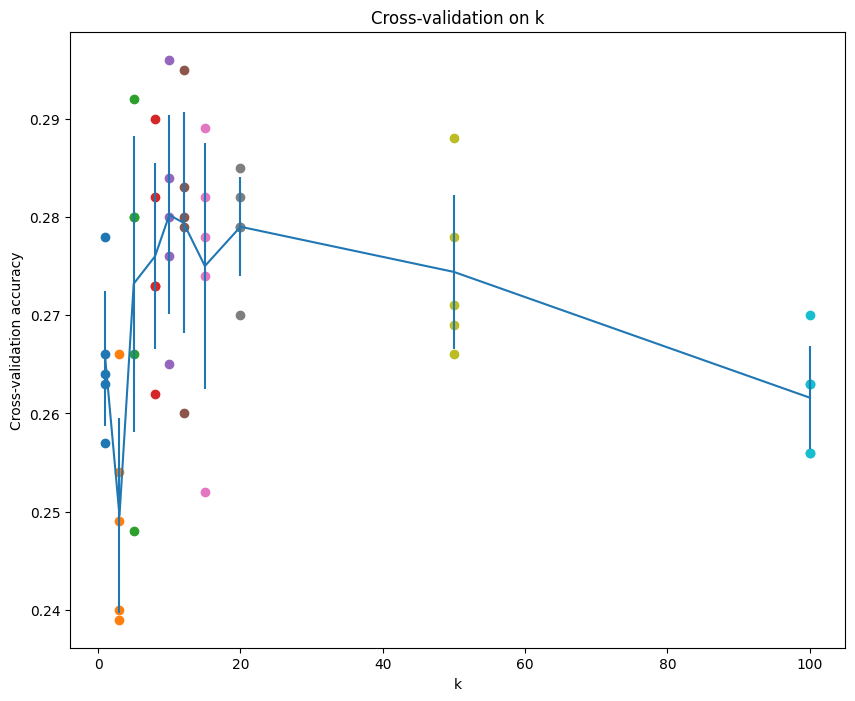
- Assignment 1-1: k-Nearest Neighbor classifier kNN 구현, training, testing, cross-validation L1, L2 distance 에 대해 이해하고, k-Nearest Neighbors(kNN) 분류기를 직접 구현하고, 학습 데이터에 대해 성능을 측정하고, Cross-Validation (k-folds) 를 이용해 최적의 하이퍼파라미터 k를 찾기 k-Nearest Neighbors(kNN)는 테스트 샘플과 훈련 샘플 간의 거리를 계산하여 가장 가까운 k개의 이웃을 찾고, 다수결을 통해 클래스를 예측하는 분류 알고리즘이다. 학습 과정이 거의 없음 (Lazy Learning) 가장 가까운 k개의 데이터로 분류 거리 척도로 주로 Euclidean Distance(L2 distance) 사용 거리 계산:
- CS231n Lecture 2 - Image Classification with Linear Classifiers 이미지 분류 문제, 데이터 기반 접근, Nearest Neighbor와 K-NN, 선형 분류기의 입력 shape와 score 계산 정리 CS231n Lecture 2 내용을 개인 학습용으로 정리한 글이다. 이미지 분류는 이미지를 텐서 입력으로 받아, 미리 정해진 클래스 중 하나의 라벨을 예측하는 문제이다.
- CS231n Lecture 1 - Introduction 컴퓨터 비전의 문제 정의, 데이터 기반 접근, 이미지 분류와 딥러닝으로 이어지는 흐름 정리 CS231n Lecture 1 내용을 개인 학습용으로 정리한 글이다. 컴퓨터 비전은 픽셀 배열에서 의미를 뽑아내는 문제이며, 현대적 접근은 사람이 규칙을 만들기보다 데이터로 모델을 학습시키는 것이다. 우리 뇌에서 뉴런은 계층 구조를 지닌다. 강의에서는 Hubel과 Wiesel의 고양이 시각 피질 실험을 통해 단순한 선과 모서리에서 점차 복잡한 객체로 인식하는 계층적 구조가 밝혀졌다고 언급한다. 컴퓨터 비전은 이미지를 숫자 배열로 보고 의미를 예측하는 문제이다. 이미지 분류 모델은 픽셀의 표면적 차이를 넘어서 객체의 본질적인 패턴을 학습해야 한다. 데이터 기반 접근은 규칙을 직접 설계하지 않고, 대량의 데이터셋을 통해 모델이 분류 기준을 스스로 학습하게 하는 방식이다. 대표적인 예로 ImageNet이 있다.
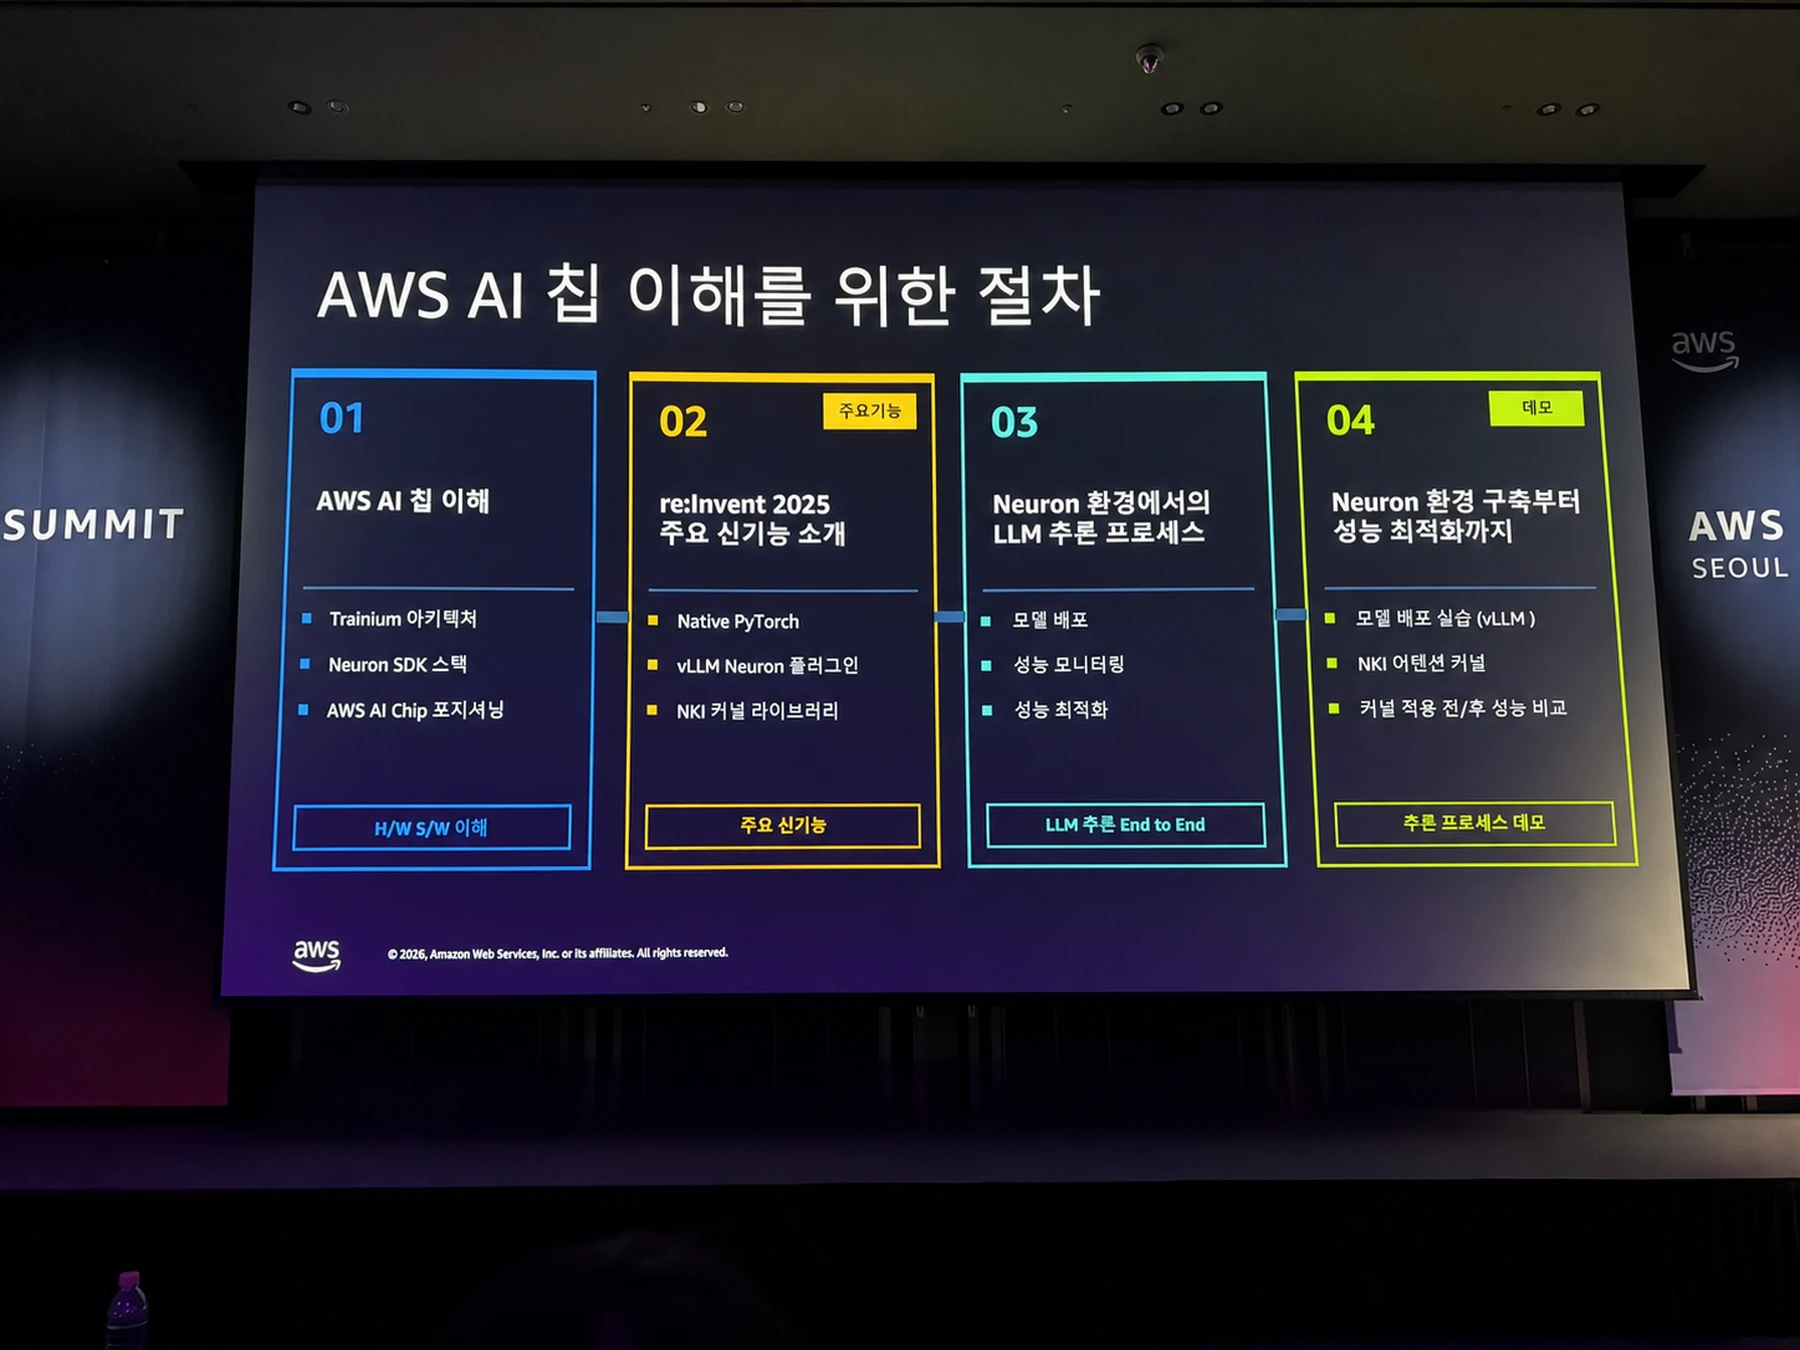
- AWS Summit 2026 마지막 세션 후기: AWS Trainium 기반 LLM 추론 A to Z Neuron 환경, Trainium 기반 LLM 추론, 성능 측정 지표와 최적화 전략을 가볍게 정리한 AWS Summit 2026 마지막 세션 후기 AWS Summit 2026에서 마지막으로 들은 세션은 AWS-Trainium 기반 LLM(Large Language Model, 대규모 언어 모델) 추론 A to Z: Neuron 환경 이해부터 성능 최적화까지였다. 하루 끝에 듣는 세션이라 집중력이 많이 떨어질 줄 알았는데, 의외로 가장 기억에 남았다. 단순히 "Trainium이 빠르다" 정도의 소개가 아니라, 실제로 LLM 추론을 Trainium 환경에서 돌리려면 어떤 것들을 봐야 하는지 전체 흐름을 잡아주는 세션이었다.
- 7.2.1. Left and Right Inverses and the Pseudoinverse 네 기본 부분공간 관점에서 left inverse, right inverse, projection, pseudoinverse를 정리하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 33: Left and Right Inverses; Pseudoinverse 이번 강의는 left inverse, right inverse, pseudoinverse를 다룬다.
- 8.3. The Search for a Good Basis change of basis의 선형대수 구조와 JPEG, wavelet, image compression 예시를 함께 정리하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 31: Change of Basis; Image Compression 이번 강의는 change of basis, 즉 기저변환을 다룬다.
- 8.2. The Matrix of a Linear Transformation basis와 coordinates를 선택하면 linear transformation이 matrix로 표현되는 과정과 projection, derivative 예시 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 30: Linear Transformations and Their Matrices 앞 글에서는 linear transformation의 아이디어를 봤다.
- 8.1. The Idea of a Linear Transformation 좌표와 행렬을 잠시 내려놓고 선형변환의 의미, 예시, 비예시, 선형성 조건을 정리하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 30: Linear Transformations and Their Matrices 이번 강의는 linear transformation, 즉 선형변환을 다룬다.
- 7.2. Bases and Matrices in the SVD rank-one 행렬의 SVD 예시와 네 기본 부분공간의 orthonormal basis 관점에서 SVD 이해하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 29: Singular Value Decomposition 앞 글에서는 SVD의 기본 형태와 full-rank 예시를 봤다.
- 7.1. Image Processing by Linear Algebra SVD의 기본 형태, 행공간과 열공간의 직교기저, A^TA와 AA^T로 singular vector를 구하는 방법 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 29: Singular Value Decomposition 이번 강의는 singular value decomposition, 즉 SVD를 다룬다.
- 6.2.1. Similar Matrices and Jordan Form similar matrix의 의미, 대각화와의 관계, 반복 고유값에서 Jordan form이 필요한 이유 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 28: Similar Matrices and Jordan Form 이번 강의의 핵심 주제는 similar matrices이다.
- 6.5. Positive Definite Matrices positive definite matrix의 판별 조건, quadratic form, 최소점, ellipse와 ellipsoid의 기하적 의미 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 27: Positive Definite Matrices and Minima 이번 강의는 positive definite matrix를 다룬다.
- 6.4.1. Complex Matrices and Fast Fourier Transform 대칭행렬의 복소수 버전인 Hermitian matrix, unitary matrix, Fourier matrix와 FFT의 기본 아이디어 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 26: Complex Matrices; Fast Fourier Transform 이번 강의는 positive definite matrix로 들어가기 직전에 복소수 행렬을 정리하는 연결 강의이다.
- 6.4. Symmetric Matrices 대칭행렬의 실수 고유값, 직교 고유벡터, spectral theorem, positive definite matrix의 기본 판별법 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 25: Symmetric Matrices and Positive Definiteness 이번 강의는 symmetric matrix, 즉 대칭행렬을 다룬다.
- 10.3. Markov Matrices, Population, and Economics Markov 행렬의 정의, 고유값 1, steady state, 인구 이동 모델과 Fourier series로 이어지는 직교기저 관점 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 24: Markov Matrices; Fourier Series 이번 강의는 고유값과 고유벡터의 응용을 다루는 강의이다.
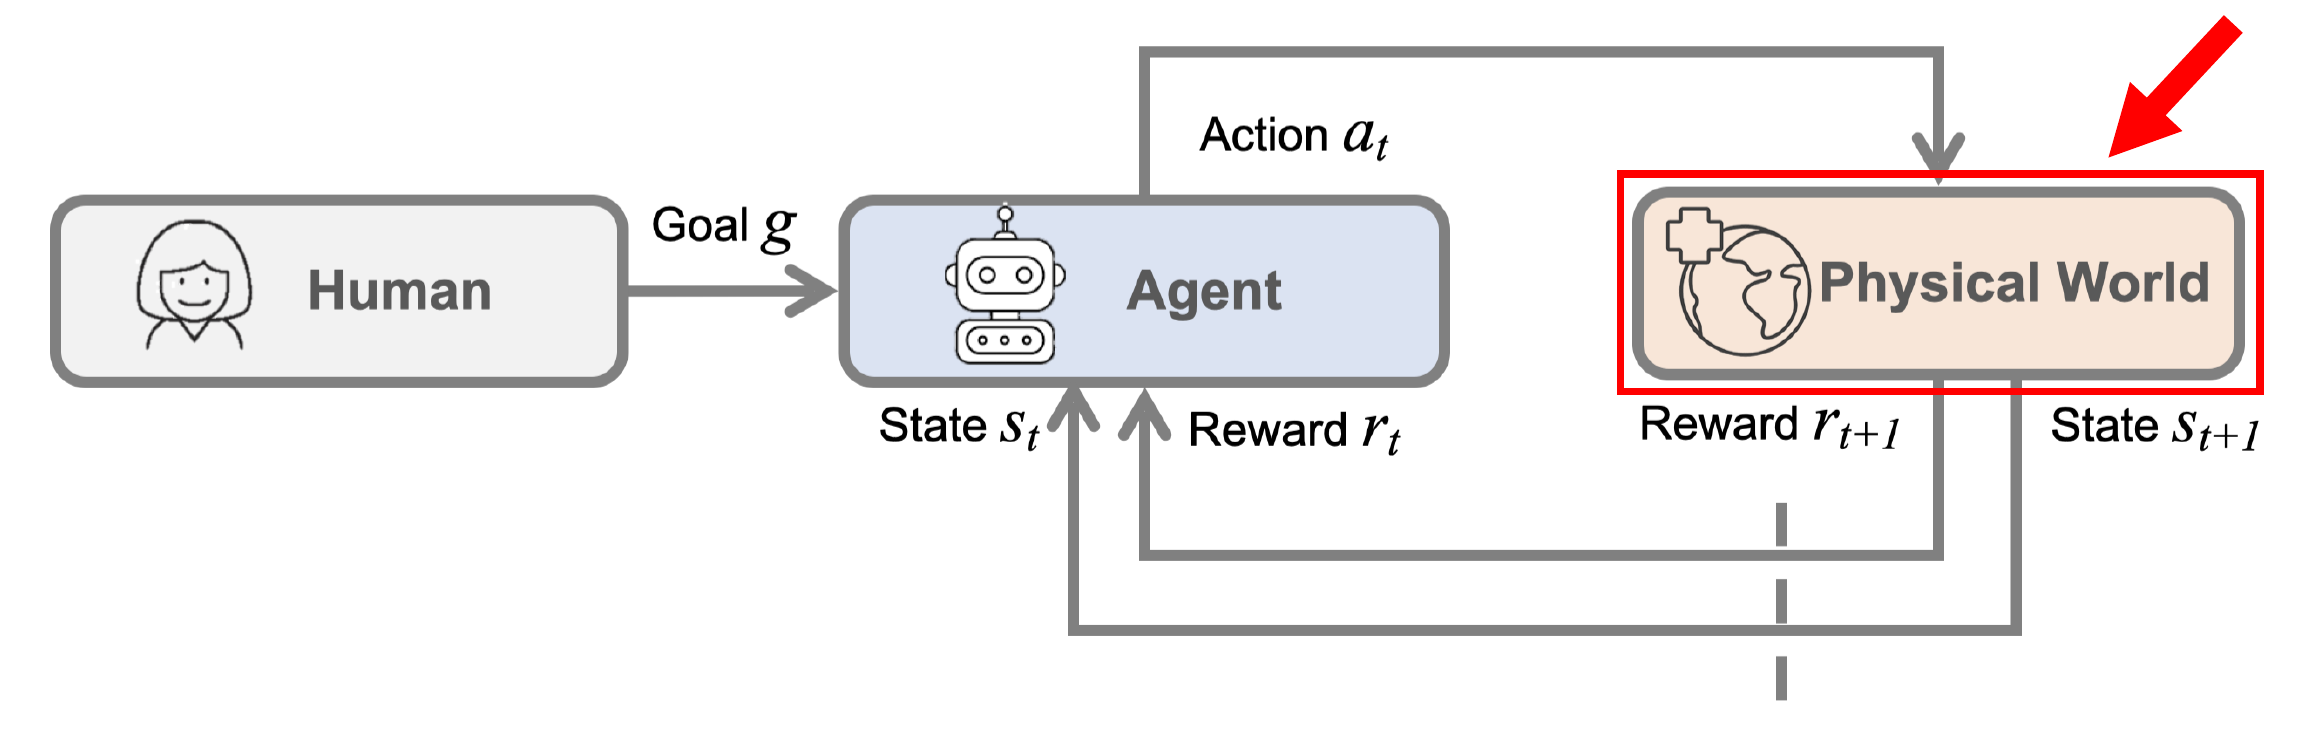
- CS231n Lecture 17 - Robot Learning reinforcement learning, model-based planning, imitation learning, vision-language-action models Robot learning은 action으로 환경을 바꾸며 장기적인 reward를 높이는 policy를 학습하는 sequential decision-making 문제이다. Supervised learning은 고정된 데이터셋의 입력 에서 label 를 예측한다.
- CS231n Lecture 16 - Vision and Language CLIP, multimodal language models, grounding, model chaining Vision-language foundation model은 이미지와 텍스트를 공통 representation으로 정렬하거나 visual token을 language model의 context로 주입해 여러 과제를 하나의 pretrained model로 풀며, grounding과 promptable output, tool chaining을 더해 텍스트 응답을 실제 픽셀과 전문 vision model의 동작으로 연결한다. 전통적인 computer vision pipeline은 과제마다 데이터셋과 모델을 따로 만든다.
- CS231n Lecture 15 - 3D Vision 3D representations, neural fields, NeRF, Gaussian splatting 3D vision은 geometry와 appearance를 point cloud, mesh, voxel, implicit function 등으로 표현하고, 2D·3D 관측에서 이를 학습해 장면 복원과 새로운 시점의 이미지 합성에 사용한다. 2D 이미지는 보통 일정한 grid 위의 pixel tensor로 표현한다. 반면 3D 물체는 geometry뿐 아니라 질감, 재질, 조명에 따른 appearance까지 포함하며, 이를 표현하는 표준적인 형식이 하나로 정해져 있지 않다.
- Assignment 3-3: Denoising Diffusion Probabilistic Models Forward Diffusion, Reverse Diffusion, U-Net 기반 Noise Prediction, Reverse Sampling, Classifier-Free Guidance 구현 및 평가 이번 과제에서는 Denoising Diffusion Probabilistic Model(DDPM)의 핵심 구성요소를 구현하고, noisy image를 점진적으로 denoise하여 이미지를 생성하는 과정을 배운다. DDPM은 데이터 분포에서 바로 샘플을 생성하는 대신, 먼저 실제 이미지에 Gaussian noise를 점진적으로 추가하는 Forward Diffusion을 정의하고, 반대로 노이즈에서 이미지를 복원하는 Reverse Diffusion을 학습한다. Forward process 자체는 고정된 noise schedule에 의해 결정되며, 실제로 학습되는 부분은 각 timestep에서 noisy image를 보고 노이즈 또는 원본 이미지를 예측하는 denoising model이다. 이 denoising model로 U-Net을 사용한다.
- CS231n Lecture 14 - Generative Models 2 Generative adversarial networks, rectified flow, latent diffusion GAN은 discriminator와 generator의 adversarial game으로 data distribution을 암묵적으로 맞추고, diffusion과 rectified flow는 노이즈와 데이터 사이의 경로를 학습해 반복적인 reverse process로 샘플을 생성한다. 명시적 밀도 모델(explicit density model)은 데이터 에 대한 확률밀도 를 명시적으로 정의한다. Autoregressive model은 이를 정확하게 계산하고, VAE는 로그우도의 하한인 ELBO를 계산한다.
- CS231n Lecture 13 - Generative Models 1 Maximum likelihood, autoregressive models, variational autoencoders Generative model은 data를 만든 probability distribution을 학습하는 모델이며, autoregressive model은 chain rule로 exact likelihood를 계산하고 VAE는 latent variable과 ELBO를 도입해 tractable한 lower bound로 학습한다. Supervised learning에서는 input과 target의 pair가 주어진다.
- 논문 리뷰: Self-Attentive Sequential Recommendation SASRec 리뷰 논문: Self-Attentive Sequential Recommendation 저자: Wang-Cheng Kang, Julian McAuley 학회: IEEE International Conference on Data Mining (ICDM) 연도: 2018 논문 링크: arXiv:1808.09781 ---
- Assignment 3-2: Self-Supervised Learning for Image Classification SimCLR의 data augmentation, NT-Xent loss 구현과 self-supervised representation의 image classification 평가 이번 과제에서는 label 없이 image representation을 학습하는 self-supervised learning과 SimCLR의 contrastive learning을 구현하고, 학습된 representation이 downstream image classification에 얼마나 유용한지 평가한다. Supervised learning은 이미지와 사람이 붙인 class label의 관계를 학습한다. 반면 self-supervised learning은 data 자체에서 학습 신호를 만든다. SimCLR에서는 같은 이미지에 서로 다른 random augmentation을 적용해 두 view를 만들고, 이 둘을 positive pair로 취급한다. Model은 positive pair의 representation을 가깝게 만들고, batch 안의 다른 이미지에서 나온 view는 멀어지게 학습한다.
- [Google Recommendation Systems 06] Retrieval, Scoring, Re-ranking 추천 시스템의 retrieval, scoring, re-ranking 파이프라인과 freshness, diversity, fairness Google 공식 원문: Retrieval, Scoring, Re-ranking, Course summary 대규모 추천 시스템은 corpus 전체를 하나의 복잡한 모델로 정렬하지 않는다. 수백만 개 이상의 item을 요청마다 모두 평가하면 latency와 compute 비용을 감당하기 어렵기 때문이다. 대신 대상을 단계적으로 줄이는 funnel 구조를 사용한다. Retrieval 또는 candidate generation: 전체 corpus에서 관련 가능성이 있는 candidate 수백수천 개를 빠르게 가져온다. Scoring과 ranking: 더 많은 feature와 복잡한 모델로 candidate의 relevance를 평가하고 순서를 정한다. Re-ranking: freshness, diversity, fairness, 정책 같은 추가 기준과 제약을 반영해 최종 노출 목록을 만든다.
- [Google Recommendation Systems 05] Softmax DNN과 Two-Tower Softmax DNN 추천 모델의 구조와 embedding 해석, negative sampling, two-tower 모델 Google 공식 원문: Deep neural network models, Softmax training 이전 글의 matrix factorization은 사용자와 item마다 하나의 embedding을 학습하고, 두 embedding의 내적으로 선호도를 예측했다. 단순하고 대규모 corpus에도 잘 확장되지만 다음과 같은 한계가 있다. user ID와 item ID 이외의 side feature를 모델에 넣기 어렵다. 학습 데이터에 없던 새로운 user나 item을 바로 처리하기 어렵다. dot product를 그대로 사용하면 norm이 큰 인기 item이 많은 사용자에게 반복해서 추천되기 쉽다. 사용자의 현재 문맥이나 구체적인 관심사를 세밀하게 반영하기 어렵다.
- [Google Recommendation Systems 04] Collaborative filtering과 matrix factorization User-item interaction에서 latent embedding을 학습하는 collaborative filtering과 weighted matrix factorization 공식 원문: Collaborative filtering: Basics, Matrix factorization, Advantages & disadvantages Collaborative filtering은 여러 사용자의 user–item interaction을 함께 이용해 user와 item의 latent embedding을 자동으로 학습하며, matrix factorization은 feedback matrix 를 저차원 행렬 와 의 곱으로 근사해 관측되지 않은 선호를 예측하는 대표적인 collaborative filtering 방법이다.
- [Google Recommendation Systems 03] Content-based filtering Item feature와 user profile의 유사도로 추천하는 content-based filtering의 원리와 장단점 공식 원문: Content-based filtering: Basics, Advantages & disadvantages Content-based filtering은 item과 사용자를 같은 feature space의 vector로 표현하고 두 vector의 similarity로 candidate의 relevance를 계산하는 방법이며, 다른 사용자의 행동 없이 개인의 취향을 세밀하게 반영할 수 있지만 추천 품질이 사람이 설계한 feature와 사용자의 기존 관심사에 크게 제한된다.
- 논문 리뷰: Attention Is All You Need Transformer 논문: Attention Is All You Need 저자: Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, Illia Polosukhin 학회: Neural Information Processing Systems (NIPS) 연도: 2017 논문 링크: arXiv:1706.03762 ---
- CS231n Lecture 12 - Self-Supervised Learning Pretext task, MAE, contrastive representation learning Self-supervised learning(자기지도학습)은 label이 없는 data 자체에서 학습 목표를 만들고, reconstruction이나 contrastive objective를 통해 다양한 downstream task에 재사용할 수 있는 representation을 학습하는 방법이다. Supervised learning은 input과 사람이 만든 label의 쌍을 사용한다. Image classification의 class label도 비용이 들지만, object detection의 bounding box나 semantic segmentation의 pixel label은 훨씬 더 많은 작업을 요구한다. 새로운 domain으로 옮길 때마다 같은 규모의 label을 다시 만드는 것도 어렵다.
- [Google Recommendation Systems 02] Candidate generation과 embedding 추천 후보를 생성하는 두 가지 접근과 embedding 공간의 의미, cosine/dot product/Euclidean distance의 차이와 선택 기준 Google 공식 원문: Candidate generation overview Candidate generation은 전체 corpus에서 현재 query와 관련 있을 가능성이 높은 item을 빠르게 추려내는 추천 시스템의 첫 단계이다. 대규모 서비스에서는 모든 item을 정교한 scoring model에 넣을 수 없으므로, 이 단계가 수백만∼수십억 개의 item을 수백∼수천 개 수준의 후보로 줄인다.
- [Google Recommendation Systems 01] 추천 시스템 개요 대규모 추천 시스템이 필요한 이유와 item, query, embedding의 의미, candidate generation부터 re-ranking까지의 전체 구조 Google 공식 원문: Recommendation Systems 과정, Large-scale recommendation systems, Terminology, Recommendation systems overview 추천 시스템은 사용 가능한 전체 콘텐츠 가운데 현재 사용자에게 보여줄 만한 item을 골라 순서를 정하는 시스템이다. YouTube가 다음에 볼 영상을 제안하거나 Google Play가 홈 화면에 앱을 배열하는 과정이 대표적인 예이다.
- CS231n Lecture 11 - Large-Scale Distributed Training GPU cluster의 memory, communication, parallelism Large-scale distributed training은 거대한 model과 batch를 여러 accelerator에 나누는 것만으로 끝나지 않으며, GPU와 cluster의 계층적인 memory bandwidth에 맞춰 computation과 communication을 겹치고 data, parameter, sequence, layer 축의 parallelism을 조합해 Model FLOPs Utilization을 높이는 문제이다. Computer가 수행하는 작업은 크게 computation과 communication으로 나눌 수 있다. Computation은 input bit로부터 새로운 output bit를 계산하는 작업이다. Communication은 data를 한 memory 또는 device에서 다른 곳으로 옮기는 작업이다.
- 21. 표본분산과 Student t, Chi-square Distribution 모분산의 불편추정량인 표본분산을 유도하고, 평균과 분산의 추론에 사용되는 Student t 및 chi-square distribution을 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 21강 평균 , 분산 인 모집단에서 IID sample 을 얻었다고 하자. Sample mean은 다음과 같다.
- 20. 표본분포와 중심극한정리 모집단에서 IID 표본을 추출하고, 표본평균의 평균과 분산 및 중심극한정리를 이용한 정규근사를 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 20강 Descriptive statistics는 관측한 데이터를 평균, 분산, median 같은 값으로 요약한다. 데이터가 어떤 분포에서 나왔는지 완전히 알 수 없더라도 중심과 퍼짐을 간단히 표현할 수 있다.
- 19. Laplace Transform과 확률생성함수 비음수 연속 확률변수의 Laplace transform과 이산 확률변수의 probability-generating function을 정의하고 주요 성질을 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 19강 비음수 연속 확률변수 에 대해 강의에서 S-transform이라 부른 함수는 다음과 같다.
- 18. Fourier Transform과 특성함수 Fourier transform의 기본 관점에서 확률분포의 characteristic function을 정의하고, moment와 convolution에 관한 성질을 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 18강 Chapter 6의 변환은 확률변수에 함수를 적용해 새로운 확률변수를 만드는 것이었다. 이번 transform method는 함수가 표현되는 domain 자체를 바꾼다. 시간에 따른 함수 를 angular frequency 에 따른 함수 로 변환하는 Fourier transform은 다음과 같다.
- 17. 다변수 변환과 난수 생성 두 확률변수를 함께 변환할 때 Jacobian으로 결합 PDF를 구하는 방법과 inverse transform 및 Box-Muller 난수 생성을 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 17강 확률변수 , 로부터 두 개의 새 확률변수 , 를 만든다고 하자.
- 16. 이산 Convolution과 확률분포의 합 이산 확률변수의 합을 convolution으로 구하고, binomial 및 Poisson distribution의 합이 어떤 분포가 되는지 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 16강 정수 값을 갖는 두 이산 확률변수 , 의 합을 다음과 같이 정의한다.
- 15. 확률변수의 합과 Convolution 두 확률변수의 합에 대한 분포를 결합 PDF에서 유도하고, 독립인 경우 convolution으로 표현되는 과정을 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 15강 두 확률변수 , 를 더해 새로운 확률변수 를 만든다.
- 14. 확률변수의 함수와 분포 변환 확률변수에 함수를 적용해 새 확률변수를 만들었을 때 CDF와 PDF가 어떻게 변하는지 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 14강 확률변수 와 함수 를 이용해 새로운 확률변수 를 정의할 수 있다.
- 13. 다변량 정규분포와 공분산 행렬 여러 확률변수의 결합분포를 다항분포와 다변량 정규분포로 확장하고, 공분산 행렬이 변수 사이의 관계를 어떻게 나타내는지 정리한다. 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 13강 두 확률변수 , 의 결합분포에서 다룬 개념은 확률변수가 개인 경우에도 그대로 확장할 수 있다. 확률변수들을 하나의 vector로 모으면 다음과 같다.
- 12. 조건부 기댓값, 공분산과 상관계수 전체 기댓값의 법칙과 공분산·상관계수, uncorrelated와 independent의 차이 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 12강 라는 조건 아래에서 의 평균을 구하면 다음과 같다.
- 11. 조건부분포와 조건부 기댓값 비직사각형 영역의 이중적분, 조건부 PMF·PDF와 조건부 기댓값 및 분산 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 11강 연속 확률변수 의 joint PDF가 일 때, 순서쌍 가 영역 에 들어갈 확률은 다음과 같다.
- 10. 결합분포와 주변분포 여러 확률변수의 joint CDF·PMF·PDF와 marginalization, independence 조건 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 10강 확률변수 하나를 다룰 때는 가 특정 값이나 구간에 들어갈 확률을 구했다. 두 확률변수 를 함께 다룰 때는 두 조건이 동시에 일어날 확률을 생각한다.
- 9. 정규분포와 정규근사 정규분포의 표준화, Gaussian integral, binomial 분포의 정규근사와 Pascal 분포 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 9강 정규분포(normal distribution)는 Gaussian 분포라고도 하며, 연속 확률변수를 모델링할 때 가장 널리 사용되는 분포 중 하나이다. 측정오차나 여러 작은 요인의 합으로 생기는 noise를 나타낼 때 자주 사용한다.
- 8. 지수분포와 Erlang 분포 지수분포의 memoryless 성질, Poisson process와의 관계, Erlang 분포 및 quantization noise 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 8강 단위 시간당 평균 번 발생하는 사건의 개수를 생각하자. 길이가 인 시간 구간에서 발생한 사건의 수를 라고 하면 Poisson process에서는 다음 분포를 따른다.
- 7. Chebyshev 부등식과 이산 확률분포 Chebyshev 부등식의 의미와 Bernoulli·binomial 분포, geometric 분포의 memoryless 성질 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 7강 확률변수 의 값을 하나의 상수 로 예측한다고 하자. 예측값과 실제값 사이의 평균 제곱오차는 다음과 같다.
- 6. 기하분포와 조건부 평균 첫 성공까지의 시행 횟수를 나타내는 기하분포와 평균의 오차 최소화 해석, 조건부 평균 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 6강 성공 확률이 인 독립적인 시행을 성공할 때까지 반복한다고 하자. 첫 성공이 나올 때까지 수행한 전체 시행 횟수를 확률변수 로 정의하면 는 기하분포(geometric distribution)를 따른다.
- 5. 기댓값, 모멘트와 분산 확률변수의 기댓값과 모멘트, 분산, 기댓값의 선형성 및 Poisson 분포 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 5강 여러 관측값 의 산술평균은 다음과 같다.
- 4. 연속 확률변수와 균등분포 연속 확률변수의 PDF와 CDF 관계, 균등분포, sampling과 quantization 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 4강 이산 확률변수는 가능한 값을 하나씩 셀 수 있지만, 연속 확률변수(continuous random variable)는 어떤 구간 안의 실숫값을 연속적으로 가질 수 있다. 예를 들어 시간, 길이, 온도와 같은 측정값은 보통 연속 확률변수로 모델링한다.
- RMS 정규화 RMSNorm의 수식과 LayerNorm과의 차이, Transformer에서 자주 사용하는 이유 RMS 정규화(Root Mean Square Layer Normalization, RMSNorm)는 입력의 평균을 빼지 않고, 제곱 평균의 제곱근인 RMS를 이용해 입력의 크기만 조절하는 정규화 방법이다. 하나의 token에 대응하는 입력 vector를 라고 하자. 입력의 RMS는 다음과 같다.
- 3. 확률변수와 확률분포 표본공간을 실수로 매핑하는 확률변수의 정의와 CDF, 이산 확률변수의 PMF 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 3강 지금까지는 표본공간의 부분집합인 사건을 중심으로 확률을 다뤘다. 이제는 실험에서 나온 각 결과를 실수에 대응시켜 확률을 함수처럼 다룬다.
- 2. 경우의 수와 시스템 신뢰도 순열과 조합, 이항정리와 급수 계산, Stirling 근사, 직렬·병렬 시스템의 신뢰도 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 2강 전확률 정리에서 가장 먼저 확인해야 할 것은 무엇을 분할하는가이다.
- 1. 확률의 기본 개념 표본공간과 사건, 조건부 확률, 전확률과 Bayes 정리, 독립 사건과 결합 시행 정리 연결 강의: 이상화 교수 - 확률과 통계 (HYU 2014) 1강 확률을 다루려면 먼저 어떤 실험을 하고 있으며, 그 실험에서 어떤 결과가 나올 수 있는지를 정해야 한다.
- CS231n Lecture 10 - Video Understanding Spatiotemporal representation과 action recognition Video understanding은 image에 time dimension을 더한 spatiotemporal data에서 appearance와 motion을 함께 표현하는 문제이며, frame pooling부터 3D CNN, optical flow 기반 two-stream network, recurrent model, space-time attention까지의 차이는 결국 temporal information을 언제 어떻게 결합하느냐에 있다. RGB image 한 장은 일반적으로 다음과 같이 표현한다.
- CS231n Lecture 9 - Object Detection, Image Segmentation, and Visualization Dense prediction과 모델 시각화 Image segmentation과 object detection은 image-level classification을 pixel, region, object 단위의 dense prediction으로 확장한 문제이며, saliency map과 CAM(Class Activation Mapping) 계열 기법은 예측 score를 다시 image 공간에 연결해 model이 어느 영역을 사용했는지 해석한다. 같은 image를 입력받더라도 무엇을 출력하느냐에 따라 task가 달라진다.
- Sinusoidal Positional Encoding의 원리 여러 주기의 sin과 cos를 이용해 token의 위치를 embedding과 같은 차원의 vector로 표현하는 원리 Transformer의 self-attention은 입력 vector 사이의 관계를 계산하지만, token이 원래 몇 번째 위치에 있었는지는 스스로 알 수 없다. 따라서 token embedding에 위치정보를 별도로 넣어주어야 한다. Sinusoidal positional encoding은 token의 위치 를 여러 주파수의 sin과 cos로 변환하여 차원 vector 하나로 표현하는 방법이다.
- Assignment 3-1: Image Captioning with Transformers Attention 및 Transformer Block 구현, Image Captioning Transformer 의 Multi-Headed Attention 을 구현하고, Positional Encoding 의 원리와 구현, Transformer Block 을 만들고 COCO Dataset 으로 이미지 캡셔닝과 ViT를 구현한다. Multi-Headed Attention은 embedding을 여러 head로 나누어 각 head가 서로 다른 표현 공간에서 token 사이의 관계를 포착하도록 한다.
- CS231n Lecture 18 - Human-Centered AI human-centered computer vision, fairness, privacy, healthcare, assistive robotics Human-centered AI는 단순히 인간과 같은 시각 능력을 만드는 데서 끝나지 않고, 인간이 놓치는 정보를 보완하면서도 편향과 개인정보 보호를 다루고, 최종적으로는 인간이 실제로 원하고 가치 있다고 판단한 일을 안전하게 돕도록 AI의 목표와 평가 기준을 설계하는 관점이다. Computer vision은 오랫동안 인간의 시각 능력을 재현하는 문제로 발전해 왔다. 그러나 모델의 성능이 높아질수록 단순히 무엇을 인식할 수 있는지만으로는 충분하지 않다. 무엇을 보게 할 것인지, 무엇을 보지 않아야 하는지, 그 결과가 누구에게 어떤 영향을 주는지까지 함께 고려해야 한다.
- CS231n Lecture 8 - Attention and Transformers Attention 연산과 Transformer 구조 Attention은 query와 key의 유사도로 value를 가중합하는 연산이며, Transformer는 self-attention으로 token 사이의 정보를 섞고 FFN으로 각 token을 독립적으로 변환하는 block을 반복해 sequence를 처리한다. Sequence-to-sequence model은 길이가 다른 두 sequence 사이의 mapping을 학습한다. 기계번역에서는 영어 문장을 입력받아 이탈리아어 문장을 출력할 수 있으며, 두 문장의 단어 수와 어순은 서로 다를 수 있다.
- Assignment 2-5: RNN Captioning COCO image feature와 RNN language model을 연결한 image captioning 구현 미리 추출한 image feature를 초기 hidden state로 투영하고, 한 timestep씩 어긋난 caption을 teacher forcing으로 학습하여 매 시점의 다음 token을 예측하는 RNN image captioning model을 구현한다. 이번 과제는 2014 COCO Dataset의 image-caption pair를 사용한다. Image는 ImageNet으로 사전 학습한 VGG-16의 fc7 feature를 사용하며, 4096차원 feature를 PCA로 줄인 512차원 입력을 model에 넣는다. Caption은 각 word를 integer ID로 바꾼 sequence로 처리한다.
- Assignment 2-3: Convolutional Networks Convolution, Max Pooling, Spatial Batch Normalization, Group Normalization 구현 이번 과제에서는 CNN을 구성하는 convolution과 max pooling layer의 forward, backward를 직접 구현한다. 이어서 CNN의 activation shape인 에 맞춰 Spatial Batch Normalization을 구현하고, 채널을 여러 group으로 나누어 정규화하는 Spatial Group Normalization까지 구현한다.
- CS231n Lecture 7 - Recurrent Neural Networks RNN 구조와 sequence modeling RNN은 이전 hidden state와 현재 입력을 같은 가중치로 반복 처리해 가변 길이 sequence를 모델링하며, BPTT로 시간축을 따라 학습하지만 순차 계산과 vanishing gradient라는 한계가 있어 LSTM과 현대적인 state space model로 발전했다. 일반적인 image classifier는 하나의 고정된 크기 입력을 받아 하나의 고정된 크기 출력을 만든다. Sequence modeling에서는 입력이나 출력이 가변 길이 sequence가 될 수 있다.
- Assignment 2-2: Dropout Dropout 개념 및 구현 드롭아웃의 개념과 효과, 순전파 및 역전파를 구현한다. 드롭아웃(Dropout)은 훈련 시 drop probability 만큼 뉴런의 출력을 무작위로 0으로 만드는 규제 기법이다.
- Assignment 2-1: Batch Normalization Batch Norm, Layer Norm 이번 과제에서는 Batch Normalization 의 개념과 BatchNorm 레이어의 forward, backward 를 구현한다. 또한 Batch Norm과 Weight Initialization 의 관계, Batch Norm과 Batch Size와의 관계를 Baseline 기반으로 비교한다.
- CS231n Lecture 6 - Training CNNs and CNN Architectures CNN 구성 요소와 아키텍처, 초기화, 데이터 증강, 전이 학습, 학습 방법 CNN을 안정적으로 학습하려면 합성곱만 쌓는 것이 아니라 정규화, Dropout, 활성화 함수를 목적에 맞게 배치하고, 잔차 연결과 Kaiming 초기화로 깊은 신경망의 최적화를 안정화하며, 데이터 증강과 전이 학습, 올바른 디버깅 절차까지 하나의 학습 과정으로 연결해야 한다. CNN을 다룰 때는 두 문제를 구분해야 한다. 어떤 계층을 어떤 순서와 형태로 연결해 아키텍처를 만들 것인가? 만들어진 아키텍처가 실제 데이터에서 안정적으로 학습되도록 어떻게 준비하고 검증할 것인가?
- Assignment 1-5: Training a fully connected network FullyConnectedNet 구현, Momentum, RMSProp, Adam 이번 과제에서는 임의의 개수의 hidden layer를 갖는 FullyConnectedNet을 구현하고, 여러 optimizer를 직접 구현해본다. 앞에서 만든 TwoLayerNet이 하나의 hidden layer만 갖는 구조였다면, 여기서는 hidden layer 개수를 리스트로 받아 더 깊은 fully-connected network를 구성한다. 기본 구조는 다음과 같다.
- CS231n Lecture 5 - Image Classification with CNNs CNN 이미지 분류 CNN은 작은 필터를 이미지 전체에 공유하며 적용해 공간 구조를 보존하고, 단순한 경계부터 복잡한 물체 특징까지 계층적으로 학습하는 신경망이다. 앞선 강의에서는 이미지 분류를 예제로 딥러닝 시스템을 구성하는 기본 요소를 배웠다. 전체 흐름은 다음과 같이 정리할 수 있다. 입력과 출력을 텐서로 표현한다. 입력으로부터 출력 점수를 계산하는 모델을 정의한다. 모델의 예측이 얼마나 나쁜지를 측정하는 손실 함수를 정의한다. 역전파로 손실에 대한 파라미터의 기울기를 계산한다. 경사하강법 기반 최적화 알고리즘으로 파라미터를 갱신한다.
- Assignment 1-4: Higher Level Representations: Image Features HOG, HSV feature 추출과 feature 기반 분류기 학습 이번 과제에서는 원본 픽셀을 그대로 사용하는 대신, 이미지에서 hand-crafted feature를 추출한 뒤 분류기를 학습한다. 사용한 feature는 Histogram of Oriented Gradients, HOG와 HSV color histogram이다. 전체 흐름은 다음과 같다. 각 이미지에서 HOG feature를 추출한다. 각 이미지에서 HSV hue channel 기반 color histogram을 추출한다. 두 feature vector를 이어 붙여 하나의 feature vector로 만든다. 추출된 feature 위에서 Softmax linear classifier를 학습한다. 같은 feature 위에서 TwoLayerNet을 학습한다.
- Assignment 1-3: Two-Layer Neural Network 완전연결계층 구현 Fully-Connected Neural Nets 과제에서는 neural network를 구성하는 기본 layer들을 모듈 단위로 구현한다. 이번 과제에서 직접 구현한 핵심은 affineforward, affinebackward, reluforward, relubackward, softmaxloss, 그리고 이들을 조합한 TwoLayerNet이다. 전체 구조는 다음과 같다.
- CS231n Lecture 4 - Neural Networks and Backpropagation Neural Networks, Backprop Neural network는 여러 linear transformation 사이에 nonlinearity를 넣어 복잡한 함수를 표현하고, backpropagation은 chain rule을 이용해 loss가 각 parameter에 미치는 영향을 효율적으로 계산하는 방법이다. Lecture 3에서는 loss function을 정의하고, regularization과 optimization으로 좋은 weight를 찾는 방법을 봤다. 하지만 지금까지의 모델은 여전히 linear classifier라서, 선 하나로 나눌 수 없는 데이터에는 한계가 있다.
- Assignment 1-2: Implement a Softmax classifier softmaxloss 구현, SGD 구현 softmaxloss 에 대해서 이해하고, svm loss와 softmaxloss의 차이를 확인하고, SGD를 적용해서 훈련을 수행하고, 검증 데이터로 하이퍼파라미터 결정하기 softmaxloss 는 모델이 정답 클래스에 얼마나 높은 확률을 부여했는지를 기준으로 손실을 계산하는 방법이다. score를 softmax로 변환하여 각 클래스의 확률을 계산 정답 클래스의 확률이 1에 가까울수록 loss가 작아짐 SVM loss와 달리 margin을 넘겨도 정답 확률을 더 키우는 방향으로 계속 학습 수식: logit(점수):
- CS231n Lecture 3 - Regularization and Optimization Regularization의 목적, L1/L2 정규화, gradient descent, SGD, momentum, RMSProp, Adam과 learning rate schedule Regularization은 모델이 training data에 너무 잘 맞는 것을 막아 test data에서 더 잘 동작하게 만드는 장치이고, optimization은 loss를 줄이는 방향으로 파라미터 를 찾는 과정이다. 이번 강의의 흐름은 loss function -> regularization -> gradient descent -> SGD -> momentum / RMSProp / Adam -> learning rate schedule로 이어진다.
- Assignment 1-1: k-Nearest Neighbor classifier kNN 구현, training, testing, cross-validation L1, L2 distance 에 대해 이해하고, k-Nearest Neighbors(kNN) 분류기를 직접 구현하고, 학습 데이터에 대해 성능을 측정하고, Cross-Validation (k-folds) 를 이용해 최적의 하이퍼파라미터 k를 찾기 k-Nearest Neighbors(kNN)는 테스트 샘플과 훈련 샘플 간의 거리를 계산하여 가장 가까운 k개의 이웃을 찾고, 다수결을 통해 클래스를 예측하는 분류 알고리즘이다. 학습 과정이 거의 없음 (Lazy Learning) 가장 가까운 k개의 데이터로 분류 거리 척도로 주로 Euclidean Distance(L2 distance) 사용 거리 계산:
- CS231n Lecture 2 - Image Classification with Linear Classifiers 이미지 분류 문제, 데이터 기반 접근, Nearest Neighbor와 K-NN, 선형 분류기의 입력 shape와 score 계산 정리 CS231n Lecture 2 내용을 개인 학습용으로 정리한 글이다. 이미지 분류는 이미지를 텐서 입력으로 받아, 미리 정해진 클래스 중 하나의 라벨을 예측하는 문제이다.
- CS231n Lecture 1 - Introduction 컴퓨터 비전의 문제 정의, 데이터 기반 접근, 이미지 분류와 딥러닝으로 이어지는 흐름 정리 CS231n Lecture 1 내용을 개인 학습용으로 정리한 글이다. 컴퓨터 비전은 픽셀 배열에서 의미를 뽑아내는 문제이며, 현대적 접근은 사람이 규칙을 만들기보다 데이터로 모델을 학습시키는 것이다. 우리 뇌에서 뉴런은 계층 구조를 지닌다. 강의에서는 Hubel과 Wiesel의 고양이 시각 피질 실험을 통해 단순한 선과 모서리에서 점차 복잡한 객체로 인식하는 계층적 구조가 밝혀졌다고 언급한다. 컴퓨터 비전은 이미지를 숫자 배열로 보고 의미를 예측하는 문제이다. 이미지 분류 모델은 픽셀의 표면적 차이를 넘어서 객체의 본질적인 패턴을 학습해야 한다. 데이터 기반 접근은 규칙을 직접 설계하지 않고, 대량의 데이터셋을 통해 모델이 분류 기준을 스스로 학습하게 하는 방식이다. 대표적인 예로 ImageNet이 있다.
- (사회복무)상락원 식권관리 시스템 개발일지-1 식권 판매를 빠르고 쉽게 해보자 진주시 종합사회복지관 상락원 식권관리시스템 개발일지
- AWS Summit 2026 마지막 세션 후기: AWS Trainium 기반 LLM 추론 A to Z Neuron 환경, Trainium 기반 LLM 추론, 성능 측정 지표와 최적화 전략을 가볍게 정리한 AWS Summit 2026 마지막 세션 후기 AWS Summit 2026에서 마지막으로 들은 세션은 AWS-Trainium 기반 LLM(Large Language Model, 대규모 언어 모델) 추론 A to Z: Neuron 환경 이해부터 성능 최적화까지였다. 하루 끝에 듣는 세션이라 집중력이 많이 떨어질 줄 알았는데, 의외로 가장 기억에 남았다. 단순히 "Trainium이 빠르다" 정도의 소개가 아니라, 실제로 LLM 추론을 Trainium 환경에서 돌리려면 어떤 것들을 봐야 하는지 전체 흐름을 잡아주는 세션이었다.
- BE(블룸에너지): NYSE, 2025.09.10 Bloom Energy의 수익구조, 경쟁사, 차별화 요소, 비용구조와 시장 위치. Bloom Energy(BE)는 고체산화물 연료전지(SOFC)를 기반으로 분산형 온사이트 전력 솔루션을 제공하는 기업이다. 이 글은 개인 공부용 기업 정리이며, 투자 권유가 아니다. Bloom Energy의 수익구조, 경쟁사와의 차이점, 비용구조, 고객 관점의 구매 포인트와 시장 확장 전략을 중심으로 정리한다.
- 7.2.1. Left and Right Inverses and the Pseudoinverse 네 기본 부분공간 관점에서 left inverse, right inverse, projection, pseudoinverse를 정리하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 33: Left and Right Inverses; Pseudoinverse 이번 강의는 left inverse, right inverse, pseudoinverse를 다룬다.
- 8.3. The Search for a Good Basis change of basis의 선형대수 구조와 JPEG, wavelet, image compression 예시를 함께 정리하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 31: Change of Basis; Image Compression 이번 강의는 change of basis, 즉 기저변환을 다룬다.
- 8.2. The Matrix of a Linear Transformation basis와 coordinates를 선택하면 linear transformation이 matrix로 표현되는 과정과 projection, derivative 예시 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 30: Linear Transformations and Their Matrices 앞 글에서는 linear transformation의 아이디어를 봤다.
- 8.1. The Idea of a Linear Transformation 좌표와 행렬을 잠시 내려놓고 선형변환의 의미, 예시, 비예시, 선형성 조건을 정리하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 30: Linear Transformations and Their Matrices 이번 강의는 linear transformation, 즉 선형변환을 다룬다.
- 7.2. Bases and Matrices in the SVD rank-one 행렬의 SVD 예시와 네 기본 부분공간의 orthonormal basis 관점에서 SVD 이해하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 29: Singular Value Decomposition 앞 글에서는 SVD의 기본 형태와 full-rank 예시를 봤다.
- 7.1. Image Processing by Linear Algebra SVD의 기본 형태, 행공간과 열공간의 직교기저, A^TA와 AA^T로 singular vector를 구하는 방법 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 29: Singular Value Decomposition 이번 강의는 singular value decomposition, 즉 SVD를 다룬다.
- 6.2.1. Similar Matrices and Jordan Form similar matrix의 의미, 대각화와의 관계, 반복 고유값에서 Jordan form이 필요한 이유 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 28: Similar Matrices and Jordan Form 이번 강의의 핵심 주제는 similar matrices이다.
- 6.5. Positive Definite Matrices positive definite matrix의 판별 조건, quadratic form, 최소점, ellipse와 ellipsoid의 기하적 의미 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 27: Positive Definite Matrices and Minima 이번 강의는 positive definite matrix를 다룬다.
- 6.4.1. Complex Matrices and Fast Fourier Transform 대칭행렬의 복소수 버전인 Hermitian matrix, unitary matrix, Fourier matrix와 FFT의 기본 아이디어 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 26: Complex Matrices; Fast Fourier Transform 이번 강의는 positive definite matrix로 들어가기 직전에 복소수 행렬을 정리하는 연결 강의이다.
- 6.4. Symmetric Matrices 대칭행렬의 실수 고유값, 직교 고유벡터, spectral theorem, positive definite matrix의 기본 판별법 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 25: Symmetric Matrices and Positive Definiteness 이번 강의는 symmetric matrix, 즉 대칭행렬을 다룬다.
- 10.3. Markov Matrices, Population, and Economics Markov 행렬의 정의, 고유값 1, steady state, 인구 이동 모델과 Fourier series로 이어지는 직교기저 관점 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 24: Markov Matrices; Fourier Series 이번 강의는 고유값과 고유벡터의 응용을 다루는 강의이다.
- 6.3. Systems of Differential Equations 고유값과 고유벡터로 선형 미분방정식 시스템을 풀고, 행렬지수 e^{At}와 안정성을 이해하기 연결 강의: MIT 18.06 Linear Algebra - Lecture 23: Differential Equations and exp(At) 이번 강의는 선형대수학을 미분방정식 시스템에 적용하는 내용이다.
- 6.2. Diagonalizing a Matrix 고유벡터 행렬을 이용한 대각화, 행렬의 거듭제곱, 대각화 가능 조건, Fibonacci 수열 예시 연결 강의: MIT 18.06 Linear Algebra - Lecture 22: Diagonalization and Powers of A 지난 강의에서는 eigenvalue와 eigenvector의 기본 방정식을 배웠다.
- Transformer Self-Attention을 기반으로 한 Transformer 구조, Encoder, Decoder, Masked Self-Attention과 Cross-Attention 정리 한빛미디어의 를 요약 정리한 글이다. Transformer는 Attention is All You Need(2017)에서 제안된 구조이다.
- 6.1. Introduction to Eigenvalues 고유값과 고유벡터의 정의, characteristic equation, projection, permutation, rotation matrix 예시 연결 강의: MIT 18.06 Linear Algebra - Lecture 21: Eigenvalues and Eigenvectors 이번 강의부터 eigenvalue와 eigenvector를 다룬다.
- Self-Attention 일반 Attention에서 Self-Attention으로 넘어가는 관점 전환과 Q, K, V의 역할을 정리한다. 한빛미디어의 를 요약 정리한 글이다. 일반 Attention은 다음 구조를 가진다. 기준: 현재 시점의 hidden state 참조: 전체 hidden states
- 5.3. Cramer's Rule, Inverses, and Volumes 크래머 공식, 여인수로 표현한 역행렬, 행렬식이 나타내는 넓이와 부피의 의미 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 20: Cramer's rule, inverse matrix, and volume 이번 내용은 행렬식의 마지막 응용에 관한 내용이다. 앞에서는 행렬식의 성질과 계산 공식을 배웠다. 이제는 그 행렬식이 실제로 어디에 쓰이는지를 본다.
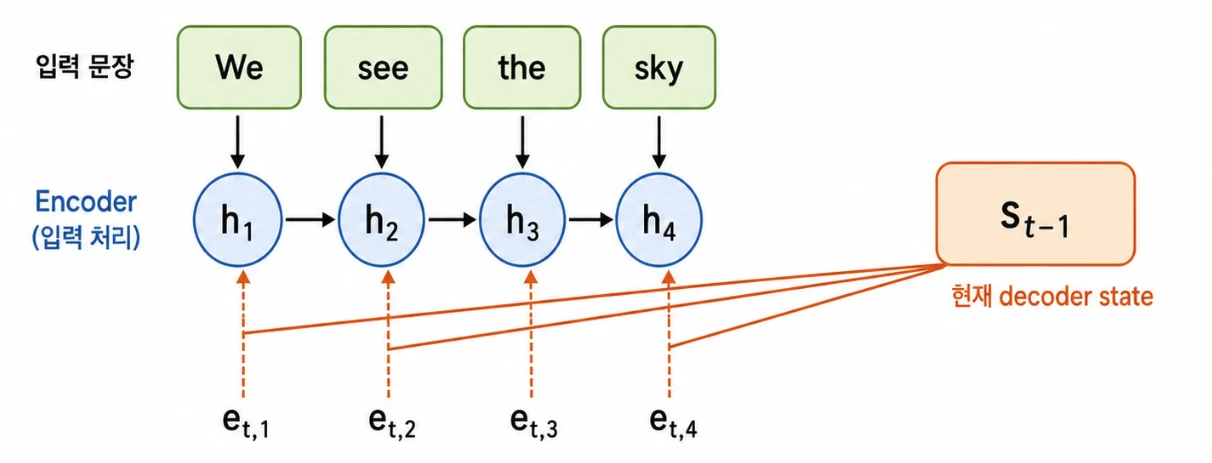
- Attention 직관 Decoder의 잠정 상태, attention score, attention weight, context vector 흐름 직관 한빛미디어의 를 요약 정리한 글이다. Attention은 Decoder가 현재 시점의 출력을 만들 때, Encoder의 전체 hidden states 중 어떤 정보를 얼마나 참고할지 학습하는 구조이다.
- 5.2. Permutations and Cofactors 순열 공식과 cofactor 전개로 determinant를 계산하는 방법 연결 강의: MIT 18.06 Linear Algebra - Lecture 19: Determinant formulas and cofactors 이번 강의는 determinant에 대한 두 번째 강의이다.
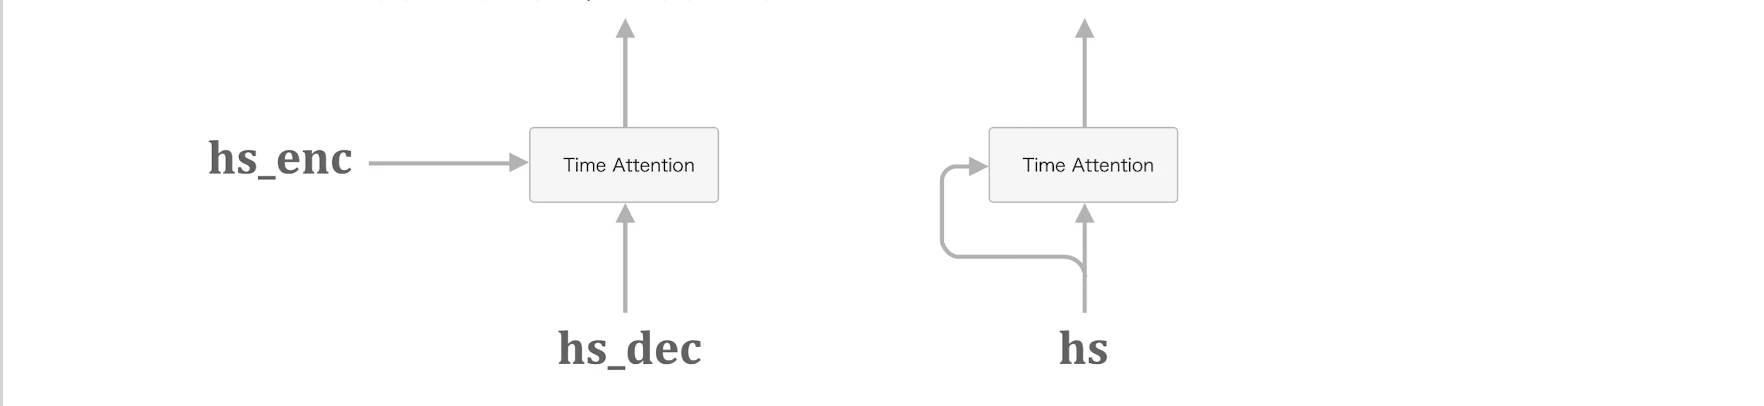
- Attention seq2seq의 고정 길이 벡터 한계를 보완하는 Attention 구조와 WeightSum, AttentionWeight, TimeAttention 구현 정리 한빛미디어의 를 요약 정리한 글이다. Transformer의 출발점이 된 논문은 Attention is All You Need(2017)이다.
- 5.1. The Properties of Determinants 행렬식의 기본 성질과 소거법, 가역성, 곱셈 법칙, 전치와의 관계 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 18: Properties of determinants 이번 강의부터는 선형대수학의 초점이 다시 정사각행렬로 이동한다.
- RNN 문장 생성 텐서 형상 RNN 문장 생성 과정에서 입력 임베딩, LSTM, 출력층, softmax까지의 텐서 형상을 정리한다. 한빛미디어의 를 요약 정리한 글이다. RNN 또는 LSTM 기반 언어 모델에서 문장을 생성할 때는 단어 ID 하나가 입력으로 들어가고, 모델은 다음 단어의 확률분포를 출력한다.
- 4.4. Orthonormal Bases and Gram-Schmidt 직교기저, 직교행렬, 그람-슈미트 과정, QR 분해 연결 강의: MIT 18.06 Linear Algebra - Lecture 17: Orthogonal matrices and Gram-Schmidt 이번 강의는 다음을 다룬다. 직교기저와 정규직교기저 직교행렬 정규직교기저를 사용하면 투영과 최소제곱 계산이 왜 쉬워지는지 일반 독립 벡터들을 정규직교 벡터들로 바꾸는 그람-슈미트 과정 그람-슈미트 과정을 행렬 언어로 표현한 QR 분해
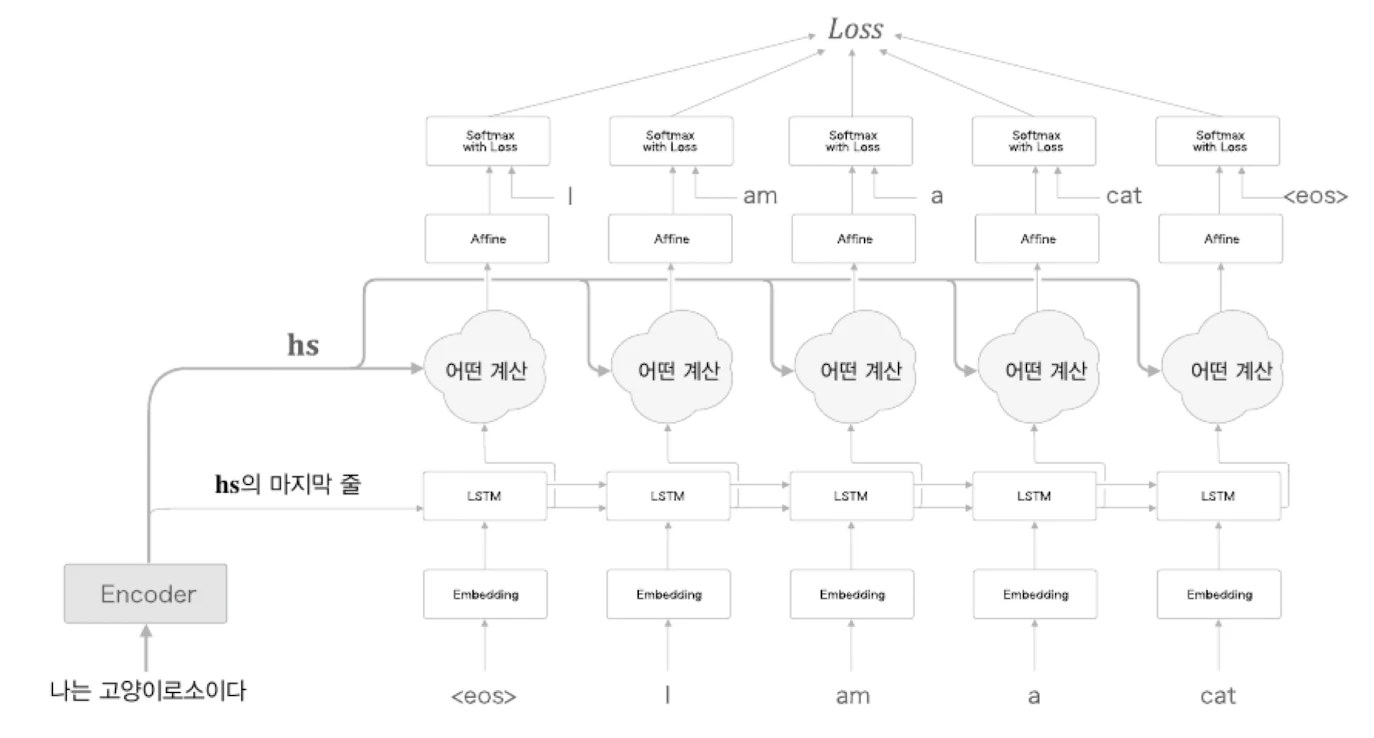
- RNN을 사용한 문장 생성 RNN 언어 모델을 이용한 문장 생성, seq2seq, Encoder-Decoder 구조와 Peeky 개선 한빛미디어의 를 요약 정리한 글이다. 언어 모델은 지금까지 주어진 단어를 바탕으로 다음에 출현할 단어의 확률분포를 출력한다.
- 4.3. Least Squres Approximations 최소제곱법 연결 강의: MIT 18.06 Linear Algebra - Lecture 16: Projection matrices and least squares 이번 강의의 핵심은 다음 세 가지이다. 프로젝션 행렬
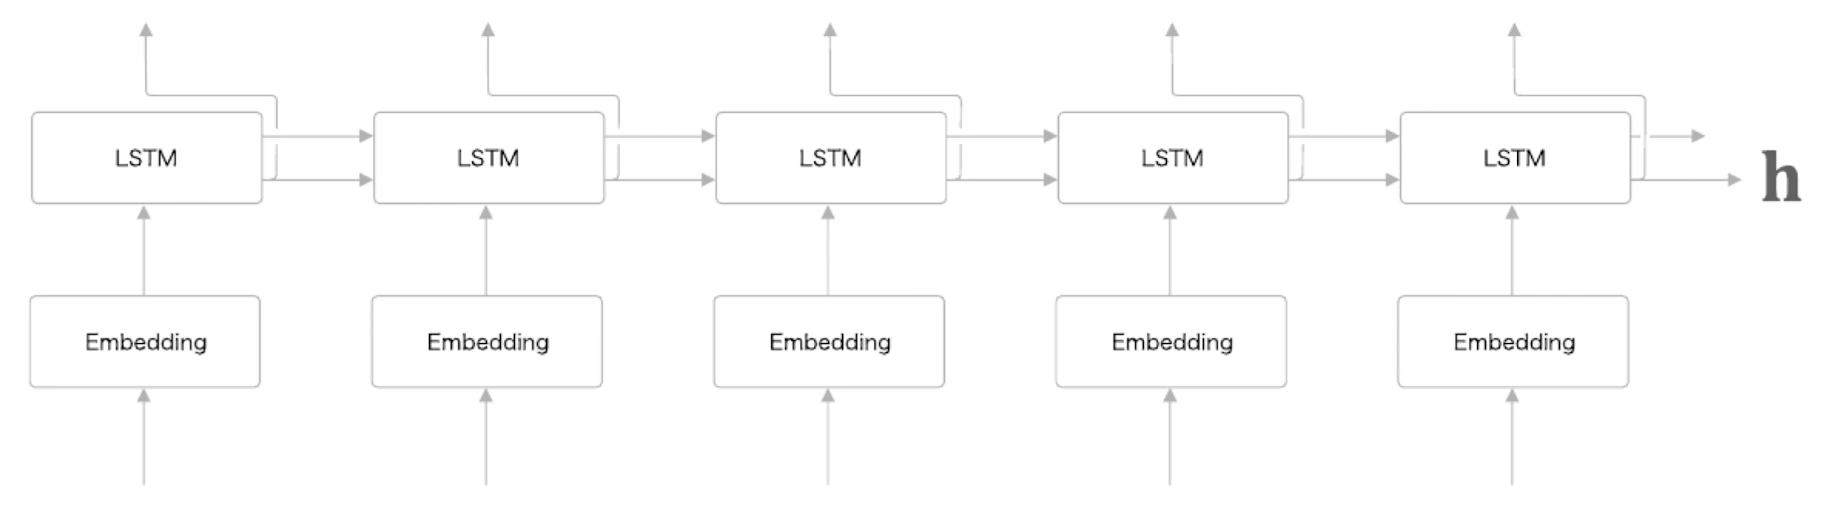
- Gated RNN 기본 RNN의 장기 의존성 문제와 LSTM의 게이트 구조, TimeLSTM 구현, RNNLM 개선 방법 한빛미디어의 를 요약 정리한 글이다. 기본 RNN은 시퀀스 데이터를 순서대로 처리할 수 있지만, 긴 시계열 데이터에서 멀리 떨어진 정보 사이의 의존 관계를 학습하기 어렵다.
- 4.2. Projection 투영 연결 강의: MIT 18.06 Linear Algebra - Lecture 15: Projections onto subspaces 프로젝션이란 어떤 벡터 를 어떤 부분공간 위로 가장 가깝게 내리는 것이라고 볼 수 있다. 가장 먼저 1차원 부분공간, 즉 가 만드는 직선 위로 를 내리는 경우를 생각할 수 있다.
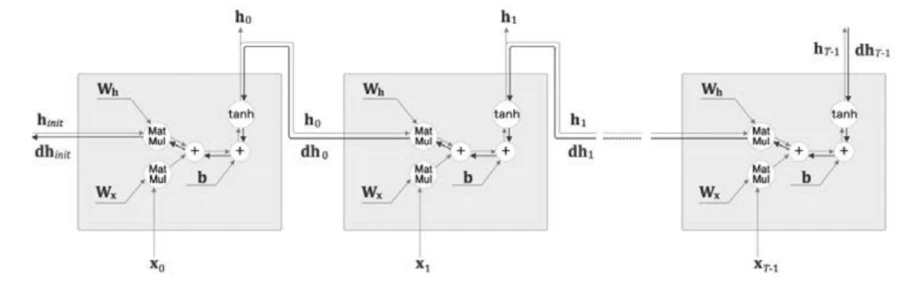
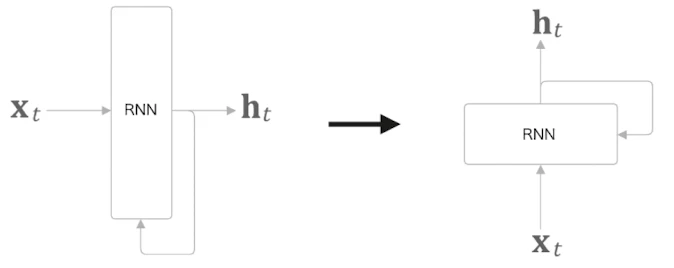
- RNN 순환 신경망의 구조, BPTT와 Truncated BPTT, TimeRNN과 RNN 언어 모델 한빛미디어의 를 요약 정리한 글이다. RNN(Recurrent Neural Network)은 시퀀스 데이터의 시간적 순서를 고려하기 위해 이전 상태 정보를 현재 계산에 반영하는 신경망이다.
- 4.1. Orthogonality of the Four Subspaces 직교와 부분공간 연결 강의: MIT 18.06 Linear Algebra - Lecture 14: Orthogonal vectors and subspaces 이번 강의의 핵심 주제는 직교성(orthogonality) 이다. 직교성은 벡터끼리, 부분공간끼리, 기저끼리 정의할 수 있으며, 기본적으로 서로 90도를 이룬다는 뜻이다.
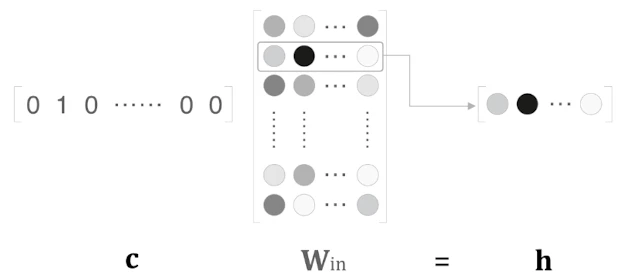
- Embedding과 Negative Sampling CBOW에서 Embedding 계층과 Negative Sampling을 사용해 계산량을 줄이는 과정 한빛미디어의 를 요약 정리한 글이다. CBOW 모델을 큰 어휘 집합에 그대로 적용하면 계산량이 매우 커진다.
- 3.5. The Four Fundamental Subspaces 부분공간 연결 강의: MIT 18.06 Linear Algebra - Lecture 11: Matrix spaces; rank 1; small world graphs 연결 강의: MIT 18.06 Linear Algebra - Lecture 12: Graphs, networks, incidence matrices 행렬 는 입력 공간 과 출력 공간 내에 4개의 핵심적인 부분공간(Subspace)을 정의한다. 이를 이해하는 것이 선형대수학의 기본 정리(Fundamental Theorem of Linear Algebra)의 핵심이다. 열공간과 좌영공간이 서로 직교 열공간의 벡터(A의 한 열)과 좌영공간의 벡터 의 직교: 열공간이므로, 로 표기. ( 의 한 행 = 의 한 열)
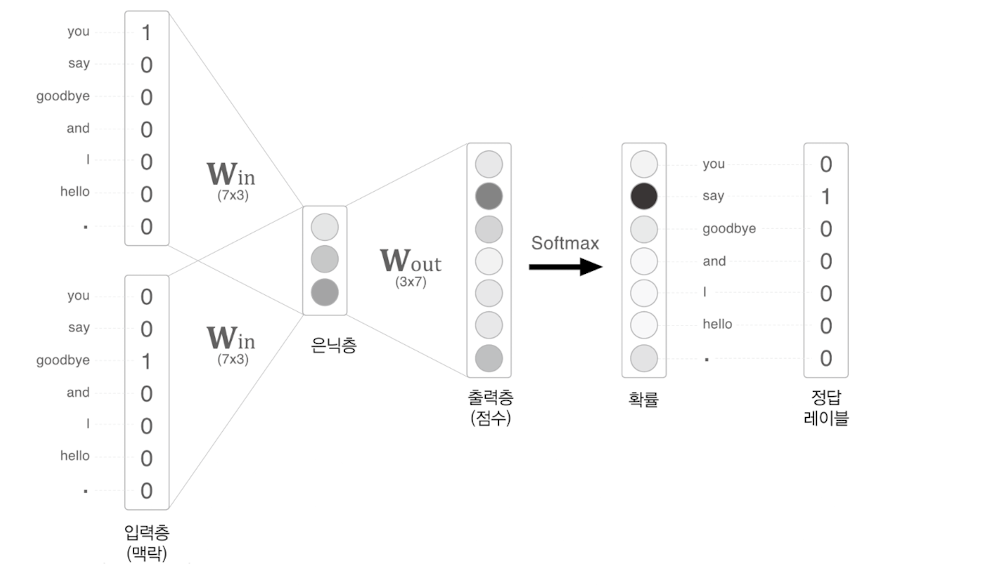
- CBOW CBOW의 구조, 임베딩 벡터와 NLL 손실, skip-gram과의 차이, 통계 기반 기법과 추론 기반 기법의 차이 한빛미디어의 를 요약 정리한 글이다. CBOW(Continuous Bag-of-Words)는 문맥(context) 단어들로부터 중앙(target) 단어를 예측하는 신경망 기반 언어 모델이다.
- 3.4. Independence, Basis, and Dimension 종속, 기저, 차원 연결 강의: MIT 18.06 Linear Algebra - Lecture 10: The four fundamental subspaces 벡터들의 집합 이 독립(Independent) 이라는 것은, 이들의 선형 결합이 영벡터가 되는 유일한 방법이 모든 계수가 0인 경우뿐이라는 뜻이다. 식: 은 오직 일 때만 성립한다. 만약 0이 아닌 가 하나라도 존재해서 을 만들 수 있다면, 그 벡터들은 종속(Dependent) 이다. 교재의 다른 표현: "하나의 벡터가 다른 벡터들의 조합으로 표현된다면 종속이다." () 평면에서의 예시 독립: 두 벡터가 일직선상에 있지 않을 때. 예: 과 . 종속: 두 벡터가 원점을 지나는 같은 직선 위에 있을 때. 예: , . 이때 이므로, 계수가 0이 아닌 해가 존재한다. 종속: 세 개의 벡터가 에 있을 때. ==평면 위의 세 벡터는 반드시 종속==이다. 공간에서의 예시 독립: 세 벡터가 같은 평면(Plane) 위에 있지 않
- PMI, SVD 단어 동시발생 빈도의 고빈도 편향 문제, PMI와 PPMI, PPMI 행렬에 SVD를 적용해 단어 벡터를 만드는 흐름 한빛미디어의 를 요약 정리한 글이다. PMI(Pointwise Mutual Information)는 두 단어가 기대보다 얼마나 자주 함께 등장하는지를 측정하는 지표이다.
- 3.3. The Complete Solution to Ax=b 완전해 연결 강의: MIT 18.06 Linear Algebra - Lecture 8: Solving Ax = b: row reduced form R 연결 강의: MIT 18.06 Linear Algebra - Lecture 9: Independence, basis, and dimension 의 완전해는 의 형태이다. 특수해(Particular Solution ) 는 를 해결하여 구한다. 여기서 는 특수해(particular solution)이고, 은 영공간(nullspace)에 존재하는 해이다. 기하학적으로 의 해집합은 의 해(영공간)를 만큼 평행 이동한 선(또는 평면)과 같다. 를 풀기 위해 행렬 에 벡터 를 붙인 첨가 행렬 를 구성한다. 소거법을 통해 를 형태로 변환하면, 원래 방정식 는 와 동치(equivalent)가 된다. 방정식이 해를 가지려면(solvable), 의 영행(zero rows)에 대응하는 의 성분이 반드시 이어야 한다. 즉, 의
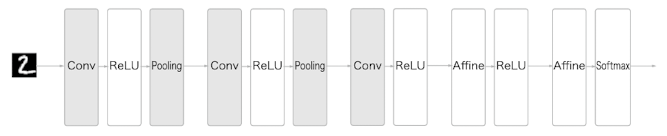
- 합성곱 신경망(CNN) CNN의 기본 구조, 합성곱 연산, 패딩, 스트라이드, 3차원 합성곱, 배치 처리와 풀링 계층 한빛미디어의 을 요약 정리한 글이다. 합성곱 신경망(CNN, Convolutional Neural Network)은 합성곱 계층과 풀링 계층이 추가된 신경망이다.
- 3.2. The Nullspace of A, Solving Ax=0 and Rx=0 영공간 연결 강의: MIT 18.06 Linear Algebra - Lecture 7: Solving Ax = 0: pivot variables, special solutions 영공간 는 을 만족하는 모든 해 벡터들의 집합이다. 이 해 는 (n-차원 공간)에 속한다. (영벡터)는 항상 영공간 에 포함된다. 는 의 부분공간(subspace)이다. (즉, 영공간 내의 벡터끼리 더하거나 스칼라 배를 해도 여전히 영공간에 속한다.) 행렬 에 기본 행 연산(소거)을 적용하여 상삼각행렬 나 기약 행 사다리꼴 을 만들어도 영공간은 변하지 않는다. 따라서 의 해를 구하는 것은 의 해를 구하는 것과 같다. 피벗(Pivot): 소거 후 각 행에서 0이 아닌 첫 번째 성분. 피벗 변수 (Pivot Variables): 피벗을 포함하는 열(column)에 해당하는 변수들이다. 자유 변수 (Free Variables): 피벗이 없는 열에 해당하는 변수들이다. 랭크 (Rank)
- 3.1. Space of Vector 벡터공간 연결 강의: MIT 18.06 Linear Algebra - Lecture 6: Column space and nullspace 벡터 공간은 덧셈과 스칼라곱에 대해 닫혀 있는 벡터들의 집합이다.
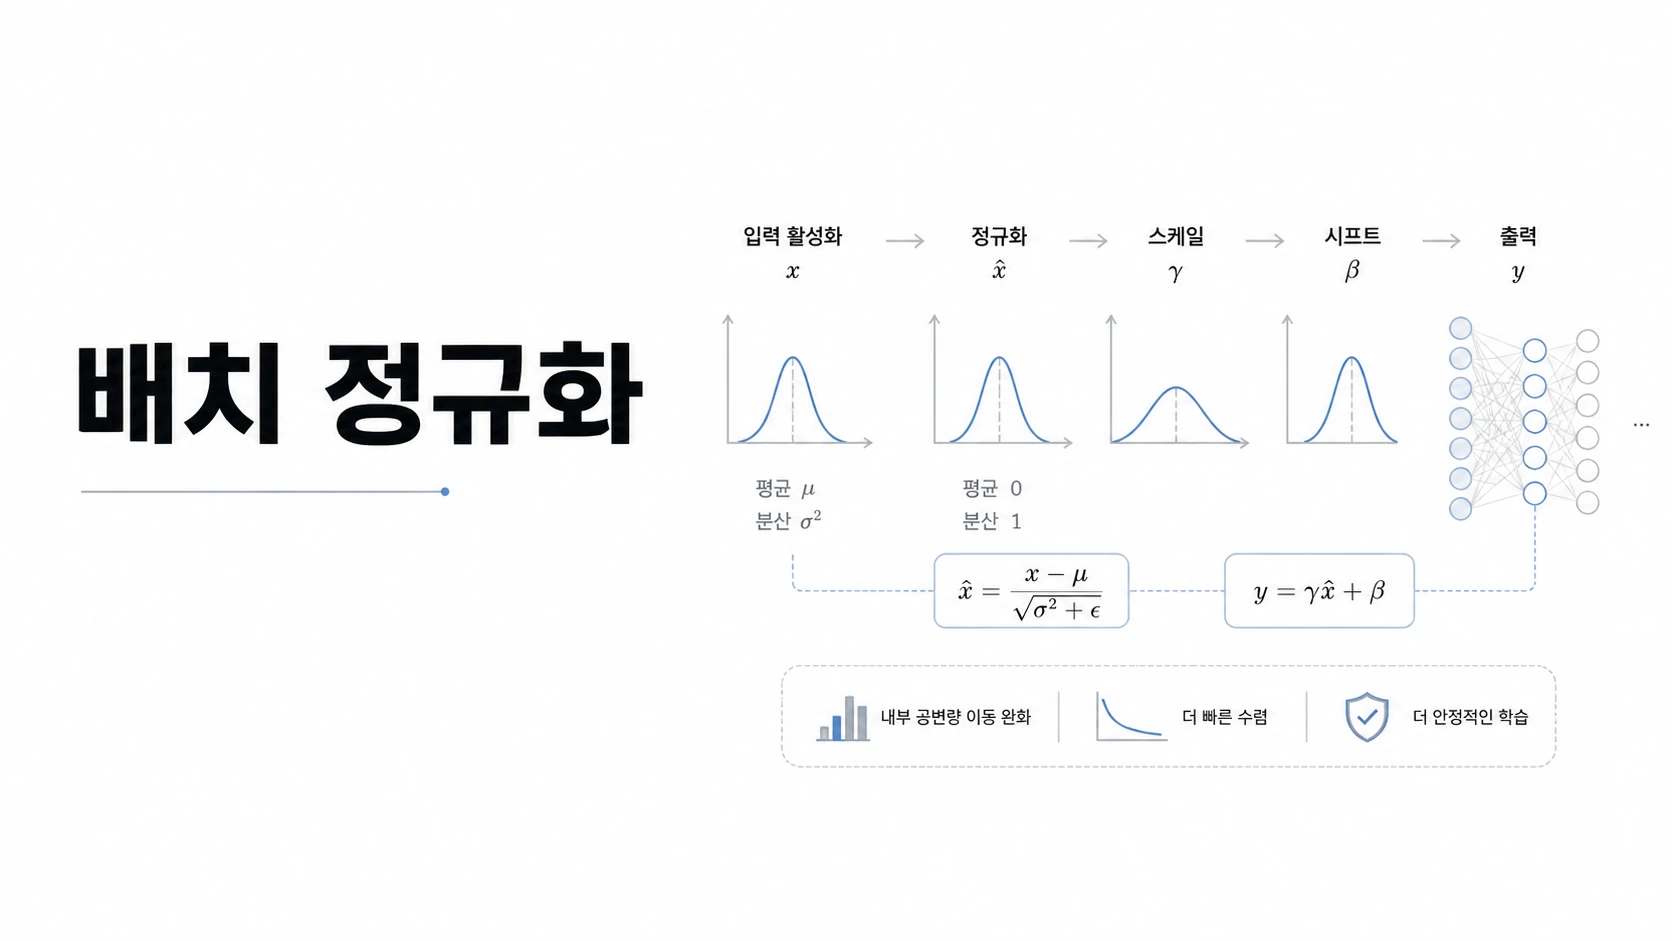
- 배치 정규화 배치 정규화의 정의, 필요성, 순전파와 역전파 계산, 학습 안정화 효과 배치 정규화(Batch Normalization, BN)는 딥러닝에서 학습을 안정적이고 빠르게 하기 위해 각 층의 출력을 정규화하는 기법이다. 각 층의 활성화값이 적당히 분포되도록 조정한다. 즉, 활성화값을 적당히 퍼뜨리도록 강제하여 분산이 너무 커지거나 작아지지 않게 유지한다.
- 2.7 Transpose and Permutations 전치, 순열 행렬 연결 강의: MIT 18.06 Linear Algebra - Lecture 5: Transposes, permutations, spaces R^n 전치 행렬 와 순열 행렬 는 선형대수에서 매우 자주 등장하는 기본 행렬이다.
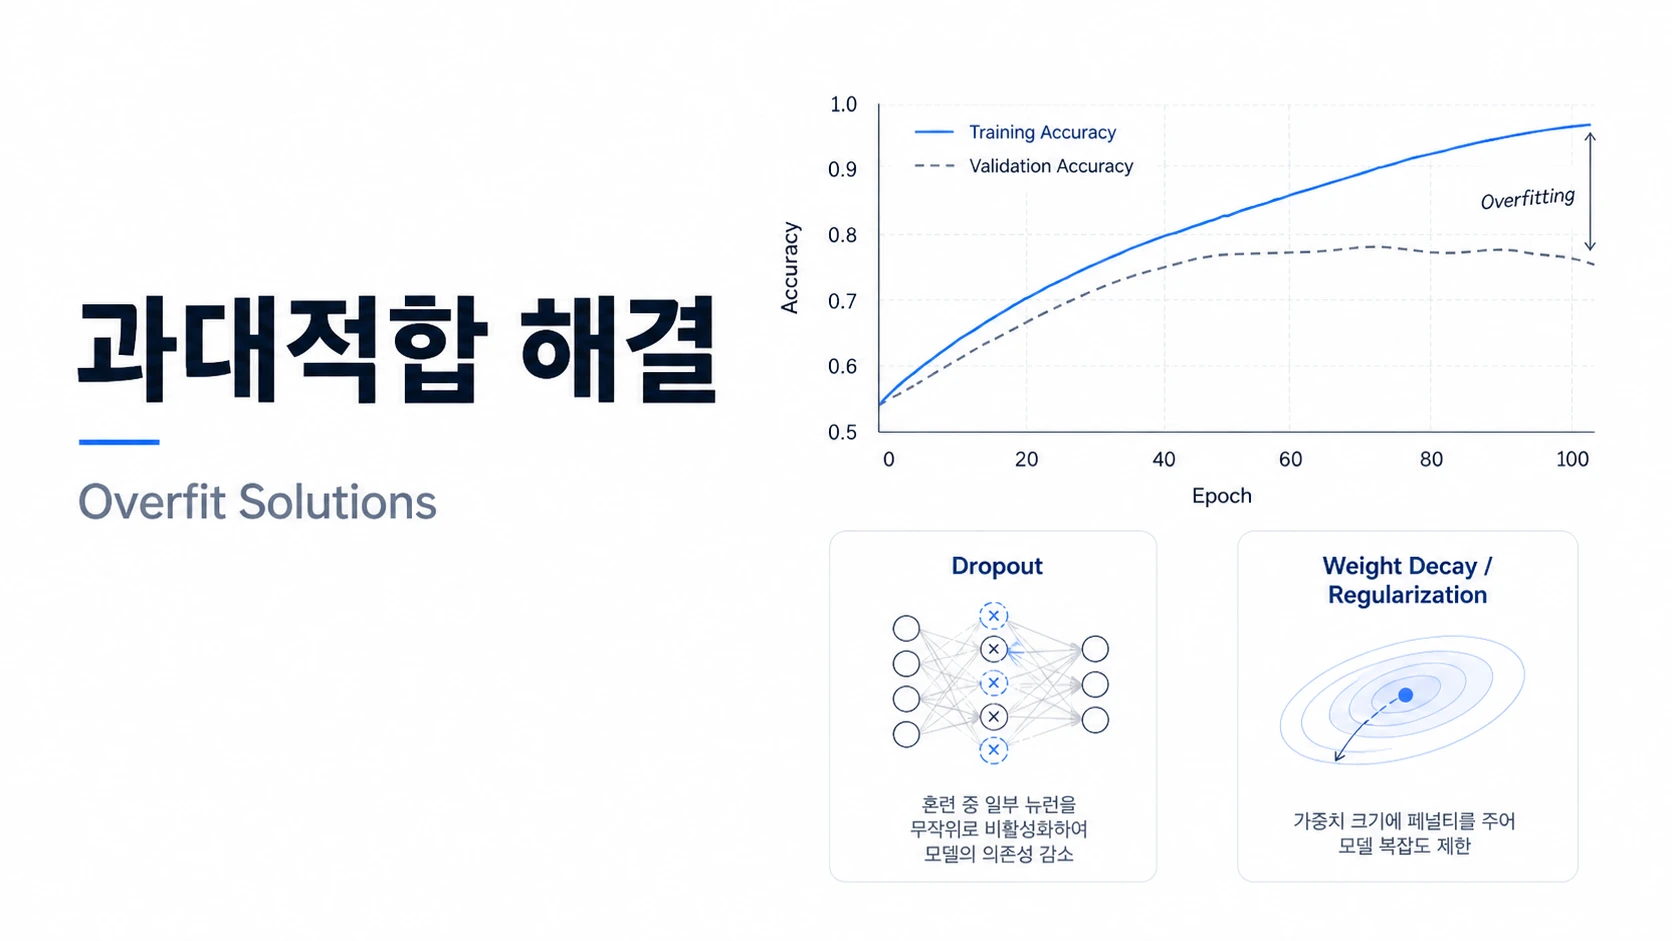
- 과대적합(Overfit) 해결 과대적합의 정의와 발생 상황, 가중치 감소와 드롭아웃을 통한 해결 방법 과대적합(Overfitting)은 신경망이 훈련 데이터에만 지나치게 적응되어, 처음 보는 데이터에는 제대로 대응하지 못하는 현상이다. 훈련 데이터에서는 높은 정확도를 보이지만 테스트 데이터에서는 성능이 낮아진다면 과대적합을 의심할 수 있다.
- 2.6 Elimination = Factorization, A=LU 제거, 인수분해 연결 강의: MIT 18.06 Linear Algebra - Lecture 4: LU and LDU factorization 가우스 소거법에서 소거 과정을 나타내는 행렬을 라고 할 때, 그 역행렬은 로 나타낼 수 있다.
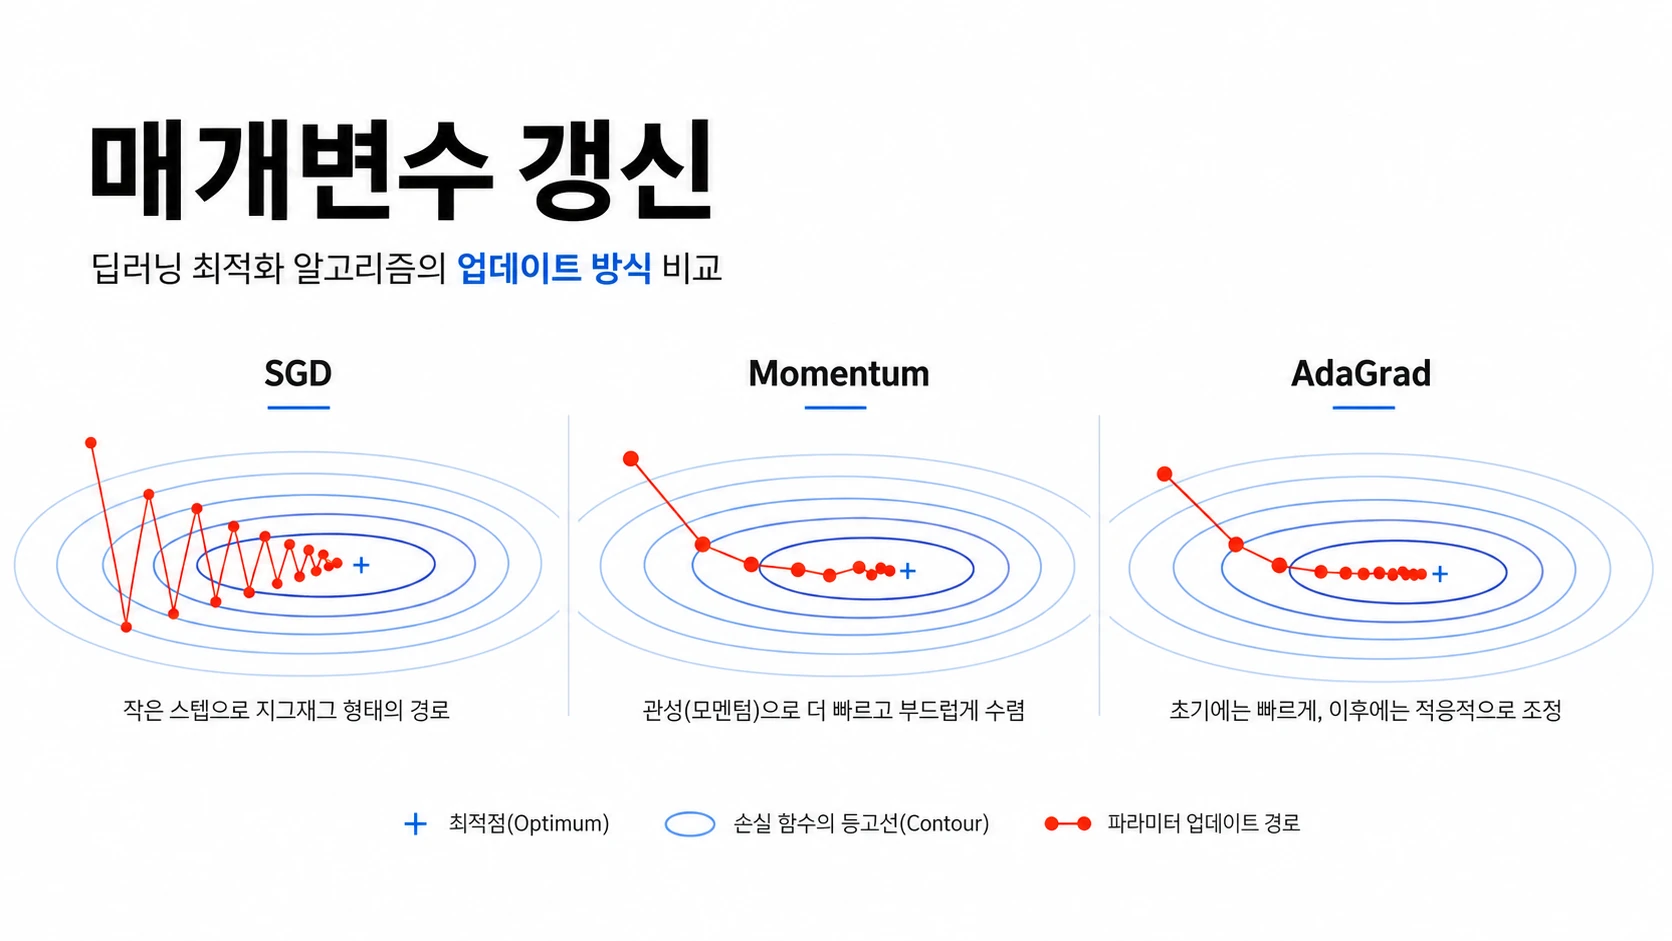
- 매개변수 갱신 SGD의 한계와 Momentum, AdaGrad를 통한 매개변수 갱신 방법 매개변수 갱신(Parameter Update)은 손실 함수의 값을 줄이기 위해 신경망의 가중치와 편향을 반복적으로 수정하는 과정이다. 신경망은 역전파를 통해 각 매개변수에 대한 기울기를 구하고, 이 기울기를 이용해 매개변수를 어느 방향으로 얼마나 이동시킬지 결정한다.
- 2.5. Inverse Matrices 역행렬의 정의, 가역성 판별, 소거행렬의 역, Gauss-Jordan 소거법 연결 강의: MIT 18.06 Linear Algebra - Lecture 3: Multiplication and inverse matrices 정사각행렬 에 대해 어떤 행렬 이 존재해서 다음을 만족하면, 를 invertible matrix라고 한다.
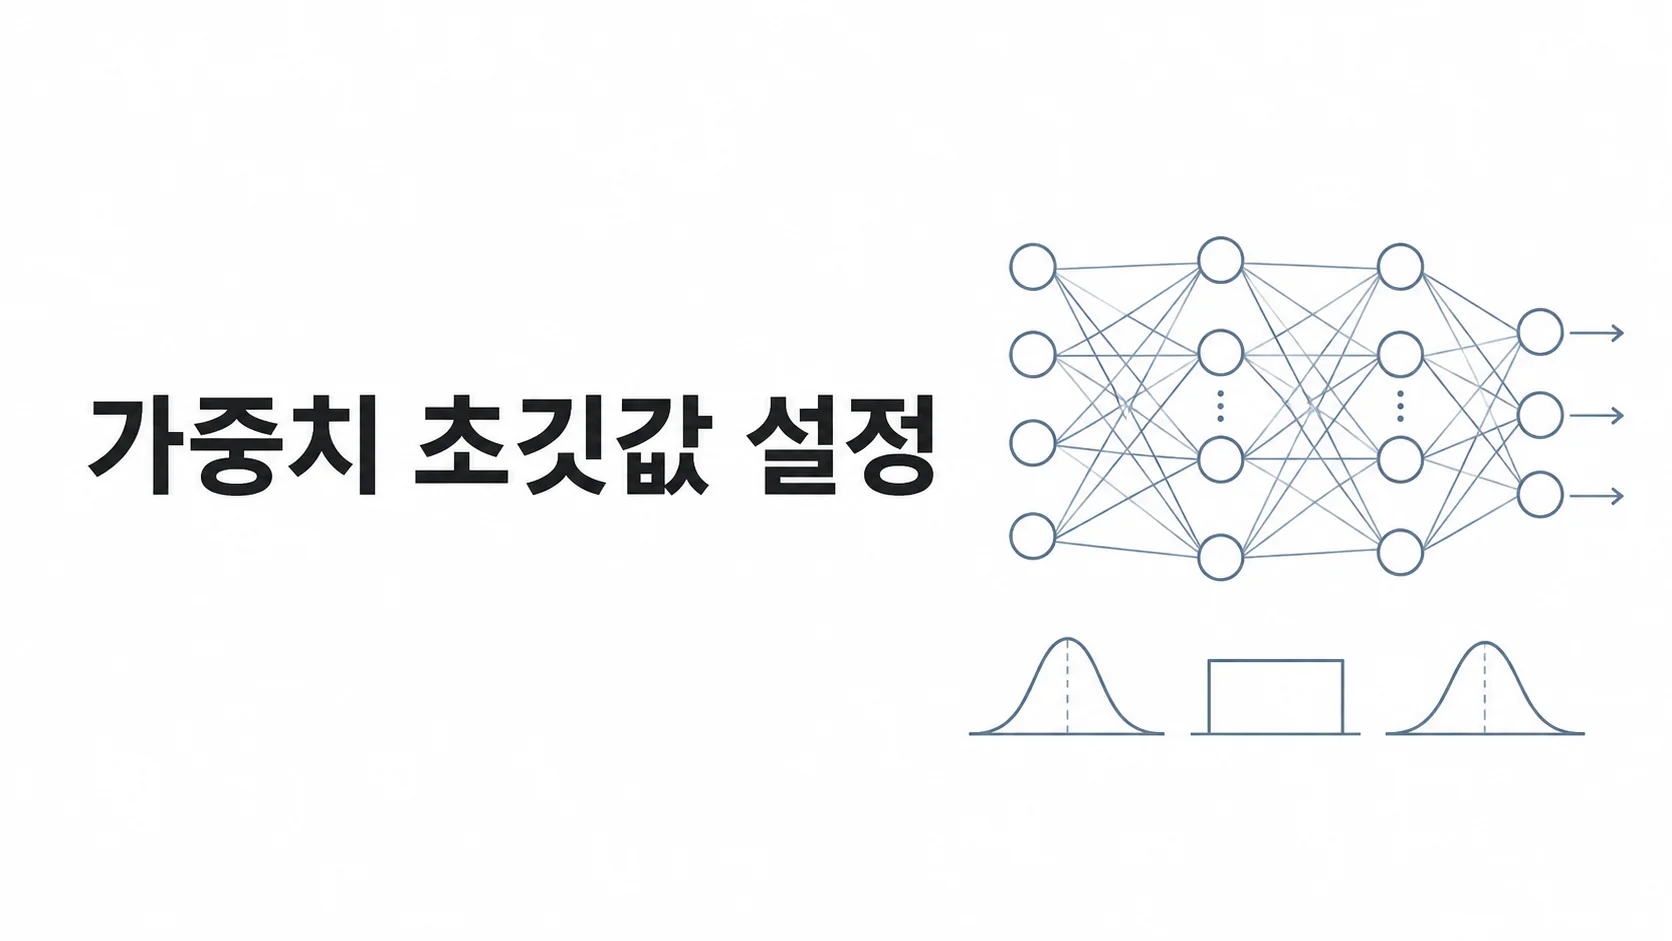
- 가중치 초깃값 설정 신경망 학습에서 가중치 초깃값이 중요한 이유와 Xavier 초기화, He 초기화의 직관 모든 가중치의 값이 동일하면 각 노드가 받는 기울기도 동일해진다. 이 경우 여러 노드를 가진 레이어를 사용하더라도 단일 노드 가중치 레이어와 큰 차이가 없어지고, 각 노드가 서로 다른 특징을 학습하지 못한다.
- 2.4 Rules for Matrix Operation 행렬 연산 규칙 연결 강의: MIT 18.06 Linear Algebra - Lecture 3: Multiplication and inverse matrices 행렬 와 행렬 를 곱하면, 결과 행렬 의 형상은 이다.
- 2.3 Elimination Using Matrices 행렬 이용 소거 연결 강의: MIT 18.06 Linear Algebra - Lecture 2: Elimination with matrices 다음 선형 방정식계를 생각한다.
- 2.2 The Idea of Elimination 소거법의 개념 연결 강의: MIT 18.06 Linear Algebra - Lecture 2: Elimination with matrices 가우스 소거법은 선형 방정식계 를 위삼각행렬 형태의 로 바꾼 뒤, 역대입(back substitution)으로 해를 구하는 방법이다.
- 2.1. Vectors and Linear Equations 벡터와 선형방정식 연결 강의: MIT 18.06 Linear Algebra - Lecture 1: The geometry of linear equations 선형 방정식은 여러 미지수의 선형결합으로 어떤 벡터 를 만드는 문제이다.
- 1.3. Matrix 행렬곱, 차분행렬, cyclic difference, 선형독립과 선형종속 연결 강의: MIT 18.06 Linear Algebra - Lecture 1: The geometry of linear equations 행렬과 벡터의 곱 는 여러 관점에서 볼 수 있다.
- 1.2. Lengths and Dot Products 길이와 내적 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 1: The geometry of linear equations 내적은 두 벡터의 대응되는 성분끼리 곱한 뒤 모두 더한 값이다.
- 1.1. Row Picture and Column Picture 선형방정식 Ax=b를 행 관점, 열 관점, 행렬 관점으로 바라보는 첫 정리 연결 강의: MIT 18.06 Linear Algebra - Lecture 1: The geometry of linear equations 선형대수학에서 가장 기본이 되는 문제는 선형방정식의 해를 구하는 것이다.
- 행렬 곱 역전파에서 전치행렬이 등장하는 이유 z = Wx 형태의 행렬 곱 노드에서 역전파 시 W의 전치행렬이 등장하는 과정 행렬 곱 노드의 순전파가 다음과 같다고 하자. 이때 역전파에서는 다음 식이 등장한다.
- 곱셈 노드의 역전파 계산 그래프에서 곱셈 노드가 역전파 시 입력과 기울기를 어떻게 전달하는지 정리한다. 곱셈 노드(Multiplication Node)는 계산 그래프에서 두 값을 곱하는 노드이다. 역전파에서는 출력 쪽에서 전달된 기울기에 대해, 각 입력의 반대쪽 값을 곱해서 기울기를 전달한다.
- 첫 공부 기록 Astro로 개인 공부 블로그를 시작하며 정리한 첫 글입니다. Astro로 개인 공부 블로그를 만들었다. 글은 Markdown 파일로 관리하고, Cloudflare Pages에 배포할 예정이다. 배운 내용을 짧게라도 남긴다. 에러가 나면 원인, 시도한 방법, 해결 방법을 같이 적는다. 나중에 다시 찾을 수 있도록 제목과 설명을 구체적으로 쓴다. 새 글은 src/content/blog 폴더에 .md 또는 .mdx 파일로 추가하면 된다.
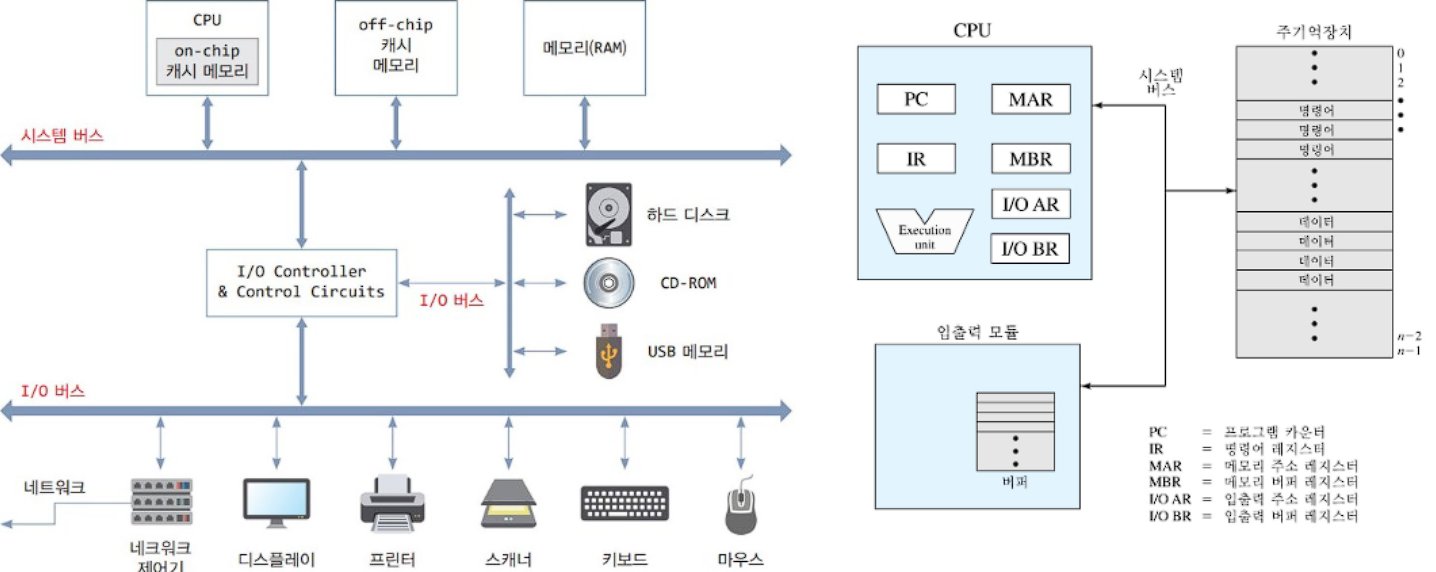
- 2. 컴퓨터 시스템과 운영체제 컴퓨터 시스템과 운영체제 정리 응용 소프트웨어 레이어, 운영체제 레이어, 컴퓨터 하드웨어 레이어 → 운영체제는 상위 계층과 하드웨어 간의 인터페이스 역할 수행, 상위 계층에게 하드웨어를 추상화
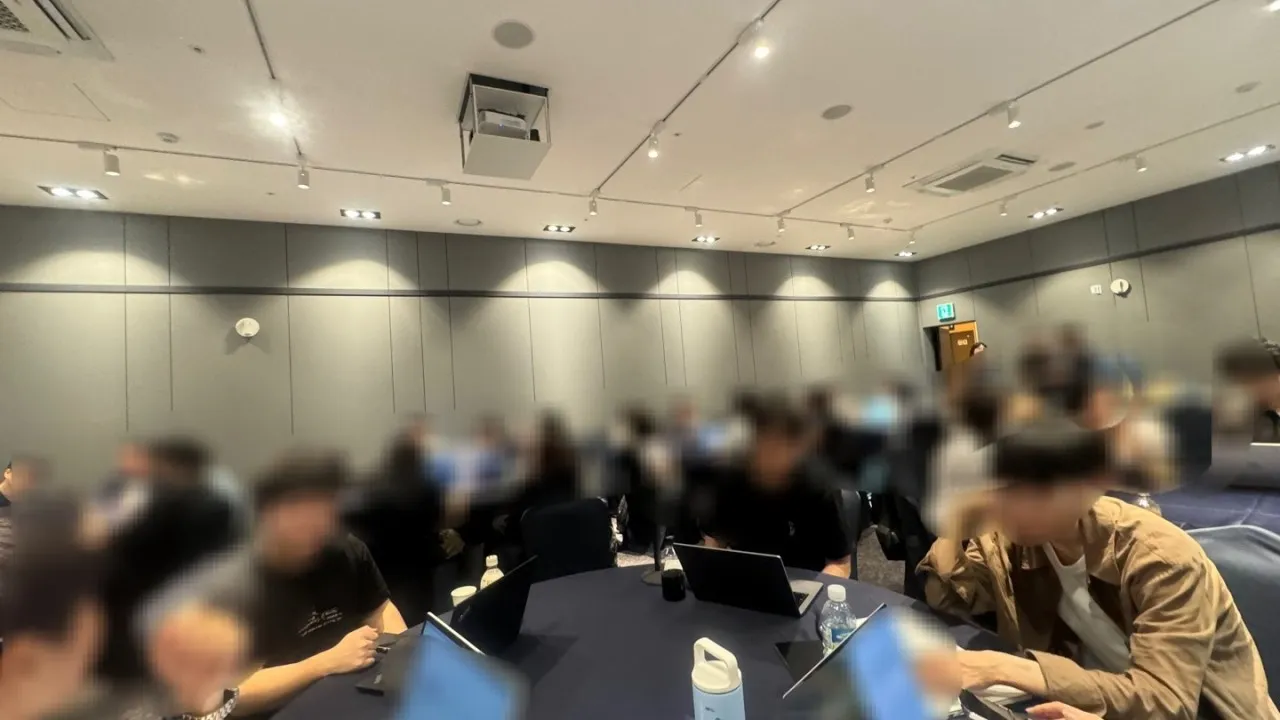
- ART 리빙랩 글로컬 해커톤(8/20~8/21) 후기 AWS와 NxtCloud가 함께한 ART 리빙랩 글로컬 해커톤 참가 후기 2024년 8월, 대전 라마다 호텔에서 열린 ART 리빙랩 글로컬 해커톤에 다녀왔다. AWS와 NxtCloud가 주관하고, 여러 대학이 공동으로 참여한 행사였다. LINC 3.0 참여 대학의 참여 학과 소속 학생이라면 신청할 수 있었고, 내가 있던 쪽에서는 신청자가 많지 않아 나를 포함해 총 세 명이 참가했다.
- [Spring] 스프링 트랜잭션 관리의 기본 개념과 원리 스프링 트랜잭션 관리의 도입 배경, 트랜잭션 추상화, 리소스 동기화, 선언적 트랜잭션 관리와 전파 속성 스프링 프레임워크는 개발자가 복잡한 트랜잭션 처리를 더 쉽게 다룰 수 있도록 강력한 트랜잭션 관리 기능을 제공한다. 이 글에서는 스프링의 트랜잭션 관리가 어떤 원리로 동작하는지, 그리고 기본적으로 어떤 개념을 바탕으로 구성되어 있는지 정리한다. 트랜잭션의 ACID 특성과 함께 스프링이 이를 어떻게 추상화하고 처리하는지 이해하는 것이 목적이다.
- [데이터베이스][MySQL] 트랜잭션 격리 수준과 MySQL 동작 방식 MySQL을 기준으로 트랜잭션 격리 수준, 트랜잭션 이상 현상, MVCC, Next-Key Lock의 동작 방식을 정리 데이터베이스를 활용한 애플리케이션을 개발할 때, 동시에 여러 사용자가 같은 데이터를 읽고 쓰는 상황은 흔하게 발생한다. 이러한 동시성 환경에서 데이터의 정합성을 유지하려면 트랜잭션의 격리 수준을 적절히 설정하는 것이 중요하다. 트랜잭션 격리 수준은 하나의 트랜잭션이 다른 트랜잭션의 작업에 어느 정도까지 영향을 받지 않도록 보호할지를 정의하는 기준이다.
- [데이터베이스][MySQL] 외래키와 잠금 대기 MySQL InnoDB에서 외래키 제약이 부모 테이블과 자식 테이블의 잠금 대기를 유발하는 방식을 정리한다. MySQL InnoDB에서 외래키는 부모 테이블과 자식 테이블 사이의 참조 무결성을 보장한다. 외래키 제약이 걸려 있으면 자식 테이블에 데이터를 추가하거나 수정할 때, 해당 값이 부모 테이블에 실제로 존재하는지 확인해야 한다. 반대로 부모 테이블의 레코드를 삭제하거나 외래키가 참조하는 값을 변경할 때는, 그 값을 참조하는 자식 레코드가 있는지 확인해야 한다.
- 동기/비동기, 블로킹/논블로킹 동기와 비동기, 블로킹과 논블로킹의 정의와 차이점, 조합 동기/비동기와 블로킹/논블로킹은 작업 처리 방식을 설명할 때 자주 함께 등장하는 개념이다. 두 개념은 비슷해 보이지만 구분 기준이 다르다. 동기/비동기: 작업이 순차적으로 진행되는지, 결과를 언제 어떻게 받는지에 대한 구분이다. 블로킹/논블로킹: 작업을 호출한 이후 제어권이 호출자에게 존재하는지에 대한 구분이다.
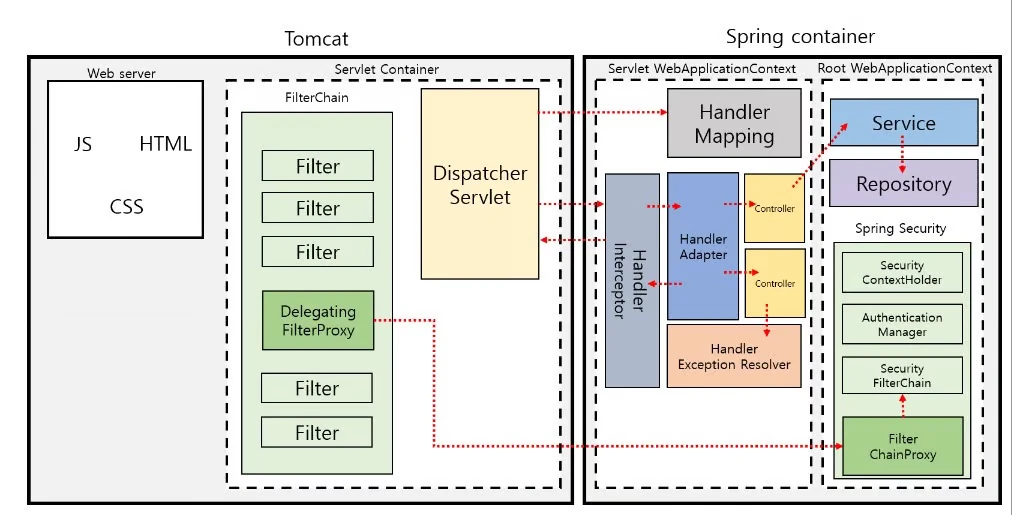
- 웹 서버, WAS, 서블릿, 톰캣, 스프링 MVC 웹 요청이 컨트롤러에 도달하기까지 WAS, 서블릿, 톰캣, Spring MVC의 관계 웹 애플리케이션에서 브라우저의 요청이 컨트롤러까지 도달하기 위해서는 여러 계층을 거친다. 정적 리소스를 처리하는 웹 서버, 동적 요청을 실행하는 WAS, 자바 HTTP 요청 처리 컴포넌트인 서블릿, 그리고 스프링 MVC의 핵심 서블릿인 DispatcherServlet이 이 흐름 안에서 각각 역할을 가진다.