
핵심 한 줄 정리
3D vision은 geometry와 appearance를 point cloud, mesh, voxel, implicit function 등으로 표현하고, 2D·3D 관측에서 이를 학습해 장면 복원과 새로운 시점의 이미지 합성에 사용한다.
중요 개념 정리
3D에서는 representation 선택부터 문제
2D 이미지는 보통 일정한 grid 위의 pixel tensor로 표현한다. 반면 3D 물체는 geometry뿐 아니라 질감, 재질, 조명에 따른 appearance까지 포함하며, 이를 표현하는 표준적인 형식이 하나로 정해져 있지 않다.
같은 물체도 다음과 같이 여러 방식으로 나타낼 수 있다.
- Point cloud(점군): 표면에서 샘플링한 3D 점 집합이다.
- Polygon mesh(다각형 메시): vertex(꼭짓점)와 그 연결 관계인 face(면)를 함께 저장한다.
- Parametric surface(매개변수 곡면): 낮은 차원의 parameter를 3D 좌표로 mapping한다.
- Implicit surface(음함수 곡면): 3D 좌표를 넣었을 때 표면과의 관계를 반환하는 함수로 표현한다.
- Voxel(복셀): 3D 공간을 regular grid(격자)로 나누어 occupancy(점유 여부)나 density(밀도)를 저장한다.
| Representation | 저장 내용 | 강점 | 한계 |
|---|---|---|---|
| Point cloud | 3D 점 집합 | 센서 출력과 가깝고 topology 제약이 없음 | 연결 관계와 매끄러운 표면이 없음 |
| Mesh | vertex와 face | 정확한 표면과 효율적인 렌더링 | 불규칙한 연결 관계를 neural network가 다루기 어려움 |
| Parametric surface | parameter-to-coordinate mapping | 점 샘플링과 매끄러운 표면 생성이 쉬움 | 복잡한 topology를 하나의 mapping으로 표현하기 어려움 |
| Implicit function | coordinate-to-property mapping | inside/outside query와 composition이 쉬움 | 표면 위 점을 직접 얻으려면 별도 추출이 필요함 |
| Voxel | regular 3D grid | 3D convolution을 바로 적용할 수 있음 | 해상도에 따라 memory와 연산량이 세제곱으로 증가함 |
Explicit와 implicit 구분
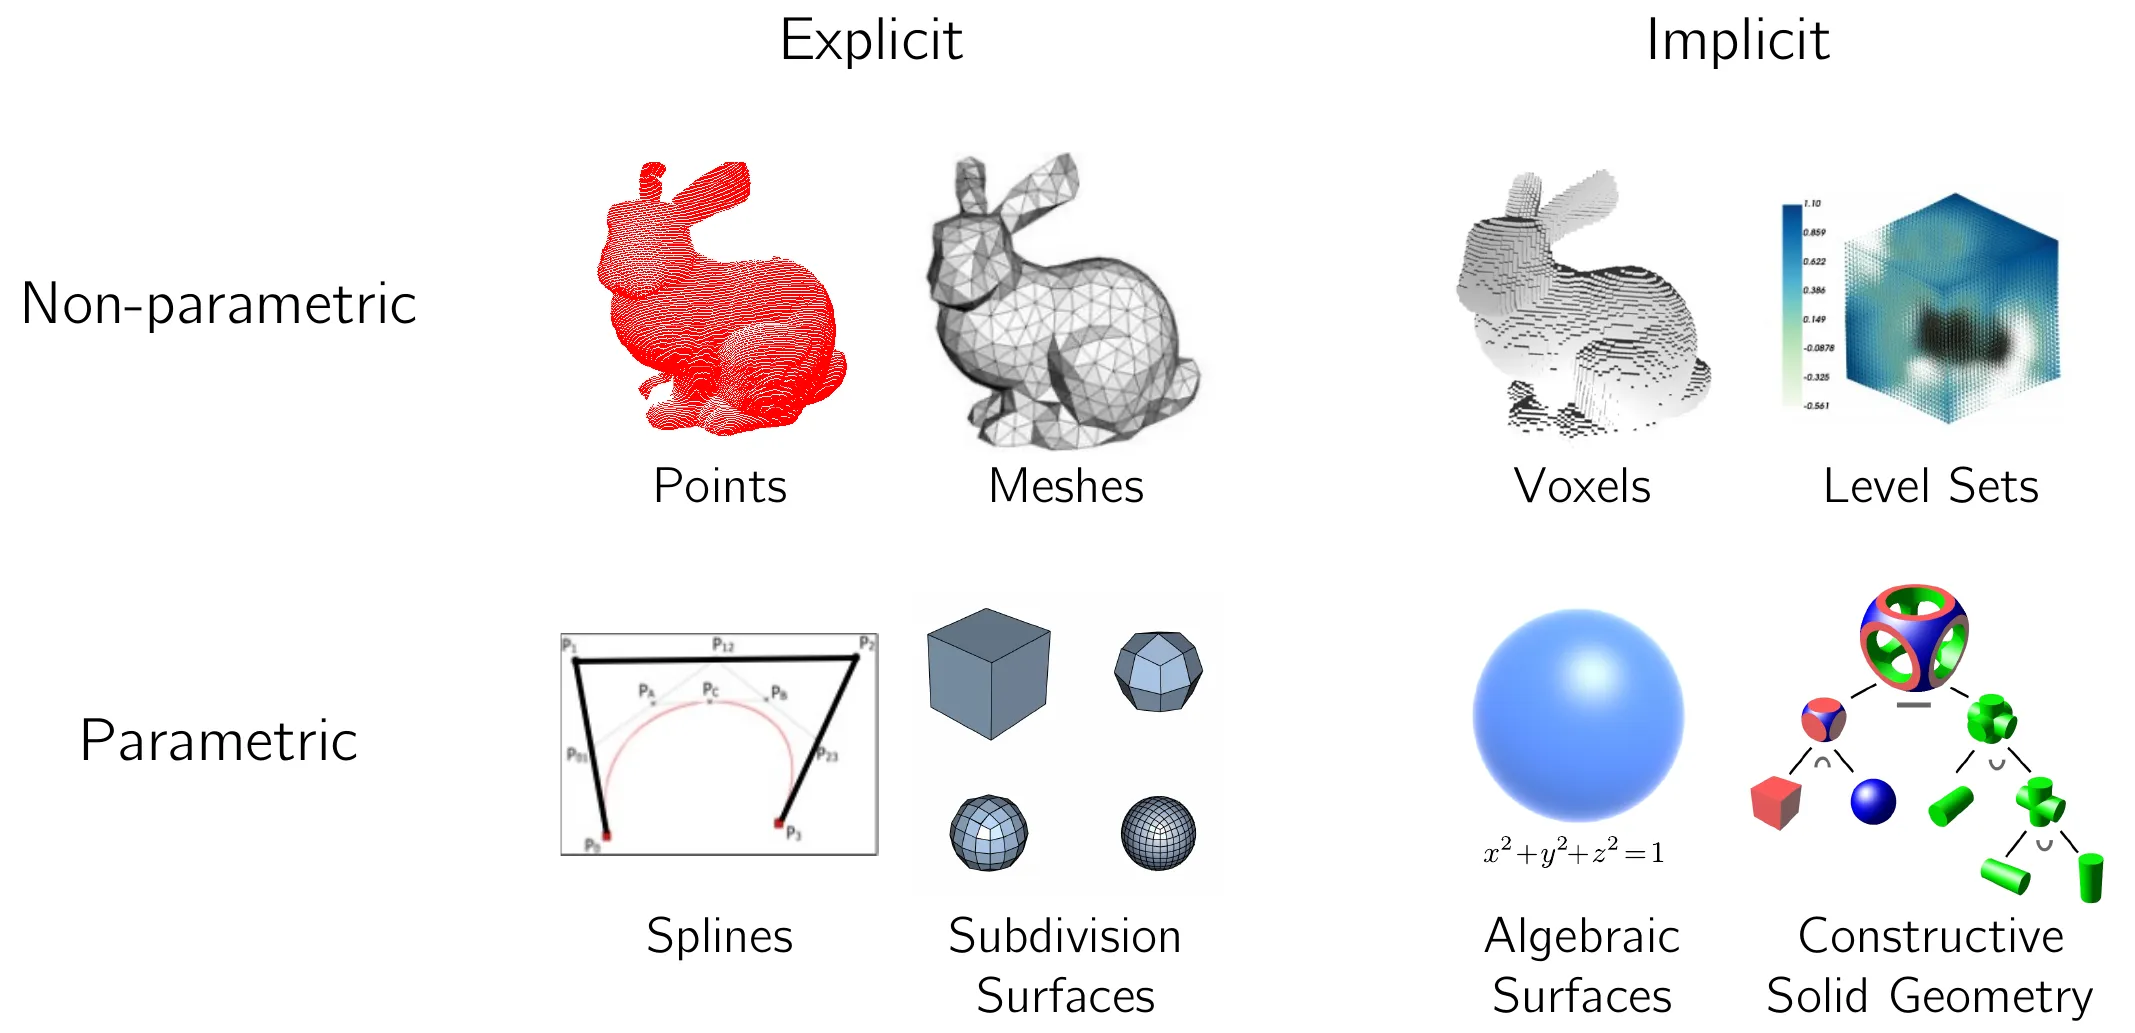
3D geometry의 표현은 크게 explicit representation과 implicit representation으로 나눌 수 있다.
- Explicit representation: Point cloud, polygon mesh, subdivision, NURBS처럼 점이나 표면을 직접 나타낸다.
- Implicit representation: Level set, algebraic surface, distance function처럼 좌표를 함수에 넣어 표면과의 관계를 표현한다.
그림의 가로축은 Explicit/Implicit 구분이다. 세로축은 점·격자 값을 직접 저장하는 방식과 spline·다항식 등의 parameter로 형상을 정의하는 방식을 구분한다.
Geometry와 appearance
Geometry는 물체의 형상과 공간적 구조를 나타낸다. Appearance는 특정 위치가 어떤 색상과 재질을 가지며, viewing direction과 조명에 따라 어떻게 보이는지를 나타낸다.
전통적인 shape representation은 주로 geometry에 초점을 맞춘다. NeRF 같은 neural rendering model은 좌표에서 density와 radiance를 함께 예측하므로 geometry와 appearance를 하나의 field 안에 표현한다.
같은 geometry도 재질, 조명, 시점에 따라 다르게 보인다. 여러 2D 이미지에서 일관된 geometry를 찾으려면 시점에 따른 appearance 변화를 구분해야 한다.
Point cloud
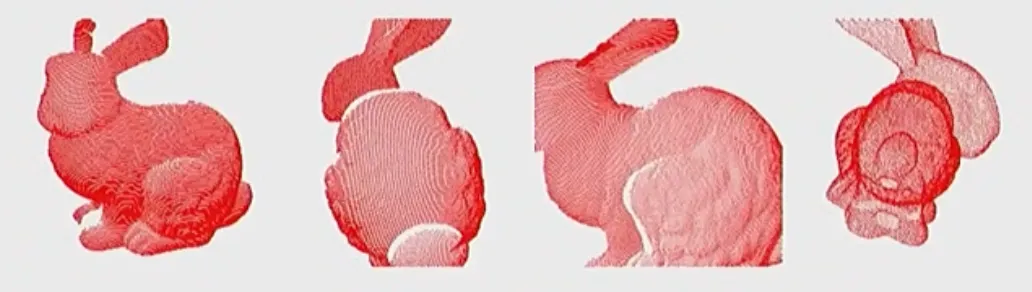
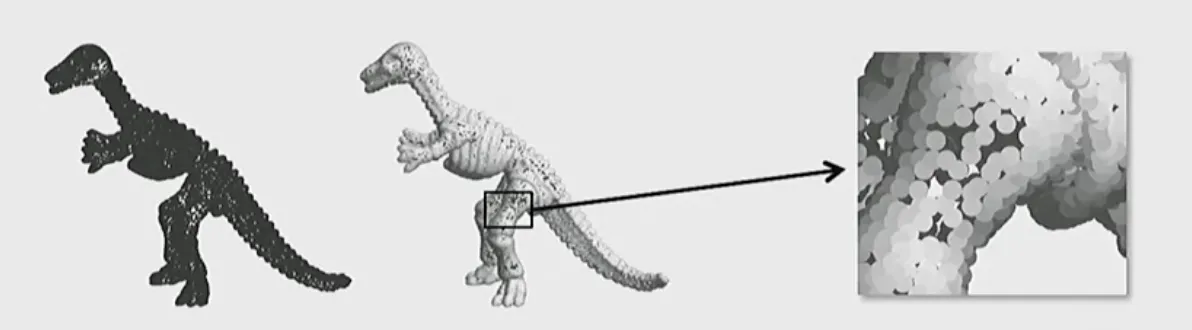
Point cloud의 개 점은 다음과 같은 matrix로 저장할 수 있다.
각 열 는 3D 공간의 한 점이다. 구현에서는 같은 정보를 tensor로 저장하기도 한다.
Depth sensor, LiDAR, 3D scanner에서 얻는 원본 출력이 point cloud인 경우가 많다. 점에 surface normal 까지 붙이면 위치와 표면의 방향을 함께 표현할 수 있으며, 이런 oriented point를 surfel이라고 부르기도 한다.
Surface normal은 조명과 표면의 상호작용을 계산할 때 필요하다. 다만 point cloud 자체에는 점 사이의 연결 관계가 없으므로, 두 점이 같은 표면 위에서 이웃하는지 바로 알 수 없다.
Point cloud의 주요 한계는 다음과 같다.
- 점의 순서에 의미가 없다.
- 샘플링 밀도가 물체 부위마다 다를 수 있다.
- 구멍, 잡음, outlier가 포함될 수 있다.
- Topology와 연속적인 표면이 명시되지 않는다.
- 매끄러운 렌더링, subdivision, simplification 같은 표면 연산이 바로 정의되지 않는다.
예를 들어 같은 위치의 점 집합이라도 어떤 점을 연결하느냐에 따라 torus와 서로 분리된 ring처럼 다른 topology가 될 수 있다. 좌표만으로는 이 차이를 완전히 복원할 수 없다.
Polygon mesh
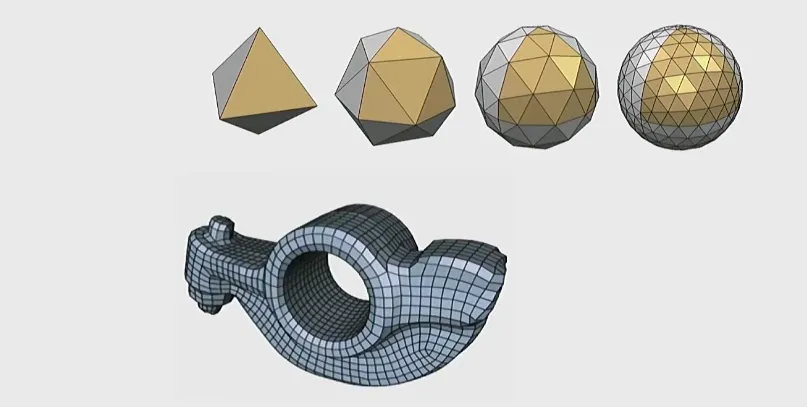
Polygon mesh는 vertex 집합과 face 집합으로 표면을 표현한다.
는 어떤 vertex들이 하나의 polygon을 이루는지 나타낸다. Triangle mesh라면 각 face는 세 vertex index로 구성된다.
Mesh는 vertex 사이의 연결 관계와 표면을 명시하므로 렌더링, 애니메이션, 세분화, 단순화에 적합하다.
Mesh는 vertex마다 이웃 개수가 다를 수 있고 face의 크기와 모양도 일정하지 않다. 강의에서는 2,800만 vertex와 5,600만 triangle을 가진 조각상을 스캔한 데이터를 예로 들었다. 이런 불규칙한 연결 구조에 고정된 kernel을 사용하는 일반 CNN을 바로 적용하기는 어렵다.
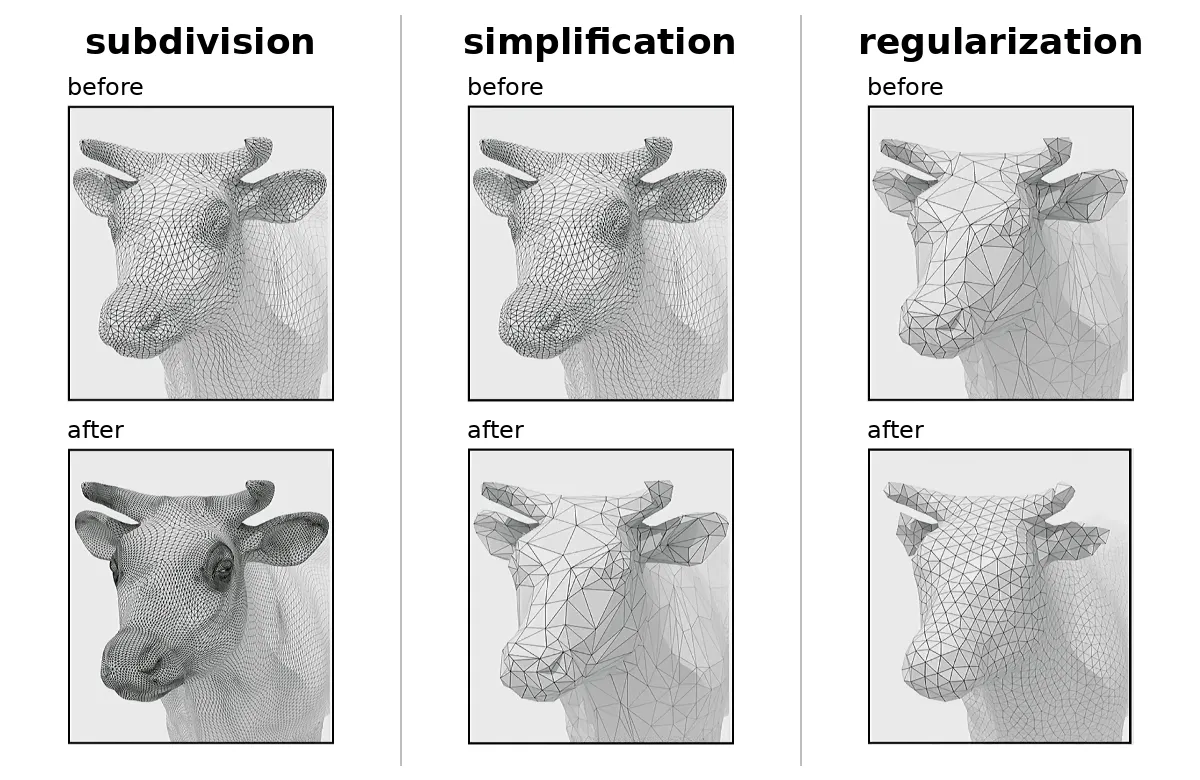
Mesh processing에서는 삼각형 크기와 샘플링 밀도를 고르게 만드는 remeshing, 세부 정보를 늘리는 subdivision, 계산량을 줄이는 simplification 등을 사용한다.
Parametric representation
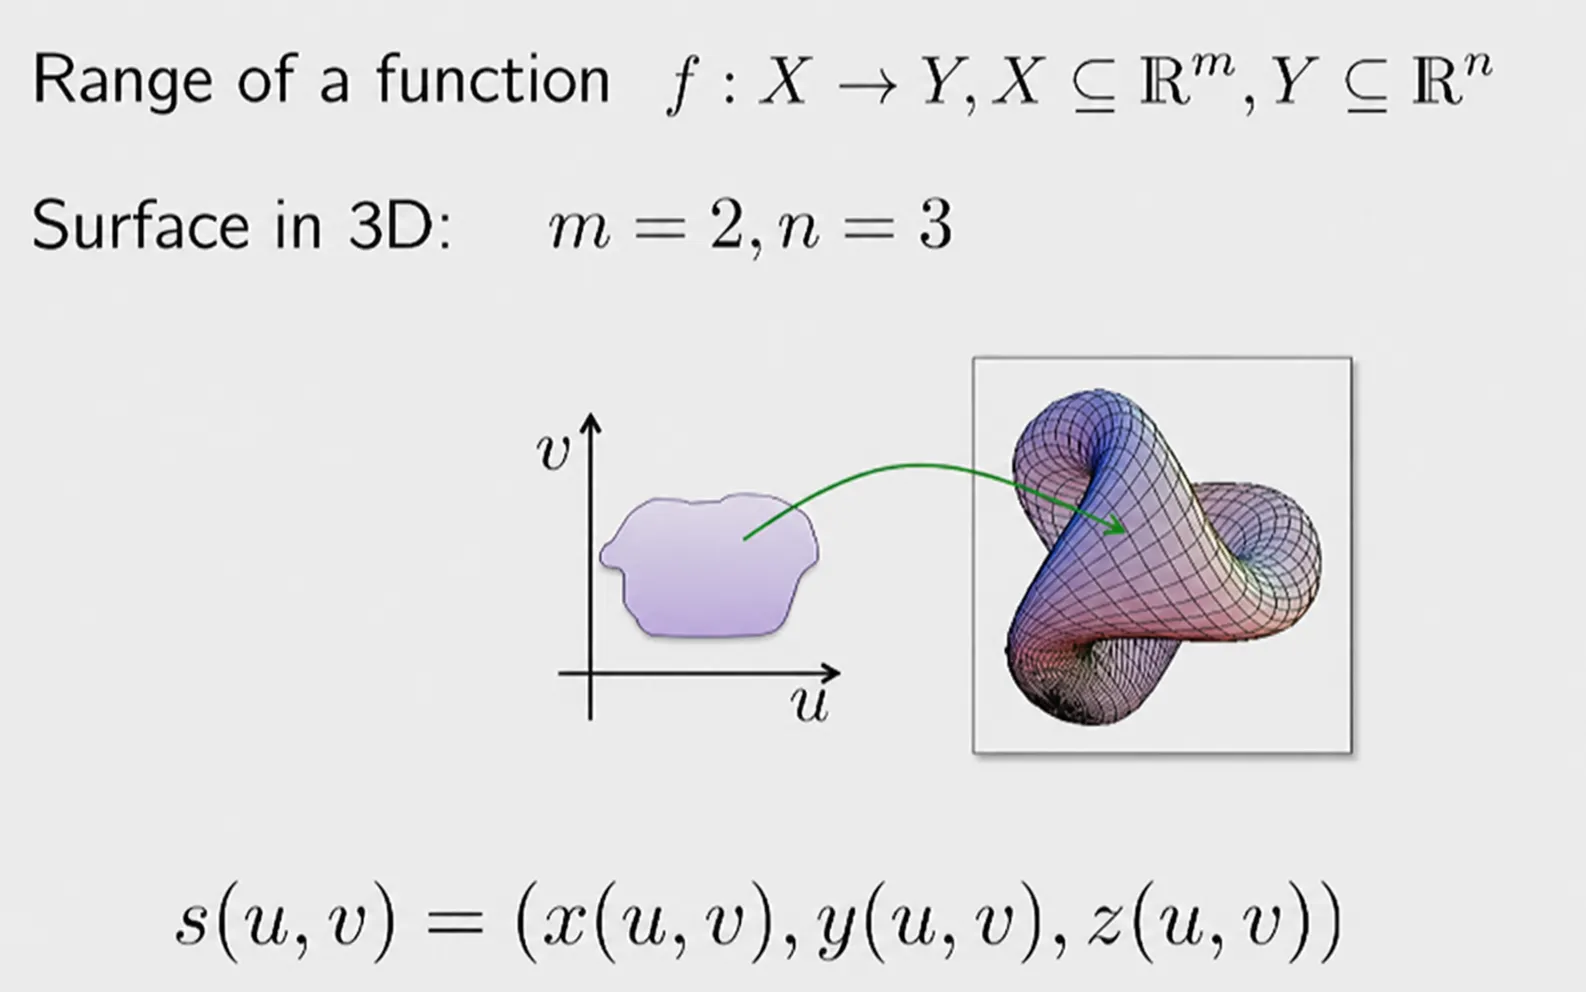
Parametric curve와 parametric surface는 낮은 차원의 parameter domain을 3D 좌표로 mapping한다.
곡선은 보통 하나의 parameter를 사용한다.
2D 단위원은 다음처럼 쓸 수 있다.
표면은 두 parameter를 사용한다.
반지름 인 구의 한 parameterization은 다음과 같다.
는 평면에서의 방위각, 는 평면을 기준으로 한 고도각이다. 와 를 변화시키면 구의 표면 위 점을 직접 얻는다.
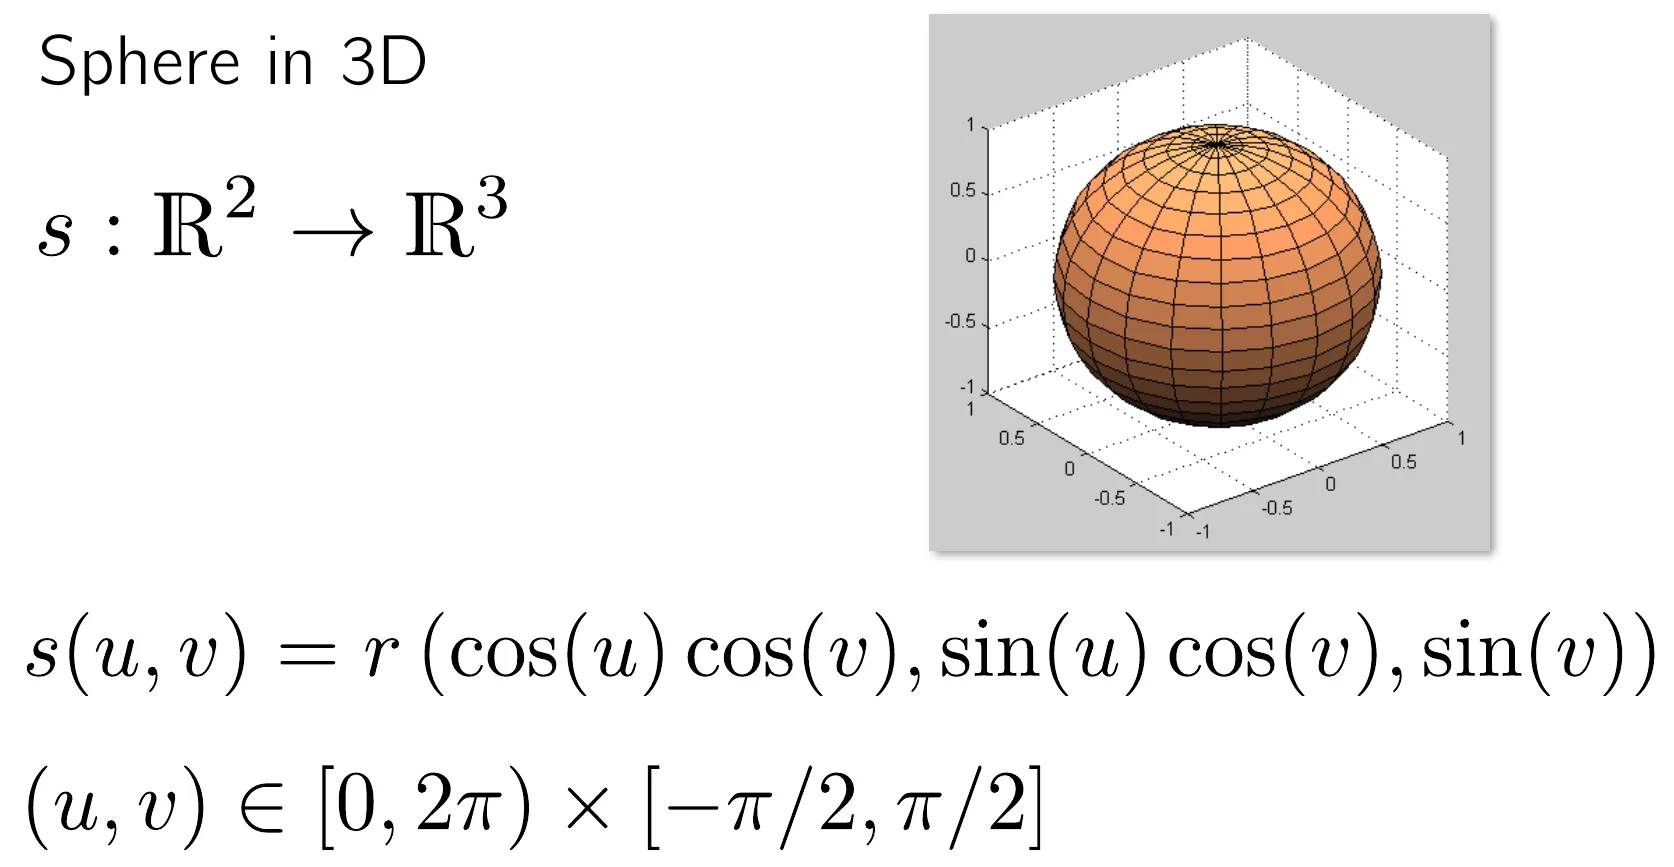
이처럼 parametric representation은 점 샘플링이 쉽고 매끄러운 표면을 만들기 좋다. Bezier curve와 Bezier surface는 control point 몇 개로 더 유연한 형상을 정의한다.
다만 하나의 parameter domain으로 복잡한 topology를 가진 물체 전체를 덮기는 어렵다. 구와 같은 단순한 표면은 닫힌 형태로 쓸 수 있지만, 의자나 동물의 전체 형상을 표현하는 mapping은 직접 작성하기 어렵다. 뒤에서 보는 AtlasNet은 이 mapping을 neural network로 학습한다.
Explicit representation과 implicit representation
Point cloud, mesh, parametric surface는 표면 위 점을 직접 제공한다는 의미에서 explicit representation으로 볼 수 있다. 반면 implicit representation은 3D 좌표를 함수에 넣어 그 위치가 표면과 어떤 관계인지 묻는다.
표면은 보통 함수의 zero level set으로 정의한다.
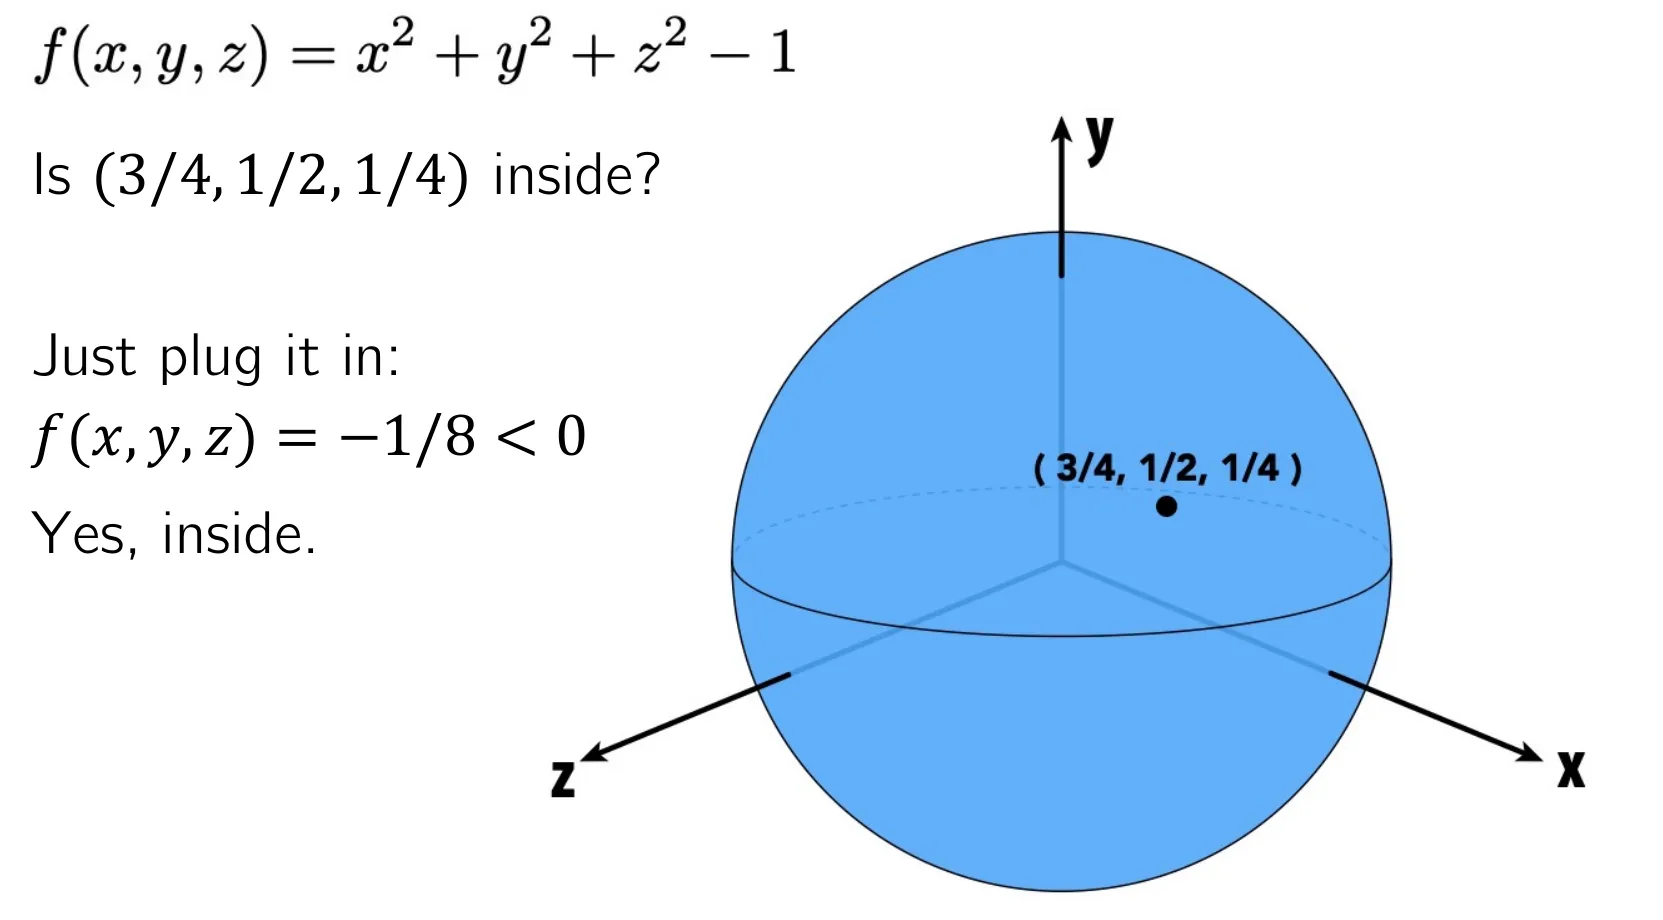
단위구는 다음 함수로 표현할 수 있다.
이때 다음 부호 표기를 사용할 수 있다.
Explicit representation은 parameter를 샘플링하면 표면 위 점이 바로 나오지만, 임의의 query point가 닫힌 물체의 내부인지 외부인지 판단하기가 상대적으로 어렵다. Implicit representation은 함수 계산 한 번으로 inside/outside를 확인할 수 있지만, 을 만족하는 표면 위 점을 직접 얻으려면 root finding이나 표면 추출이 필요하다.
그림의 query 는 이므로 구 내부의 점이다.
Signed Distance Function
Signed Distance Function, SDF는 점에서 가장 가까운 표면까지의 거리에 inside/outside 부호를 붙인 implicit representation이다.
여기서는 내부에서 음수, 외부에서 양수가 되도록 를 정한다. 표면에서는 이다.
Occupancy function은 inside/outside를 나타내고, SDF의 절댓값은 표면까지의 거리를 나타낸다. 이 거리 정보를 collision 계산이나 smooth blending에 사용할 수 있다. 충분히 매끄러운 영역에서는 SDF gradient가 surface normal 방향을 나타낸다.
Implicit function의 composition
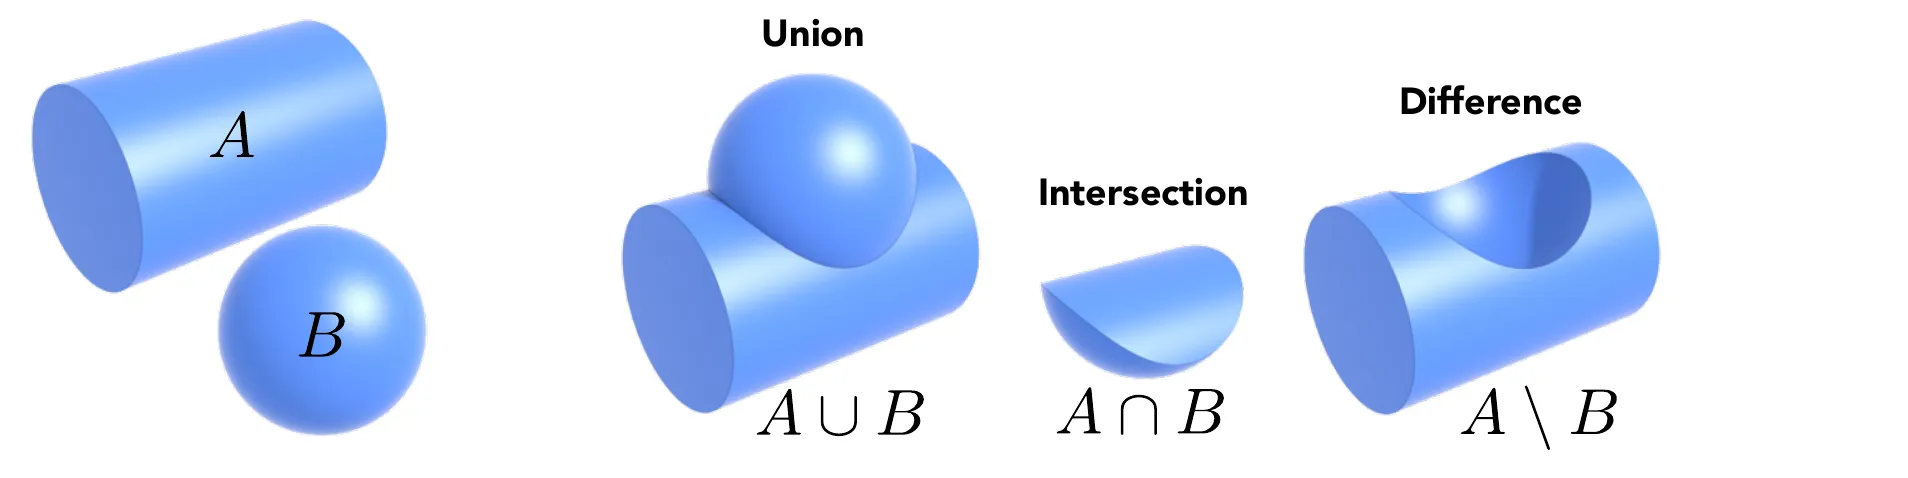
Implicit representation은 여러 primitive를 조합하기 쉽다. 내부에서 음수를 쓰는 SDF 표기에서 두 field 와 의 기본 Constructive Solid Geometry, CSG 연산은 다음처럼 나타낼 수 있다.
이런 합집합, 교집합, 차집합을 반복하면 단순한 primitive에서 복잡한 CAD 형상을 구성할 수 있다. Hard min과 max 대신 매끄러운 근사를 사용하면 두 형상이 부드럽게 이어지도록 blending할 수도 있다.
Level set과 voxel
복잡한 implicit function을 매번 계산하기 어렵다면 regular 3D grid의 좌표마다 함숫값을 미리 저장할 수 있다.
인접한 grid 값의 부호가 바뀌는 곳 사이에는 인 표면이 존재한다. Marching Cubes 같은 알고리즘은 이 부호 변화를 이용해 implicit grid에서 triangle mesh를 추출한다.
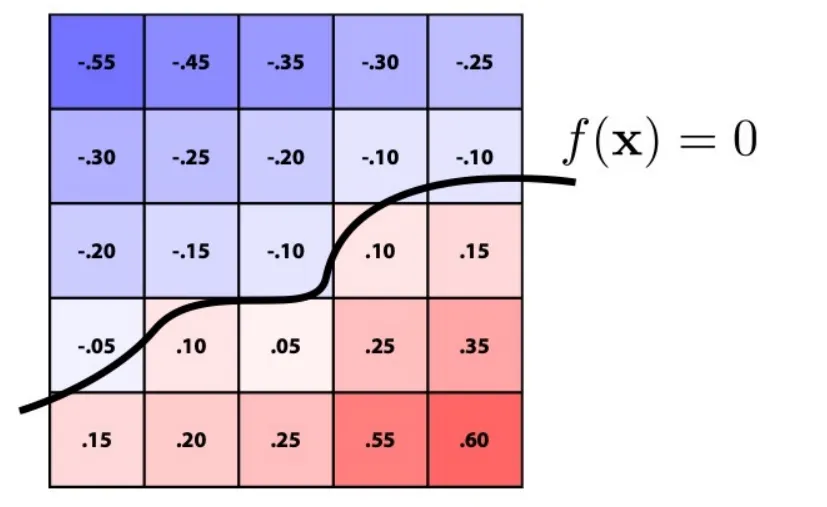
거리 값을 모두 저장하지 않고 inside/outside만 이산화하면 voxel occupancy grid가 된다.
강의에서는 grid를 예로 들었다. 이 경우 총 voxel 수는 다음과 같다.
Voxel은 pixel을 3D로 확장한 형태처럼 regular tensor이므로 3D convolution을 바로 적용할 수 있다. 그러나 한 축의 해상도가 이면 저장량과 dense convolution 비용은 대략 에 비례한다.
해상도를 두 배로 올리면 voxel 수는 여덟 배가 된다.
%% title: 3D Representation별 Query와 사용 방식
%% caption: 같은 3D 물체도 표면을 직접 저장할 수도, 좌표에서 특성을 묻는 함수로 저장할 수도 있으며 representation이 가능한 연산과 비용을 결정한다.
flowchart TB
    object["3D Object / Scene"]
    object --> points["Point Cloud<br/>unordered xyz samples"]
    object --> mesh["Mesh<br/>vertices + faces"]
    object --> parametric["Parametric Surface<br/>(u,v) → xyz"]
    object --> implicit["Implicit Field<br/>xyz → occupancy / SDF"]
    object --> voxel["Voxel Grid<br/>regular D × H × W"]
    points --> setnet["Set Model / PointNet"]
    mesh --> render["Rasterization / Geometry Ops"]
    parametric --> sample["Direct Surface Sampling"]
    implicit --> extract["Query + Marching Cubes"]
    voxel --> conv3d["3D Convolution"]
3D data의 규모 문제
2D 이미지는 웹에서 대규모로 수집할 수 있지만, 정확한 3D geometry는 직접 모델링하거나 여러 시점을 촬영하고 복원해야 한다.
강의에서 제시한 규모 변화는 다음과 같다.
- 초기 Princeton Shape Benchmark는 180 범주, 약 1,800 모델 규모였다.
- ShapeNet 전체는 약 300만 모델이며, 자주 사용하는 ShapeNetCore는 약 5만 모델과 55 범주로 구성된다.
- Objaverse와 Objaverse-XL은 대략 100만, 1,000만 단위의 합성 3D asset으로 규모를 키웠다.
- 실제 물체와 실내 장면을 스캔한 데이터는 수집 비용 때문에 합성 asset보다 훨씬 적다.
3D 학습 데이터의 부족을 보완하기 위해 대규모 2D 이미지·비디오 모델의 prior를 렌더링을 통해 3D로 옮기는 방법도 사용한다.
3D vision의 주요 task
3D representation을 사용하는 문제는 크게 다음과 같이 나눌 수 있다.
- 인식(Recognition): 형상 분류(shape classification), 부분 분할(part segmentation), 장면 이해(scene understanding)
- 재구성(Reconstruction): 이미지, 비디오, depth, LiDAR에서 3D geometry와 appearance를 복원
- 완성 및 복원(Completion and repair): 부분 스캔의 누락된 영역을 채움
- 생성(Generation): 텍스트나 이미지를 조건으로 물체와 장면을 생성
- 편집 및 애니메이션(Editing and animation): geometry, 질감, 관절구조 및 움직임(articulation)을 수정한다.
- 멀티모달 융합(Multimodal fusion): RGB, depth, LiDAR, 촉각정보(tactile), 텍스트를 함께 사용한다.
Differentiable rendering은 3D representation을 2D 이미지로 렌더링하는 과정을 미분 가능하게 만든다. 렌더링한 이미지와 기준 이미지의 차이를 3D parameter까지 역전파할 수 있다.
이 구조 덕분에 직접적인 3D ground truth가 없더라도 여러 2D 시점을 supervision으로 사용할 수 있다.
Multi-view CNN
초기 deep 3D recognition의 실용적인 방법은 3D 물체를 여러 카메라 시점에서 2D 이미지로 렌더링한 뒤, pretrained 2D CNN으로 처리하는 것이었다.
각 시점 에서 feature를 추출한다.
그다음 시점 순서에 덜 민감한 pooling으로 하나의 물체 feature를 만든다.
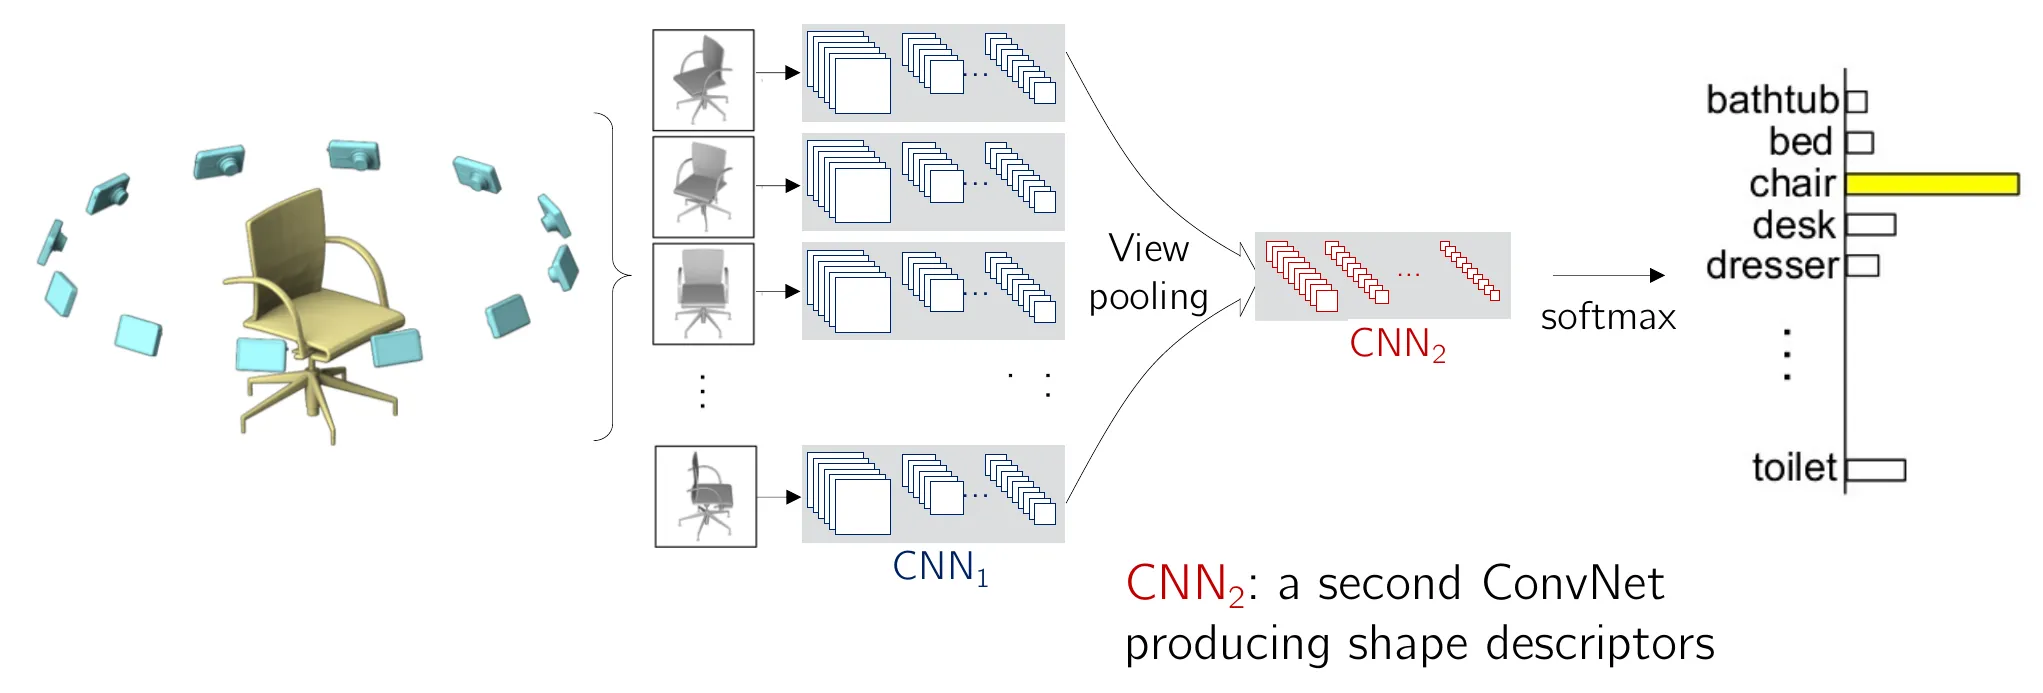
이 방식은 대규모 이미지 데이터로 pretraining한 CNN을 활용할 수 있다는 장점이 있다. 반면 카메라 배치와 렌더링 품질에 따라 성능이 달라지고, 3D 연결 관계와 metric structure를 직접 처리하지는 않는다.
Volumetric CNN과 3D GAN
Voxel은 regular grid이므로 2D convolution을 3D convolution으로 확장할 수 있다. 3D kernel은 높이와 너비뿐 아니라 깊이 방향으로도 이동한다.
입력 channel까지 포함한 voxel tensor를 다음처럼 둘 수 있다.
3D convolution kernel의 shape는 다음과 같다.
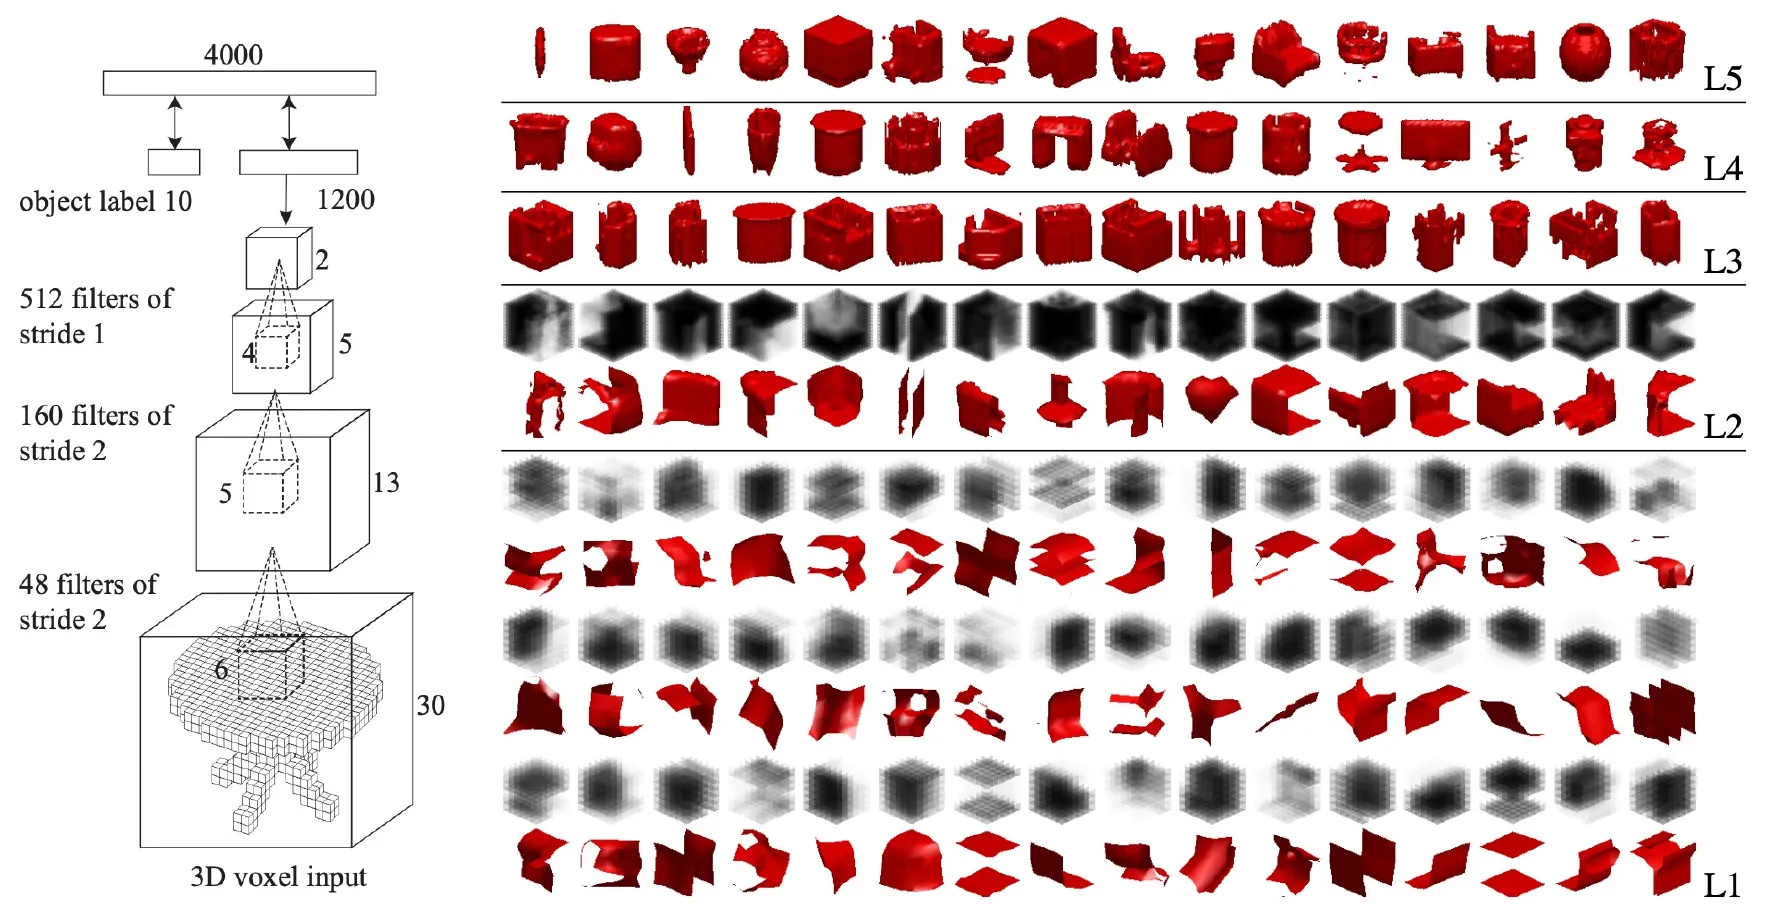
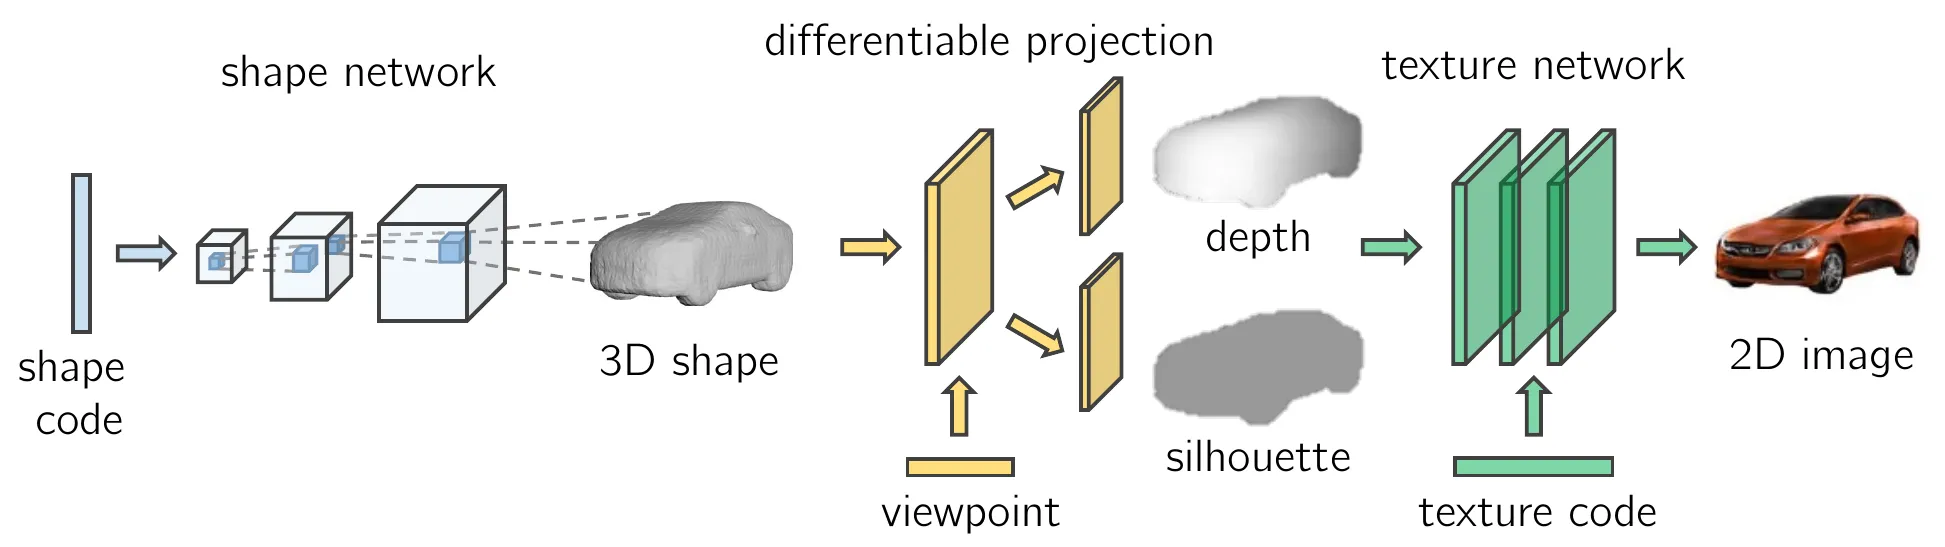
이를 이용해 voxel classification, reconstruction, generation을 구현할 수 있다. GAN의 generator가 이미지 픽셀 대신 voxel occupancy를 출력하면 3D GAN이 된다.
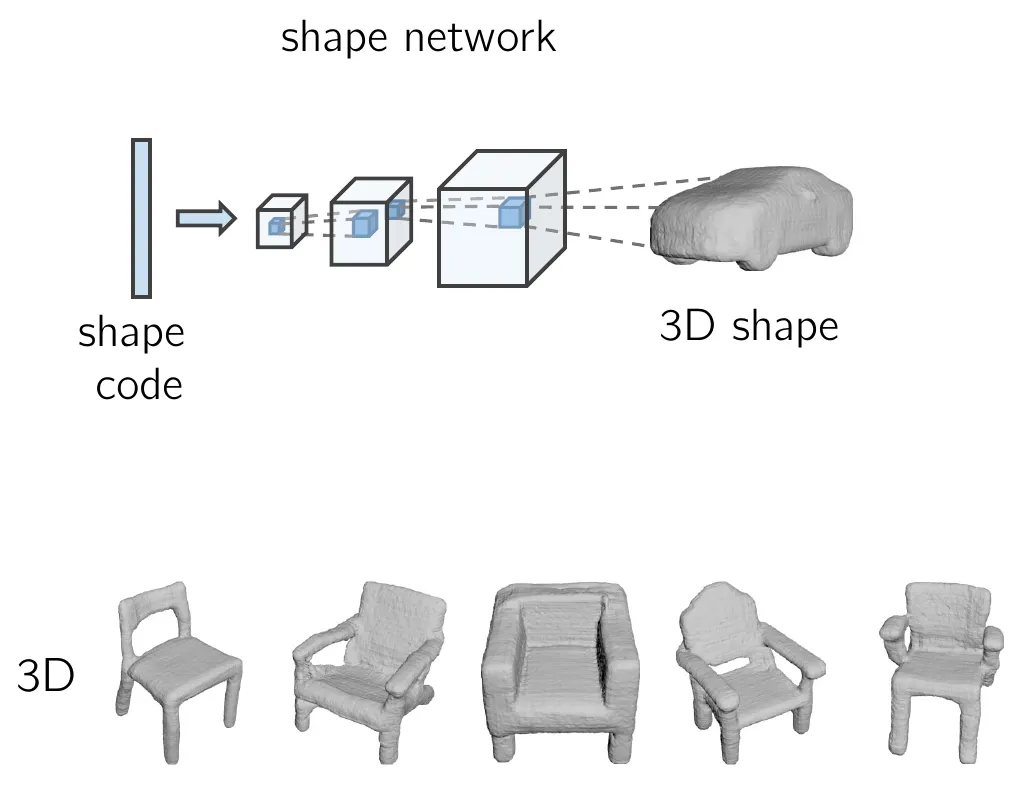
또한 생성한 voxel을 depth image로 렌더링하고 image adversarial loss를 추가할 수 있다. 형상의 사실성은 3D 손실로, 렌더링 결과의 appearance는 2D 손실로 제약하는 방식이다. 형상, 시점, 질감을 나타내는 latent를 분리하면 시점 변경이나 texture transfer 같은 제어도 가능하다.
Dense voxel의 한계와 Octree
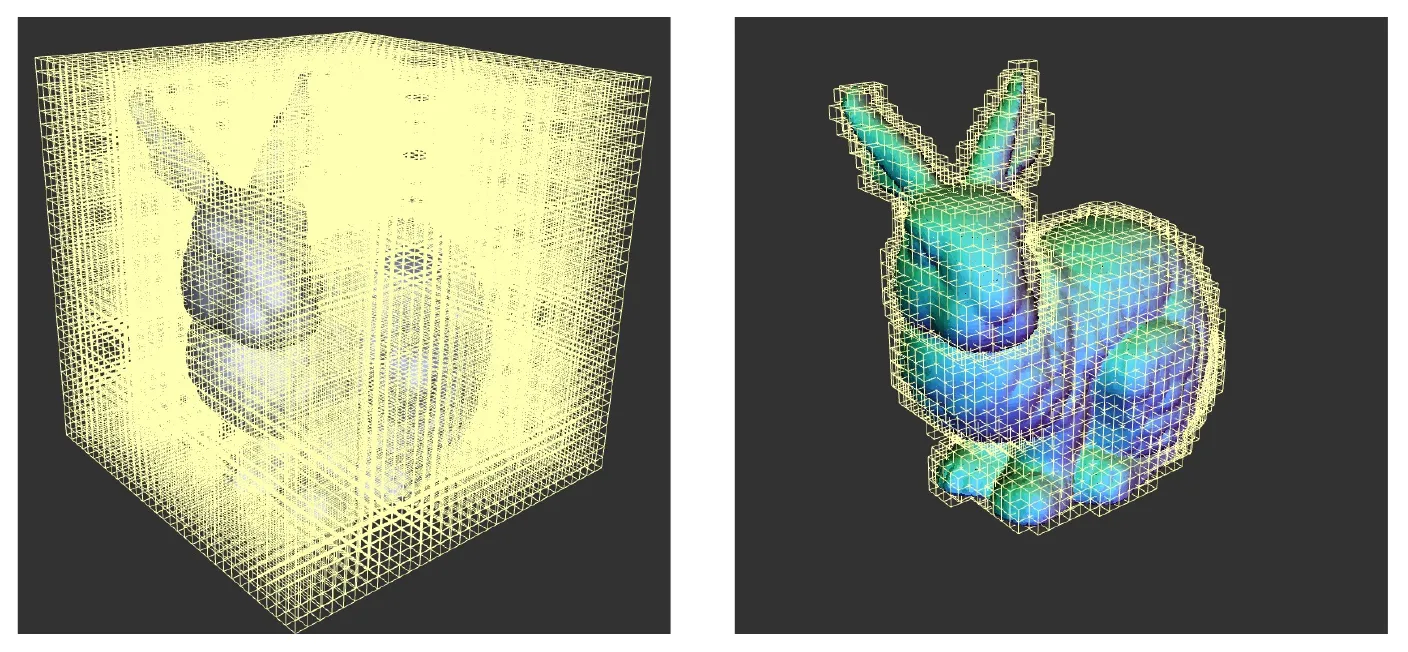
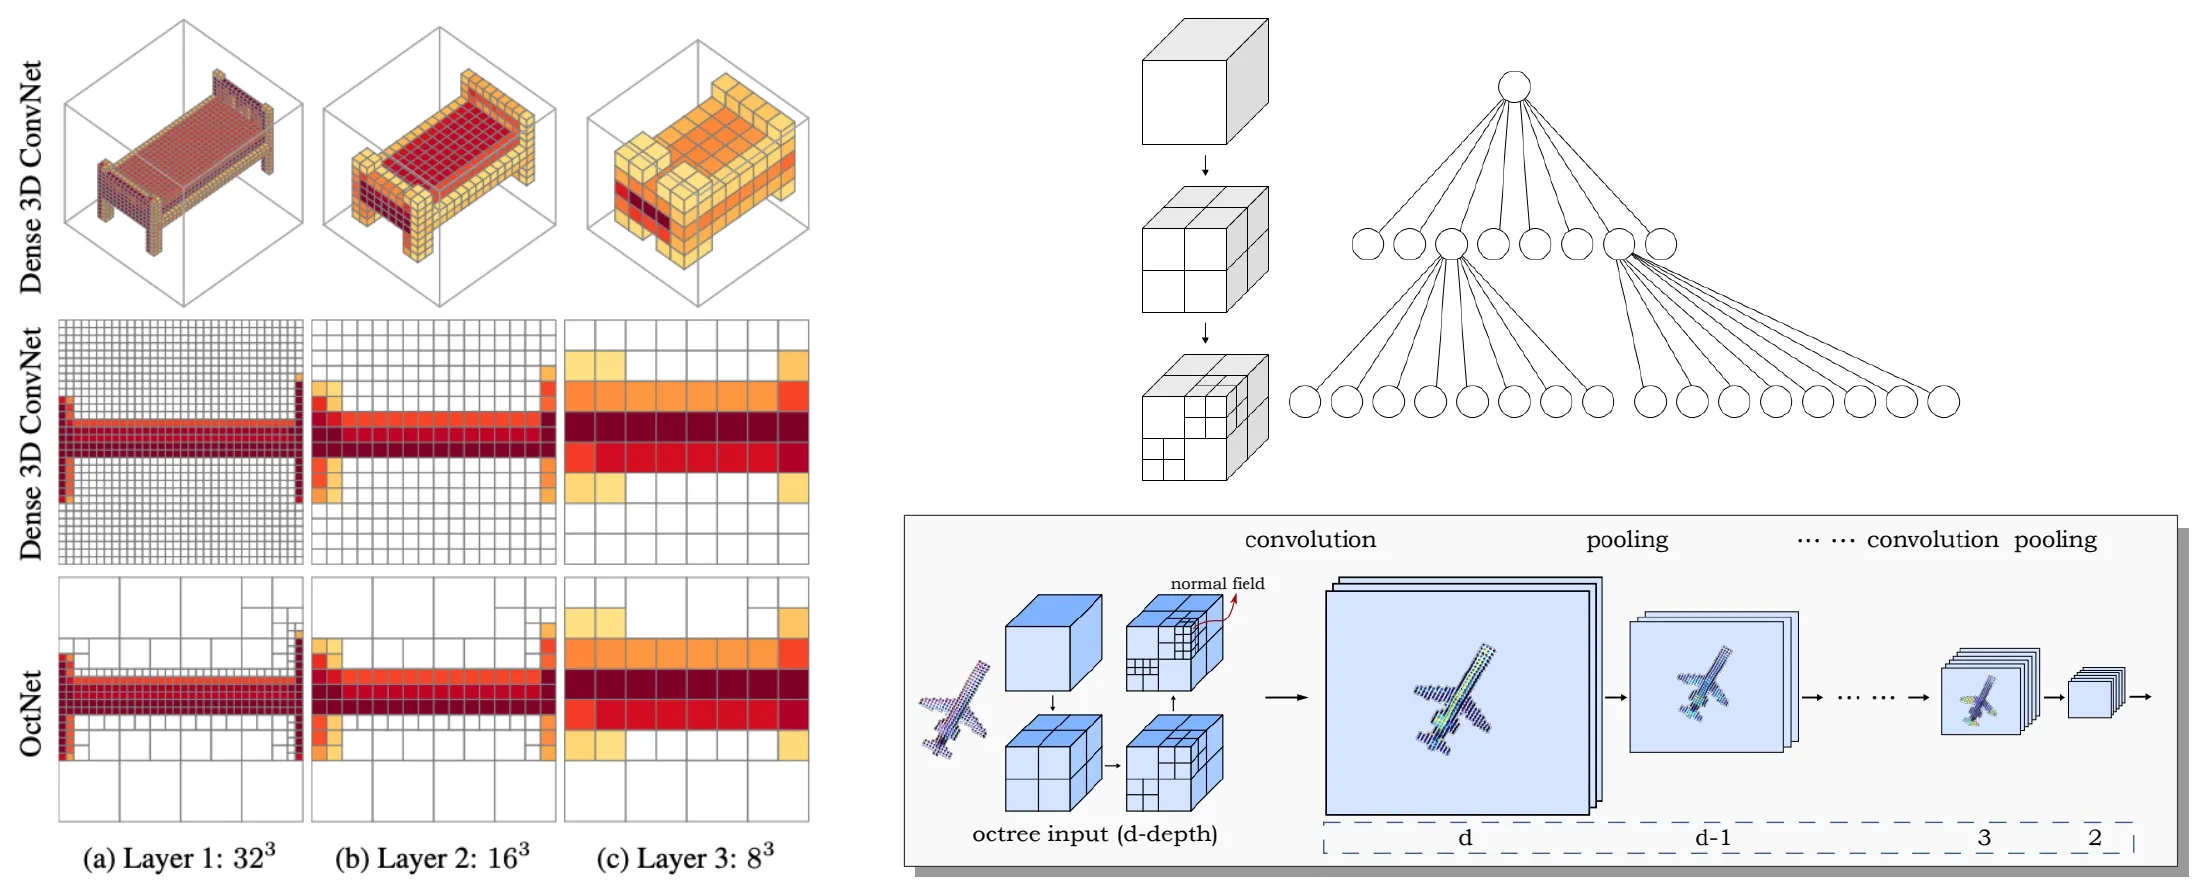
Octree의 oct-는 ‘8’을 뜻한다. 정육면체를 가로·세로·높이에서 절반씩 나눠 8개 자식 셀을 만들고, 필요한 셀에서만 이 분할을 재귀적으로 반복하는 tree 구조이다.
Dense voxel은 빈 공간이나 물체 내부의 균일한 영역에도 같은 해상도의 cell을 할당한다. Octree는 표면 근처에 작은 cell을 두고 나머지 공간에는 큰 cell을 둔다. 강의의 예에서는 dense voxel이 정도를 다룰 때 adaptive octree를 이용해 수준의 세부 형상을 표현했다.
왼쪽 dense grid는 빈 공간도 작은 cell로 나누지만, 오른쪽 octree는 표면 근처에 세밀한 cell을 배치한다.
왼쪽은 dense 3D ConvNet과 OctNet의 layer별 공간 분할 비교이다. 오른쪽은 정육면체의 재귀 분할과 tree의 대응 관계, O-CNN의 convolution·pooling 구조를 보여 준다.
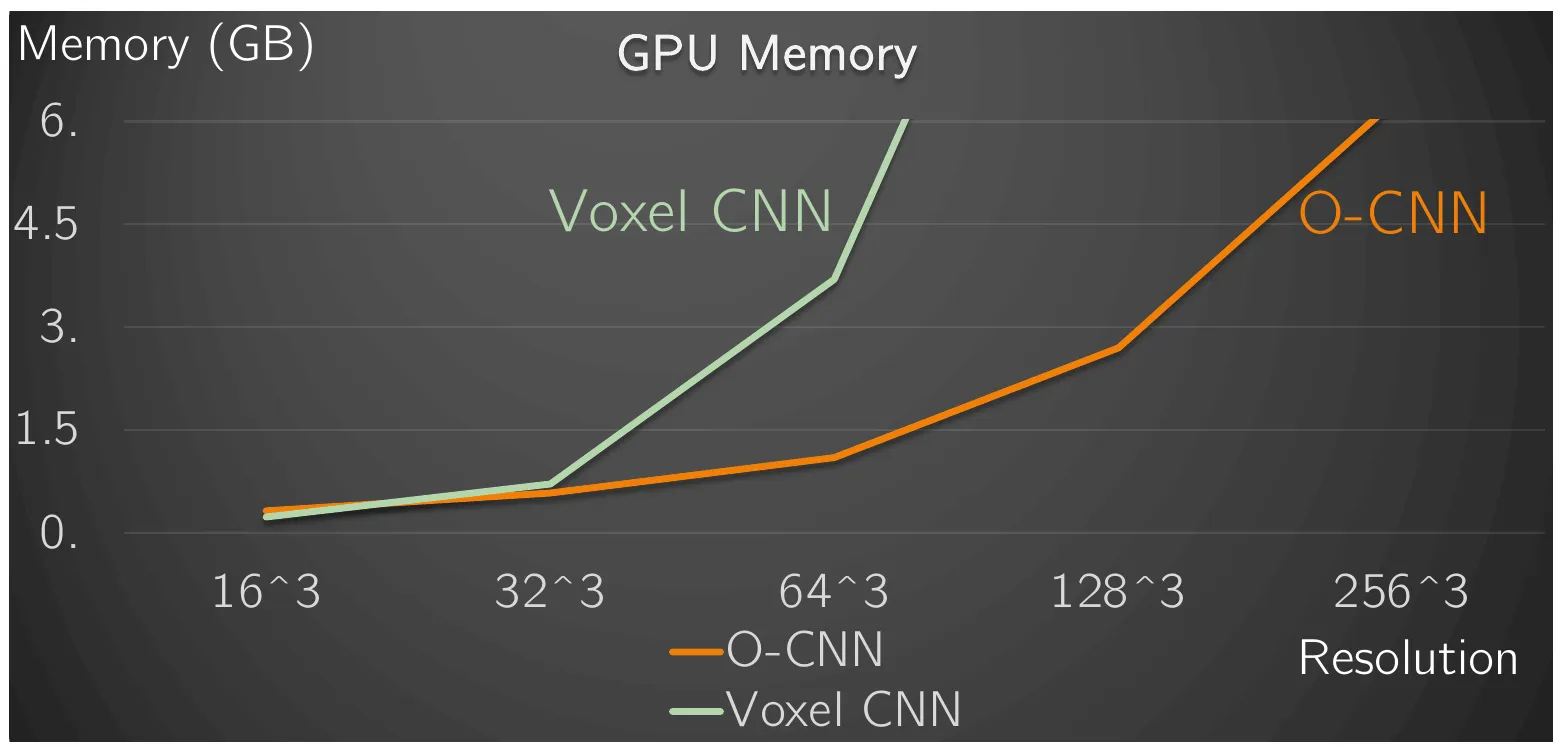
다음 그래프는 입력 해상도에 따른 Voxel CNN과 O-CNN의 GPU 메모리 사용량을 비교한다. O-CNN은 표면 주변에 저장과 연산을 집중해 같은 해상도에서 메모리를 덜 사용한다.
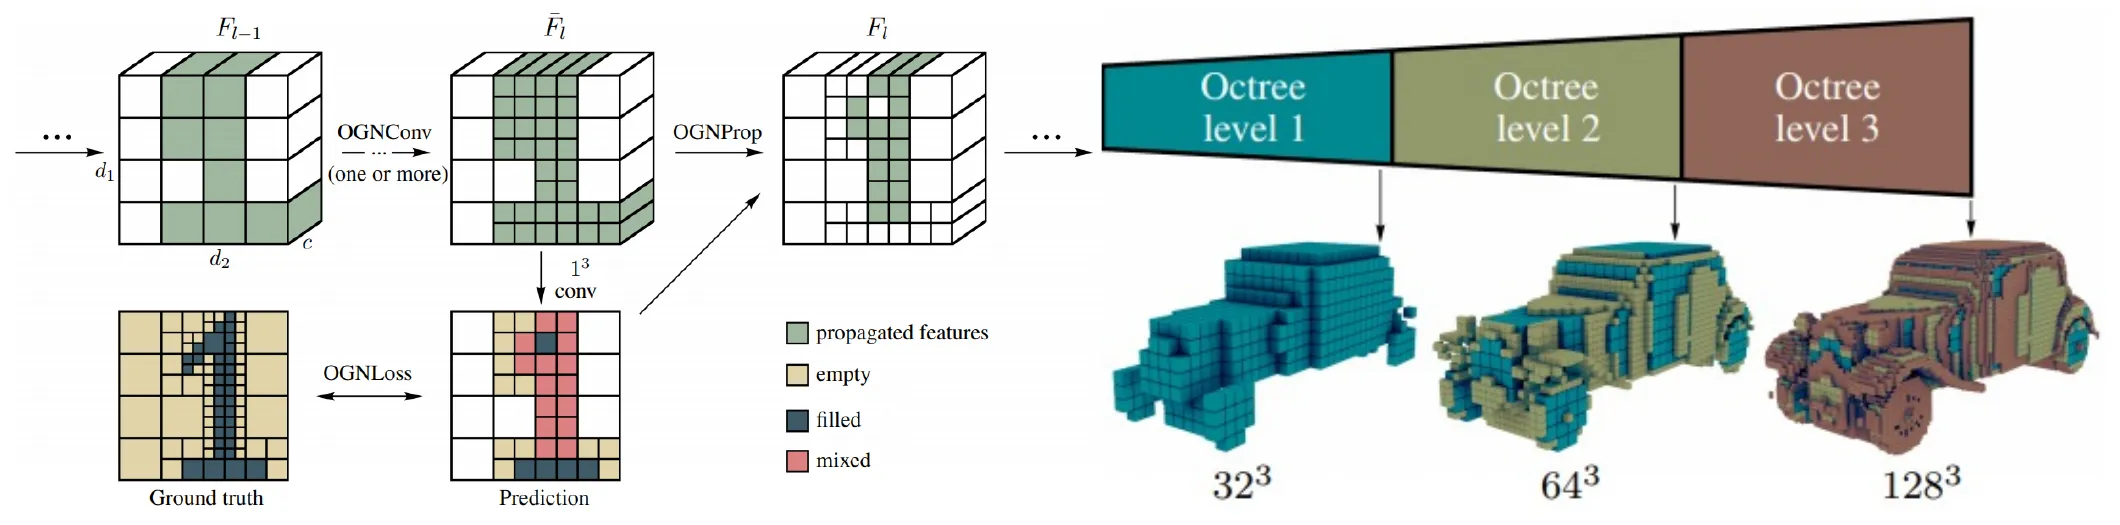
Octree Generating Networks는 octree를 level별로 생성하면서 셀이 비어 있는지(empty), 채워져 있는지(filled), 경계에 걸치는지(mixed)를 예측한다.
PointNet과 permutation invariance
Point cloud는 순서가 없는 집합이다. 같은 점을 다른 순서로 나열해도 같은 geometry이므로 네트워크 출력도 같아야 한다.
는 점의 index의 임의 permutation이다.
PointNet은 모든 점에 같은 MLP 를 적용한 뒤 symmetric function으로 feature를 모은다.
Max, sum, mean 같은 symmetric aggregation은 입력 순서가 바뀌어도 결과가 같다.
그림에서는 shared MLP를 , 대칭 집계 함수를 , 최종 classifier를 로 표시한다.
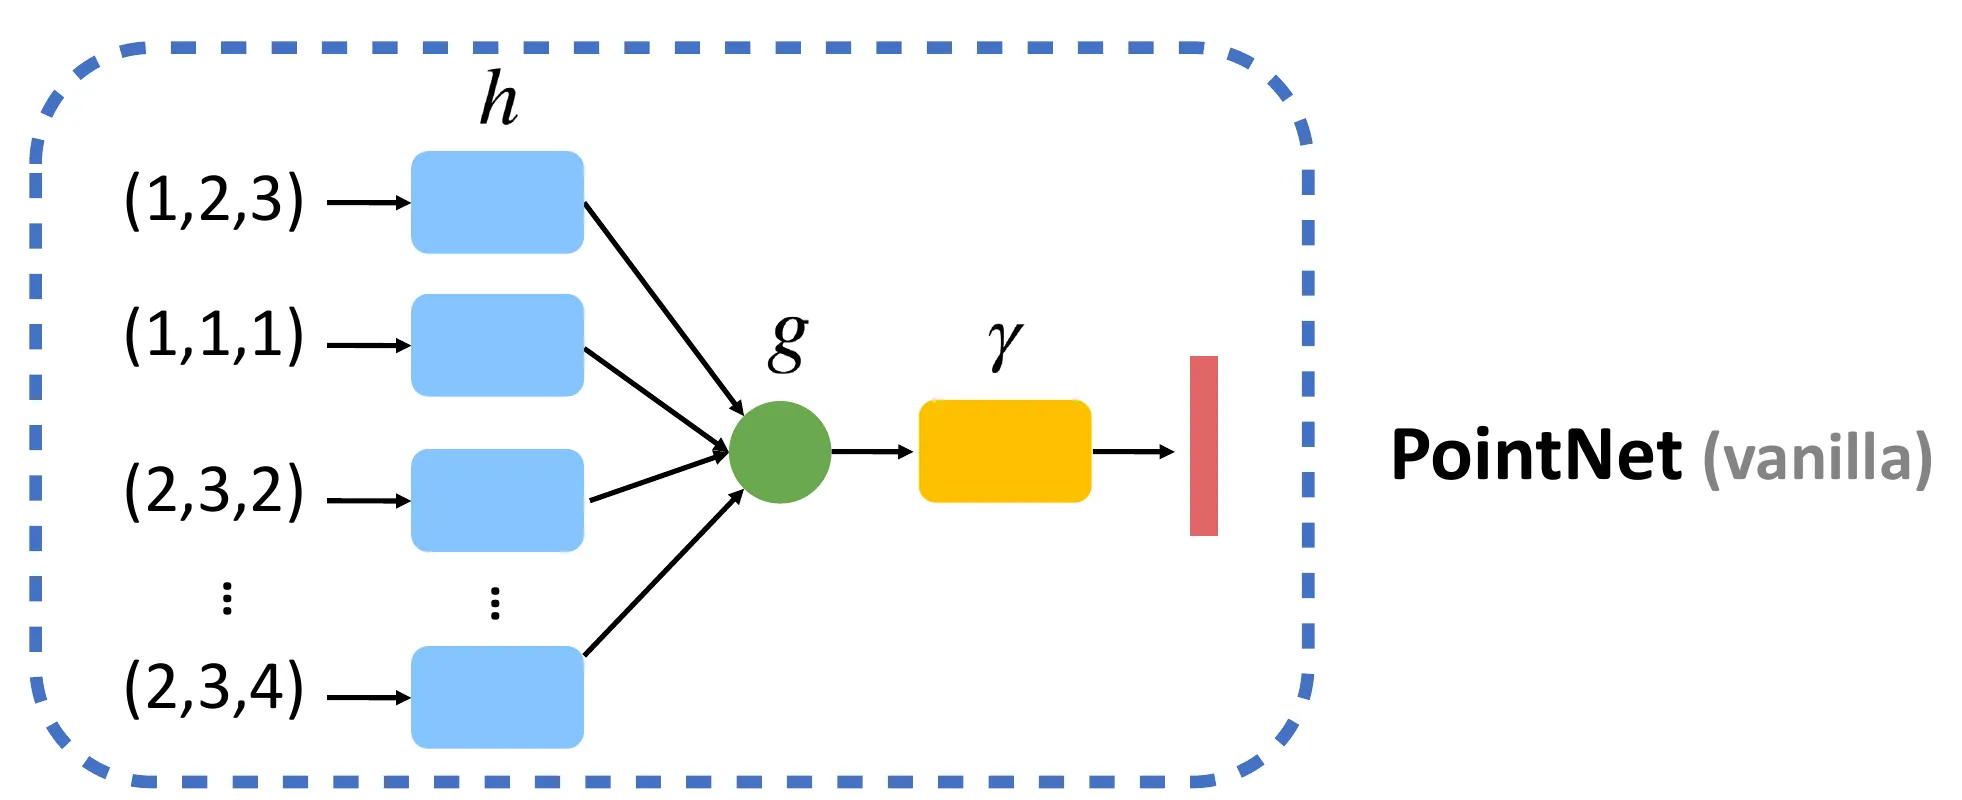
Shared MLP는 각 점을 독립적으로 embedding하고 global max pooling은 각 feature dimension에서 가장 강한 반응을 선택한다. PointNet++는 local neighborhood를 계층적으로 묶어 세밀한 geometry를 더 잘 포착한다. 점을 graph node로 보고 공간적으로 가까운 점을 edge로 연결하면 Graph Neural Network 방식으로도 확장할 수 있다.
Symmetric pooling은 점의 순서 변화에 대한 permutation invariance를 보장한다. 점의 위치나 샘플링 밀도가 바뀌어도 출력을 유지하는 sampling invariance까지 보장하지는 않는다. 다양한 샘플링에 대한 robustness는 학습 시 데이터 augmentation, local aggregation, density-aware method로 보완해야 한다.
%% title: PointNet의 Permutation-Invariant 구조
%% caption: 모든 점에 같은 MLP를 적용하고 점 축에서 symmetric max pooling하면 입력 순서가 바뀌어도 같은 global representation을 얻는다.
flowchart LR
    p1["Point p₁<br/>(x,y,z)"] --> mlp1["Shared MLP h"]
    p2["Point p₂<br/>(x,y,z)"] --> mlp2["Shared MLP h"]
    pn["Point pₙ<br/>(x,y,z)"] --> mlpn["Shared MLP h"]
    mlp1 --> max["Symmetric MAX<br/>over points"]
    mlp2 --> max
    mlpn --> max
    max --> global["Global Shape Feature"]
    global --> head["Classification / Segmentation Head"]
Point cloud distance
이미지는 같은 pixel 위치끼리 비교하면 되지만 point cloud에는 고정된 correspondence가 없다. 따라서 생성된 점 집합과 기준 점 집합을 비교하려면 집합 사이 거리가 필요하다.
두 점 집합을 와 라 할 때 symmetric Chamfer distance는 다음과 같다.
양방향 nearest-neighbor distance를 사용하므로 두 집합이 서로를 얼마나 잘 덮는지 측정한다. 계산이 비교적 간단하지만 여러 점이 같은 nearest neighbor에 몰릴 수 있어 one-to-one correspondence를 보장하지 않는다.
두 집합의 점 수가 같을 때 Earth Mover’s Distance, EMD는 가능한 bijection 중 전체 이동 비용이 최소인 matching을 찾는다.
는 one-to-one matching이다. EMD는 전체 점의 대응 관계를 고려해 correspondence가 더 균형적이지만 정확한 계산이 더 비싸다. 두 거리는 미분 가능한 형태 또는 근사로 구현해 point cloud generator를 학습할 수 있다.
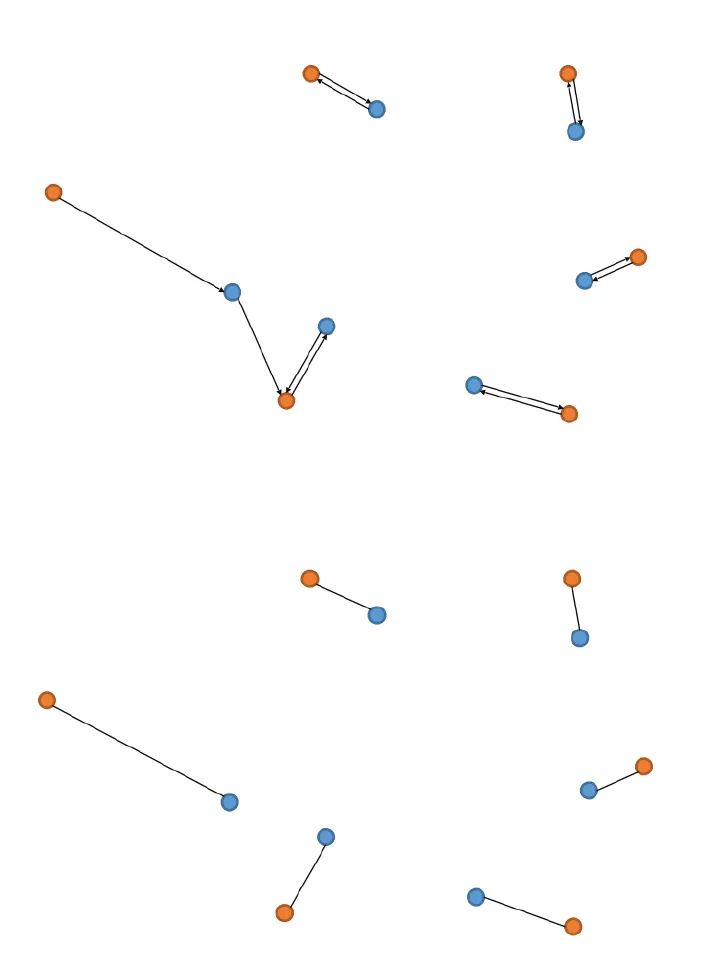
다음 그림의 위쪽은 Chamfer distance의 최근접 이웃 대응, 아래쪽은 EMD의 one-to-one matching이다.
AtlasNet과 learned parametric surface
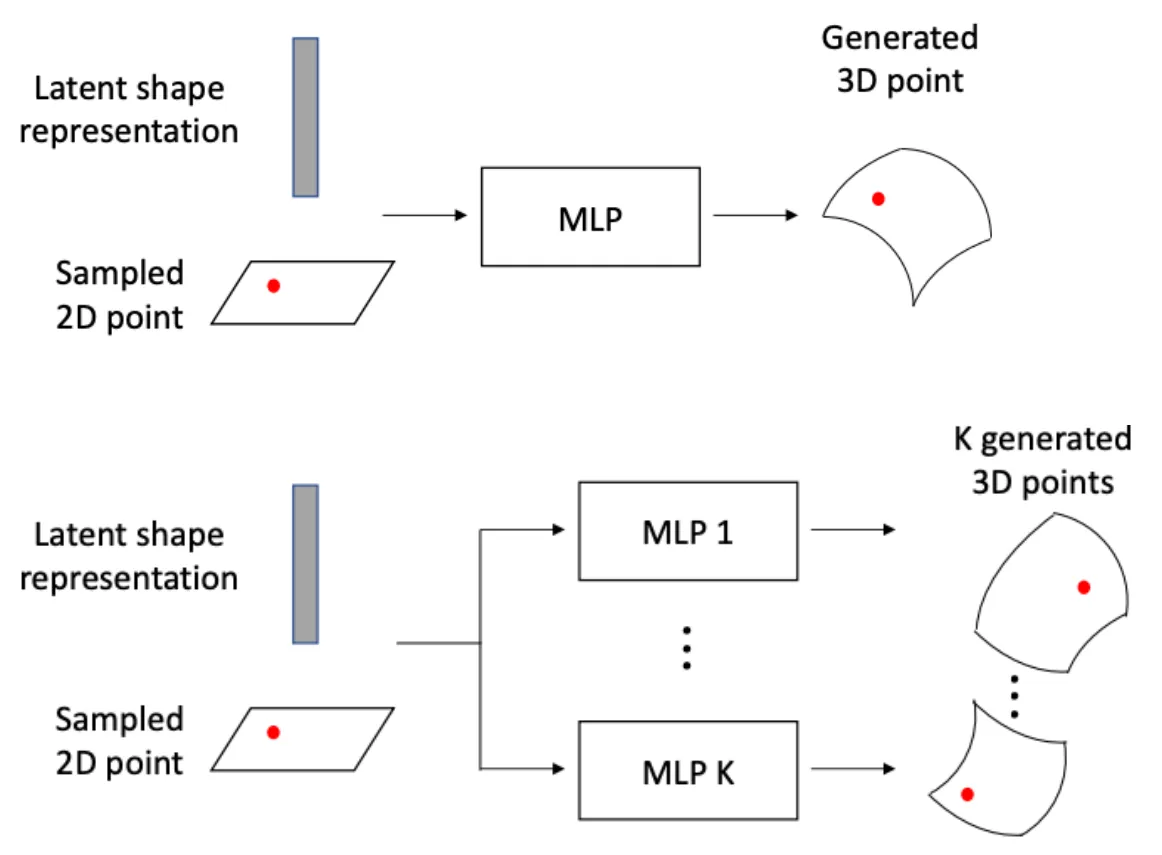
AtlasNet은 복잡한 parametric mapping을 닫힌 형태의 수식 대신 MLP로 학습한다. 2D patch 좌표 와 입력의 latent shape code 를 넣어 3D 점을 출력한다.
하나의 patch만으로 복잡한 topology를 표현하기 어려우므로 여러 mapping을 함께 사용한다.
각 네트워크는 2D patch 좌표를 3D 표면 위 점으로 mapping하고, 여러 patch가 물체 전체를 덮는다. Voxel보다 해상도 제약이 적고 point cloud보다 매끄러운 표면을 제공하지만, patch 사이 경계의 틈과 겹침을 관리해야 한다.
Deep implicit function
AtlasNet이 를 표면 위 3D 좌표로 보내는 함수를 학습했다면, 여기서는 3D 좌표에서 inside/outside나 거리를 반환하는 함수를 신경망으로 학습한다. Latent shape code 와 query point 를 입력받아 occupancy나 SDF를 예측한다.
Occupancy 네트워크라면 는 점이 물체 내부일 확률이다.
SDF 네트워크라면 scalar signed distance를 출력한다.
필요한 좌표에서 네트워크를 query하므로 고정 grid의 해상도에 묶이지 않고 연속적인 좌표에서 표면을 표현할 수 있다.
학습에는 query point와 그 점의 occupancy 또는 SDF label이 필요하다. 추론에서는 많은 좌표를 평가한 뒤 zero level set을 Marching Cubes로 추출할 수 있다. Dense grid를 저장하지 않아도 되지만 고해상도 표면 추출에는 여전히 많은 네트워크 query가 필요하다.
Neural Radiance Field
Neural Radiance Field, NeRF는 neural implicit function을 geometry뿐 아니라 appearance까지 확장한다. Query position 와 viewing direction 를 입력받아 volume density 와 색상 를 출력한다.
Density는 해당 위치가 ray의 빛을 얼마나 가리는지 나타내며 geometry를 암묵적으로 표현한다. 색상이 viewing direction에도 의존하게 하면 specular reflection처럼 보는 방향에 따라 달라지는 appearance를 모델링할 수 있다.
카메라 원점 에서 방향 로 나가는 ray는 다음과 같다.
NeRF는 ray 위의 여러 에서 점을 샘플링하고 각 위치의 density와 색상을 예측한다.
%% title: NeRF의 Ray Sampling과 Pixel Rendering
%% caption: 카메라 ray 위의 여러 3D 위치를 neural field에 query해 density와 색상을 얻고, transmittance를 고려한 alpha compositing으로 하나의 픽셀 색상을 만든다.
flowchart LR
    camera["Camera Origin o<br/>Ray Direction d"] --> samples["Sample Points<br/>xᵢ = o + tᵢd"]
    samples --> field["NeRF MLP Fθ(xᵢ, d)"]
    field --> density["Density σᵢ"]
    field --> color["Color cᵢ"]
    density --> weights["Transmittance × Alpha<br/>wᵢ"]
    color --> composite["Volume Rendering<br/>Ĉ(r) = Σ wᵢcᵢ"]
    weights --> composite
    composite --> pixel["Rendered Pixel"]
    target["Observed Pixel"] --> loss["Photometric Loss"]
    pixel --> loss
    loss -. "backpropagation" .-> field
Differentiable volume rendering
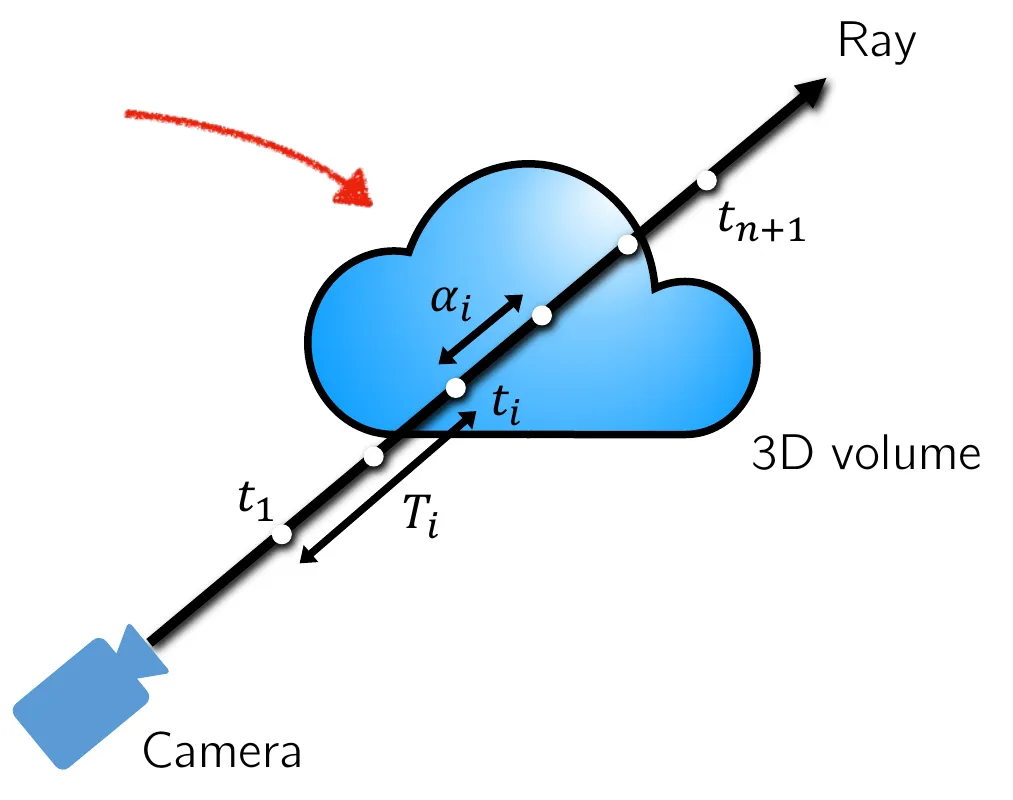
샘플 사이 간격을 라 하면 점 에서 빛이 흡수될 확률은 다음과 같다.
앞선 샘플들을 통과해 번째 샘플까지 도달할 transmittance는 다음과 같다.
같은 값을 alpha의 곱으로 쓸 수도 있다.
최종 픽셀 색상은 각 샘플 색상을 alpha compositing한 합이다.
는 카메라 ray가 앞의 모든 샘플을 통과한 뒤 정확히 번째 샘플에서 색상을 얻을 weight이다. 앞쪽 density가 크면 뒤쪽 샘플의 기여도는 작아진다.
모든 항이 미분 가능하므로 렌더링한 색상과 관측된 픽셀 색상 사이의 reconstruction loss로 neural field를 학습할 수 있다.
은 학습 이미지에서 샘플링한 카메라 ray 집합이다. Gradient는 volume rendering 수식을 거쳐 각 샘플의 색상과 density, 다시 네트워크 parameter 로 전달된다.
NeRF가 2D image로 3D를 학습하는 방식
기존 deep implicit geometry는 query point의 occupancy나 SDF ground truth가 필요했다. NeRF는 카메라 pose를 알고 있는 여러 2D 이미지를 supervision으로 사용한다.
- 학습 이미지에서 pixel과 카메라 ray를 샘플링한다.
- Ray 위의 3D 점들을 샘플링한다.
- NeRF에서 density와 색상을 query한다.
- Volume rendering으로 예측한 픽셀 색상을 계산한다.
- 관측된 픽셀과의 차이를 줄이도록 네트워크를 갱신한다.
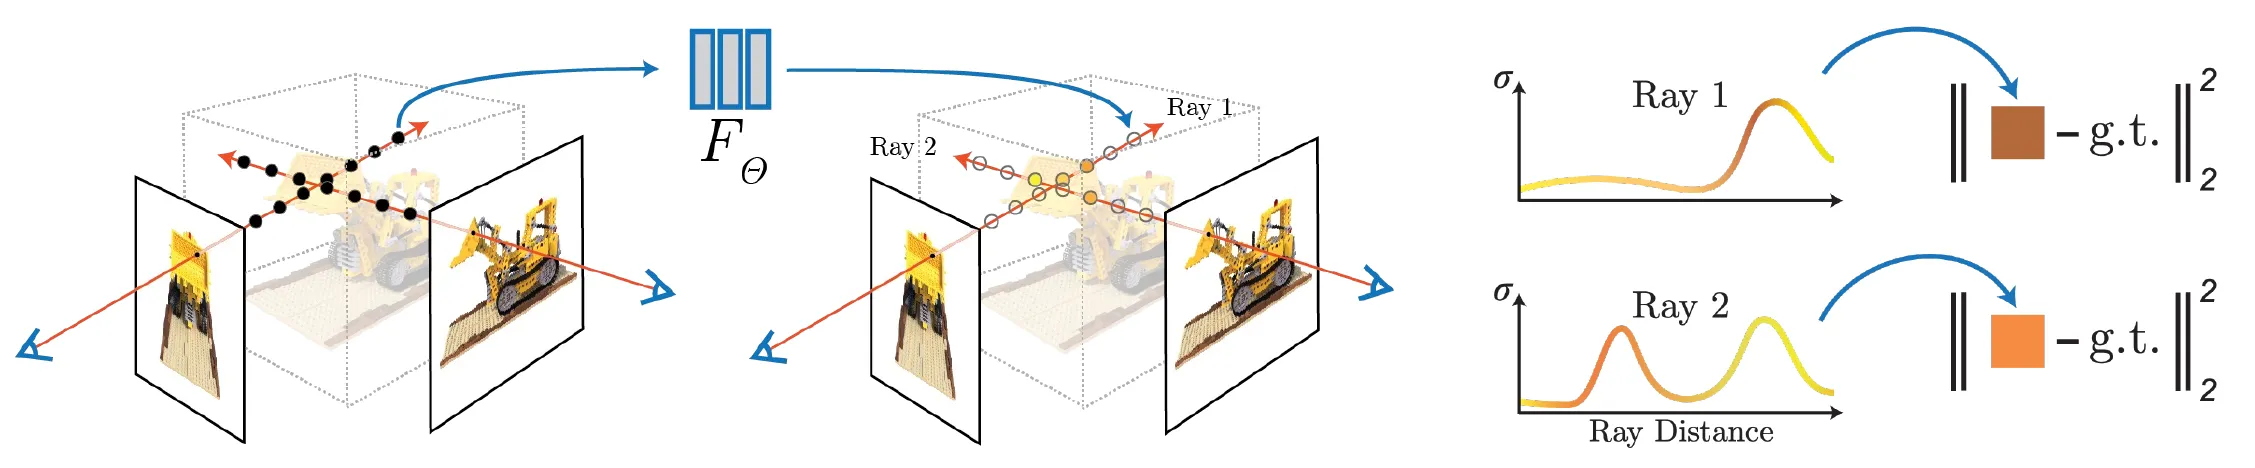
여러 카메라 시점을 동시에 설명하려면 서로 일관된 3D density와 appearance field가 필요하다. 학습 후 새로운 카메라 원점과 방향으로 ray를 만들면 학습에 없던 시점의 이미지를 렌더링할 수 있다. 이것이 novel-view synthesis이다.
NeRF를 생성모델로 확장하기
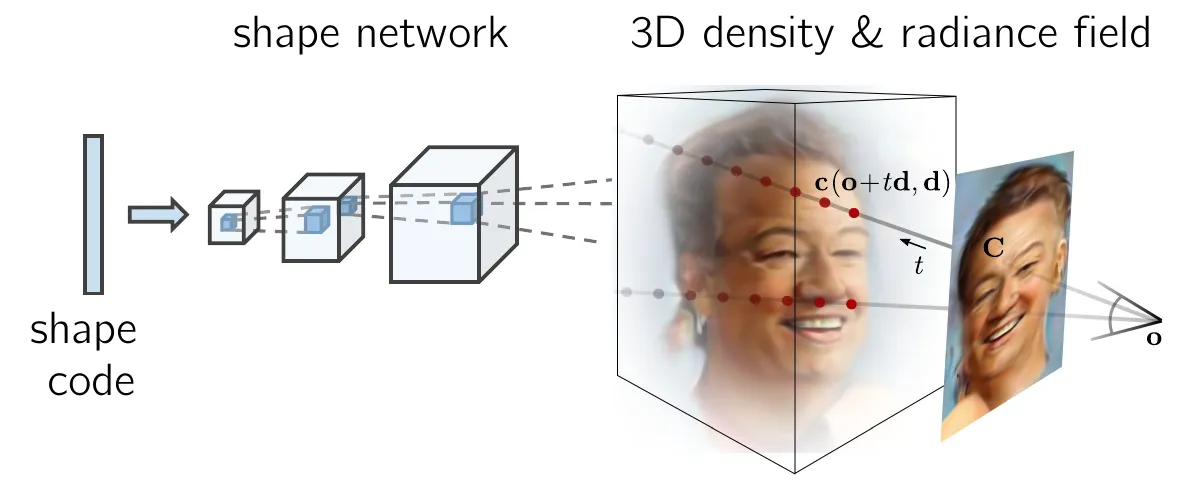
앞의 3D GAN에서 voxel로 표현하던 형상을 radiance field로 바꿀 수도 있다. Latent vector를 조건으로 density와 radiance를 예측하고, 렌더링한 이미지에 adversarial loss를 적용해 생성모델을 학습한다.
이 경우에는 3D 형상 정답 없이 2D 이미지로 학습할 수 있다. Latent vector로 물체의 형태를 바꾸고, 카메라 시점을 바꾸어 같은 물체를 다른 방향에서 렌더링할 수 있다.
NeRF의 계산 비용
Vanilla NeRF는 이미지의 각 ray마다 많은 3D 샘플을 만들고 각 샘플에서 MLP를 평가한다. 빈 공간의 점도 반복해서 query하므로 학습과 렌더링이 느리다.
Hierarchical sampling, occupancy grid, hash-grid encoding 등은 빈 공간 query를 줄이거나 field 계산을 빠르게 한다.
3D Gaussian Splatting
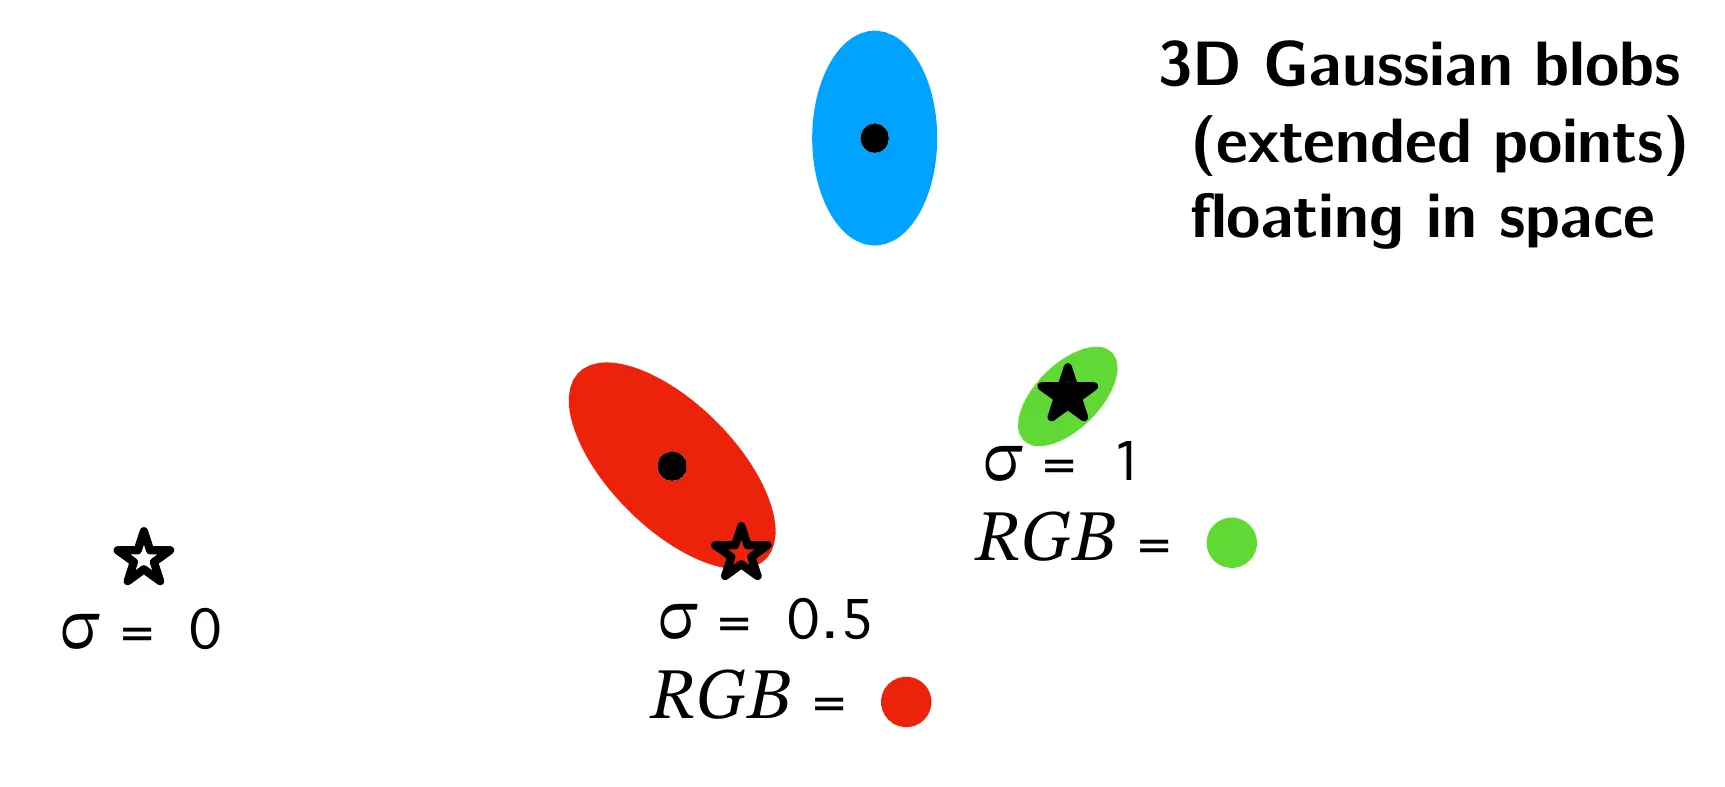
3D Gaussian Splatting은 학습 가능한 3D Gaussian primitive 집합으로 장면을 나타내는 explicit representation이다. 각 Gaussian은 다음과 같은 parameter를 가진다.
는 중심, 는 형상과 방향을 나타내는 공분산, 는 opacity, 는 색상 또는 view-dependent appearance coefficient이다.
Gaussian density의 형태는 다음과 같다.
각 3D Gaussian을 카메라 평면에 projection하면 2D ellipse가 된다. Renderer는 pixel에 영향을 주는 Gaussian만 depth 순서로 alpha compositing한다. Gaussian의 위치를 알고 있으므로 전체 3D 공간을 균일하게 샘플링하거나 모든 ray 위 점에서 MLP를 호출할 필요가 없다.
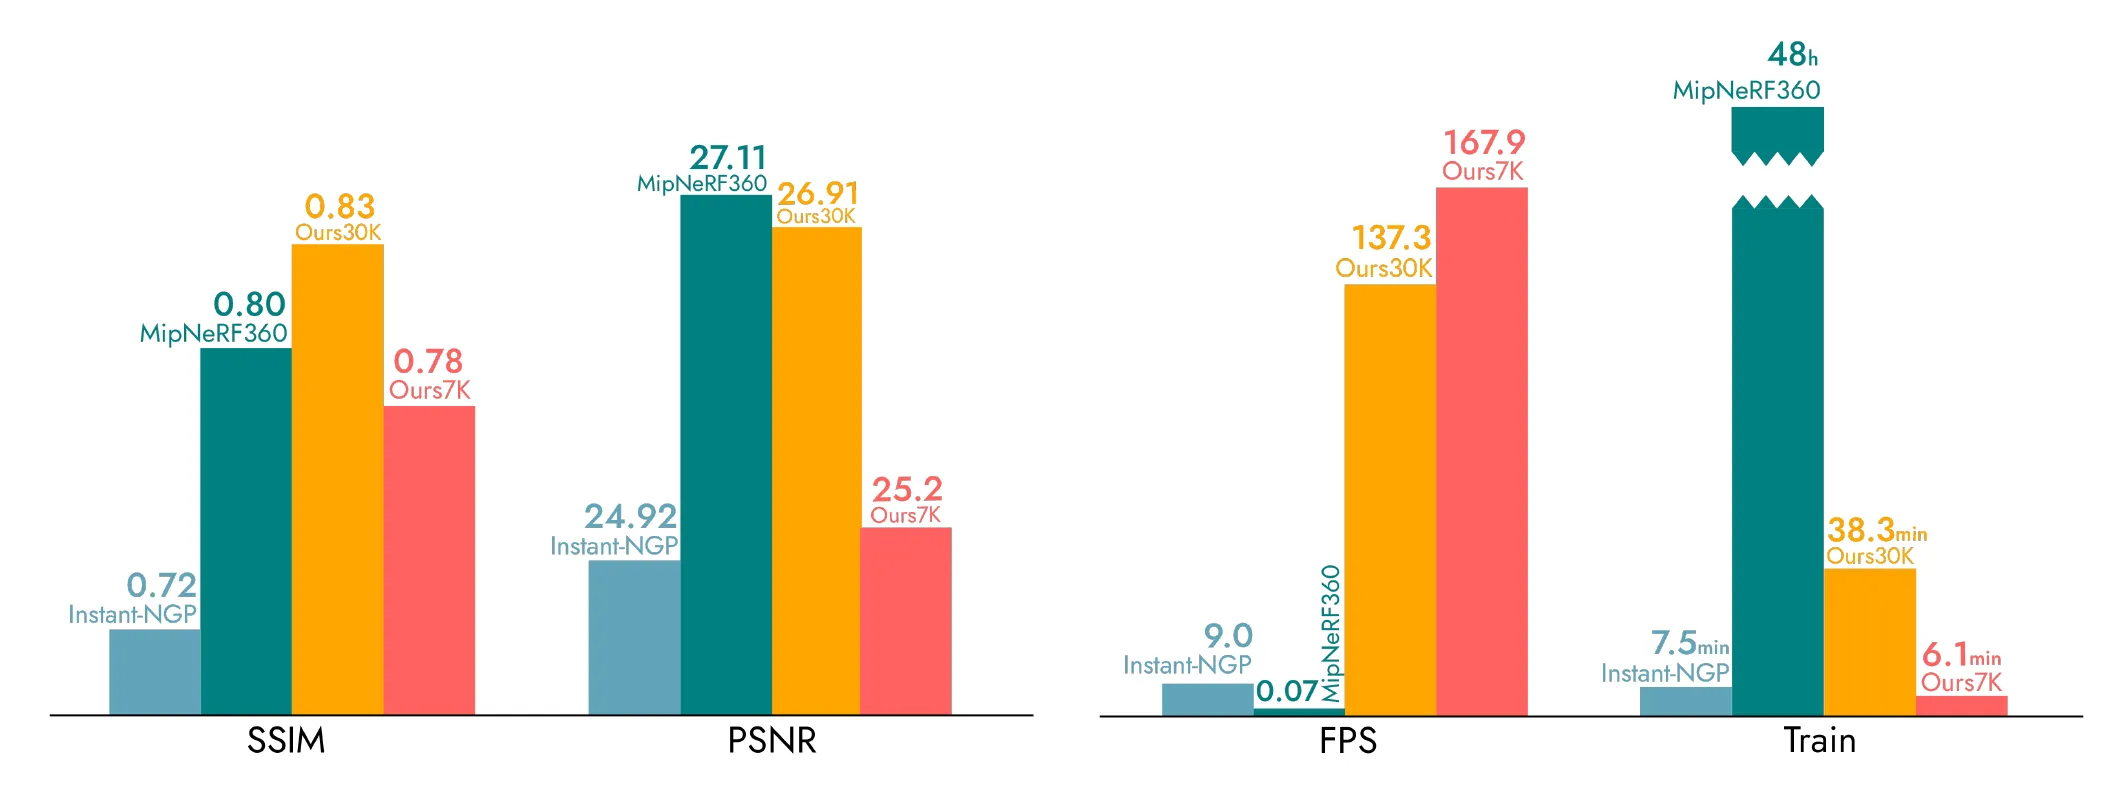
강의의 비교에서는 PSNR과 SSIM으로 측정한 렌더링 품질이 당시 NeRF와 비슷하면서, Gaussian Splatting은 약 150 FPS를 보였고 vanilla NeRF는 이미지 한 장에 약 20초가 걸리는 예가 제시되었다. 측정 속도는 하드웨어와 구현에 따라 달라진다.
다음 그래프는 MipNeRF360·Instant-NGP와 Gaussian Splatting을 비교한다. SSIM·PSNR은 렌더링 품질, FPS는 렌더링 속도, Train은 학습 시간이다.
%% title: 3D Gaussian Splatting Rendering Pipeline
%% caption: 학습 가능한 3D Gaussian을 카메라 평면에 투영하고, screen-space ellipse를 depth 순서로 alpha blending해 이미지를 렌더링한다.
flowchart LR
    gaussians["3D Gaussians<br/>mean · covariance · opacity · color"] --> project["Project with Camera"]
    project --> ellipses["2D Screen-Space Ellipses"]
    ellipses --> tiles["Tile Culling + Depth Sort"]
    tiles --> blend["Front-to-Back<br/>Alpha Blending"]
    blend --> image["Rendered Image"]
    target["Target View"] --> loss["Image Loss"]
    image --> loss
    loss -. "optimize" .-> gaussians
3D structure는 local geometry만으로 충분하지 않다
점, mesh, SDF, radiance field는 local geometry와 appearance를 자세히 표현하지만 symmetry, repetition, 부품 사이 관계 같은 상위 구조를 직접 나타내지는 않는다.
의자를 예로 들면 좌석, 등받이, 받침대, 다리라는 부품의 계층 구조가 있고, 왼쪽과 오른쪽 다리 사이에는 symmetry와 alignment 제약이 있다. 실내 장면에서는 침대가 벽 가까이에 있고 의자가 탁자 주변에 놓이는 식의 물체 사이 관계가 있다.
이를 나타내기 위한 representation은 다음과 같다.
- Primitive set: box, cylinder 같은 단순한 부품의 조합이다.
- Part graph: node는 부품, edge는 symmetry나 인접 관계를 나타낸다.
- Hierarchical graph: 물체, 부품, 하위 부품을 여러 수준으로 표현한다.
- Shape program: loop, repetition, transform 같은 명령으로 geometry를 생성한다.
Neural encoder와 decoder가 이런 graph나 프로그램을 생성하도록 학습하면 부품 사이의 symmetry, alignment, 계층 구조를 출력에 명시할 수 있다.
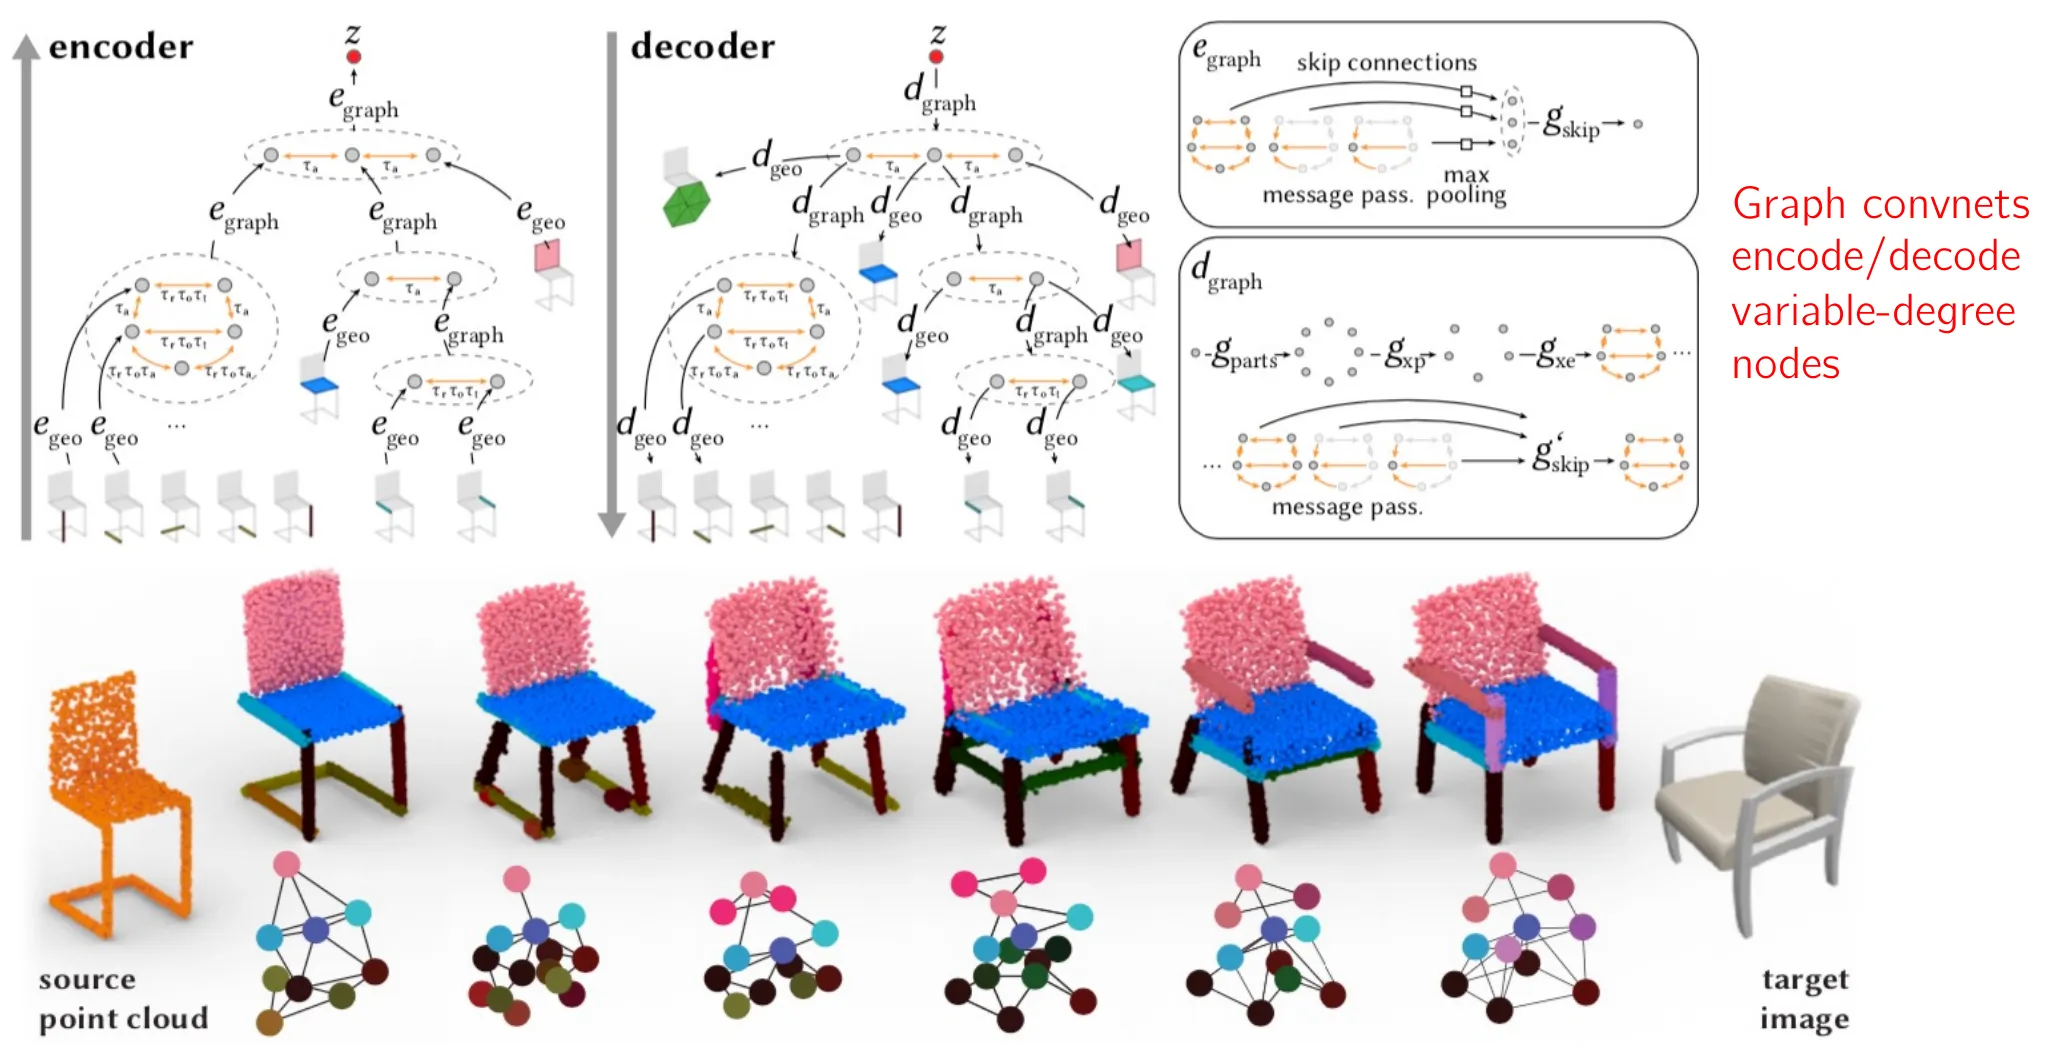
강의자는 마지막으로 LLM이 물체의 의미와 부품 관계를 바탕으로 shape program을 생성하고, implicit function이 각 부품의 세부 geometry를 표현하는 조합을 연구 방향으로 제안한다.
3D representation의 발전 흐름
- Multi-view CNN은 3D 물체를 이미지로 바꾸어 pretrained 2D CNN을 사용했다.
- Voxel과 3D CNN은 regular grid 덕분에 3D-native learning을 쉽게 만들었지만 세제곱으로 증가하는 비용이 컸다.
- Octree는 표면 근처에 해상도를 집중해 dense voxel의 낭비를 줄였다.
- PointNet은 symmetric aggregation으로 순서 없는 점 집합을 직접 처리했다.
- AtlasNet은 learned parametric patch로 매끄러운 표면을 생성했다.
- Deep implicit function은 좌표를 query하는 네트워크로 continuous geometry를 표현했다.
- NeRF는 density와 radiance, differentiable volume rendering을 결합해 2D 이미지에서 3D 장면을 학습했다.
- 3D Gaussian Splatting은 sparse explicit primitive로 novel-view 렌더링을 크게 가속했다.
하나의 시스템에서도 센서 입력은 point cloud로 받고, optimization에는 neural field를 사용하며, 렌더링이나 downstream engine에 전달할 때는 mesh를 추출할 수 있다.