
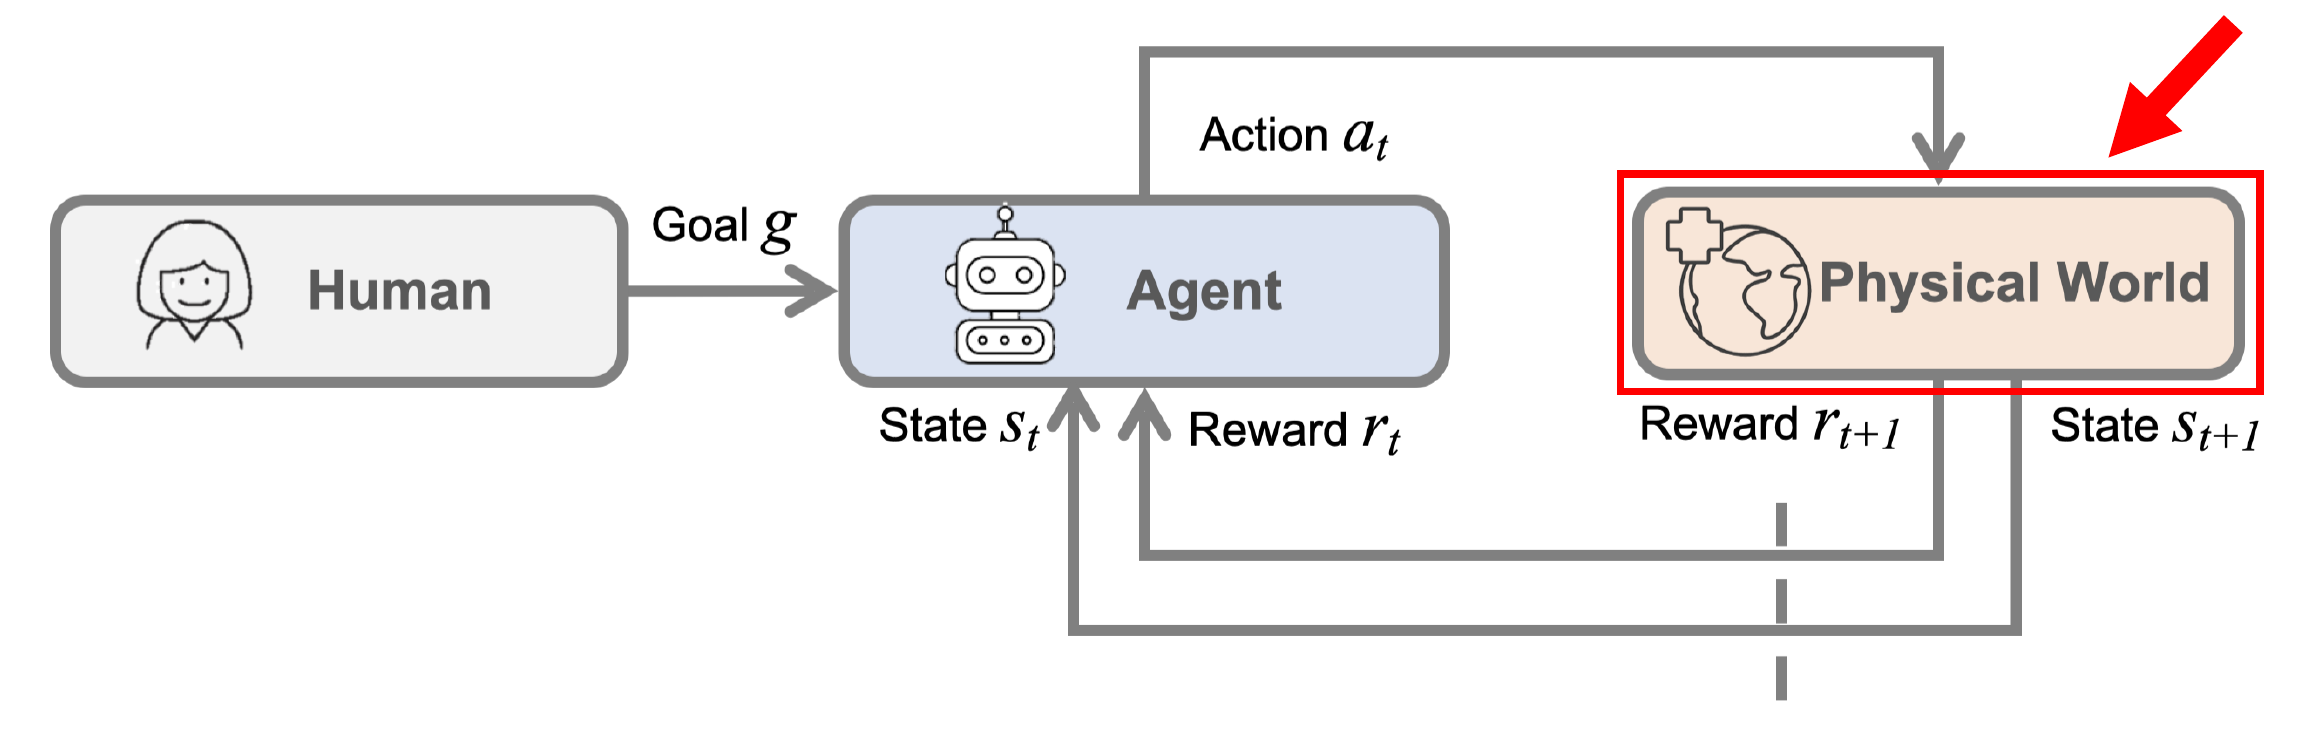
- CS231n Lecture 17 - Robot Learning reinforcement learning, model-based planning, imitation learning, vision-language-action models Robot learning은 action으로 환경을 바꾸며 장기적인 reward를 높이는 policy를 학습하는 sequential decision-making 문제이다. Supervised learning은 고정된 데이터셋의 입력 에서 label 를 예측한다.
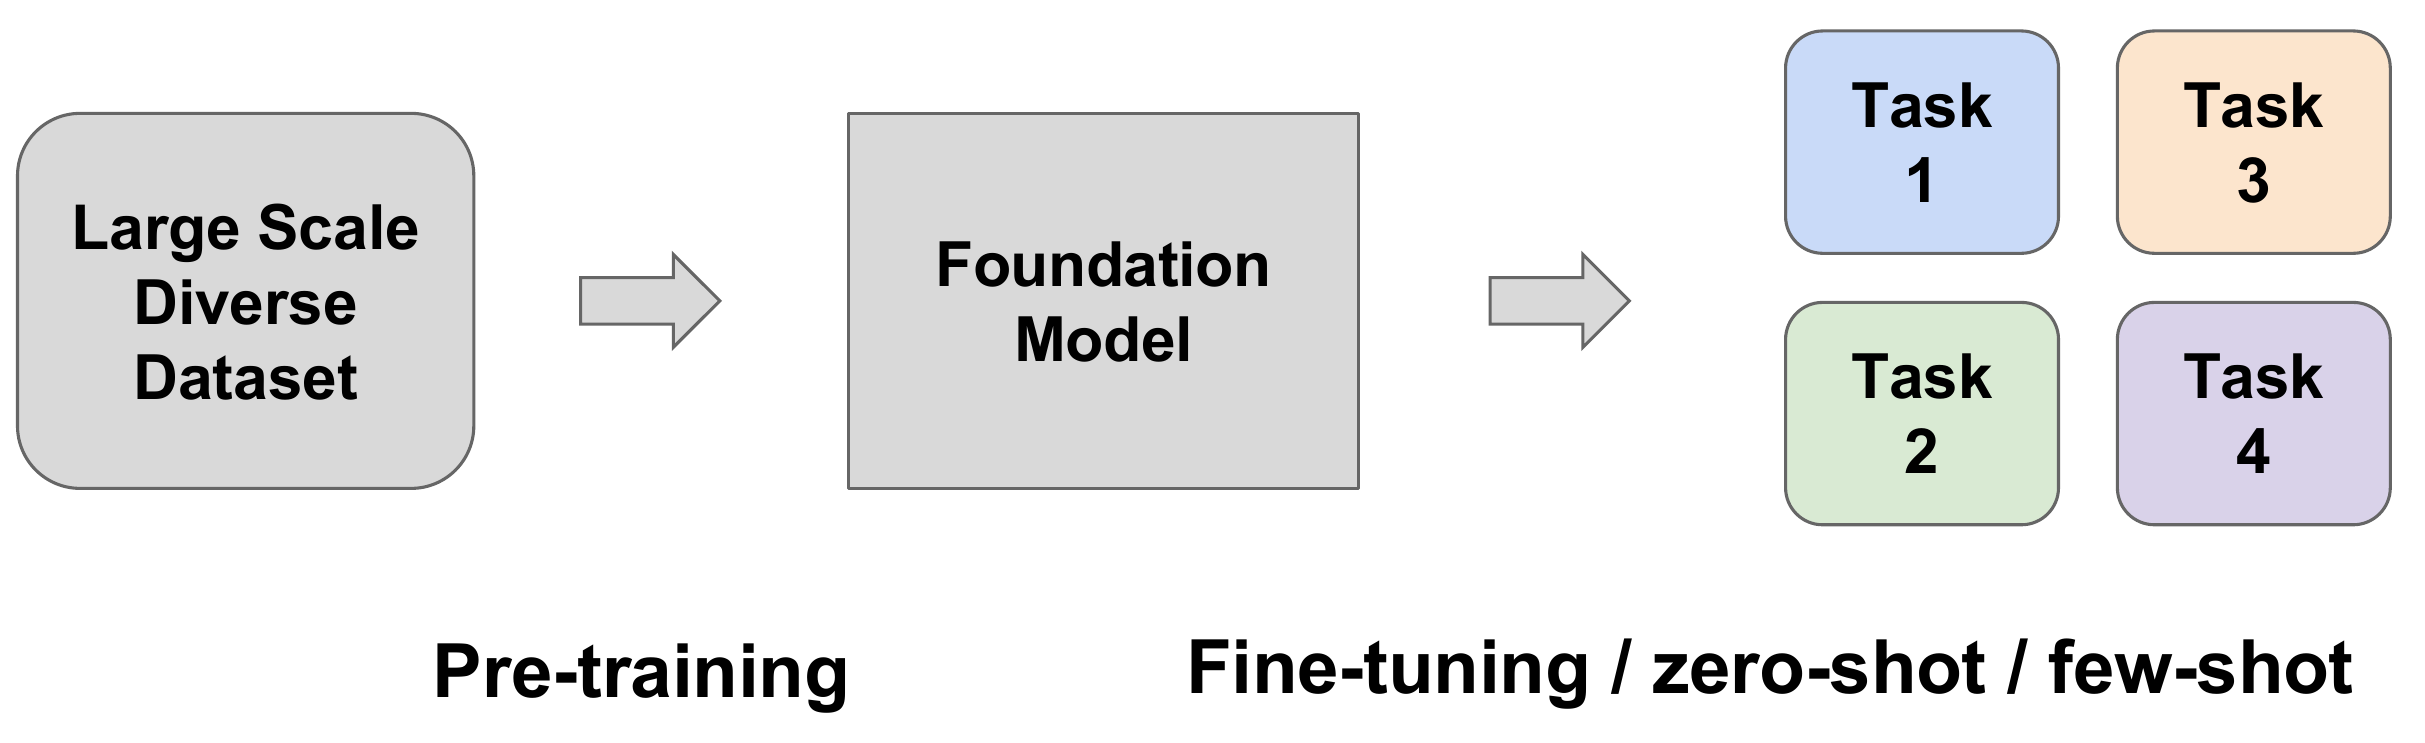
- CS231n Lecture 16 - Vision and Language CLIP, multimodal language models, grounding, model chaining Vision-language foundation model은 이미지와 텍스트를 공통 representation으로 정렬하거나 visual token을 language model의 context로 주입해 여러 과제를 하나의 pretrained model로 풀며, grounding과 promptable output, tool chaining을 더해 텍스트 응답을 실제 픽셀과 전문 vision model의 동작으로 연결한다. 전통적인 computer vision pipeline은 과제마다 데이터셋과 모델을 따로 만든다.
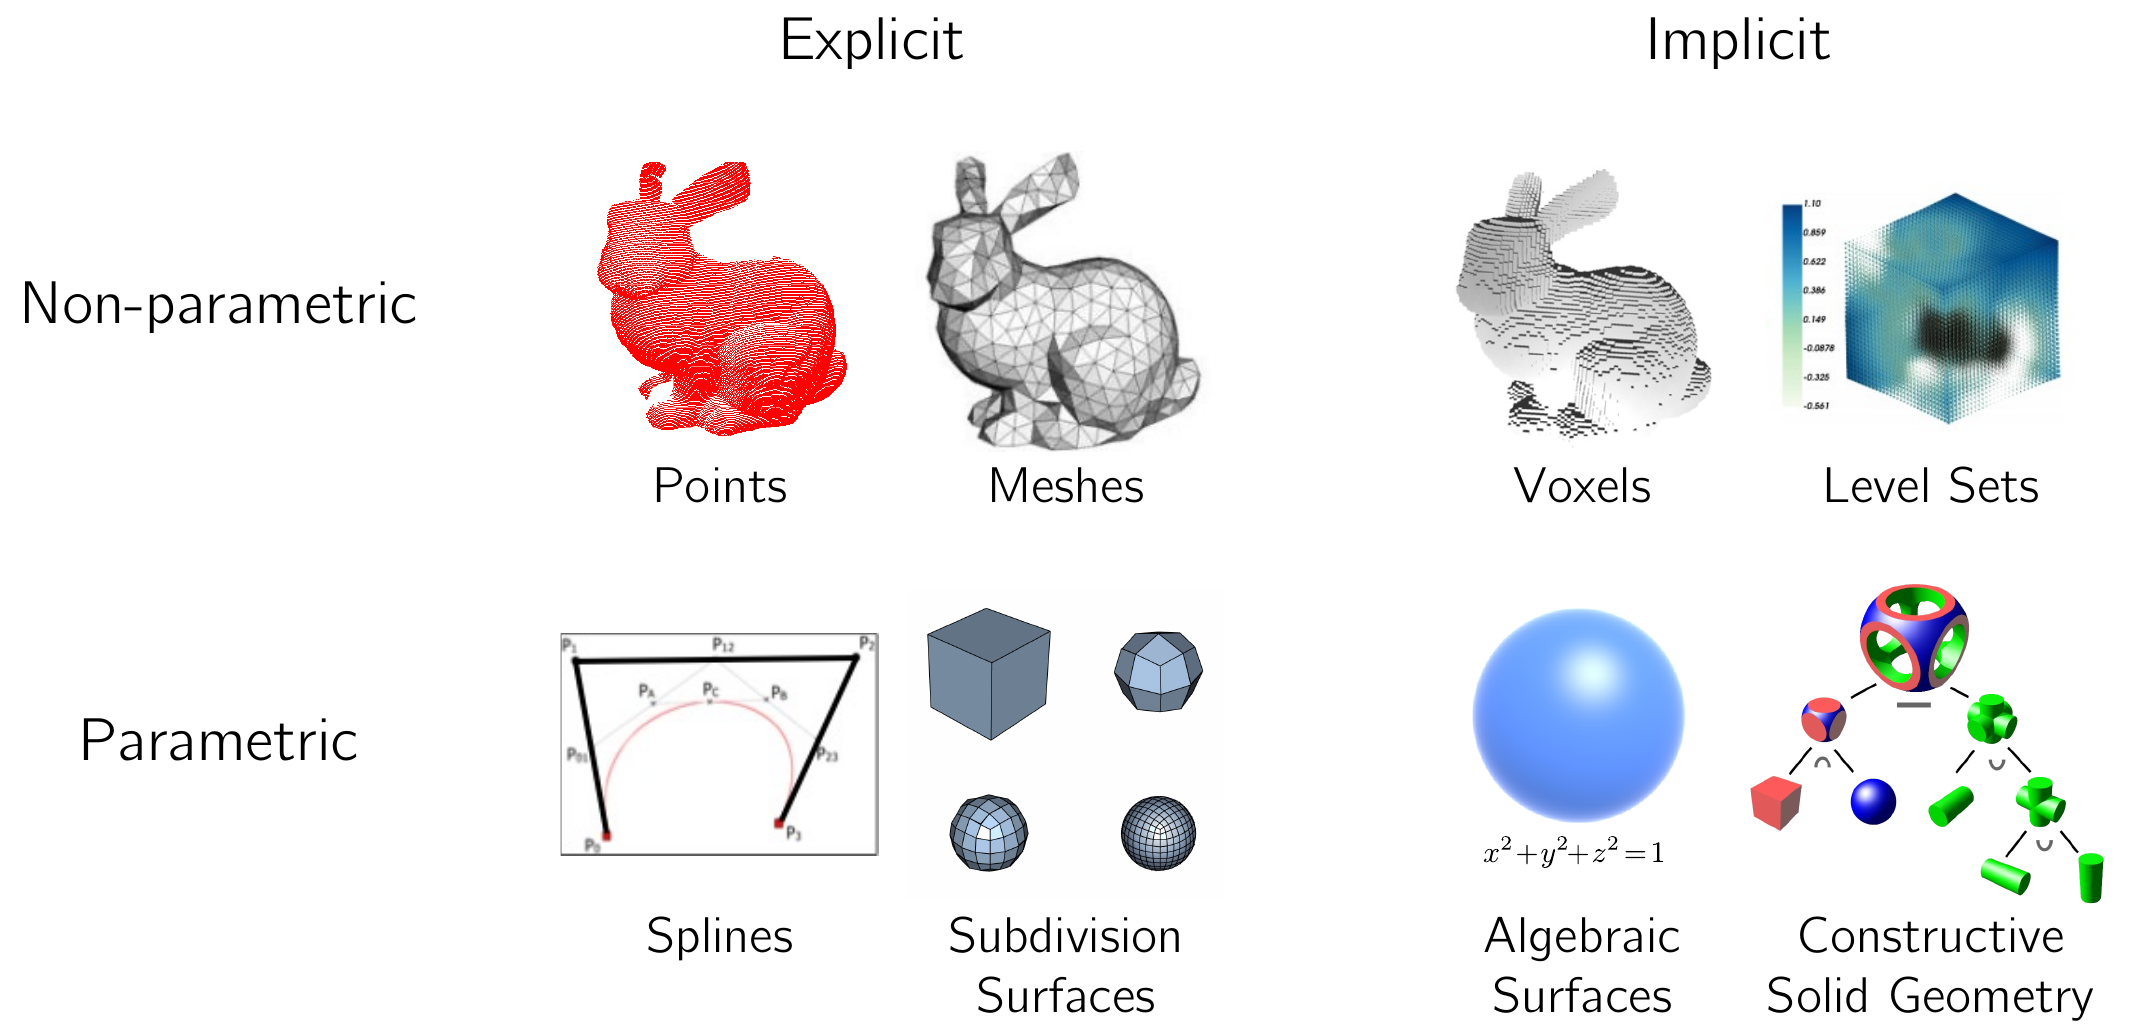
- CS231n Lecture 15 - 3D Vision 3D representations, neural fields, NeRF, Gaussian splatting 3D vision은 geometry와 appearance를 point cloud, mesh, voxel, implicit function 등으로 표현하고, 2D·3D 관측에서 이를 학습해 장면 복원과 새로운 시점의 이미지 합성에 사용한다. 2D 이미지는 보통 일정한 grid 위의 pixel tensor로 표현한다. 반면 3D 물체는 geometry뿐 아니라 질감, 재질, 조명에 따른 appearance까지 포함하며, 이를 표현하는 표준적인 형식이 하나로 정해져 있지 않다.
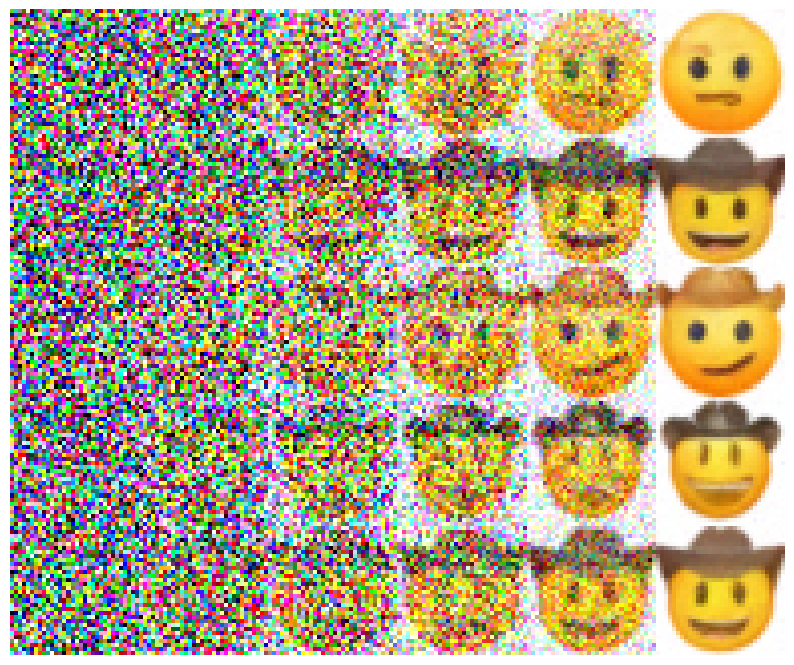
- Assignment 3-3: Denoising Diffusion Probabilistic Models Forward Diffusion, Reverse Diffusion, U-Net 기반 Noise Prediction, Reverse Sampling, Classifier-Free Guidance 구현 및 평가 이번 과제에서는 Denoising Diffusion Probabilistic Model(DDPM)의 핵심 구성요소를 구현하고, noisy image를 점진적으로 denoise하여 이미지를 생성하는 과정을 배운다. DDPM은 데이터 분포에서 바로 샘플을 생성하는 대신, 먼저 실제 이미지에 Gaussian noise를 점진적으로 추가하는 Forward Diffusion을 정의하고, 반대로 노이즈에서 이미지를 복원하는 Reverse Diffusion을 학습한다. Forward process 자체는 고정된 noise schedule에 의해 결정되며, 실제로 학습되는 부분은 각 timestep에서 noisy image를 보고 노이즈 또는 원본 이미지를 예측하는 denoising model이다. 이 denoising model로 U-Net을 사용한다.
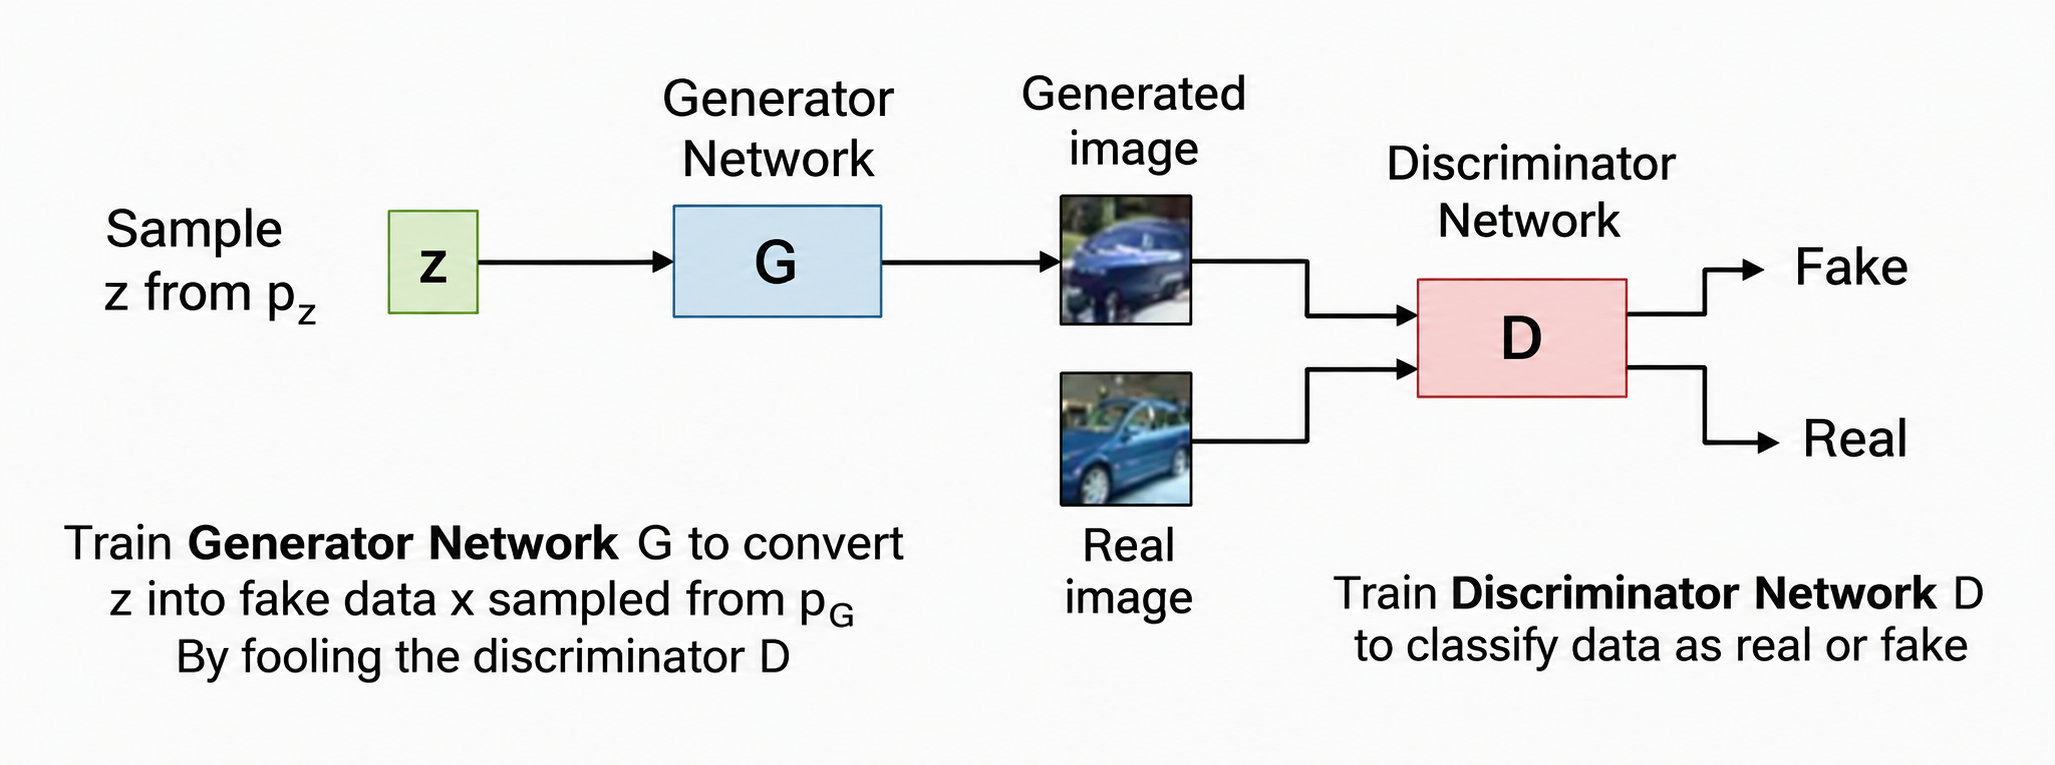
- CS231n Lecture 14 - Generative Models 2 Generative adversarial networks, rectified flow, latent diffusion GAN은 discriminator와 generator의 adversarial game으로 data distribution을 암묵적으로 맞추고, diffusion과 rectified flow는 노이즈와 데이터 사이의 경로를 학습해 반복적인 reverse process로 샘플을 생성한다. 명시적 밀도 모델(explicit density model)은 데이터 에 대한 확률밀도 를 명시적으로 정의한다. Autoregressive model은 이를 정확하게 계산하고, VAE는 로그우도의 하한인 ELBO를 계산한다.
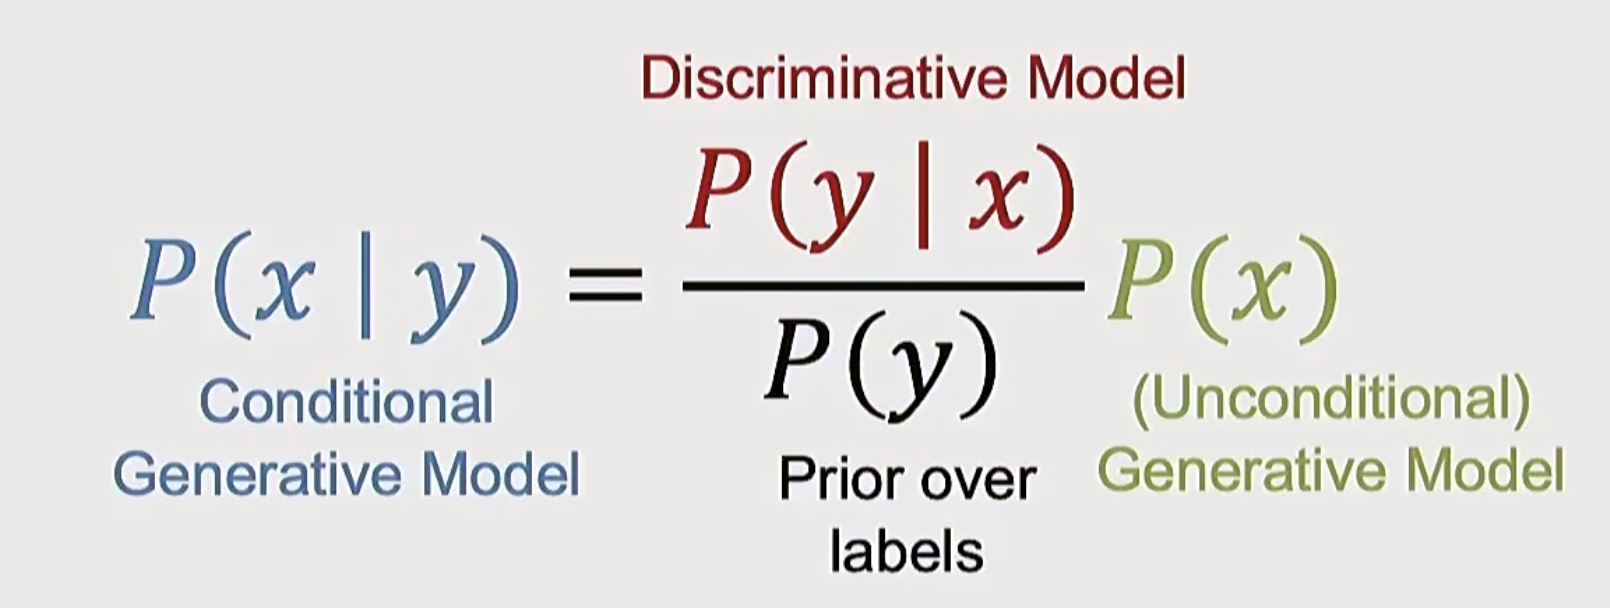
- CS231n Lecture 13 - Generative Models 1 Maximum likelihood, autoregressive models, variational autoencoders Generative model은 data를 만든 probability distribution을 학습하는 모델이며, autoregressive model은 chain rule로 exact likelihood를 계산하고 VAE는 latent variable과 ELBO를 도입해 tractable한 lower bound로 학습한다. Supervised learning에서는 input과 target의 pair가 주어진다.
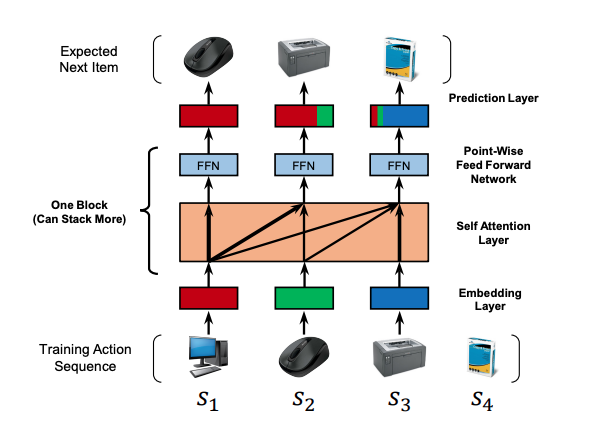
- 논문 리뷰: Self-Attentive Sequential Recommendation SASRec 리뷰 논문: Self-Attentive Sequential Recommendation 저자: Wang-Cheng Kang, Julian McAuley 학회: IEEE International Conference on Data Mining (ICDM) 연도: 2018 논문 링크: arXiv:1808.09781 ---
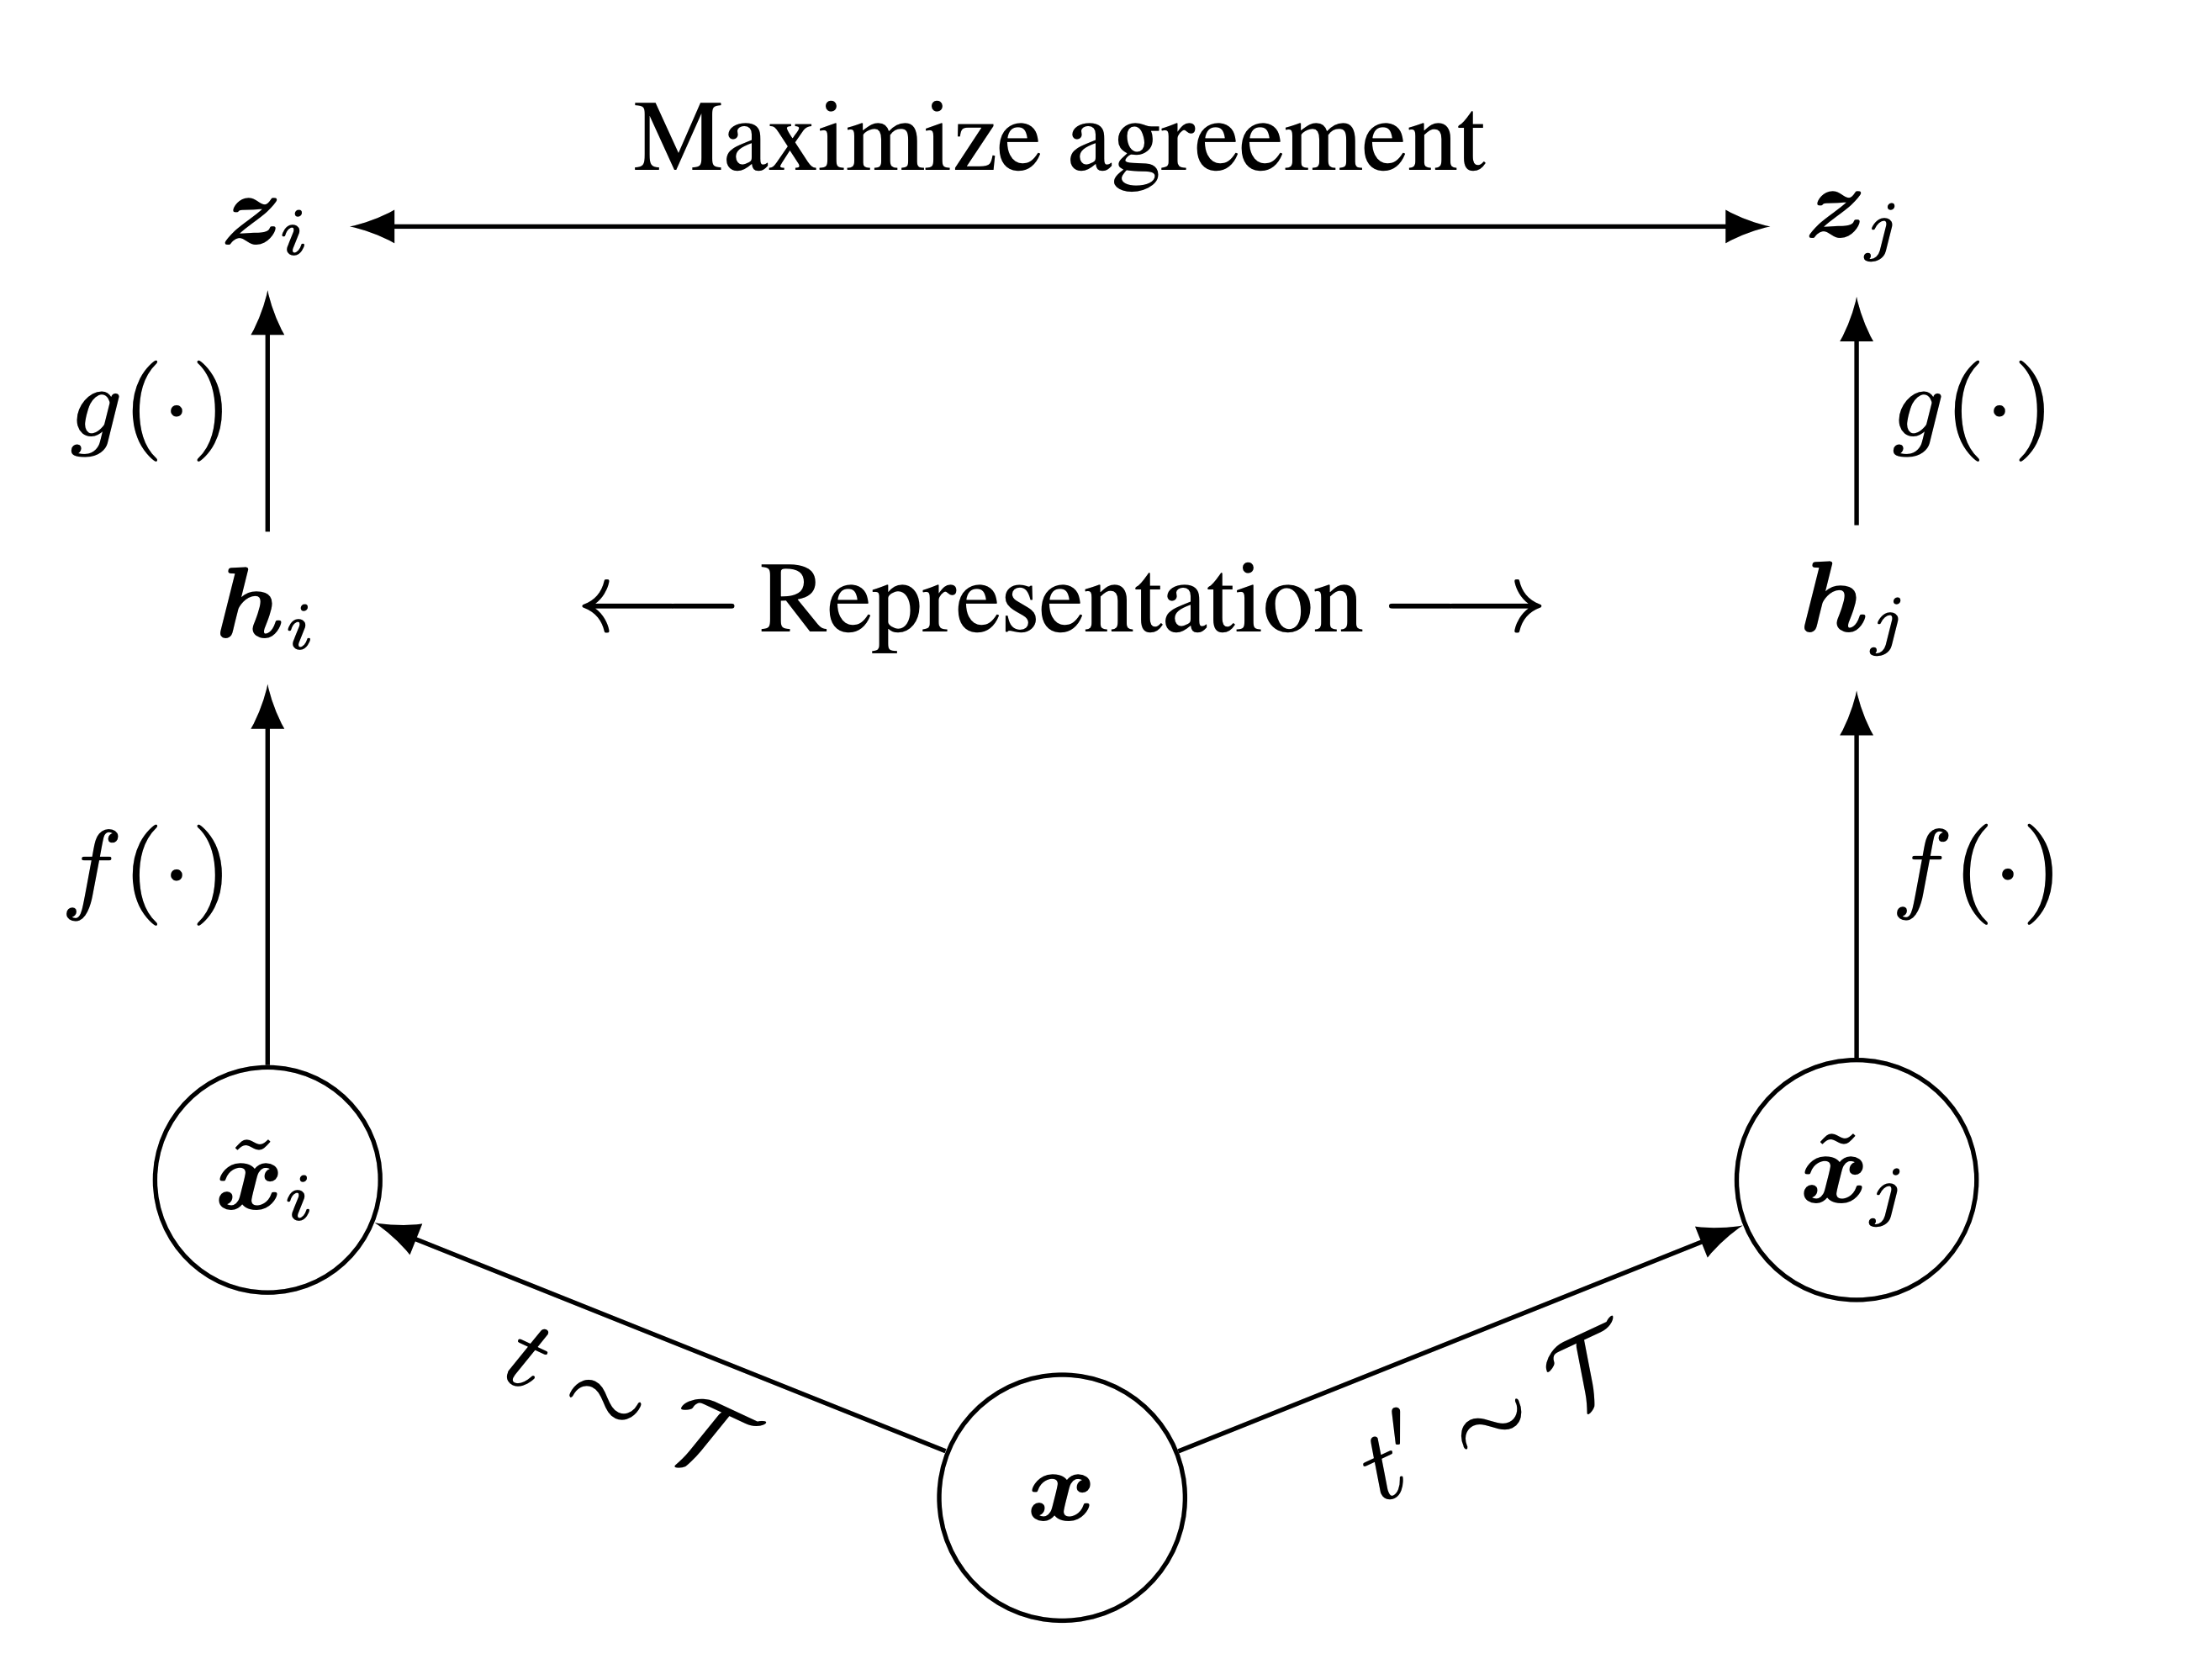
- Assignment 3-2: Self-Supervised Learning for Image Classification SimCLR의 data augmentation, NT-Xent loss 구현과 self-supervised representation의 image classification 평가 이번 과제에서는 label 없이 image representation을 학습하는 self-supervised learning과 SimCLR의 contrastive learning을 구현하고, 학습된 representation이 downstream image classification에 얼마나 유용한지 평가한다. Supervised learning은 이미지와 사람이 붙인 class label의 관계를 학습한다. 반면 self-supervised learning은 data 자체에서 학습 신호를 만든다. SimCLR에서는 같은 이미지에 서로 다른 random augmentation을 적용해 두 view를 만들고, 이 둘을 positive pair로 취급한다. Model은 positive pair의 representation을 가깝게 만들고, batch 안의 다른 이미지에서 나온 view는 멀어지게 학습한다.
- [Google Recommendation Systems 06] Retrieval, Scoring, Re-ranking 추천 시스템의 retrieval, scoring, re-ranking 파이프라인과 freshness, diversity, fairness Google 공식 원문: Retrieval, Scoring, Re-ranking, Course summary 대규모 추천 시스템은 corpus 전체를 하나의 복잡한 모델로 정렬하지 않는다. 수백만 개 이상의 item을 요청마다 모두 평가하면 latency와 compute 비용을 감당하기 어렵기 때문이다. 대신 대상을 단계적으로 줄이는 funnel 구조를 사용한다. Retrieval 또는 candidate generation: 전체 corpus에서 관련 가능성이 있는 candidate 수백수천 개를 빠르게 가져온다. Scoring과 ranking: 더 많은 feature와 복잡한 모델로 candidate의 relevance를 평가하고 순서를 정한다. Re-ranking: freshness, diversity, fairness, 정책 같은 추가 기준과 제약을 반영해 최종 노출 목록을 만든다.
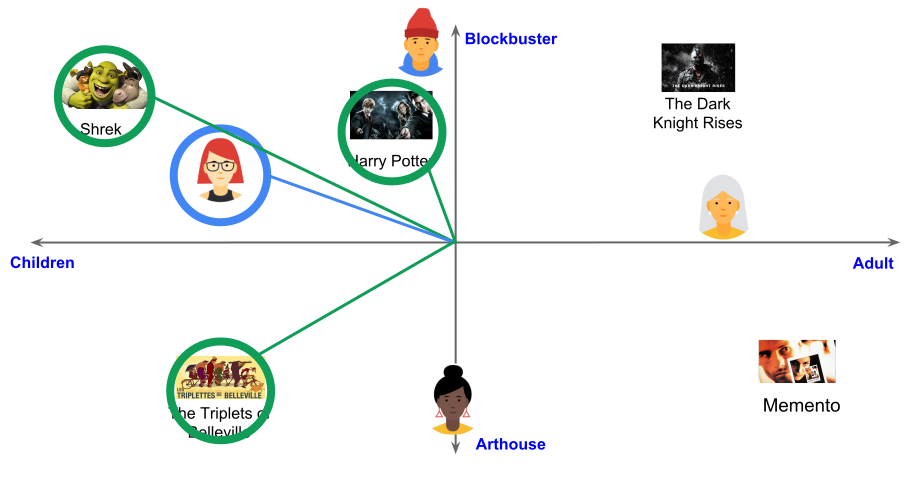
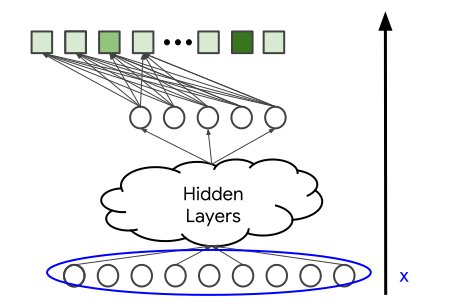
- [Google Recommendation Systems 05] Softmax DNN과 Two-Tower Softmax DNN 추천 모델의 구조와 embedding 해석, negative sampling, two-tower 모델 Google 공식 원문: Deep neural network models, Softmax training 이전 글의 matrix factorization은 사용자와 item마다 하나의 embedding을 학습하고, 두 embedding의 내적으로 선호도를 예측했다. 단순하고 대규모 corpus에도 잘 확장되지만 다음과 같은 한계가 있다. user ID와 item ID 이외의 side feature를 모델에 넣기 어렵다. 학습 데이터에 없던 새로운 user나 item을 바로 처리하기 어렵다. dot product를 그대로 사용하면 norm이 큰 인기 item이 많은 사용자에게 반복해서 추천되기 쉽다. 사용자의 현재 문맥이나 구체적인 관심사를 세밀하게 반영하기 어렵다.
마지막 글입니다.