
핵심 한 줄 정리
Robot learning은 action으로 환경을 바꾸며 장기적인 reward를 높이는 policy를 학습하는 sequential decision-making 문제이다.
중요 개념 정리
Robot learning이 일반적인 supervised learning과 다른 점
Supervised learning은 고정된 데이터셋의 입력 에서 label 를 예측한다.
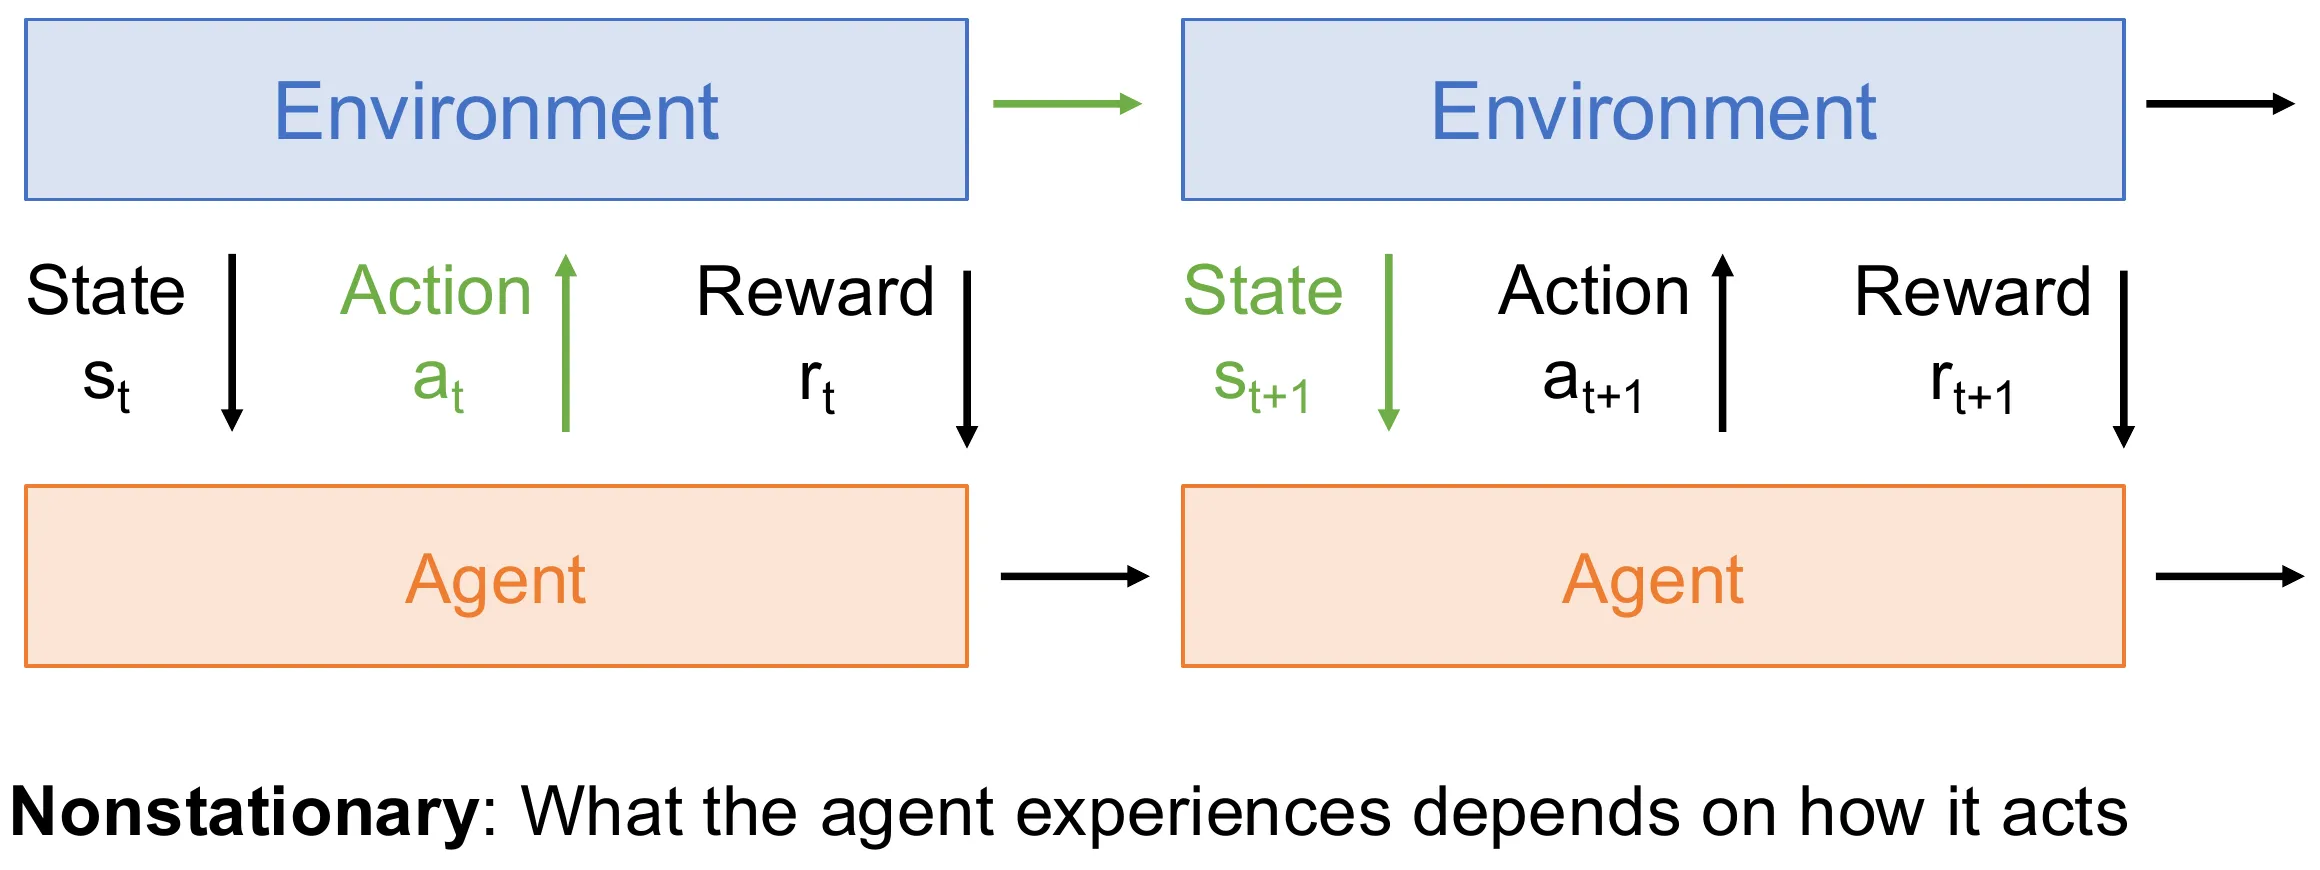
예측이 틀려도 다음 입력의 분포는 바뀌지 않는다. 반면 로봇은 현재 observation에서 action을 선택하고, 그 action이 물리 세계를 바꾸며 다음 observation을 만든다.
한 시점의 action 오차는 다음 state를 학습 분포 밖으로 밀어내고 이후 action의 오차를 키울 수 있다.
Sequential decision-making formulation
Robot learning 문제는 보통 Markov Decision Process, MDP로 정리한다.
- 는 state space이다.
- 는 action space이다.
- 는 transition dynamics이다.
- 는 reward function이다.
- 는 미래 reward의 discount factor이다.
Policy는 state에서 action distribution을 정한다.
환경은 policy의 action에 따라 다음 state와 reward를 만든다.
Agent의 목표는 discounted return의 기댓값을 최대화하는 것이다.
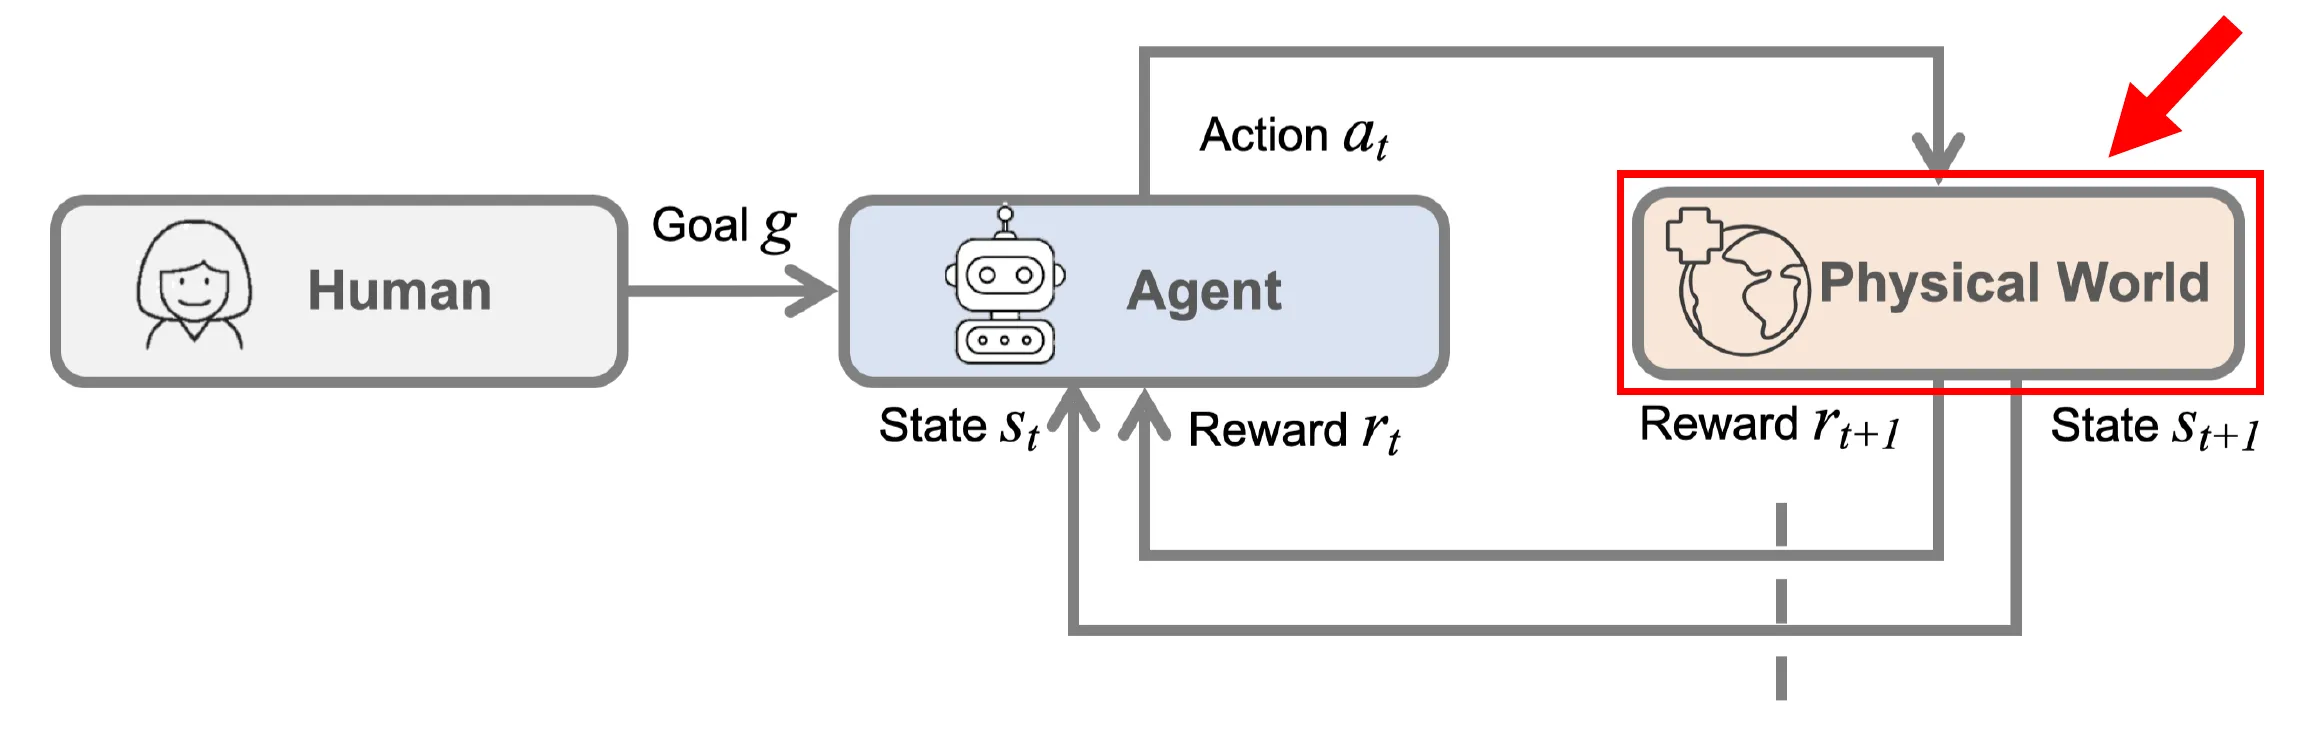
%% title: Sequential Decision-Making의 Agent-Environment Loop
%% caption: Policy가 observation으로 action을 선택하면 환경이 다음 state·observation과 reward를 만든다. 이 반복 구조 때문에 현재 action이 미래 데이터 분포를 바꾼다.
flowchart LR
    env["Environment<br/>State sₜ"] --> observe["Observation oₜ<br/>camera · proprioception · force"]
    goal["Goal / Instruction g"] --> policy["Policy π(aₜ | o≤ₜ, g)"]
    observe --> policy
    policy --> action["Action aₜ"]
    action --> transition["Dynamics<br/>p(sₜ₊₁ | sₜ, aₜ)"]
    transition --> envnext["Next State sₜ₊₁"]
    envnext --> reward["Reward rₜ"]
    reward -. "learning signal" .-> policy
    envnext --> observe
State와 observation
State 는 미래를 예측하는 데 필요한 환경의 완전한 정보를 뜻한다. 실제 로봇은 occlusion, sensor noise, 숨겨진 물리적 특성 때문에 true state를 직접 알지 못하고 observation 만 얻는 경우가 많다.
이 경우 문제는 Partially Observable Markov Decision Process, POMDP에 가깝다. Policy는 한 frame만 보거나 observation history, recurrent state, estimated belief를 사용할 수 있다.
는 language instruction이나 target configuration 같은 goal이다.
Goal, state, action, reward의 예
같은 formulation은 서로 다른 domain에 적용할 수 있다.
| 작업 | State 또는 observation | Action | Reward |
|---|---|---|---|
| Cart-pole | cart 위치, pole 각도와 속도 | cart에 주는 수평 방향의 힘 | pole이 똑바로 서 있으면 timestep마다 1 |
| Locomotion | 로봇 joint position과 속도 | 각 joint의 토크 | forward progress와 upright posture |
| Atari | 게임 화면의 pixel | up, down, left, right | 점수 변화 |
| Go | 바둑판 위 바둑돌의 배치 | 다음 바둑돌의 위치 | episode 끝의 승리 또는 패배 |
| cloth folding | multi-view RGB 또는 RGB-D | end-effector motion과 gripper open·close | 원하는 fold가 완성되면 높은 reward |
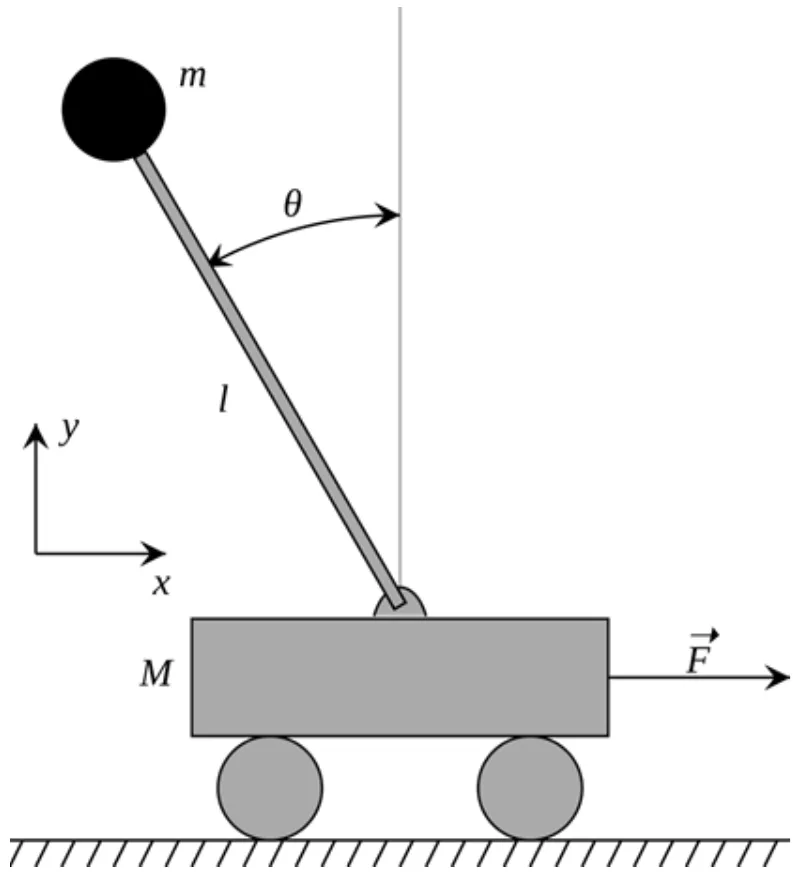
Cart-pole의 state는 이고, action은 cart에 가하는 수평 힘 이다.
Cloth folding에서는 천이 가려질 수 있고 겉으로 보이는 형상이 같아도 fold topology가 달라 state estimation이 어렵다. Grasp 실패도 천의 형상을 예상 밖으로 바꿀 수 있다.
Reward design은 task specification이다
Reward function은 작업의 목표와 제약을 수치로 표현한다. 자율주행에서는 빠른 이동, 승차감, collision avoidance가 서로 충돌할 수 있다. Cloth folding에서도 조밀함, 매끄러움, 접는 방식에 따라 다른 reward가 필요하다.
여러 목적함수를 가중합으로 만들 수 있다.
Agent는 지정한 reward를 최대화하므로 가중치에 따라 설계자가 의도하지 않은 행동을 택할 수 있다. Sparse terminal reward는 명세가 간단하지만 credit assignment가 어렵고, dense shaping reward는 학습을 돕지만 의도하지 않은 편법을 만들 수 있다.
Robot perception은 embodied, active, situated하다
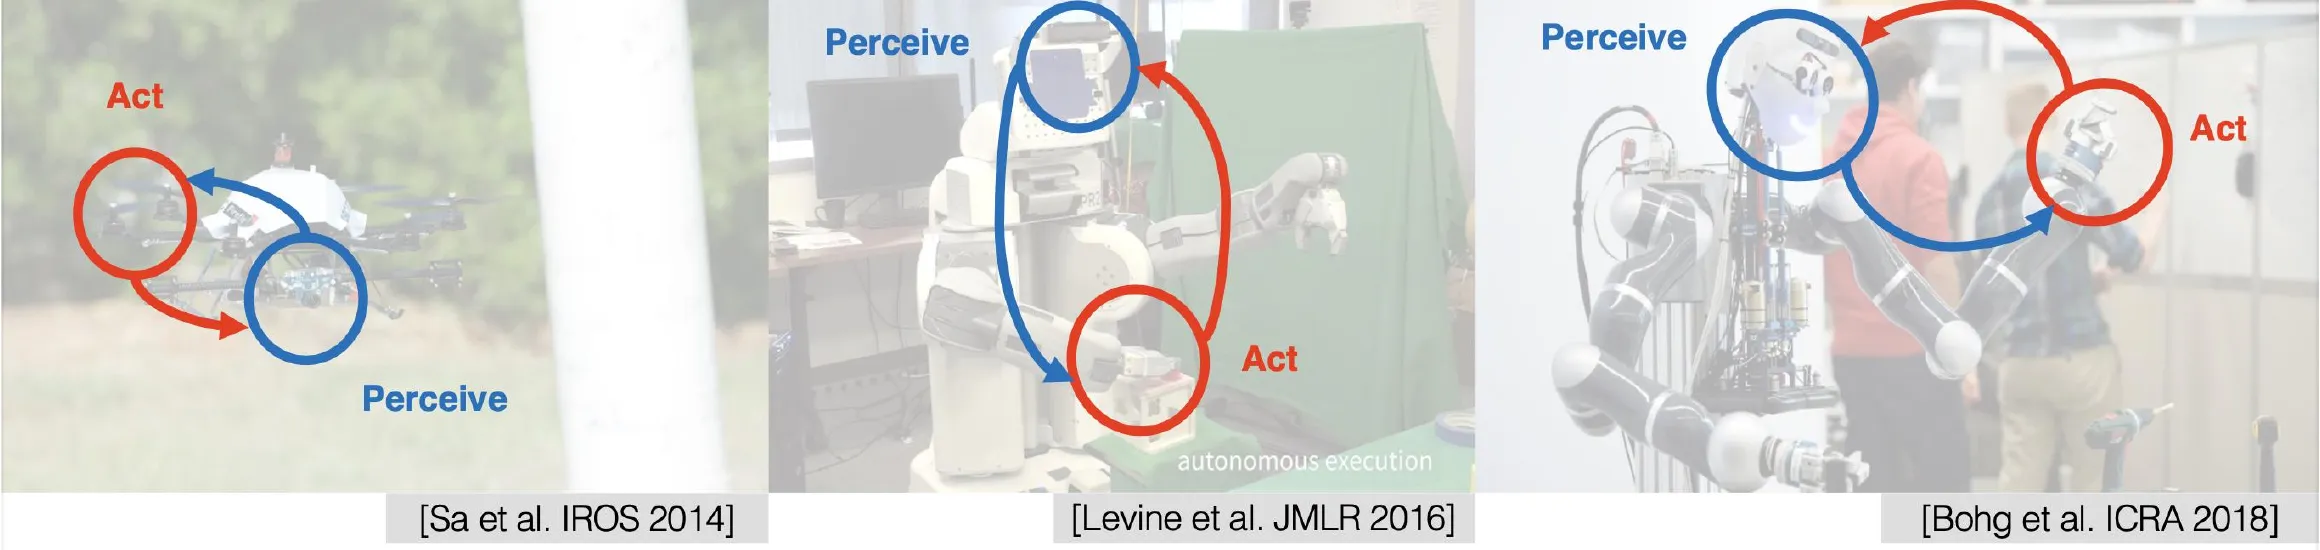
일반 이미지 인식은 이미 수집된 이미지를 수동적으로 처리한다. 로봇은 신체를 가지고 환경 안에서 움직이며 perception과 action을 닫힌 loop로 연결한다.
- Embodied: 센서와 actuator가 특정 신체와 kinematics에 묶여 있다.
- Active: 더 잘 보기 위해 카메라나 물체를 움직일 수 있다.
- Situated: 지금 이 위치와 작업에 필요한 정보를 판단해야 한다.
겹쳐 보이는 물체가 하나인지 여러 개가 포개진 것인지 이미지 한 장으로 알기 어렵다면 로봇이 건드려 보고 분리되는지 관찰할 수 있다. 이처럼 action으로 추가 정보를 얻는 방식을 active perception이라 한다.
셔츠 단추를 잠그려면 단추 주변의 local geometry와 contact state를 추정해야 한다.
Multimodal robot perception
물리적 상호작용은 RGB 이미지 하나로 보이지 않는 특성을 포함한다.
- RGB는 물체가 무엇인지, scene context, 질감을 알려 준다.
- Depth와 LiDAR는 geometry와 거리를 알려 준다.
- Tactile sensor는 contact, slip, grasp stability를 알려 준다.
- Force-torque sensor는 상호작용에서 발생하는 힘을 알려 준다.
- 소리는 충돌, 모터, 재질 간 상호작용에서 발생한 사건을 알려 줄 수 있다.
- Proprioception은 joint position, 속도, gripper state를 제공한다.
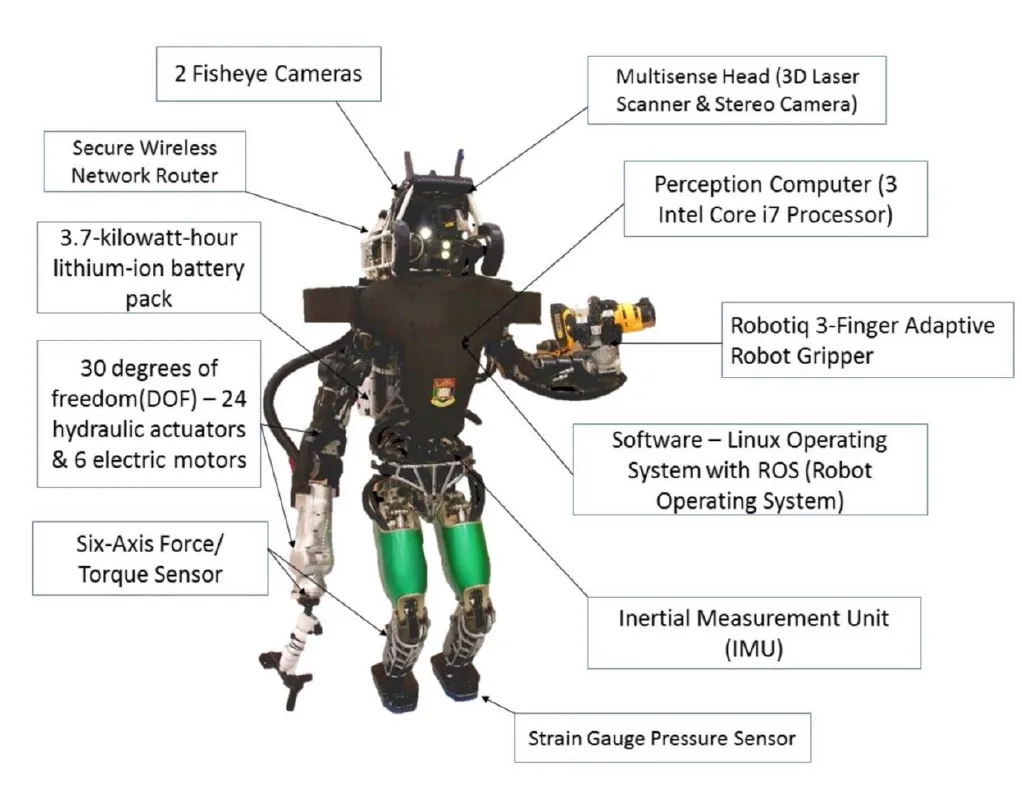
카메라에서 가려진 contact는 tactile sensor가 보완하고, tactile sensor가 주지 못하는 장면의 맥락은 vision이 제공한다. Sensor fusion에서는 timestamp와 coordinate frame을 맞추고 센서별 uncertainty를 반영한다.
Reinforcement learning의 기본 아이디어
Reinforcement learning은 환경과의 상호작용으로 trajectory를 모으고 return이 높은 action의 확률을 높인다.
Supervised learning과 비교하면 다음 어려움이 있다.
- Transition과 reward가 확률적일 수 있다.
- Reward가 늦게 나타나 credit assignment가 어렵다.
- 물리 환경은 보통 미분할 수 없다.
- Policy가 바뀌면 방문하는 state distribution도 바뀐다.
- Exploration 중 위험한 action을 실행할 수 있다.
같은 push action도 마찰과 contact의 미세한 차이로 물체를 다른 방향으로 돌릴 수 있다. Go에서는 마지막 승리 reward를 수십 또는 수백 step 전 action에 배분해야 한다. 로봇의 action은 다음 학습 샘플 자체를 바꾸므로 데이터 분포가 일정하게 유지되지 않는다.
Value function과 Q-function
State value는 state 에서 policy를 따를 때 얻는 expected return이다.
Action value는 state 에서 action 를 먼저 실행한 뒤 policy를 따를 expected return이다.
Bellman equation은 현재 reward와 next-state value를 연결한다.
Optimal Q-function을 알고 discrete action을 사용한다면 가장 큰 value의 action을 선택할 수 있다.
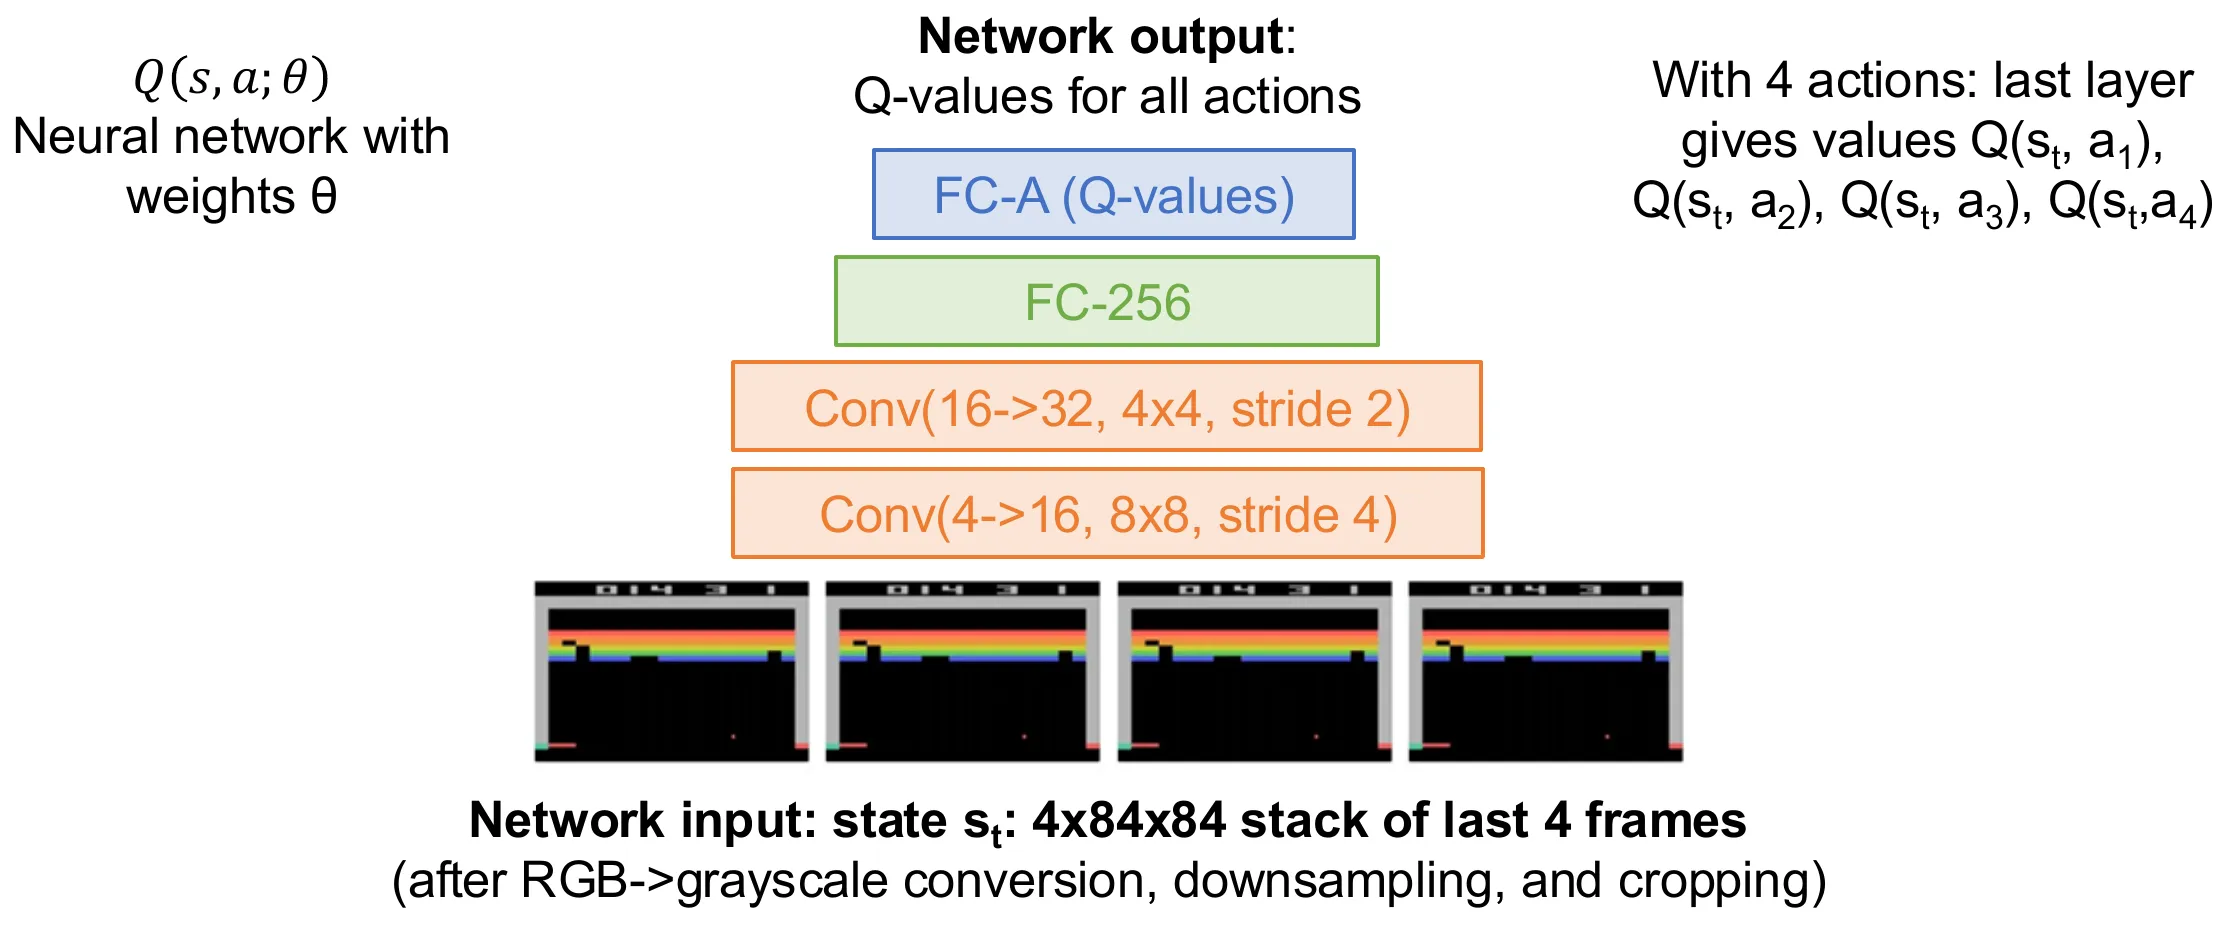
Atari의 Deep Q-Network 예에서는 최근 네 게임 frame을 CNN에 넣고 각 discrete action의 Q-value를 한 번에 출력한다. 여러 frame이 필요한 이유는 이미지 한 장만으로 공의 속도와 방향을 알 수 없기 때문이다.
그림의 입력은 이고, 마지막 fully connected layer는 action 수 만큼 Q-value를 출력한다.
Policy optimization
Value를 거치지 않고 policy parameter를 직접 갱신할 수도 있다. Policy gradient의 기본 형태는 다음과 같다.
는 선택한 action이 baseline보다 얼마나 좋은지 나타내는 advantage estimate이다. PPO는 policy update가 지나치게 커지는 것을 제한하고, SAC는 entropy를 함께 최대화해 continuous action에서 exploration을 유지하는 대표적인 알고리즘이다.
강의에서는 Breakout agent가 약 10분 뒤 공을 맞히기 시작하고, 약 2시간 뒤 안정적으로 패들을 제어하며, 약 4시간 뒤 측면 통로를 만들어 위쪽 벽돌을 빠르게 제거하는 전략을 발견하는 예를 소개했다.
Model-free reinforcement learning의 한계
Model-free RL은 transition model을 명시적으로 학습하지 않고 policy나 value를 상호작용에서 바로 학습한다. 시뮬레이션과 게임에서는 여러 시도를 병렬로 실행할 수 있다. 실제 로봇에서는 다음 제약이 있다.
- Sample inefficiency: 실제 interaction을 대량으로 모으기 어렵다.
- 안전성: 무작위 exploration이 로봇과 주변을 손상시킬 수 있다.
- Reset cost: 실패 뒤 환경을 초기화하는 데 사람이 필요하다.
- Interpretability: 실패 원인과 수정 방법을 찾기 어렵다.
- Sim-to-real gap: 시뮬레이션에서 배운 행동이 실제 dynamics에서 달라질 수 있다.
Locomotion은 시뮬레이션에서 대규모 RL을 수행한 뒤 실제 로봇으로 옮기는 성공 사례가 많다. Manipulation은 grasp 성공과 실패가 contact의 작은 오차로 불연속적으로 바뀌므로 sim-to-real이 더 어렵다.
Domain randomization과 sim-to-real
Domain randomization은 매 episode 시뮬레이션 parameter를 샘플링한다.
에는 마찰, 질량, geometry, actuator delay, sensor noise 등이 포함될 수 있다. Policy는 무작위화한 환경 전체에서 return을 높인다.
실제 환경의 dynamics가 학습 중 샘플링한 범위에 있다면 policy가 transfer될 수 있다. Low-level locomotion policy는 눈이나 수풀을 정확히 렌더링하지 않아도 robust할 수 있다.
하지만 randomization의 범위에 포함되지 않은 contact event는 해결하지 못한다. 시뮬레이션에서 상자가 10도, 실제 세계에서 12도 회전하는 차이는 feedback으로 수정할 수 있지만, 시뮬레이션에서는 grasp가 성공하고 실제 세계에서는 물체가 미끄러지는 차이는 trajectory 자체를 바꾼다.
Hierarchical control
실제 로봇 시연은 사람이 high-level direction을 주고 learned policy가 low-level torque를 생성하는 경우가 많다.
High-level command 는 전진, 회전, 목표 위치처럼 추상적이고 low-level action은 각 joint의 토크나 목표 위치이다.
이 구조에서는 조작자가 통과할 경로를 고르거나 실패 뒤 다른 명령을 줄 수 있다. 평가에는 경로 선택과 재명령 등 사람이 개입한 범위를 명시해야 한다.
Dynamics model과 world model
Model-based approach는 action이 환경을 어떻게 바꾸는지 예측하는 forward model을 학습한다.
확률적 dynamics라면 next-state 분포를 예측한다.
Transition 데이터로 supervised learning할 수 있다.
World model이 정확하면 후보 action의 결과를 virtual rollout으로 비교할 수 있다.
Planning은 forward prediction의 inverse problem이다
현재 state 와 goal 가 주어졌을 때 horizon 의 action sequence를 최적화한다.
은 최종 목표와의 오차이고 는 collision, 힘, action smoothness 같은 중간 비용이다. 미분 가능한 모델이면 action에 gradient descent를 적용할 수 있고, 그렇지 않으면 random shooting이나 sampling-based trajectory optimization을 사용할 수 있다.
Model Predictive Control
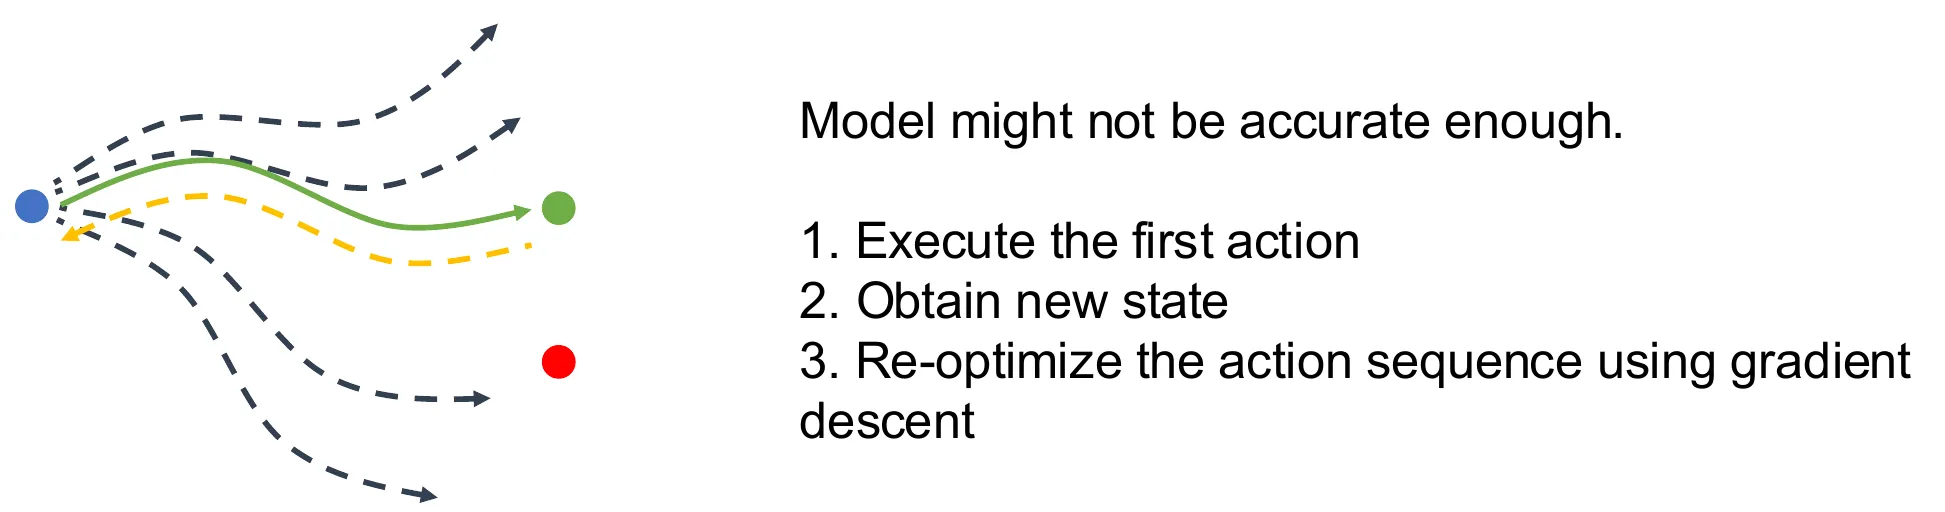
긴 action sequence를 open loop로 실행하면 모델의 예측 오차가 누적된다. Model Predictive Control, MPC는 새 observation을 받을 때마다 다시 계획한다.
- 현재 observation에서 state를 추정한다.
- Horizon 의 action sequence를 최적화한다.
- 첫 action 만 실행한다.
- 새 observation 을 받는다.
- State를 갱신하고 다시 최적화한다.
새 observation으로 state를 갱신해 모델 예측 오차와 외부 교란을 반영한다. Planning이 느리다면 offline에서 최적화한 trajectory를 모아 그 action을 예측하는 policy로 distill할 수 있다.
%% title: Model Predictive Control의 Receding-Horizon Loop
%% caption: 현재 state에서 여러 action sequence의 미래를 모델로 예측하고 가장 좋은 sequence의 첫 action만 실행한 뒤, 새 observation으로 다시 planning한다.
flowchart LR
    obs["Current Observation oₜ"] --> state["State Estimate ŝₜ"]
    state --> candidates["Candidate Action Sequences<br/>Aₜ¹ … Aₜᵏ"]
    candidates --> rollout["Dynamics / World Model<br/>Virtual Rollouts"]
    rollout --> cost["Goal + Constraint Cost"]
    cost --> best["Best Sequence Aₜ*"]
    best --> first["Execute First Action aₜ*"]
    first --> robot["Robot + Environment"]
    robot --> newobs["New Observation oₜ₊₁"]
    newobs --> state
State representation이 model learning을 결정한다
같은 물리 세계도 어떤 state를 사용하느냐에 따라 dynamics learning 난도가 달라진다.
- Pixel: 원본 정보를 보존하지만 고차원이고 appearance 변화까지 예측해야 한다.
- Keypoint: 물체의 중요한 위치만 추적해 간결하지만 keypoint detector에 의존한다.
- Particle: 변형 가능한 물체나 입자형 물질의 geometry를 세밀하게 표현하지만 point correspondence와 interaction modeling이 필요하다.
- Latent state: encoder가 task-relevant dynamics를 학습하지만 해석이 어렵고 중요한 contact를 잃을 수 있다.
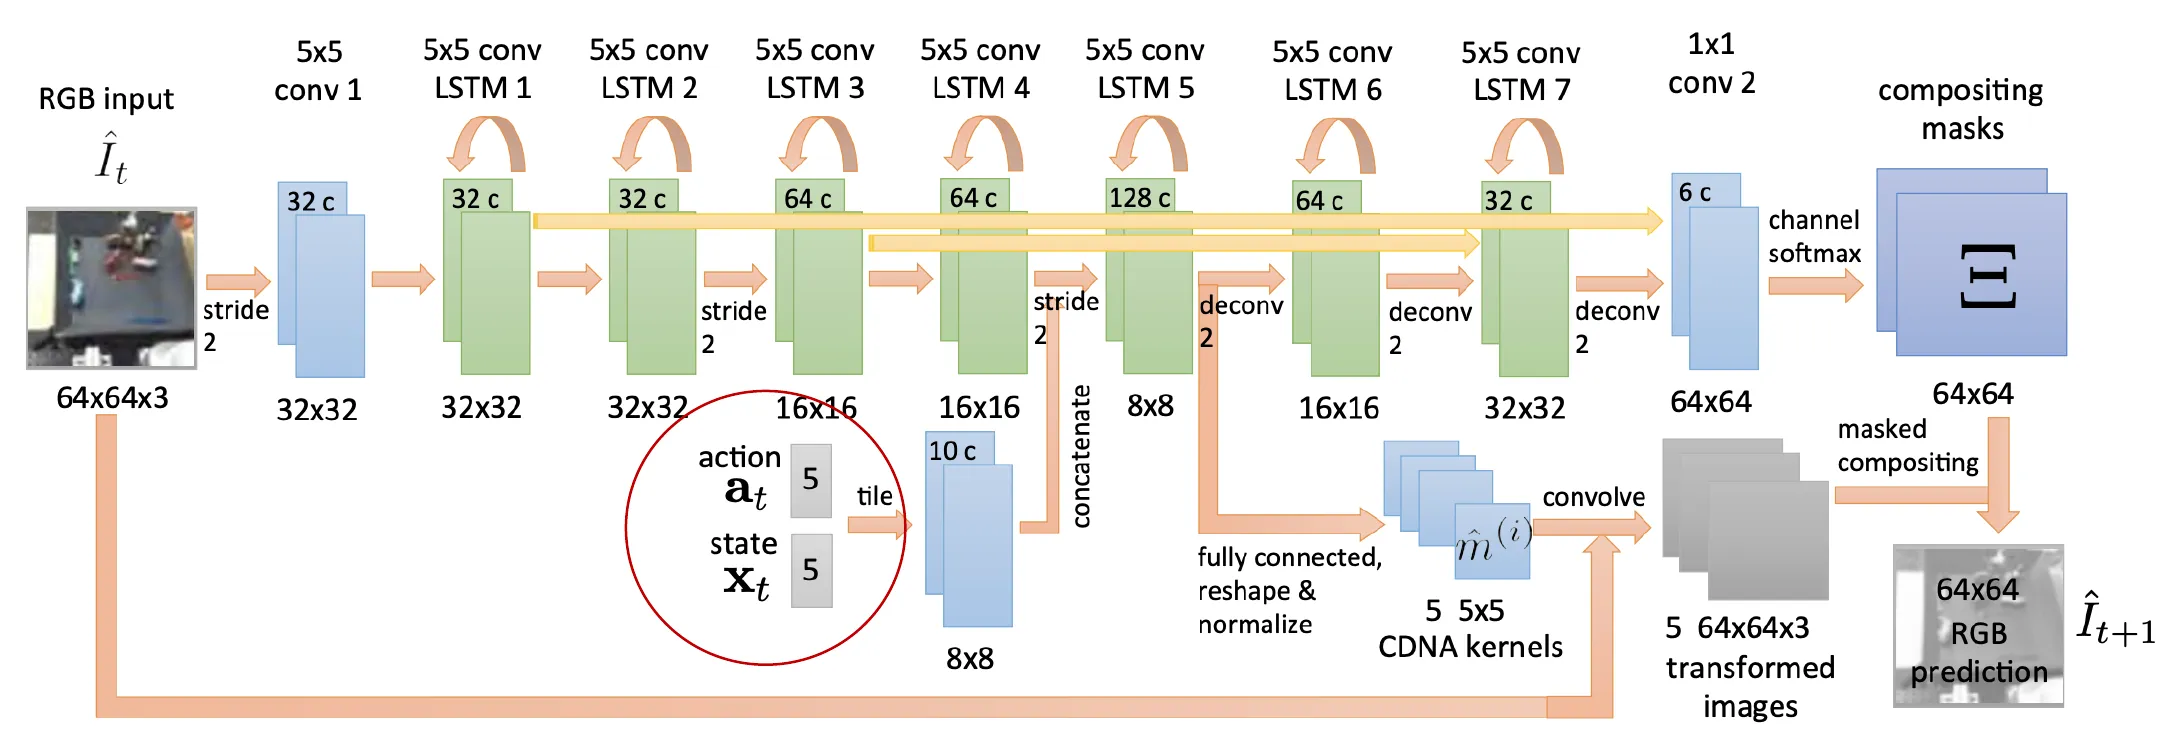
Pixel dynamics는 이미지 자체의 미래를 예측해 visual goal과 비교할 수 있다.
그림의 모델은 RGB 입력과 action·state를 받아 다음 RGB 이미지를 예측한다.
Keypoint dynamics는 상자 위 점의 3D 움직임을 예측한다.
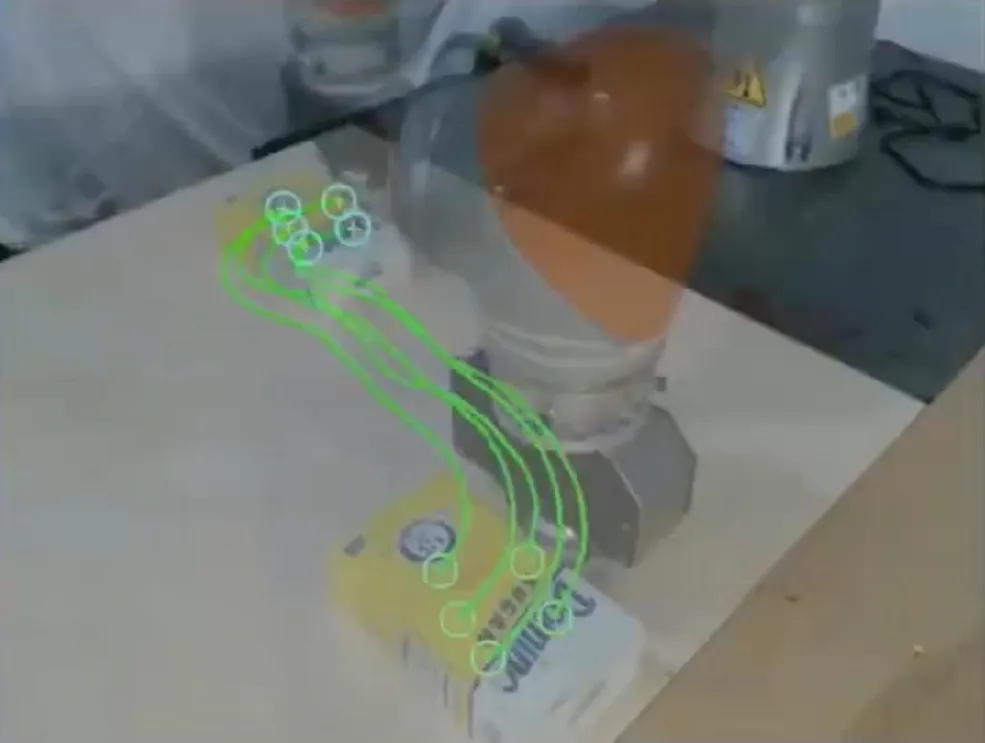
Particle dynamics는 입자형 물질이나 반죽처럼 자유도가 큰 물체를 점 집합으로 나타낸다.
Particle-based planning 예
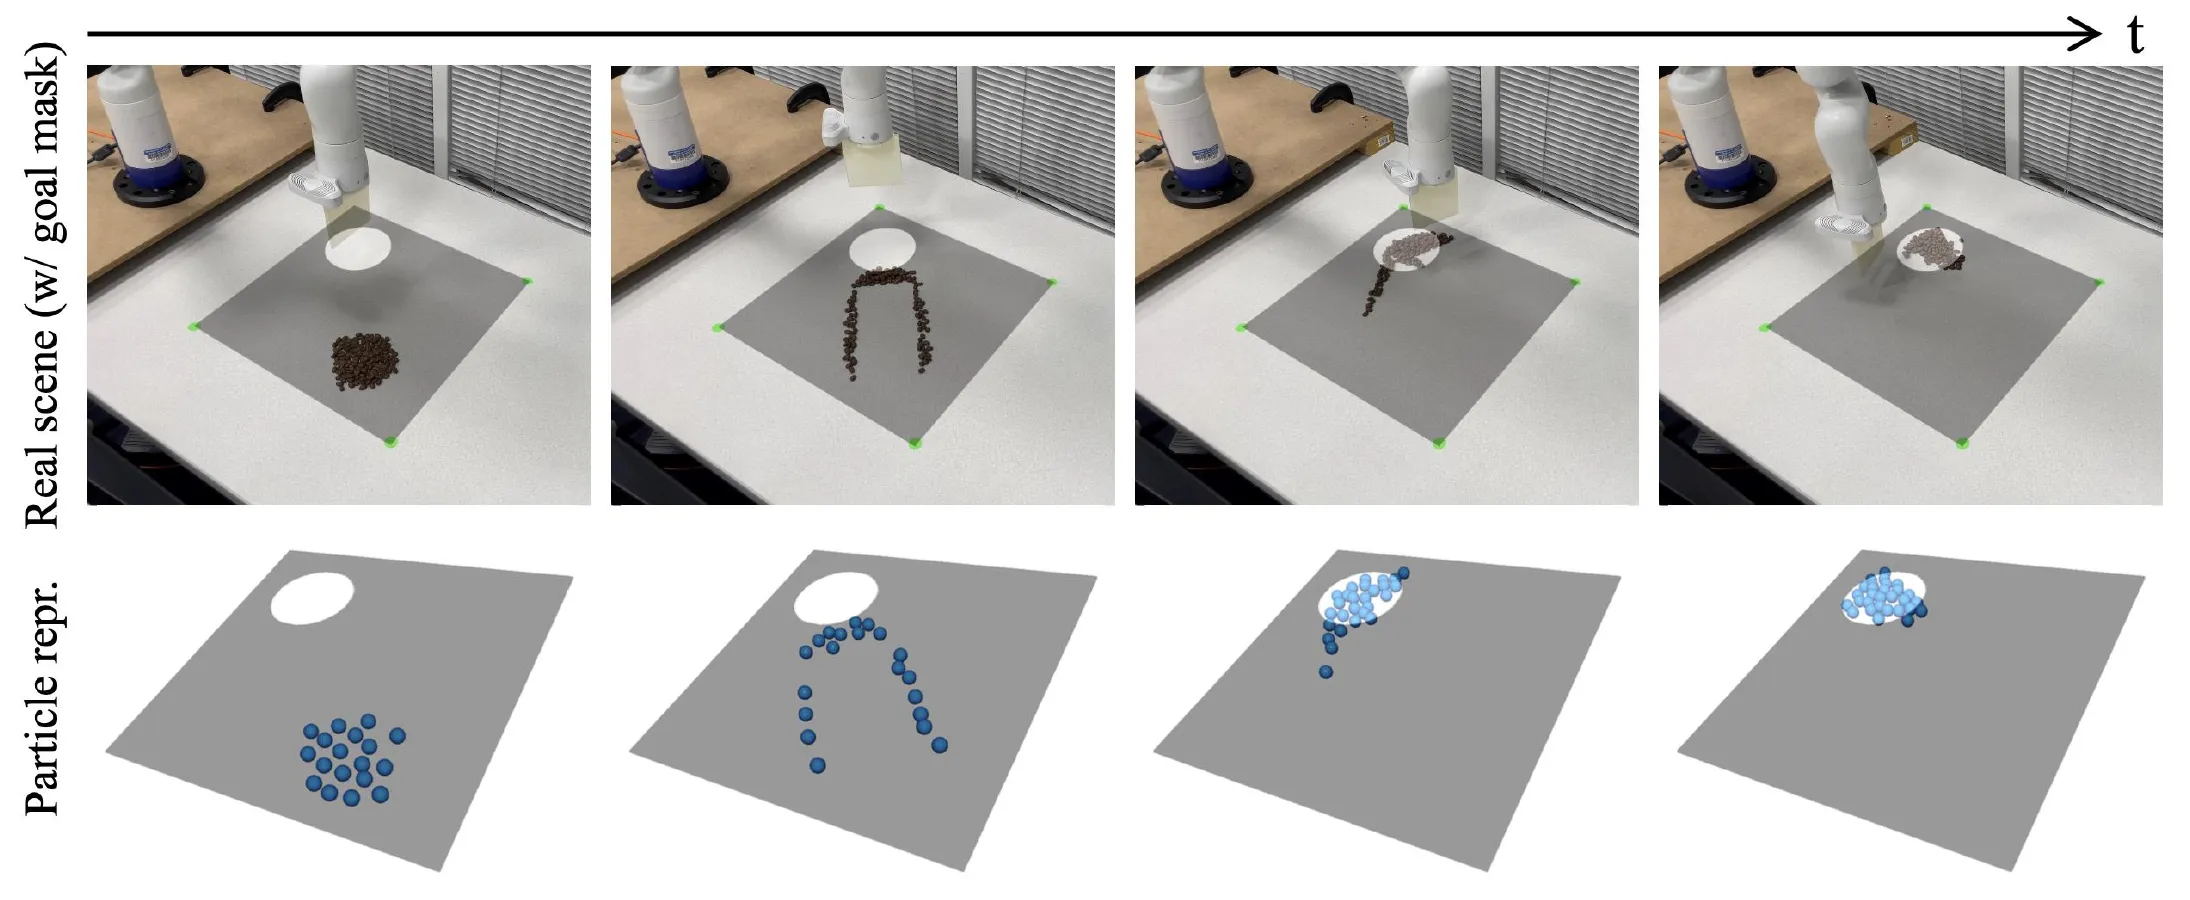
Granular rearrangement에서는 파란 particle이 현재 물체의 형상, 빨간 particle이 목표 형상을 나타낸다고 볼 수 있다. Dynamics model이 후보 action 뒤 particle의 움직임을 예측하고 점 집합 사이 거리가 작은 action을 선택한다.
에는 Chamfer distance 같은 set metric을 사용할 수 있다. 강의에서는 입자 더미를 목표 영역으로 모으거나 A부터 Z까지의 글자 모양으로 재배치하는 예가 소개되었다.
그림의 위쪽은 실제 장면과 흰색 goal mask이고, 아래쪽은 같은 장면의 particle representation이다.
Tool use와 hierarchical planning 예
만두를 만드는 시스템은 네 대의 RGB-D 카메라로 반죽의 geometry를 관찰하고 3D 프린터로 만든 15개 도구 중 하나를 선택했다.
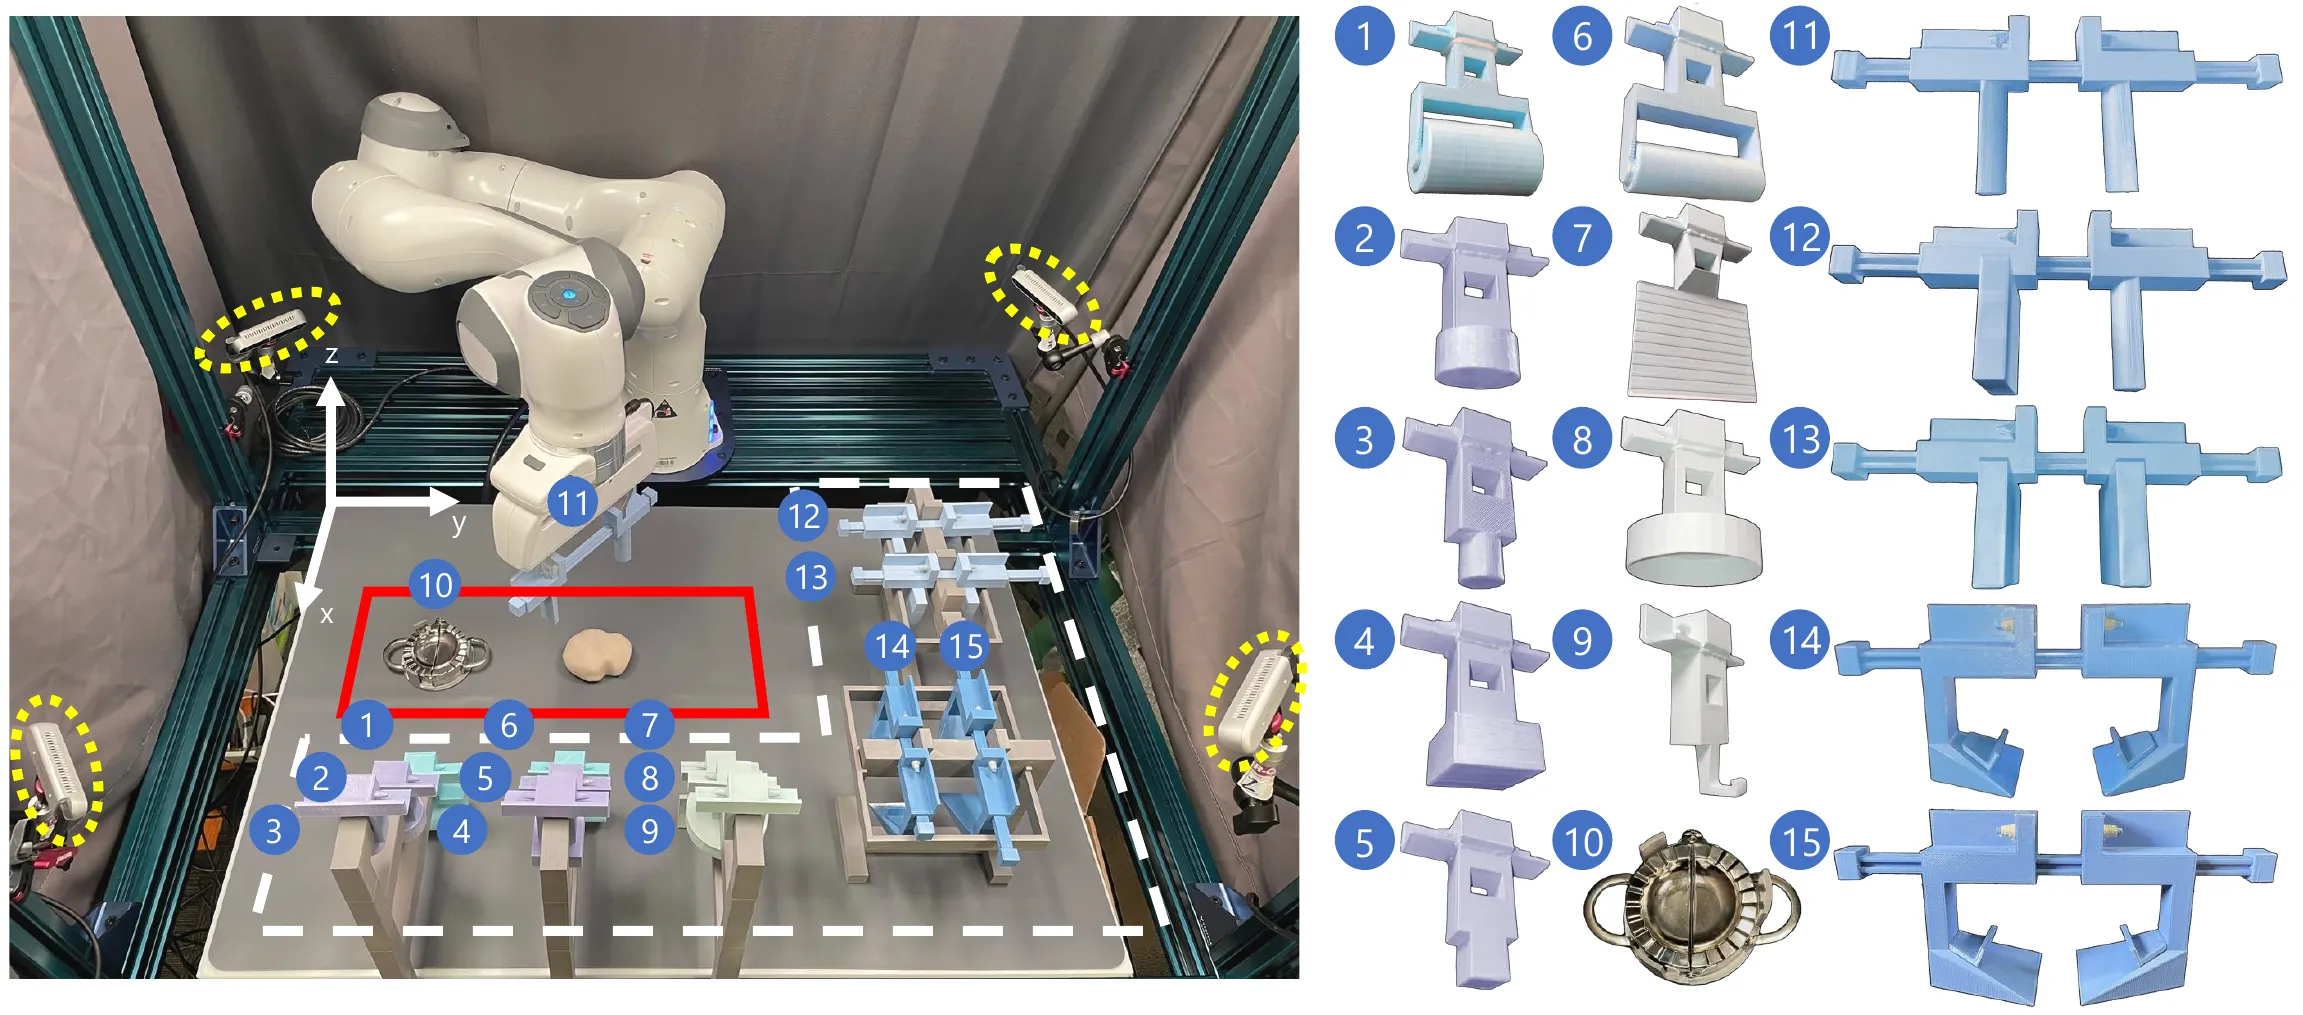
의사결정은 두 수준으로 나뉜다.
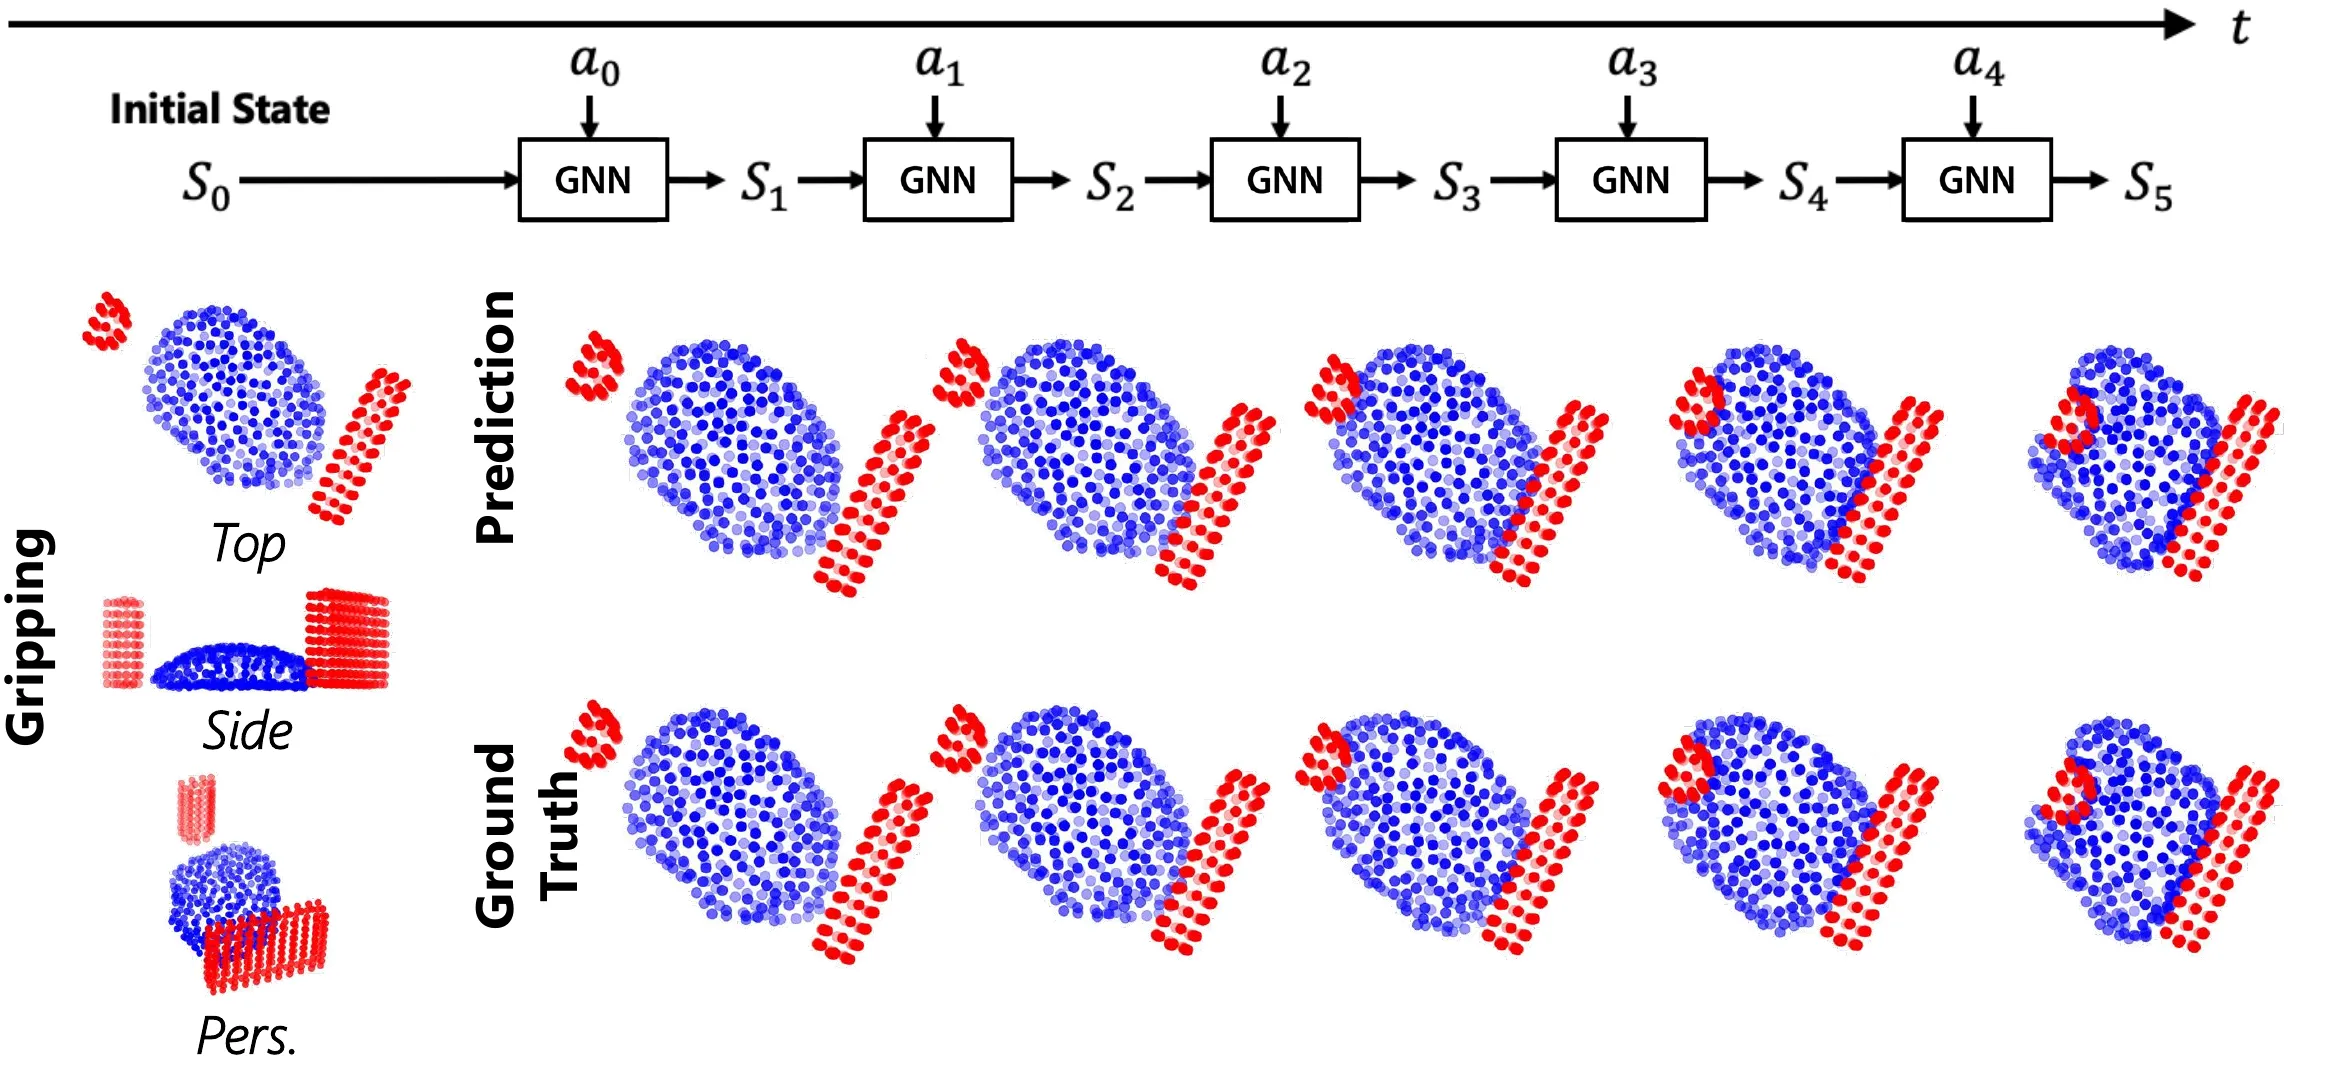
는 도구 범주이고 는 선택한 도구의 움직임이다. Learned particle dynamics는 각 도구와 action이 반죽의 형상을 어떻게 바꿀지 예측한다.
그림은 particle state와 action을 GNN에 넣어 다음 state를 반복 예측하는 구조이다. 파란색은 반죽, 빨간색은 도구이며, 위쪽 prediction과 아래쪽 ground truth를 비교한다.
이 시스템은 현재 observation으로 작업 단계와 motion plan을 갱신한다. 사람이 반죽을 망가뜨렸을 때도 이전 단계로 돌아가 작업을 이어갈 수 있었다.
이 시스템의 dynamics model은 실제 상호작용 데이터로 학습했다. Material Point Method simulator를 system identification한 baseline보다 실제 데이터로 학습한 dynamics가 더 정확했던 사례도 소개되었다. 복잡한 deformable contact에서는 실제 재질에 맞는 simulator parameter를 추정하기 어렵다.
Model-based planning과 model-based RL
Dynamics model을 supervised learning한 뒤 그 모델 위에서 action optimization을 수행하는 접근은 model-based planning에 해당한다. Model-based reinforcement learning에서는 모델과 value 또는 policy를 함께 학습하고 imagined rollout을 RL update에 사용하기도 한다.
구현을 비교할 때는 다음 항목을 확인한다.
- 어떤 데이터로 dynamics를 학습하는가?
- 모델의 uncertainty를 planning에 반영하는가?
- Planning을 online으로 수행하는가, policy로 distill하는가?
- 모델 오차가 큰 state를 피하거나 새 데이터를 수집하는가?
Imitation learning
Imitation learning은 expert demonstration에서 observation-to-action policy를 supervised learning한다.
Reward를 설계하거나 exploration으로 행동을 탐색하는 대신, expert가 실행한 action을 학습 목표로 사용한다.
Behavior cloning
Continuous action의 deterministic behavior cloning은 expert action과의 regression loss를 사용할 수 있다.
확률적 policy라면 negative log-likelihood를 최소화한다.
Deployment에서는 policy가 선택한 action이 다음 observation을 결정한다.
Covariate shift와 cascading error
Demonstration은 expert가 방문한 state distribution 에서 수집된다. Learned policy는 작은 실수 뒤 다른 분포 를 방문한다.
학습 데이터에 없는 off-trajectory state에서는 action 오차가 커지고, 그 action이 더 낯선 state를 만들어 오차가 시간에 따라 증폭된다. One-step validation loss가 작아도 long-horizon success가 낮을 수 있는 이유이다.
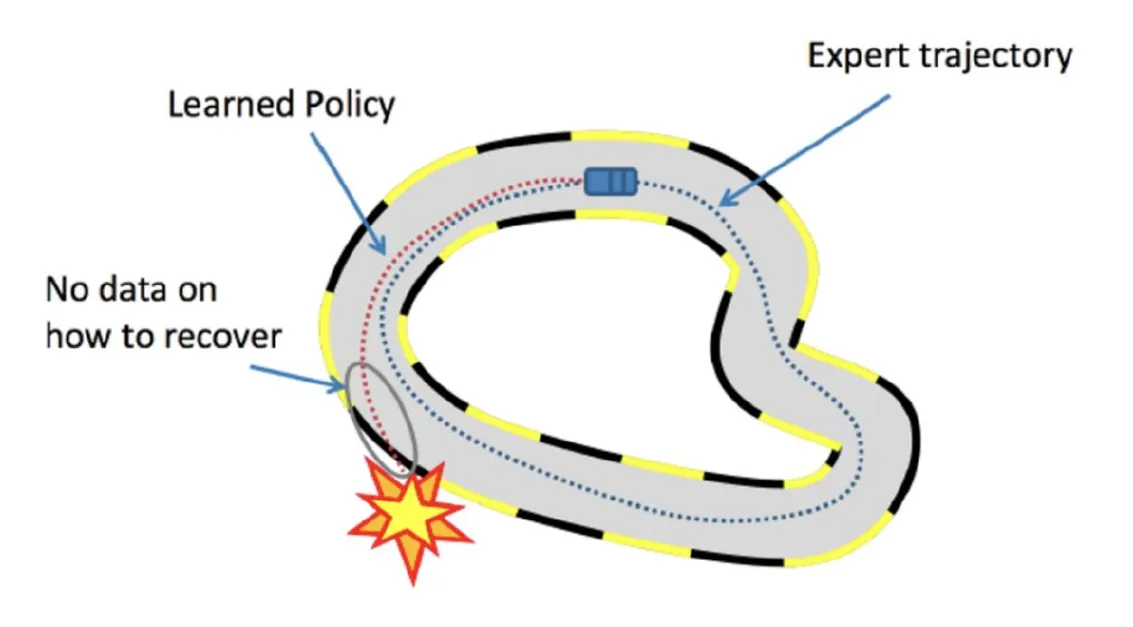
이를 줄이려면 policy를 rollout한 상태에서 expert correction을 추가한다.
- 초기 expert demonstration으로 policy를 학습한다.
- Learned policy를 실제 환경 또는 시뮬레이션 환경에서 실행한다.
- 실패와 recovery state에서 expert action을 라벨링한다.
- 새 데이터를 기존 데이터셋에 합쳐 다시 학습한다.
DAgger는 learner가 실제로 방문하는 state에서 expert label을 모아 학습 데이터에 추가한다.
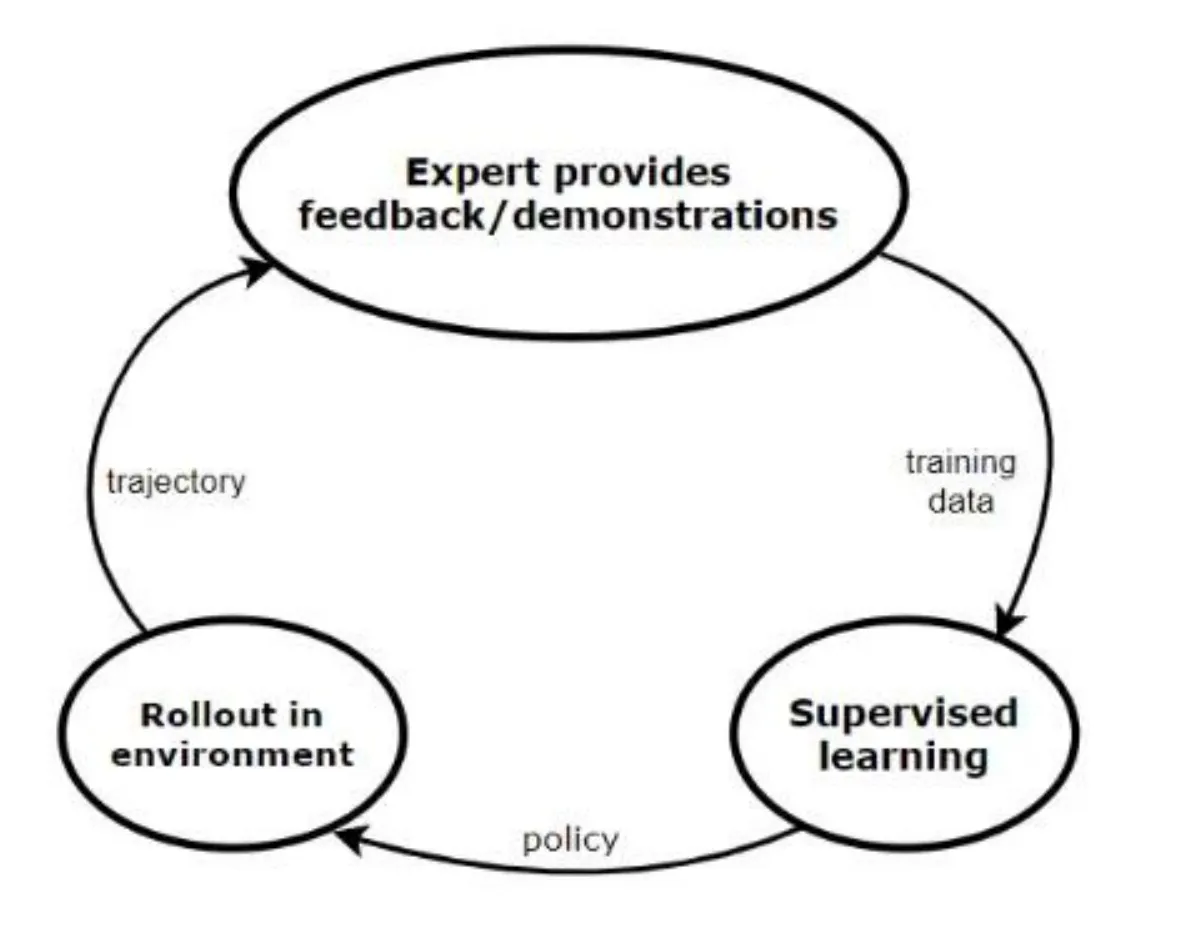
%% title: Behavior Cloning의 Covariate Shift와 Data Aggregation
%% caption: Expert trajectory에서만 학습한 policy는 작은 실수 뒤 off-trajectory state를 만나고, 낯선 state에서 추가 실수를 만들 수 있다. Policy가 실제로 방문한 state의 expert correction을 다시 학습 데이터에 합친다.
flowchart LR
    expert["Expert Demonstrations<br/>dπ_E"] --> train["Supervised Policy Training"]
    train --> policy["Learned Policy πθ"]
    policy --> rollout["Deployment Rollout"]
    rollout --> error["Small Action Error"]
    error --> drift["Off-Distribution State<br/>dπ_θ ≠ dπ_E"]
    drift --> cascade["Cascading Error"]
    drift --> correction["Expert Recovery Label"]
    correction --> aggregate["Aggregate Dataset"]
    expert --> aggregate
    aggregate --> train
Inverse reinforcement learning
Imitation learning의 demonstration에는 작업 목적함수가 명시적으로 적혀 있지 않다. Inverse reinforcement learning, IRL은 expert trajectory를 잘 설명하는 reward를 추정한다.
추정한 reward로 새로운 dynamics나 초기 state에서 reinforcement learning을 수행할 수 있다.
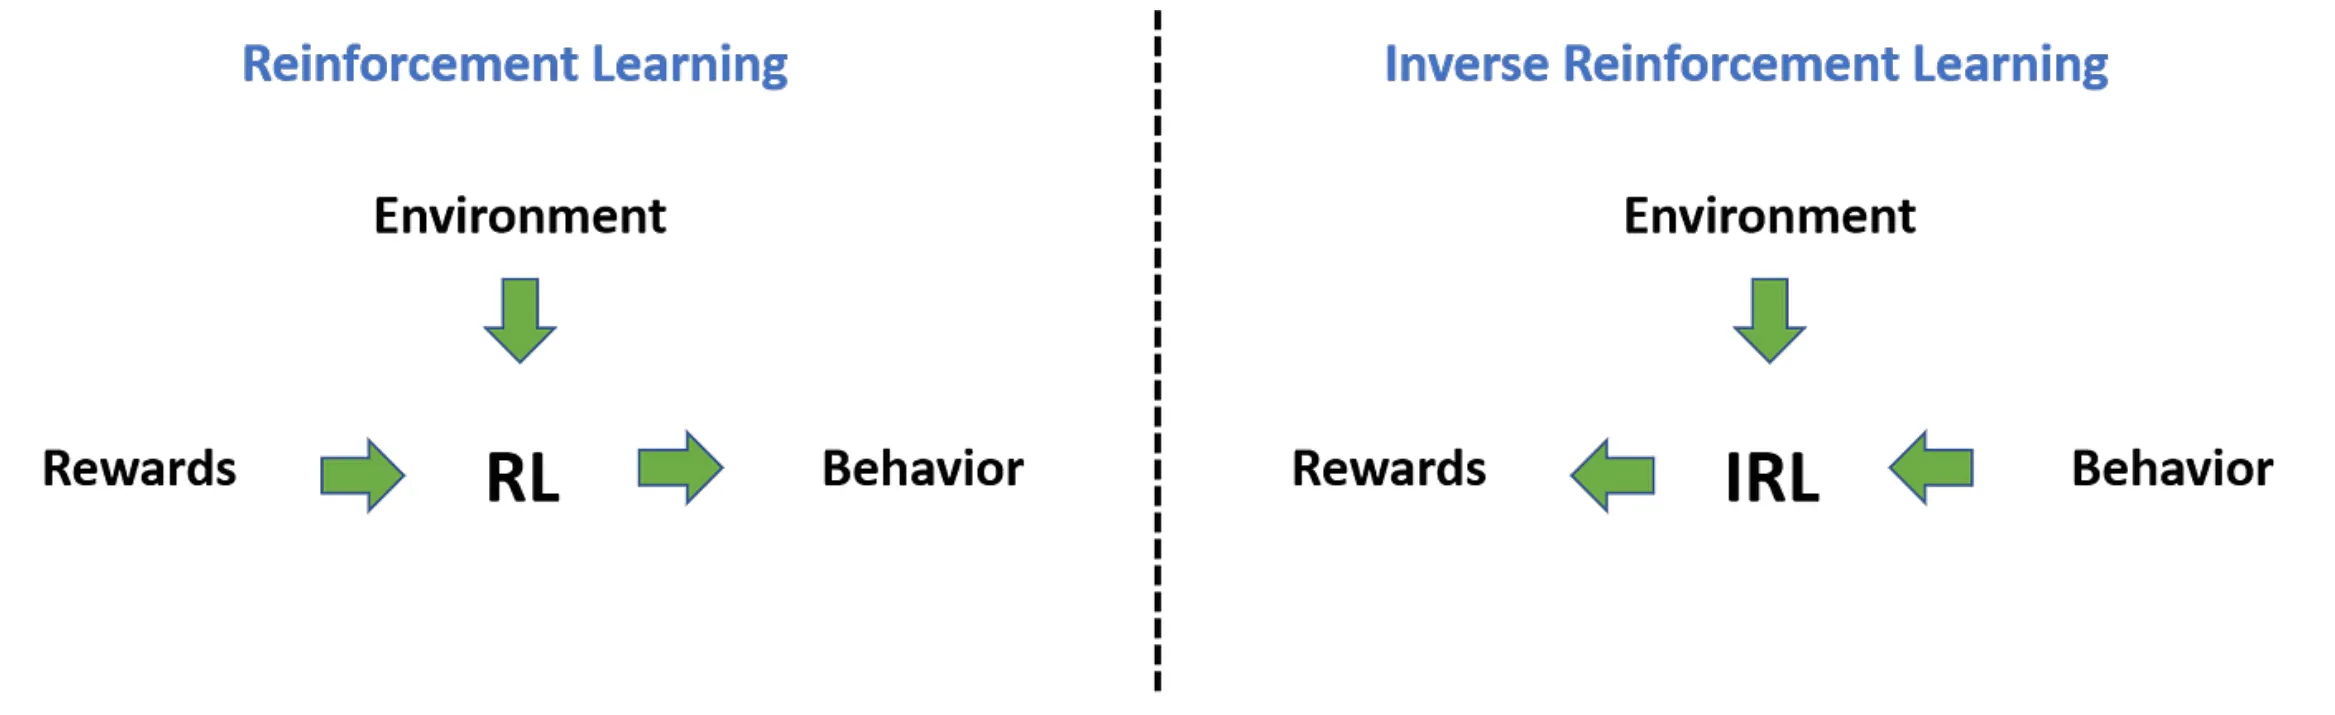
Reward는 여러 형태로 같은 전문가의 행동을 설명할 수 있어 identifiability가 어렵고, 이후 RL 단계의 sample cost가 다시 생긴다는 한계가 있다.
Explicit policy와 implicit policy
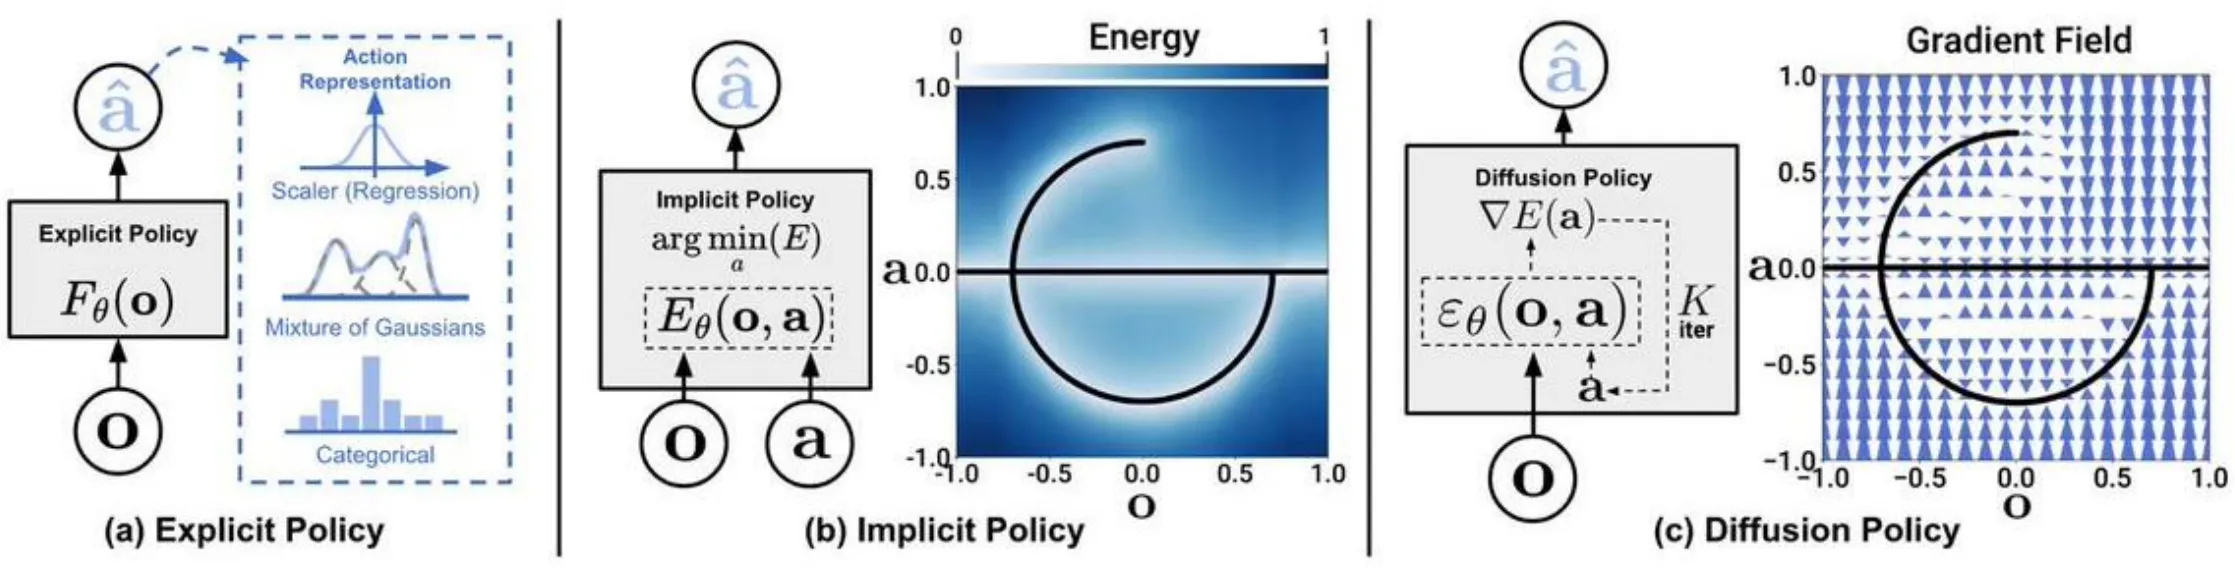
Explicit policy는 observation을 action으로 직접 mapping한다.
같은 observation에서 여러 action이 모두 유효하면 MSE regression은 서로 다른 mode의 평균을 예측할 수 있다. 평균 action이 어느 유효한 행동에도 속하지 않을 수 있다.
Implicit policy는 observation과 후보 action의 compatibility를 energy로 나타낸다.
Action distribution의 여러 mode를 유지할 수 있지만 추론 때 optimization이나 샘플링이 필요하다.
Diffusion Policy
Diffusion Policy는 generative diffusion model을 policy function class로 사용한다. 향후 여러 step의 action을 묶은 action chunk를 생성하는 경우가 많다.
학습에서는 expert action chunk에 잡음을 더하고 observation을 조건으로 한 denoiser가 잡음 또는 clean action을 예측한다.
추론에서는 무작위 action sequence에서 시작해 iterative denoising으로 action chunk를 생성한다. Multimodal demonstration의 서로 다른 유효한 행동을 여러 mode로 표현하고, 여러 step의 action을 함께 생성해 시간적 일관성을 학습할 수 있다.
초기 배치나 물체가 demonstration distribution을 벗어나면 실패할 수 있다. 이런 조건에서의 데이터와 recovery demonstration을 추가해 policy를 다시 학습한다.
%% title: Diffusion Policy의 Action-Chunk 생성
%% caption: Observation과 goal을 condition으로 사용해 무작위 action sequence를 반복적으로 denoise하고, 생성된 일관된 action chunk의 일부를 실행한 뒤 새 observation에서 다시 생성한다.
flowchart LR
    obs["Observation History o≤ₜ"] --> denoiser["Conditional Action Denoiser"]
    goal["Goal / Language g"] --> denoiser
    noise["Random Action Chunk<br/>Aₜ⁽ᴷ⁾"] --> denoiser
    denoiser --> k1["Denoise Step K-1"]
    k1 --> k2["…"]
    k2 --> clean["Action Chunk<br/>(aₜ … aₜ₊ₕ₋₁)"]
    clean --> execute["Execute Prefix"]
    execute --> robot["Robot / Environment"]
    robot --> nextobs["New Observation"]
    nextobs -. "replan" .-> denoiser
Robot learning 방법 비교
| 방법 | 주된 데이터 | 학습 대상 | 장점 | 핵심 한계 |
|---|---|---|---|---|
| Model-free RL | 환경과의 상호작용과 reward | policy 또는 value | demonstration에 없는 전략 탐색 | sample cost, 안전성, reward design |
| Model-based planning | transition tuple | dynamics와 online plan | virtual rollout과 feedback을 통한 교정 | model bias, online planning 비용 |
| Behavior cloning | expert observation-action pair | policy | expert action을 supervised loss로 직접 학습 | covariate shift, demonstration 품질 |
| Diffusion Policy | expert action sequence | multimodal action generator | multimodal action chunk 생성 | 반복 추론과 데이터 범위 |
| VLA foundation model | multi-task robot data와 vision-language data | goal-conditioned general policy | semantic generalization과 작업 간 transfer | embodiment gap, post-training, 평가 |
Robotic foundation model과 VLA
Robotic foundation model은 observation과 작업 명세를 받아 물리적인 action을 생성하는 범용 policy이다. Vision-Language-Action, VLA 모델이라고도 부른다.
은 language instruction이고 는 robot embodiment와 센서 맥락이다. 다양한 물체, 장면, instruction, 작업, 로봇에서 상황에 맞는 action을 생성하는 것이 목표이다.
출력 action에는 다음 조건이 요구된다.
- Language instruction과 의미상 일치한다.
- Kinematic limit과 충돌 제약을 지킨다.
- Motion이 매끄럽고 물리 세계에서 실행 가능하다.
- 예상하지 못한 observation에 feedback으로 반응한다.
RT-1, RT-2, RT-X, OpenVLA, , , Gemini Robotics 등이 이 방향의 예이다.
Vision-language prior를 action으로 확장하기
VLA는 large-scale vision-language pretraining에서 얻은 semantic knowledge를 robot action prediction에 연결한다.
Pretrained vision-language model은 물체와 instruction을 이해하는 semantic prior를 제공한다. Robot demonstration은 어떤 visual state에서 어떤 모터 명령을 실행해야 하는지 grounding한다.
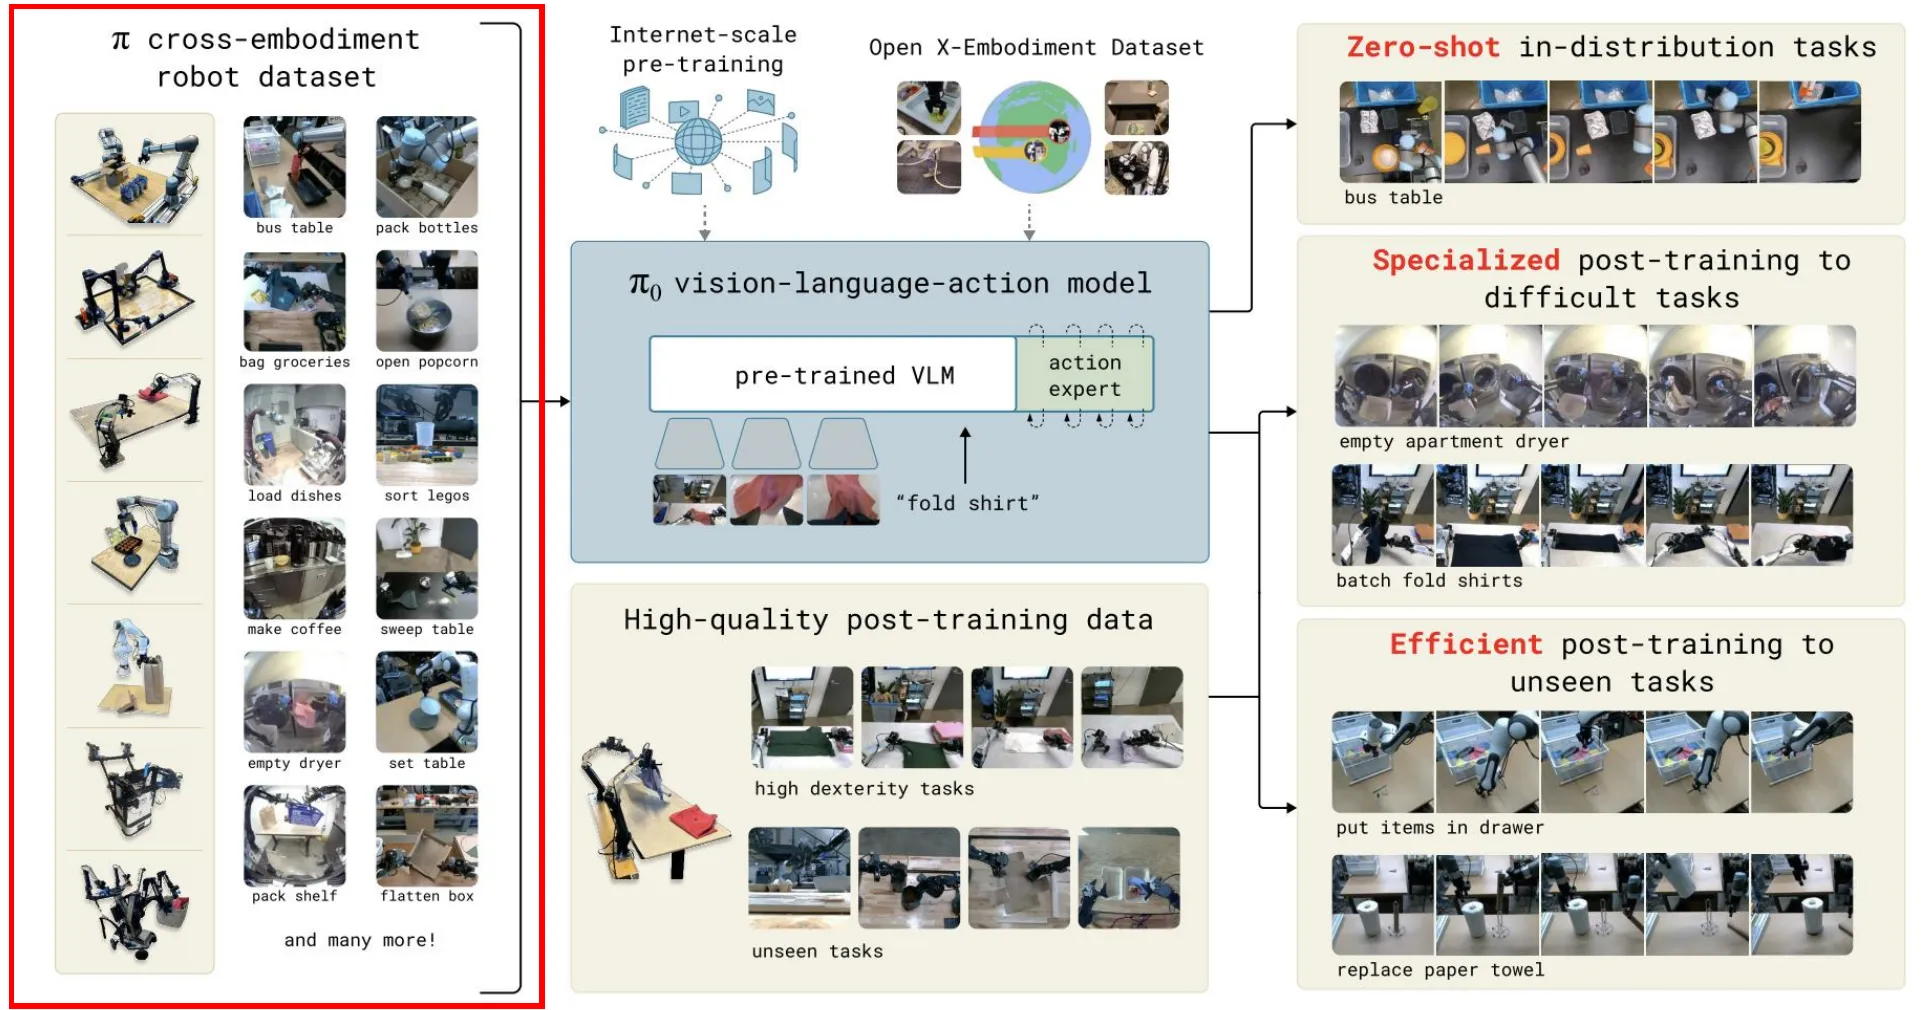
Action 목적함수만 강하게 학습하면 pretraining으로 얻은 의미 이해 능력을 잊을 수 있다. Co-training 또는 co-fine-tuning은 robot action prediction과 vision-language 목적함수를 함께 사용해 semantic knowledge를 유지하도록 학습한다.
%% title: Vision-Language-Action Model의 입력부터 행동까지
%% caption: Vision-language pretraining의 semantic prior에 multi-robot demonstration으로 action grounding을 더하고, 추론 시에는 visual observation·instruction·robot state를 함께 받아 실행 가능한 action을 출력한다.
flowchart LR
    image["Camera / Visual Tokens"] --> backbone["Vision-Language Backbone"]
    language["Language Instruction"] --> backbone
    robotstate["Robot State + Embodiment Token"] --> actionhead["Action Decoder / Head"]
    backbone --> actionhead
    actionhead --> action["Action Token / Chunk<br/>pose · gripper · joints"]
    action --> robot["Robot Execution"]
    robot --> feedback["New Multimodal Observation"]
    feedback --> image
    vlpre["Vision-Language Pretraining"] -.-> backbone
    demos["Cross-Robot Demonstrations"] -.-> actionhead
    taskdata["Task-Specific Post-Training"] -.-> actionhead
Base model과 post-training
폭넓은 pretraining을 마친 base policy는 데이터에 자주 등장한 단순한 작업을 바로 수행할 수 있다. 하지만 학습 분포 안의 어려운 작업이나 처음 보는 작업에서 높은 신뢰성이 필요하면 task-specific 데이터로 post-training한다.
- Base 평가: pretraining에서 본 것과 비슷한 작업을 그대로 실행한다.
- In-distribution post-training: 같은 작업 유형의 더 어려운 변화를 fine-tuning한다.
- New-task adaptation: 새로운 작업 demonstration을 추가해 post-training한다.
정밀한 contact-rich action을 수행하도록 작업과 embodiment에 맞는 데이터로 post-training하는 경우가 많다.
Cross-embodiment data
로봇 데이터셋을 크게 만들려면 서로 다른 arm, gripper, 카메라, control frequency에서 수집한 demonstration을 합쳐야 한다. 하지만 action space와 kinematics가 서로 다르다.
같은 end-effector motion도 로봇마다 다른 joint command가 필요하다. Cross-embodiment learning에는 다음 중 하나가 필요하다.
- End-effector pose처럼 공통 action space로 변환한다.
- Embodiment token이나 robot state를 condition으로 제공한다.
- Robot-specific action head를 사용한다.
- Shared representation과 embodiment-specific controller를 계층적으로 분리한다.
데이터를 합칠 때는 좌표 표기와 control semantics를 맞춰야 한다.
Teleoperation data의 bias
사람의 원격 조종은 실제 로봇의 demonstration을 수집하는 대표적인 방법이다. 하지만 사람이 자신의 손으로 하는 동작보다 로봇을 원격 조종하는 동작이 느리고 불연속적일 수 있다.
카메라 occlusion, communication delay, 익숙하지 않은 interface 때문에 조작자가 자주 멈추고 확인한다. Behavior cloning policy는 이 속도와 망설임도 함께 복제할 수 있다.
Long-horizon task를 위한 hierarchical policy
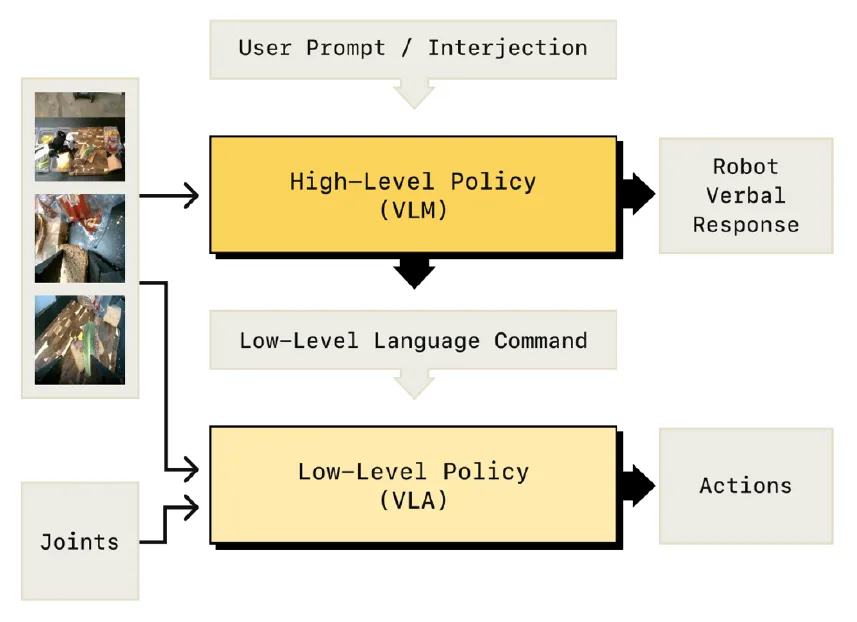
Hierarchical policy는 high-level task와 low-level skill을 나눈다.
는 subgoal, skill, 물체 사이 관계, scene graph node처럼 더 느린 시간 단위로 변하는 변수이다. High-level planner가 pick up shirt, fold sleeve, place in drawer를 정하고 low-level policy가 contact-rich motion을 수행할 수 있다.
Hi-Robot 예에서는 high-level VLM이 language command를 정하고, low-level VLA가 카메라와 joint 정보를 받아 action을 생성한다.
Generalization을 무엇으로 측정할 것인가
Robotic foundation model의 generalization은 다음 조건별로 평가한다.
- 처음 보는 물체와 appearance
- 처음 보는 장면과 배경
- 처음 보는 언어 표현
- 새로운 초기 배치
- 새로운 작업 조합
- 서로 다른 robot embodiment
- 더 긴 horizon과 외부 교란
학습 작업의 변형인지 새로운 작업의 zero-shot 평가인지 구분하고, 학습 데이터와 테스트 조건의 관계를 명시해야 한다.
One-step loss와 long-horizon success의 차이
Policy training loss는 보통 한 observation에서 expert action을 얼마나 잘 맞혔는지 측정한다. 실제 작업 지표는 전체 trajectory가 성공했는지 측정한다.
각 step을 올바르게 실행할 확률이 독립적으로 라고 단순화하면 step 전체가 성공할 확률은 다음과 같다.
여도 이면 다음과 같다.
평가에는 validation loss와 함께 rollout success, recovery rate, completion time, intervention count를 기록한다.
Real-world evaluation의 어려움
실제 로봇 평가는 비용이 크고 잡음이 많다.
- 물체의 초기 pose와 fold 상태가 시도마다 다르다.
- 조명, 마찰, 배터리, calibration이 바뀐다.
- 사람의 초기화 작업과 성공 판단이 개입한다.
- 충분한 시도를 수행하는 데 시간이 오래 걸린다.
- 다른 연구실이 같은 실험 구성을 재현하기 어렵다.
성공 횟수 와 시도 수 , confidence interval, 실패 유형, 사람의 개입, seed와 실험 구성을 함께 기록한다.
Offline 지표가 좋은 checkpoint도 실제 rollout에서는 성공률이 더 낮을 수 있어, training loss만으로 checkpoint를 선택하기 어렵다.
Simulation benchmark의 역할과 한계
시뮬레이션은 대량의 반복 가능한 평가를 제공하지만 sim-to-real 상관관계가 검증되어야 한다. 강체 물체, 변형 가능한 물체, 천, contact를 정확히 시뮬레이션하는 난도가 다르고 현실적인 asset과 장면 변화를 만드는 비용도 크다.
Embodied benchmark에서는 다음 항목을 확인한다.
- 같은 policy를 반복 평가할 수 있다.
- 다양한 작업, asset, 초기 state를 제공한다.
- 실제 환경에서의 성공과 유의미한 상관관계가 있다.
- 센서와 action interface가 명확하다.
- 비공개 테스트 조건으로 overfitting을 막는다.
Foundation world model
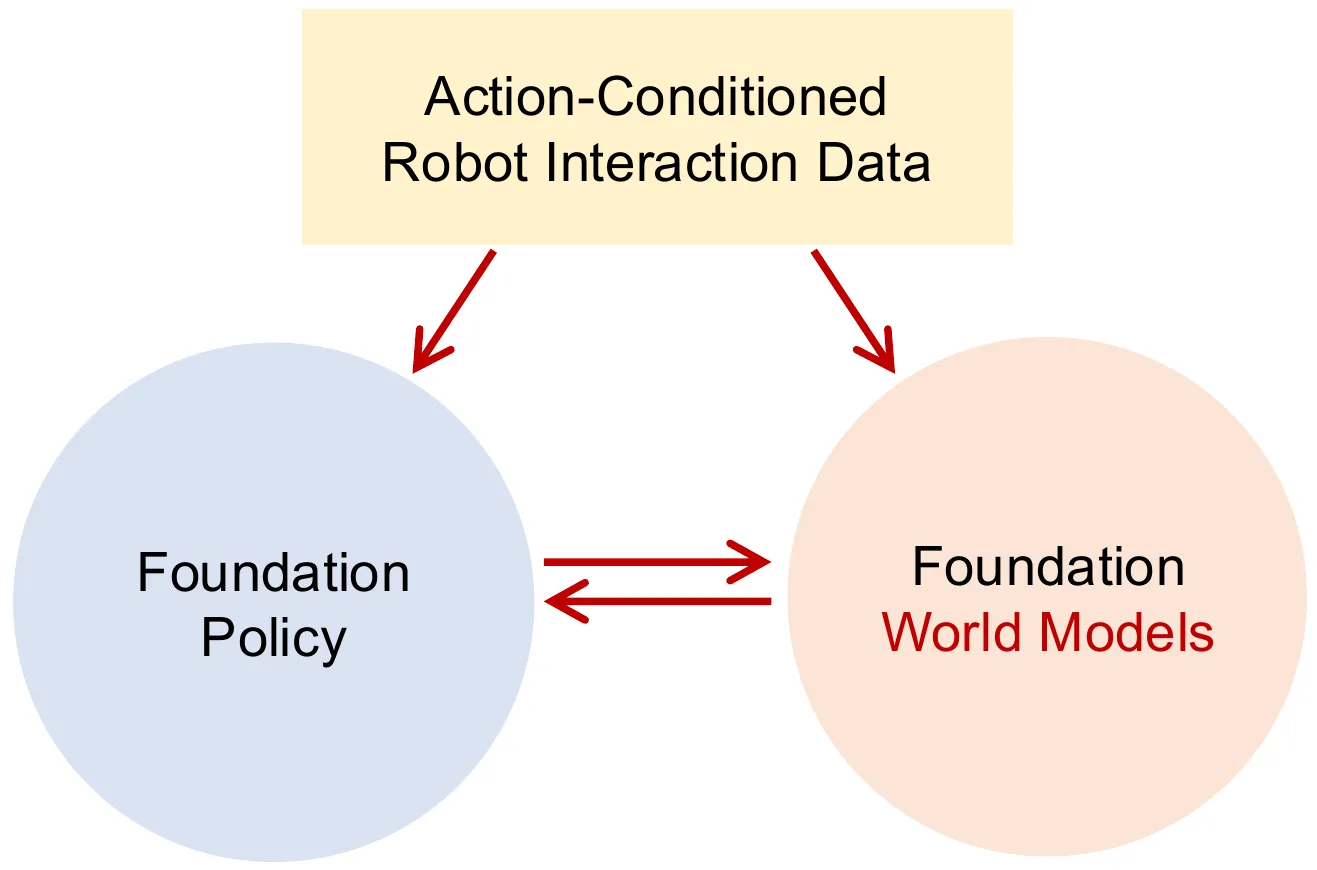
로봇 상호작용 데이터는 현재 observation, action, 다음 observation을 포함한다.
같은 데이터로 action prediction과 action-conditioned world model을 학습할 수 있다.
Foundation world model은 여러 물체, 작업, embodiment의 transition을 예측하고 policy planning, 합성 데이터 생성, 안전성 검증에 사용할 수 있다.
남은 설계 질문은 다음과 같다.
- Pixel, 3D geometry, object-centric graph 중 어떤 state를 예측할 것인가?
- Learned dynamics와 해석적인 물리 모델을 어떻게 결합할 것인가?
- 긴 rollout의 uncertainty와 누적 오차를 어떻게 표현할 것인가?
- Policy와 world model을 함께 학습할 것인가, 분리할 것인가?
전체 흐름 정리
- Reinforcement learning은 reward를 기준으로 trial-and-error exploration을 수행한다.
- Domain randomization은 시뮬레이션의 다양한 dynamics에서 robust policy를 학습해 실제 세계로 옮긴다.
- Model-based planning은 learned dynamics로 후보 action의 미래를 예측하고 feedback마다 다시 계획한다.
- Imitation learning은 expert demonstration의 observation-action pair에서 policy를 학습한다.
- Diffusion Policy는 multimodal action sequence를 generative model로 표현한다.
- VLA foundation model은 vision-language semantic prior와 multi-task robot data를 결합한다.
- Foundation world model은 같은 interaction 데이터에서 재사용 가능한 물리 예측 모델을 학습한다.