
핵심 한 줄 정리
Vision-language foundation model은 이미지와 텍스트를 공통 representation으로 정렬하거나 visual token을 language model의 context로 주입해 여러 과제를 하나의 pretrained model로 풀며, grounding과 promptable output, tool chaining을 더해 텍스트 응답을 실제 픽셀과 전문 vision model의 동작으로 연결한다.
중요 개념 정리
Task-specific model에서 foundation model로
전통적인 computer vision pipeline은 과제마다 데이터셋과 모델을 따로 만든다.
Image classification, captioning, detection, segmentation을 각각 풀려면 서로 다른 label과 architecture를 준비해야 한다. 데이터셋 분포나 범주가 바뀌면 다시 학습하는 경우도 많다.
Foundation model은 폭넓은 데이터와 학습 목표를 사용해 먼저 pretraining한 뒤 여러 downstream 과제에 적응하는 방향이다.
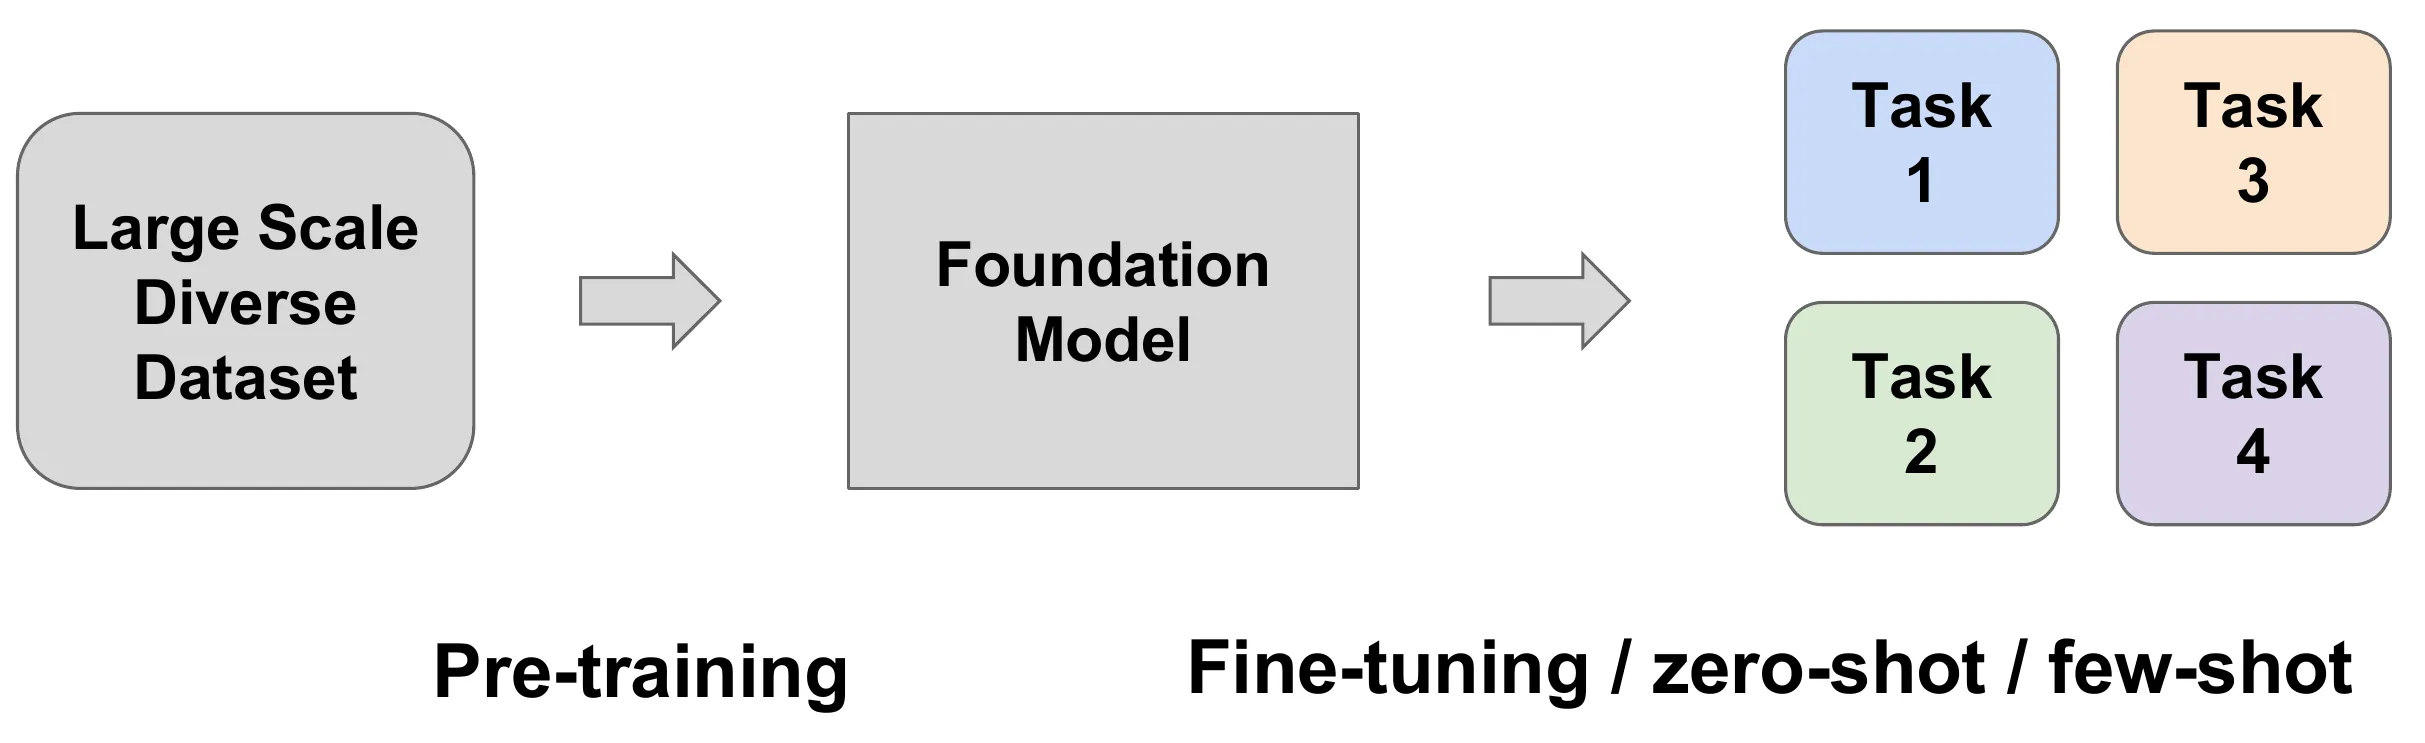
Foundation model은 보통 다음 특성을 목표로 한다.
- 규모가 큰 모델과 폭넓은 학습 데이터를 사용한다.
- 직접 만든 class label보다 데이터 자체에서 얻는 weak 또는 self-supervised signal을 활용한다.
- 하나의 representation이나 interface를 여러 과제에 재사용한다.
- 소량의 라벨이 있는 데이터, few-shot 예시, 또는 prompt만으로 새로운 과제에 적응한다.
Vision-language model은 이미지와 텍스트가 함께 존재하는 웹 데이터를 이용한다. 텍스트는 물체 범주뿐 아니라 색상, shape, action, 맥락을 함께 담을 수 있으므로 고정된 class label보다 풍부한 supervision이 된다.
Vision-language foundation model의 세 가지 방향
강의의 모델들은 대략 세 방향으로 나눌 수 있다.
| 방향 | 대표 모델 | 핵심 interface | 주된 출력 |
|---|---|---|---|
| Shared embedding | CLIP, CoCa | 이미지와 텍스트의 similarity | 클래스, retrieval ranking |
| Multimodal language model | LLaVA, Flamingo, Molmo | visual token을 language model에 제공 | autoregressive text, 점 |
| Promptable vision model | SAM | 이미지와 spatial prompt를 함께 encoding | segmentation mask |
마지막으로 chaining은 이 모델들을 서로 연결한다. Language model이 문제를 분해하고 CLIP, detector, SAM 같은 전문 모델을 도구로 호출하면 한 모델의 출력 공간을 넘어서는 과제를 수행할 수 있다.
CLIP의 기본 구조
CLIP은 Contrastive Language-Image Pre-training의 약자이다. Image encoder와 text encoder가 서로 다른 modality를 같은 embedding space로 매핑한다.
는 이미지, 는 그 이미지와 연결된 텍스트이다. 보통 두 embedding을 unit vector로 normalize한다.
Image-text similarity는 normalized embedding의 dot product와 temperature 로 계산한다.
Normalized vector의 dot product는 cosine similarity와 같다. Positive pair 의 similarity 는 높이고, minibatch 안의 mismatched pair 는 낮추는 것이 목표이다.
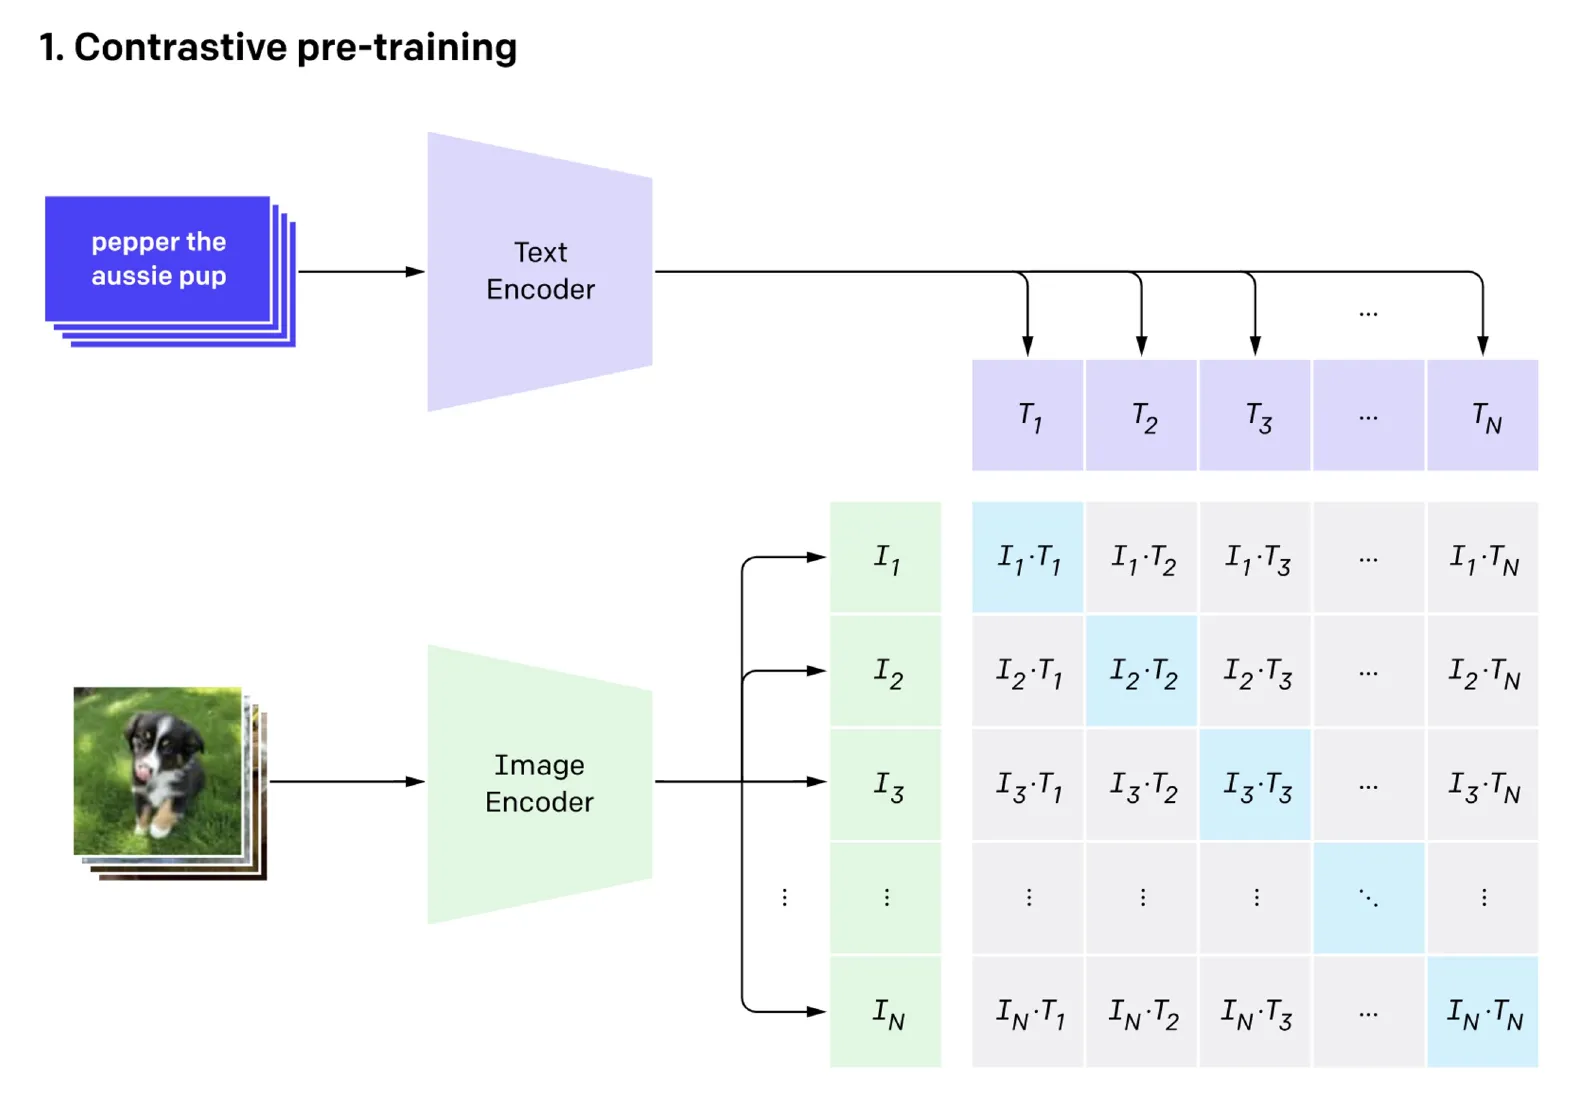
%% title: CLIP의 Dual-Encoder 구조
%% caption: Image encoder와 text encoder가 각각 embedding을 만들고, batch 내 모든 image-text dot product로 similarity matrix를 구성해 대각선 pair를 높이도록 학습한다.
flowchart LR
    images["Image Batch<br/>I₁ … Iₙ"] --> vision["Vision Encoder"]
    texts["Text Batch<br/>T₁ … Tₙ"] --> language["Text Encoder"]
    vision --> ie["Normalized Image Embeddings<br/>N × d"]
    language --> te["Normalized Text Embeddings<br/>N × d"]
    ie --> sim["Similarity Matrix<br/>S = IE · TEᵀ / τ"]
    te --> sim
    sim --> i2t["Image → Text Cross-Entropy"]
    sim --> t2i["Text → Image Cross-Entropy"]
    i2t --> loss["Symmetric CLIP Loss"]
    t2i --> loss
Symmetric image-text contrastive loss
Batch size를 라 하면 이미지 가 올바른 텍스트 를 찾는 손실은 다음과 같다.
반대 방향으로 텍스트 가 올바른 이미지 를 찾는 손실도 사용한다.
최종 손실은 두 방향의 손실을 대칭적으로 평균낸 값이다.
한 batch의 다른 샘플들이 negative pair 역할을 한다. 따라서 batch가 크면 더 다양한 negative를 비교할 수 있고 fine-grained concept을 구분할 가능성이 커진다. 강의에서는 약 32,000의 매우 큰 effective batch를 hard negative가 등장할 확률을 높이는 예로 들었다.
Negative가 너무 쉬우면 관계나 세부 범주를 학습하지 못하고, 직접 설계한 hard negative만 과도하게 넣으면 폭넓은 semantic generalization이 약해질 수 있다.
CLIP의 training data와 scale
CLIP은 사람이 직접 부여한 고정된 class label 대신 웹의 image-text pair를 weak supervision으로 사용한다. 원 논문의 큰 모델 예시에서는 약 4억 개 image-text pair와 3억 700만 parameter 규모의 Vision Transformer가 사용되었다.
ImageNet은 약 130만 이미지와 1,000개의 범주를 중심으로 한다. 웹 caption에는 잡음이 많지만 훨씬 큰 규모로 모을 수 있고 물체 이름 외에도 장면과 특성을 포함한다. 강의에서는 드문 pose와 맥락을 포함한 ObjectNet에서 CLIP representation이 ImageNet-only 모델보다 잘 일반화하는 예를 들었다.
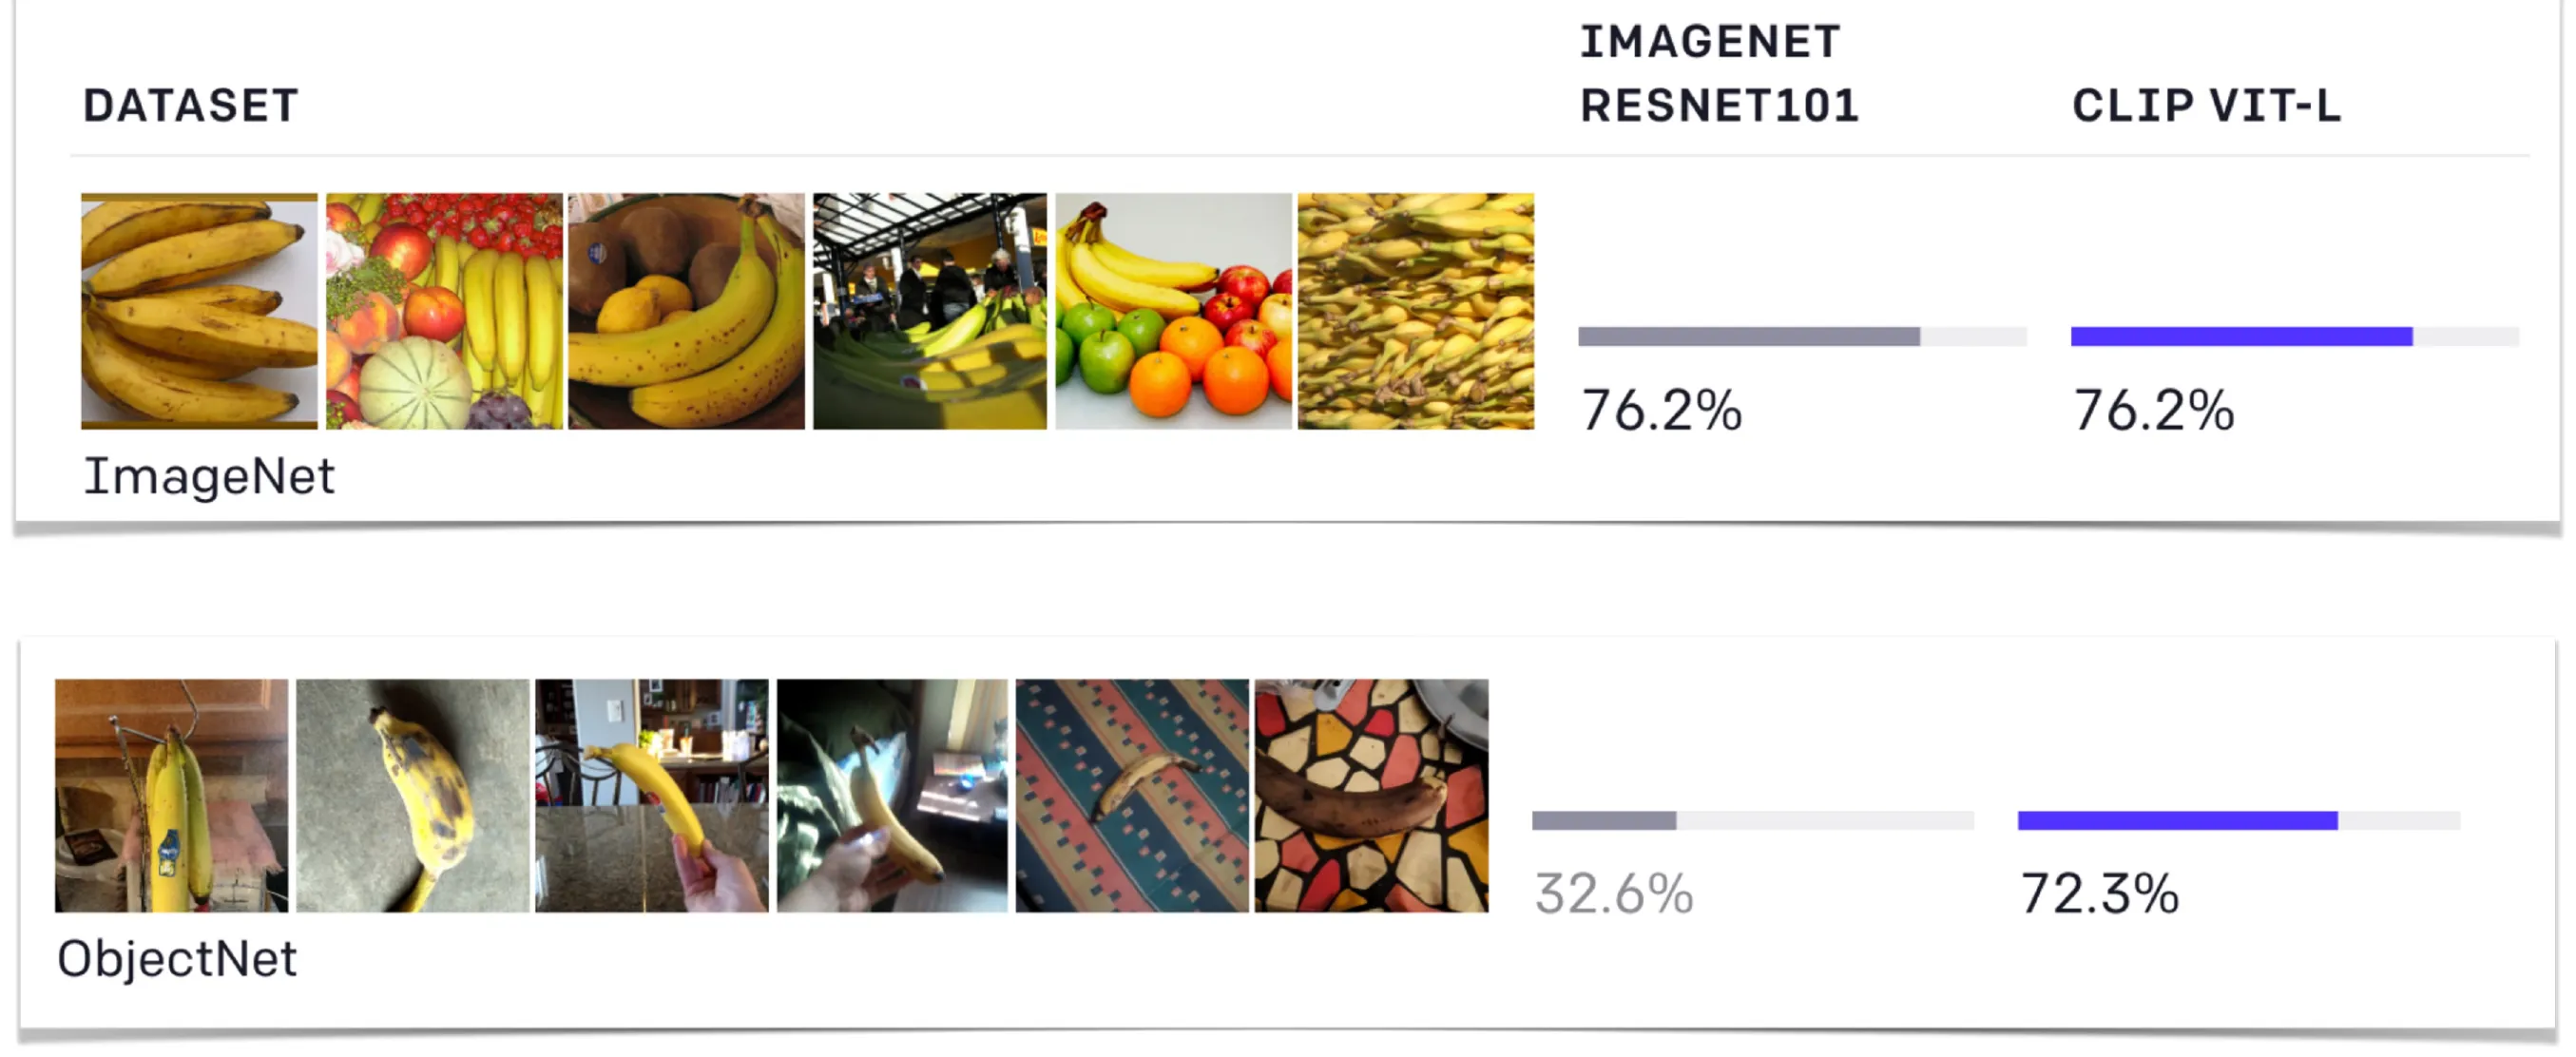
웹 텍스트는 게시자의 감정이나 주변 맥락만 설명하고 이미지 속 물체와 공간 관계를 생략할 수 있다. 편향과 중복도 포함하므로 pair를 선별할 때 이미지와 텍스트의 대응 여부, 개념별 수집량, 중복을 확인해야 한다.
CLIP을 downstream task에 사용하는 방법
Pretrained image encoder를 사용하는 방법은 세 가지로 구분할 수 있다.
- Linear probe: encoder를 고정하고 labeled feature 위에 linear classifier만 학습한다.
- Fine-tuning: pretrained encoder 일부 또는 전체를 downstream 데이터로 갱신한다.
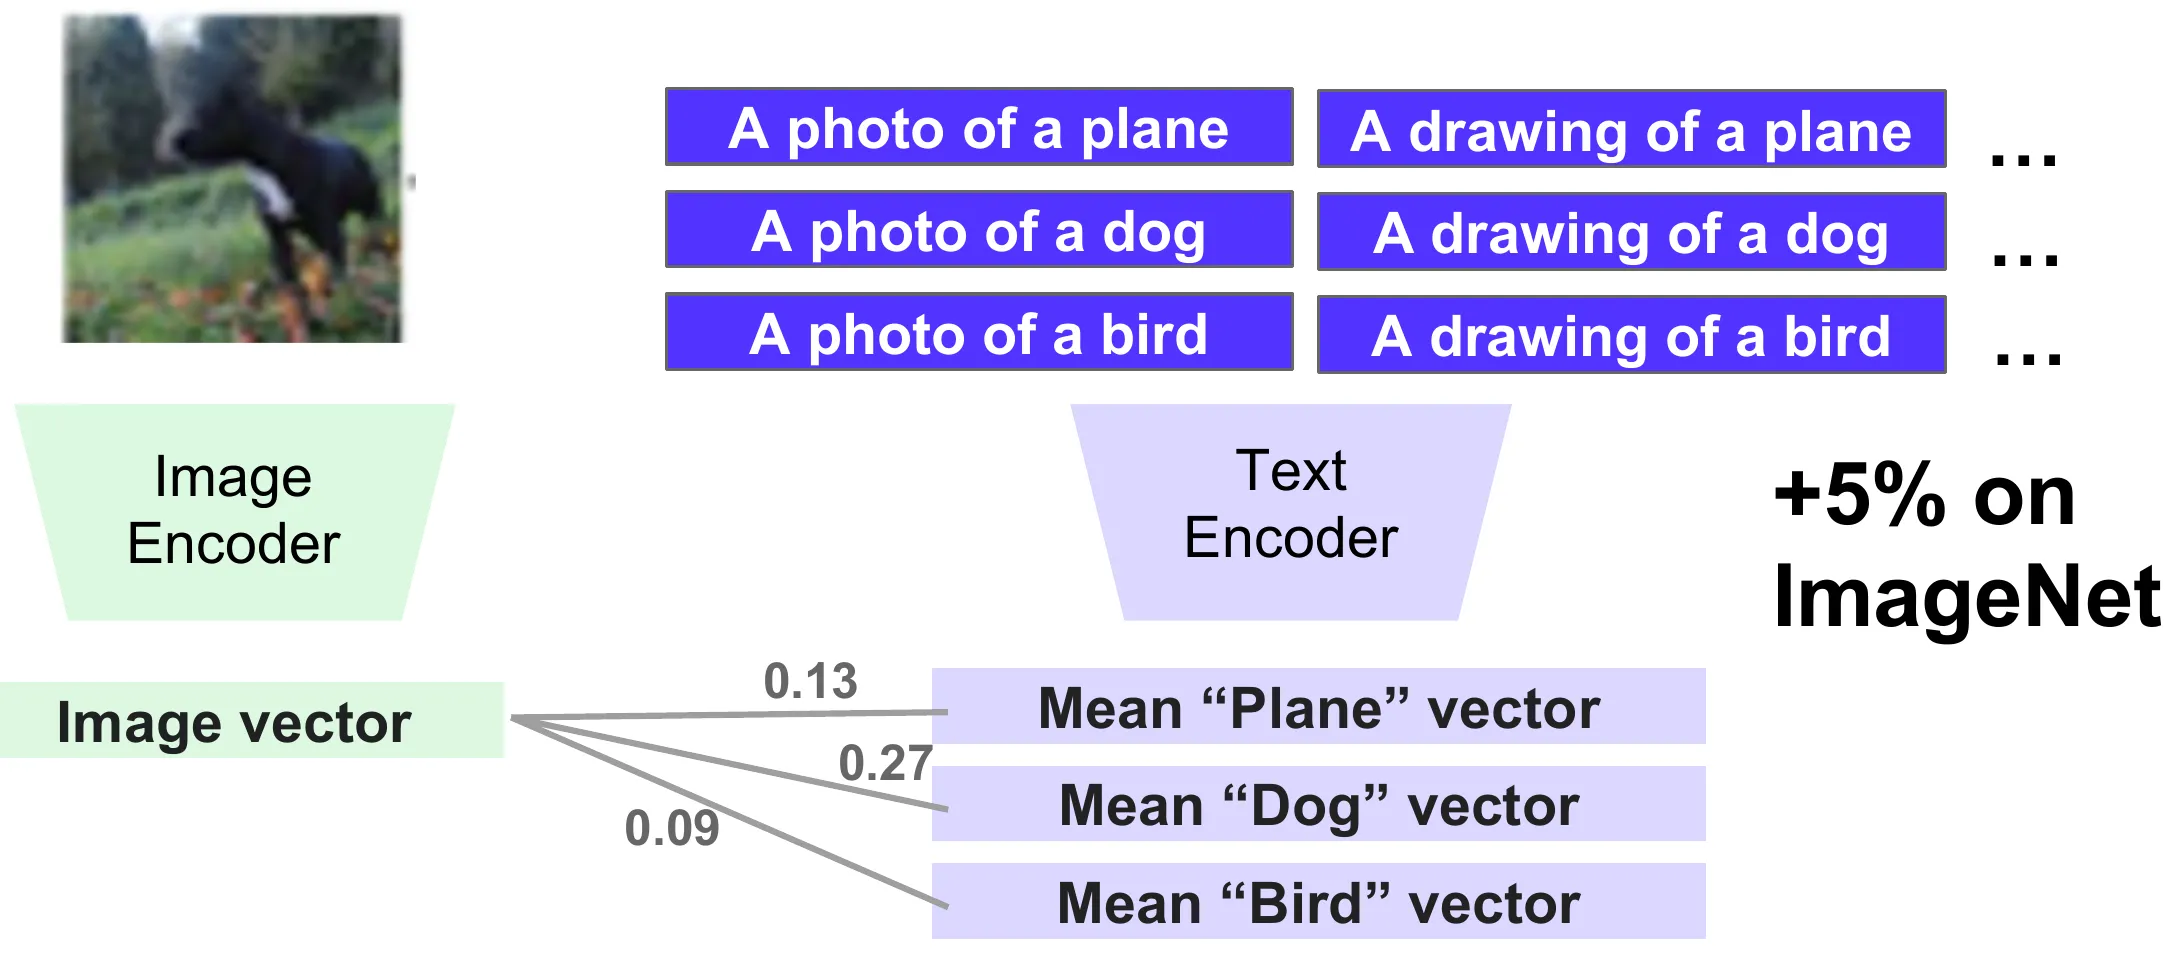
- Zero-shot classification: text encoder로 class prototype을 만들고 별도 학습 없이 이미지와 비교한다.
Linear probe는 representation에 클래스 정보가 선형적으로 분리되어 있는지 측정하기 좋다. Fine-tuning은 과제에 더 맞게 적응하지만 라벨이 있는 데이터와 compute가 필요하다. Zero-shot은 클래스 이름만으로 바로 사용할 수 있지만 prompt와 학습 분포에 민감하다.
Zero-shot classification
새 데이터셋의 클래스가 라고 하자. 각 클래스 이름을 text prompt에 넣어 prototype을 만든다.
입력 image embedding 와 각 class prototype의 similarity를 비교한다.
이는 text embedding을 class center로 사용하는 nearest-neighbor classifier로 볼 수 있다. Classifier vocabulary를 추론 시점에 텍스트로 정할 수 있으므로 open-vocabulary classification이 가능하다.
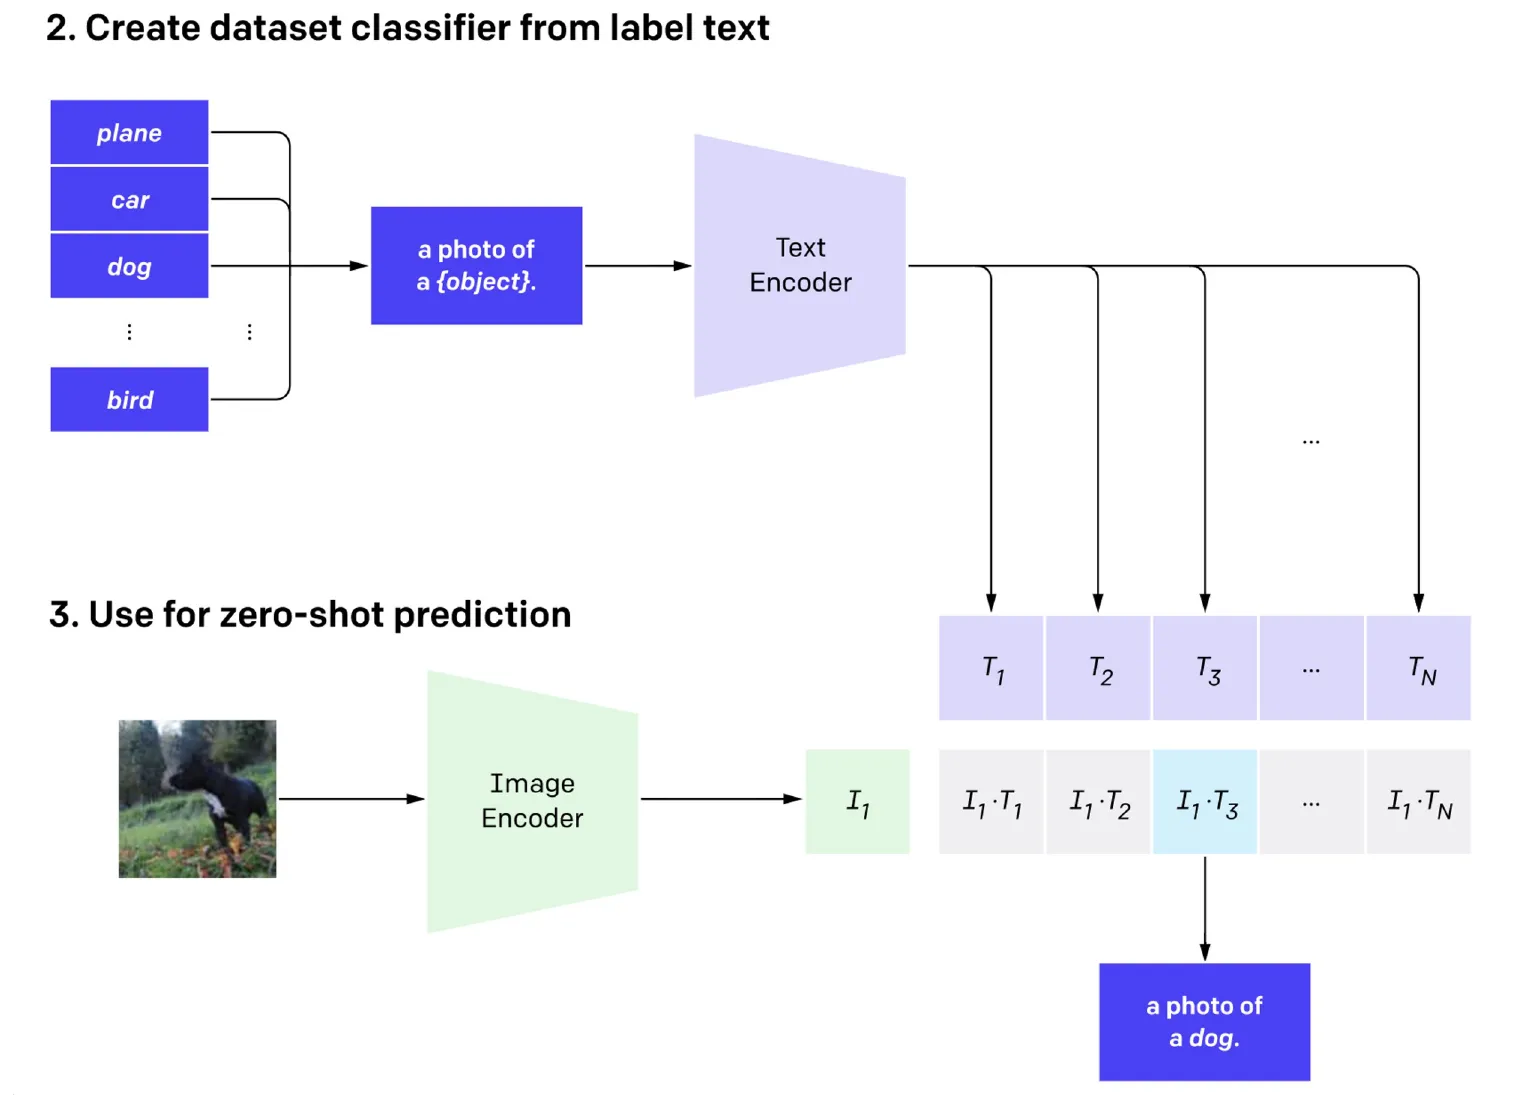
새 클래스를 구분하려면 클래스 설명이 pretraining 데이터와 충분히 연결되어 있어야 하고, encoder가 그 시각적 특성을 구분할 수 있어야 한다.
Prompt engineering과 prompt ensemble
CLIP은 인터넷에서 주로 구절이나 문장과 함께 학습되었으므로 클래스 이름 하나보다 자연스러운 prompt가 잘 동작할 수 있다. 강의에서는 dog 대신 a photo of a dog를 사용했을 때 ImageNet 정확도가 약 1.3 퍼센트포인트 개선된 예를 들었다.
Prompt 하나의 표현에 의존하지 않도록 여러 template을 사용할 수 있다.
a photo of a dog, a drawing of a dog처럼 여러 prompt의 embedding을 평균하면 표현 방식에 따른 variance를 줄일 수 있다.
CLIP의 장점
CLIP representation은 다음 용도로 재사용할 수 있다.
- Open-vocabulary classification과 retrieval을 같은 similarity 계산으로 수행한다.
- image embedding과 text embedding을 미리 계산하면 nearest-neighbor search가 빠르다.
- 라벨이 있는 범주가 적거나 없는 domain에 zero-shot으로 적용할 수 있다.
- Image encoder를 detection, segmentation, multimodal language model의 backbone으로 재사용할 수 있다.
- Text description을 interface로 사용하므로 다른 language model과 연결하기 쉽다.
Image-to-text retrieval은 query 이미지에 가까운 caption을 찾고, text-to-image retrieval은 query 텍스트에 가까운 이미지를 찾는다. Training loss가 이미 양방향 retrieval 목적함수이므로 같은 embedding을 그대로 재사용할 수 있다.
CLIP의 한계
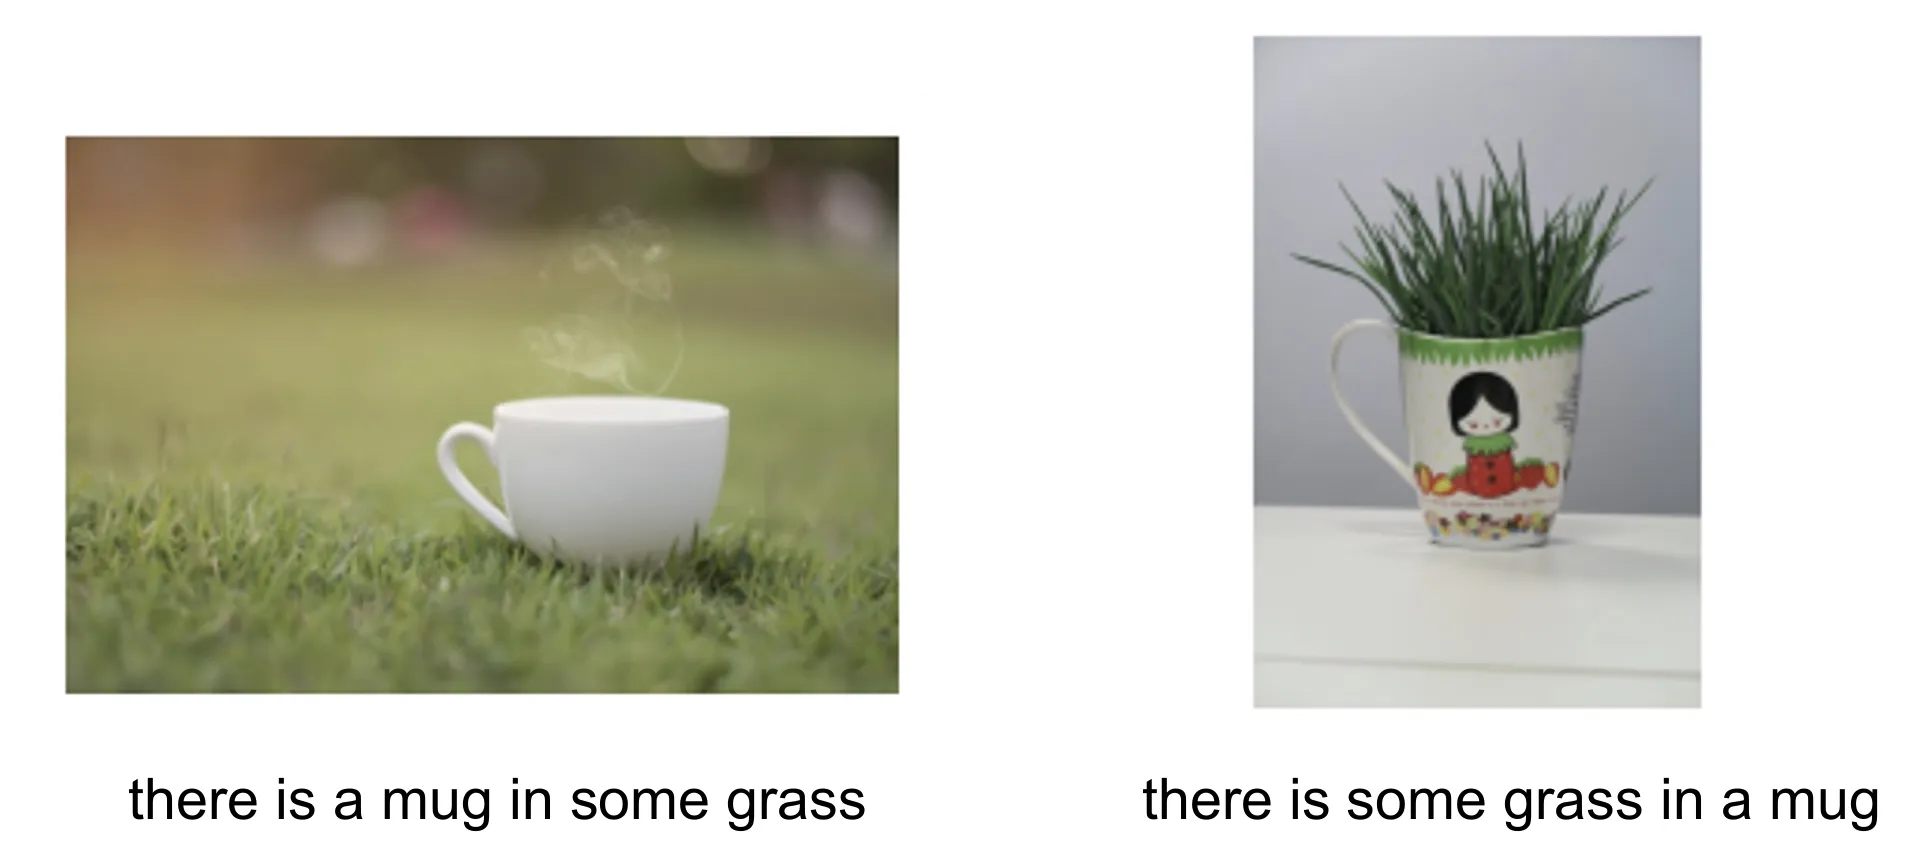
CLIP은 이미지 전체와 텍스트 전체의 alignment를 학습한다. 이 목적함수만으로는 물체 위치와 관계를 정확히 학습하기 어렵다.
강의의 대표 예는 a mug in grass와 grass in a mug이다. 두 구절은 같은 명사를 포함하지만 관계가 반대이다. CLIP은 이미지 전체에서 머그컵과 잔디가 함께 나타난다는 사실은 잡아도 어느 것이 어느 안에 있는지 구분하지 못할 수 있다.
주요 한계는 다음과 같다.
- Compositionality: 같은 개념의 다른 조합과 관계에 약하다.
- Spatial grounding: 단어와 pixel region의 correspondence를 직접 감독하지 않는다.
- Fine-grained distinction: 적절한 negative가 없으면 비슷한 subclass를 구분하지 못한다.
- 데이터 의존성: web pair의 누락, 잡음, 편향을 그대로 학습할 수 있다.
- 근거의 불투명성: 높은 similarity가 어떤 pixel을 근거로 했는지 설명하지 않는다.
ViT의 patch token은 global class token을 만드는 attention에 참여하므로 gradient를 간접적으로 받는다. CLIP contrastive loss는 개별 patch와 구절을 직접 정렬하지 않으므로 patch-level localization을 보장하지 않는다.
Winoground, ARO, CREPE 같은 benchmark는 물체와 관계를 재조합한 예시로 이런 compositional limitation을 측정한다.
CoCa의 contrastive-captioning objective
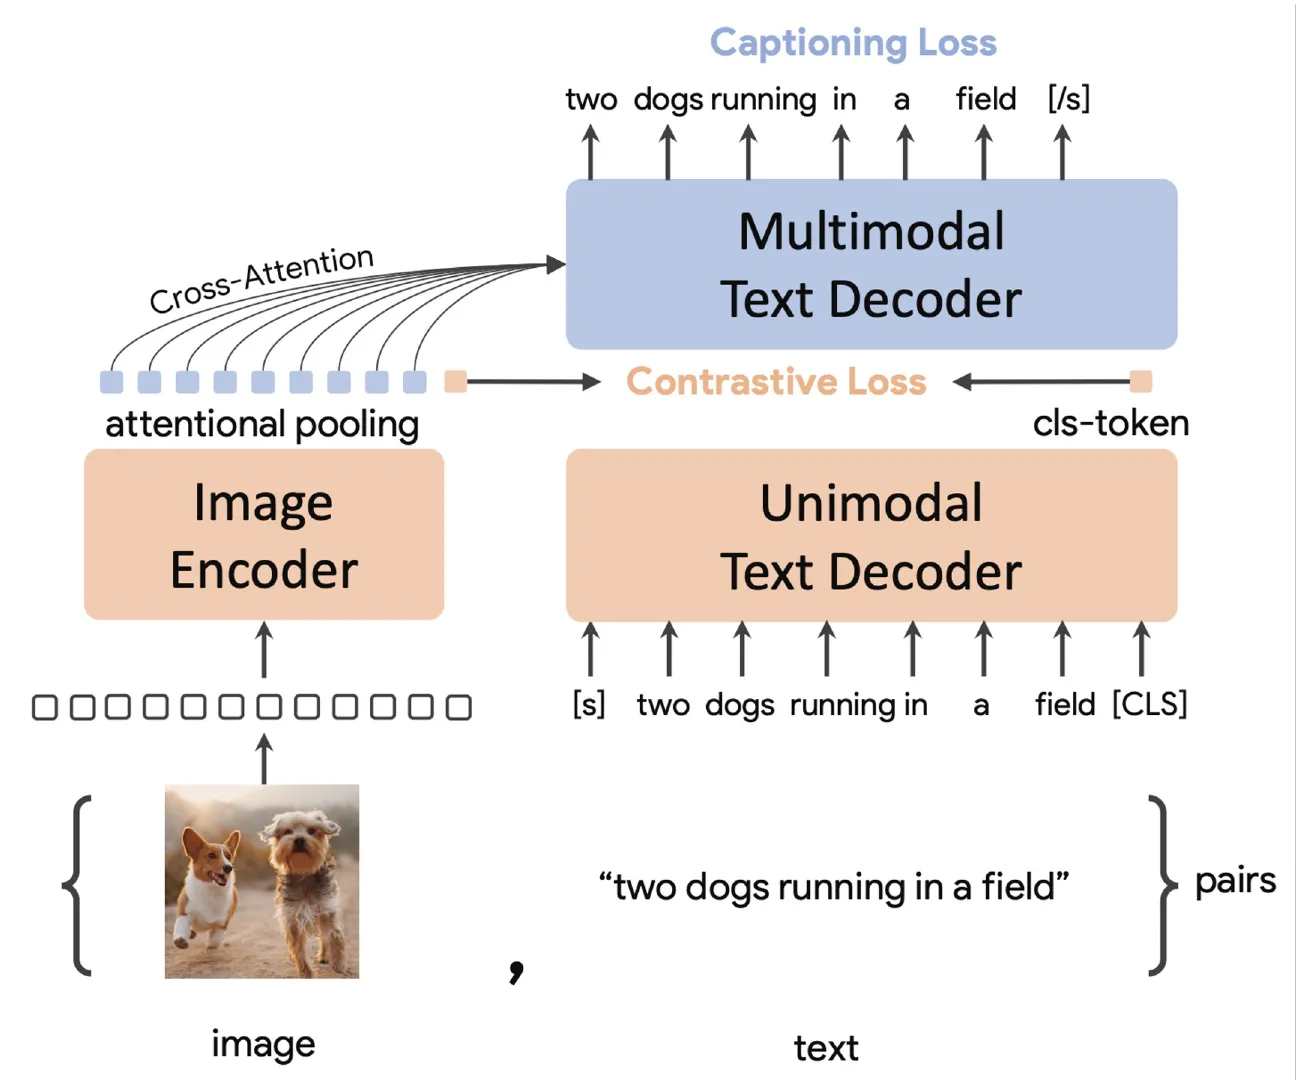
CoCa는 Contrastive Captioners의 약자이다. CLIP의 global contrastive objective에 autoregressive captioning objective를 함께 사용한다.
Image encoder에서 얻은 visual feature와 text representation으로 contrastive loss를 계산한다.
Multimodal decoder는 visual feature에 cross-attention하며 caption token을 예측한다.
전체 목적함수는 두 손실의 가중합이다.
Contrastive loss는 이미지와 텍스트의 global correspondence를 학습한다. Captioning loss는 이미지 속 물체, 행동, 관계를 설명하는 각 token의 예측에 손실을 주어 세부 정보를 학습하도록 한다.
Multimodal language model의 기본 관점
Autoregressive language model은 이전 token에서 다음 token을 예측한다.
Multimodal language model은 이미지에서 만든 visual token을 추가 맥락으로 사용한다.
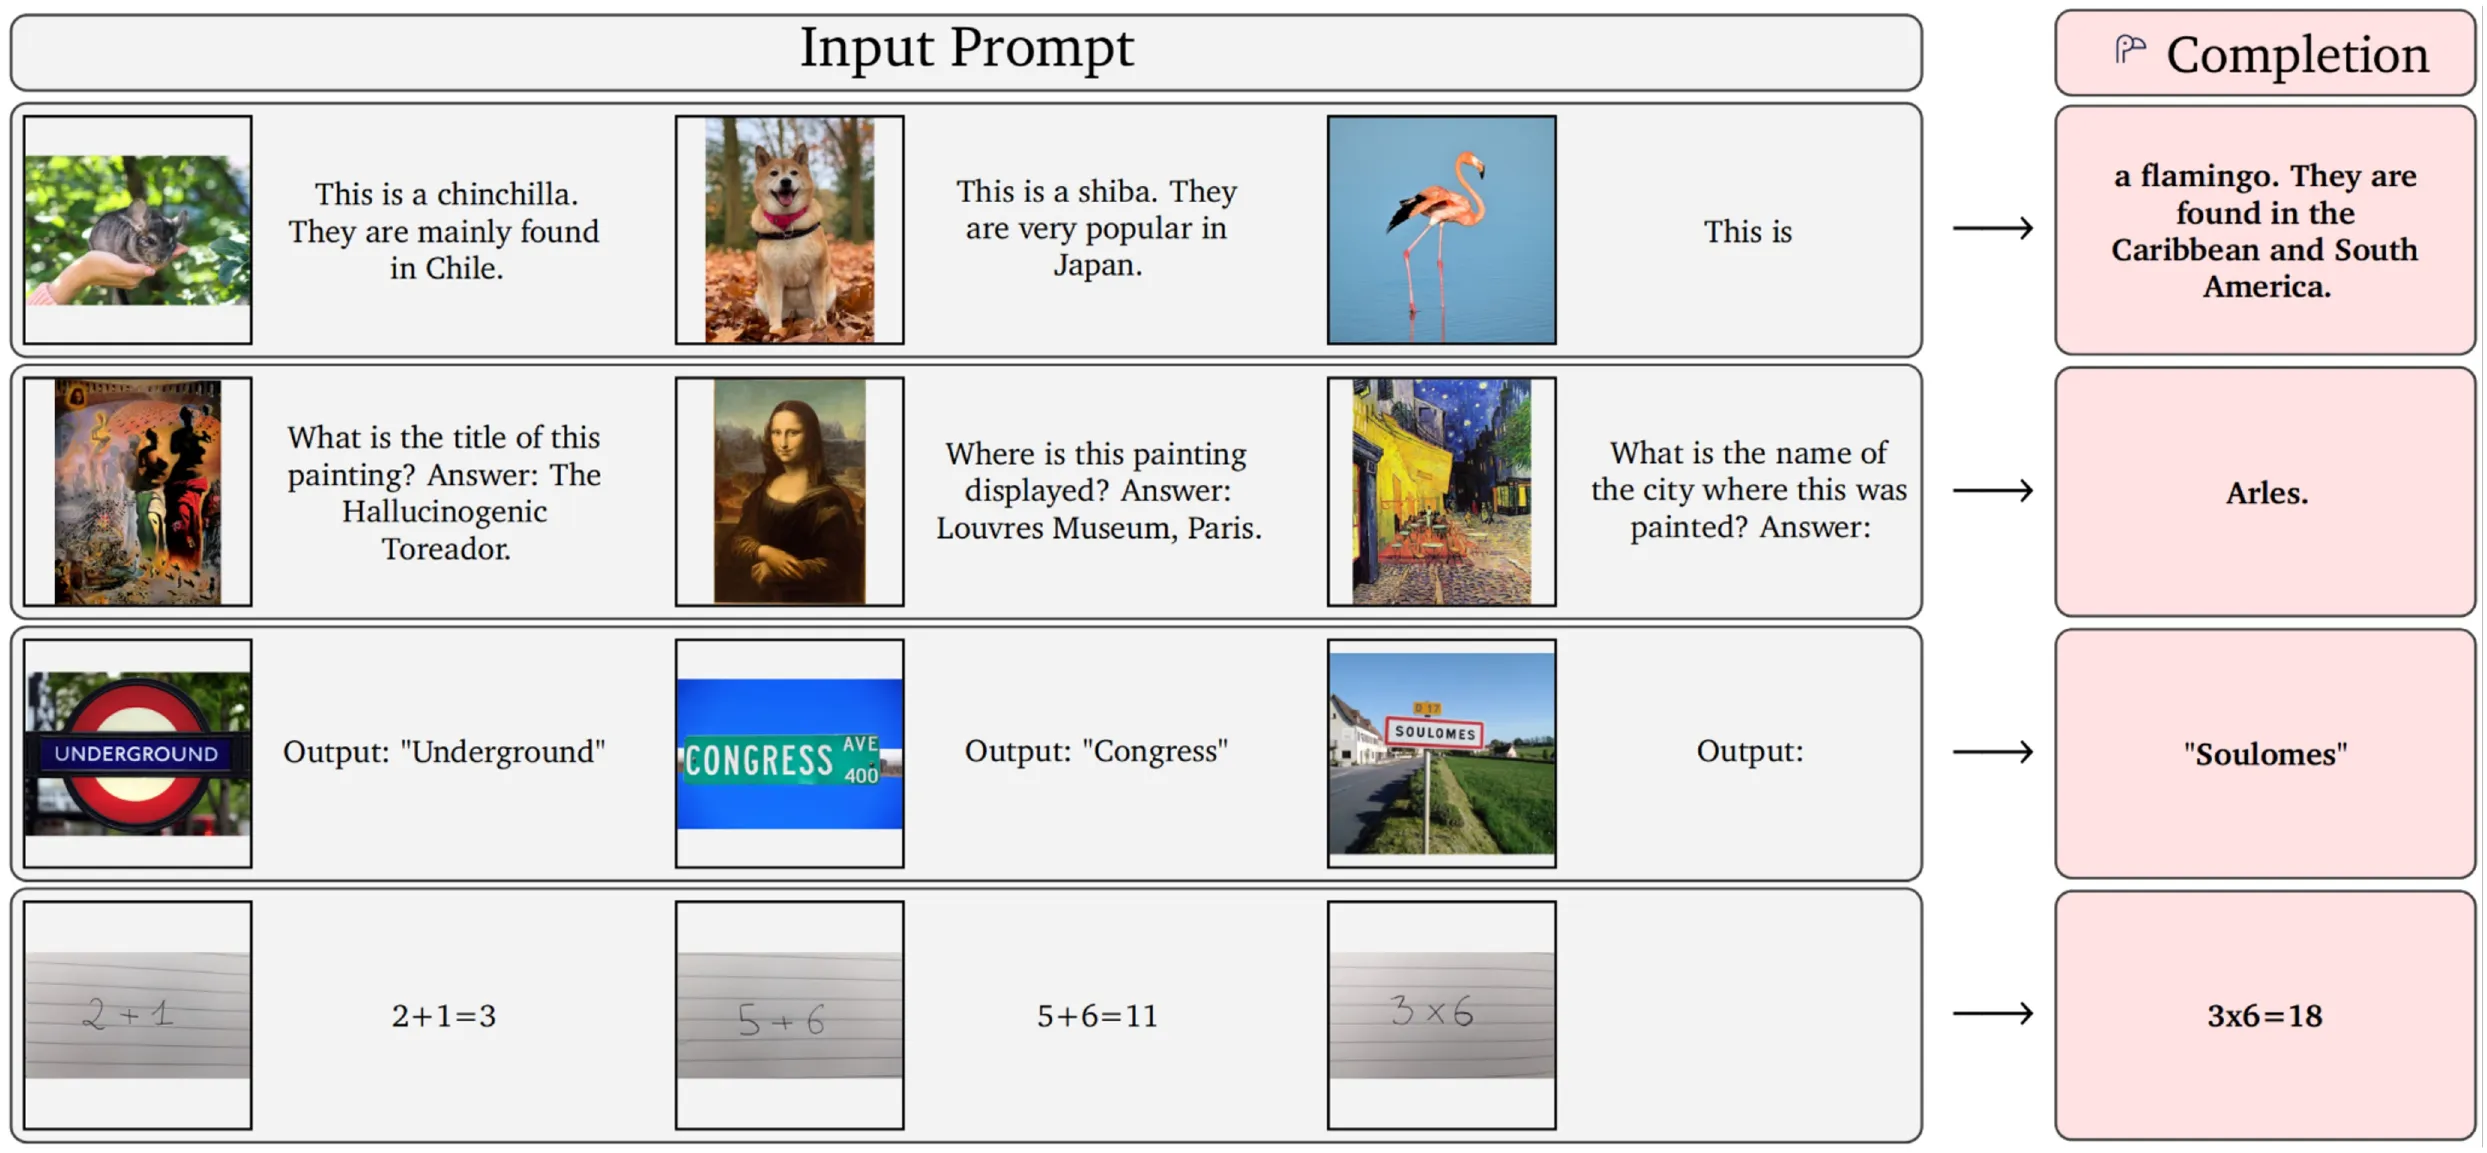
이미지를 language model이 읽을 수 있는 token sequence로 바꾸면 captioning, VQA, OCR, classification을 모두 next-token prediction 형태로 통일할 수 있다. 과제별 입력과 출력 형식은 natural-language prompt와 답변으로 지정한다.
LLaVA의 visual token 연결
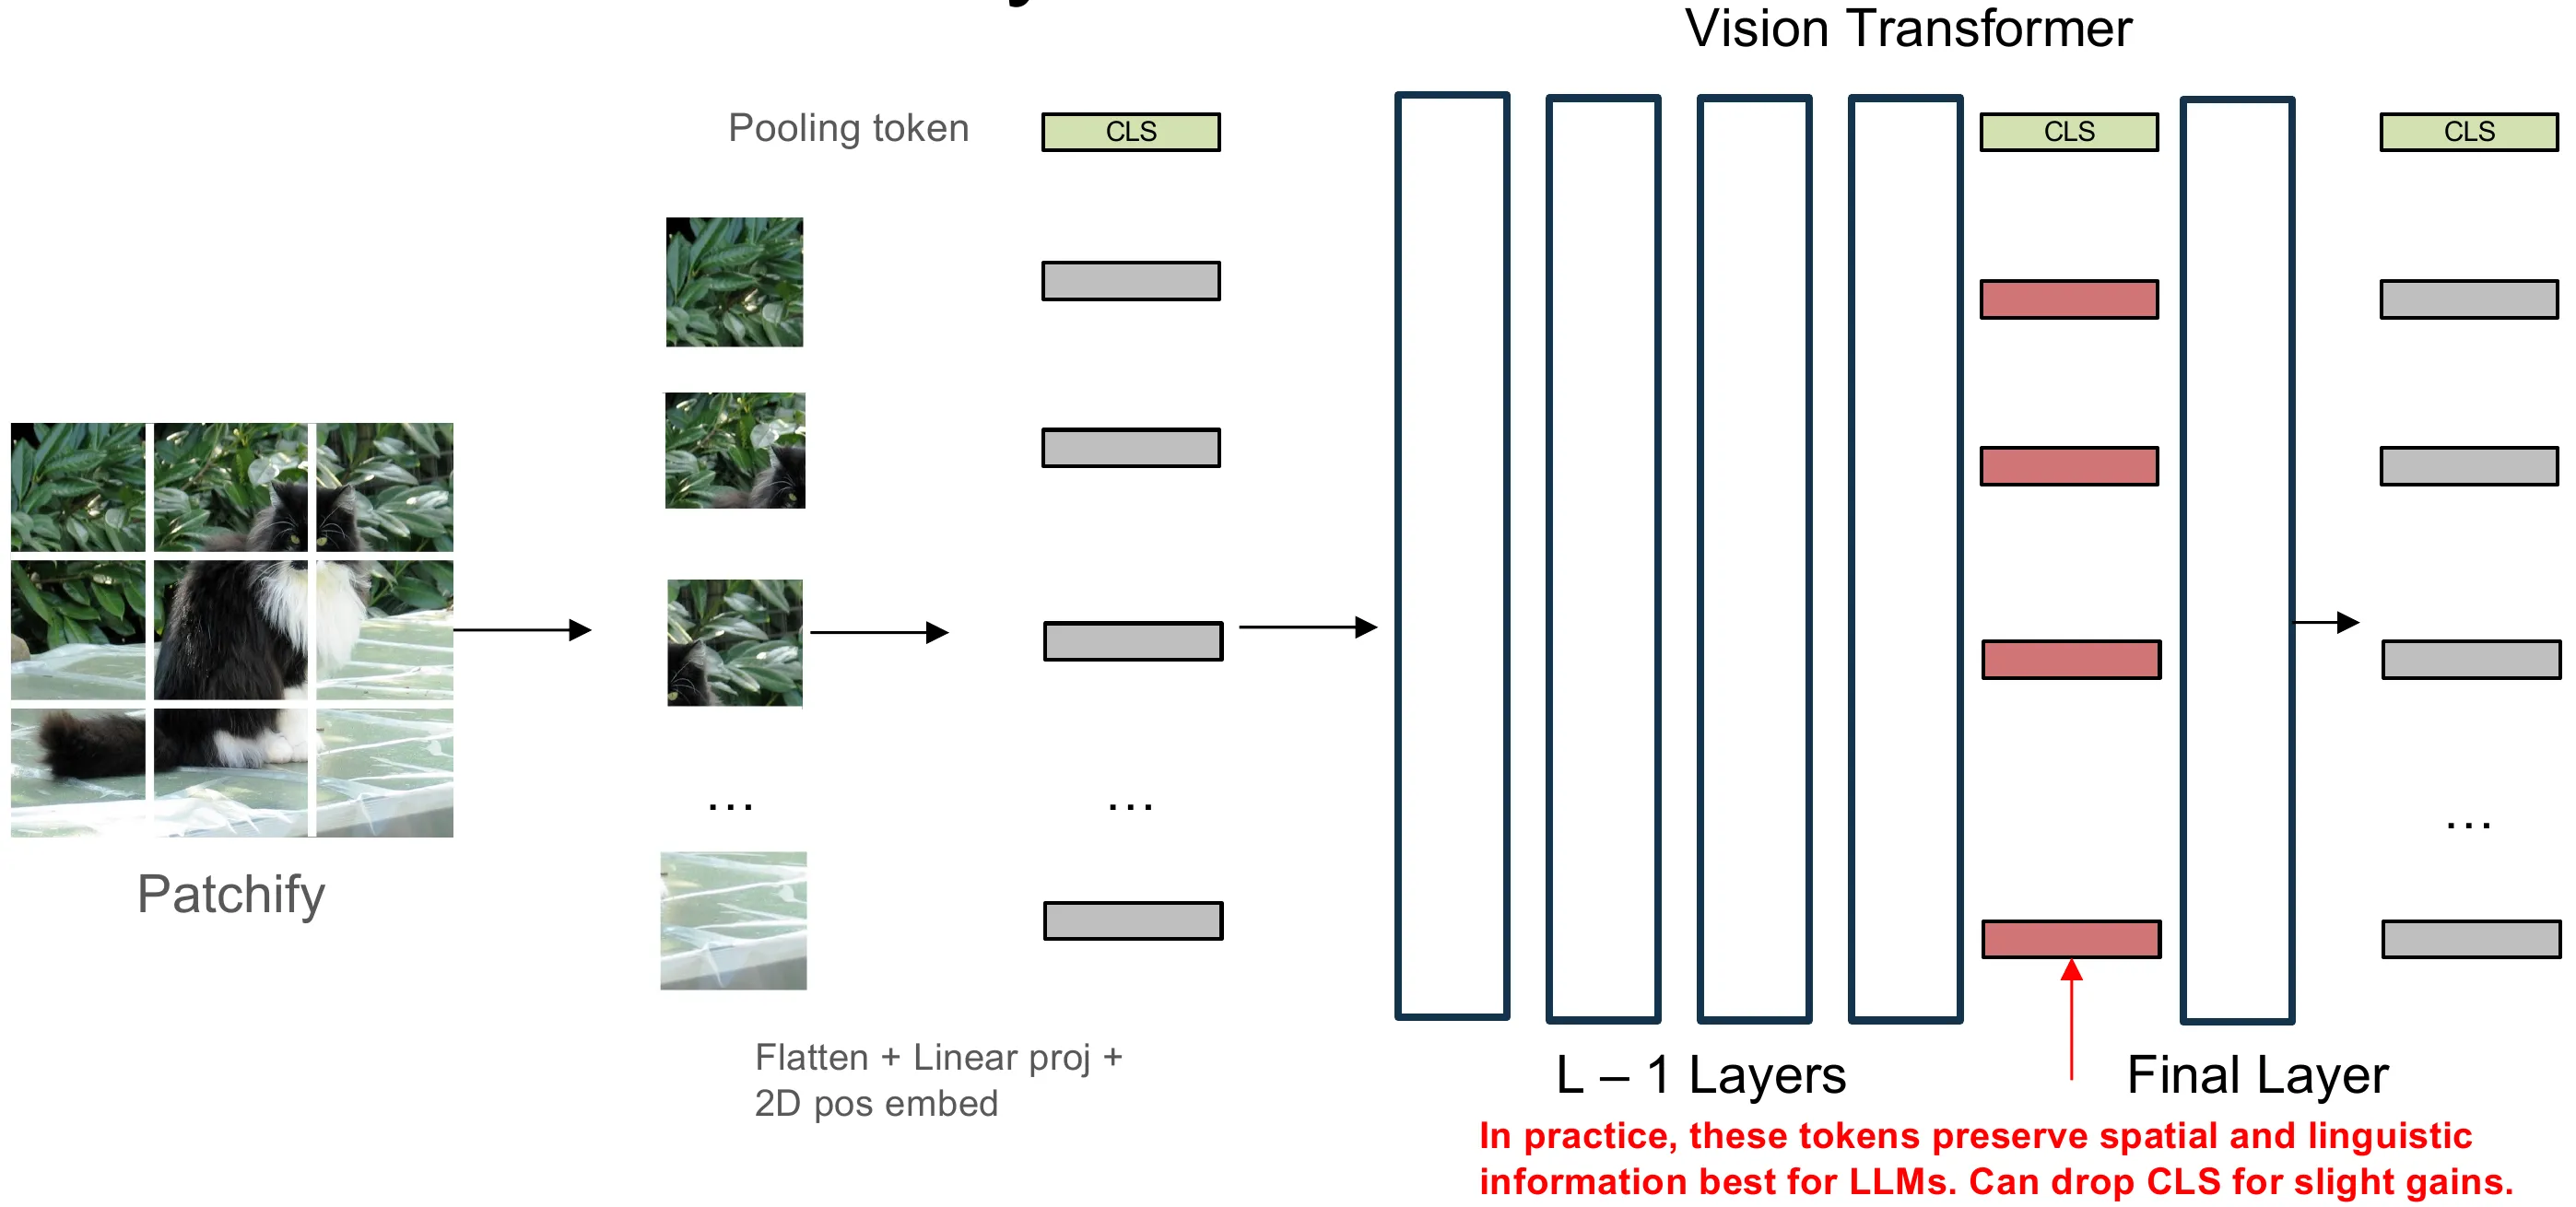
LLaVA는 pretrained vision encoder, projector, pretrained language model을 연결한다.
는 visual token 수이고 는 vision encoder dimension이다. Linear projector가 이를 language model embedding dimension 로 바꾼다.
Projected visual token과 text token을 하나의 sequence로 넣는다.
Language model의 architecture를 크게 바꾸지 않고 visual token을 prefix context처럼 사용할 수 있다는 장점이 있다.
Pretrained vision encoder와 LLM에서 시작해 projector를 먼저 학습한 뒤, LLM과 projector를 함께 fine-tuning한다.
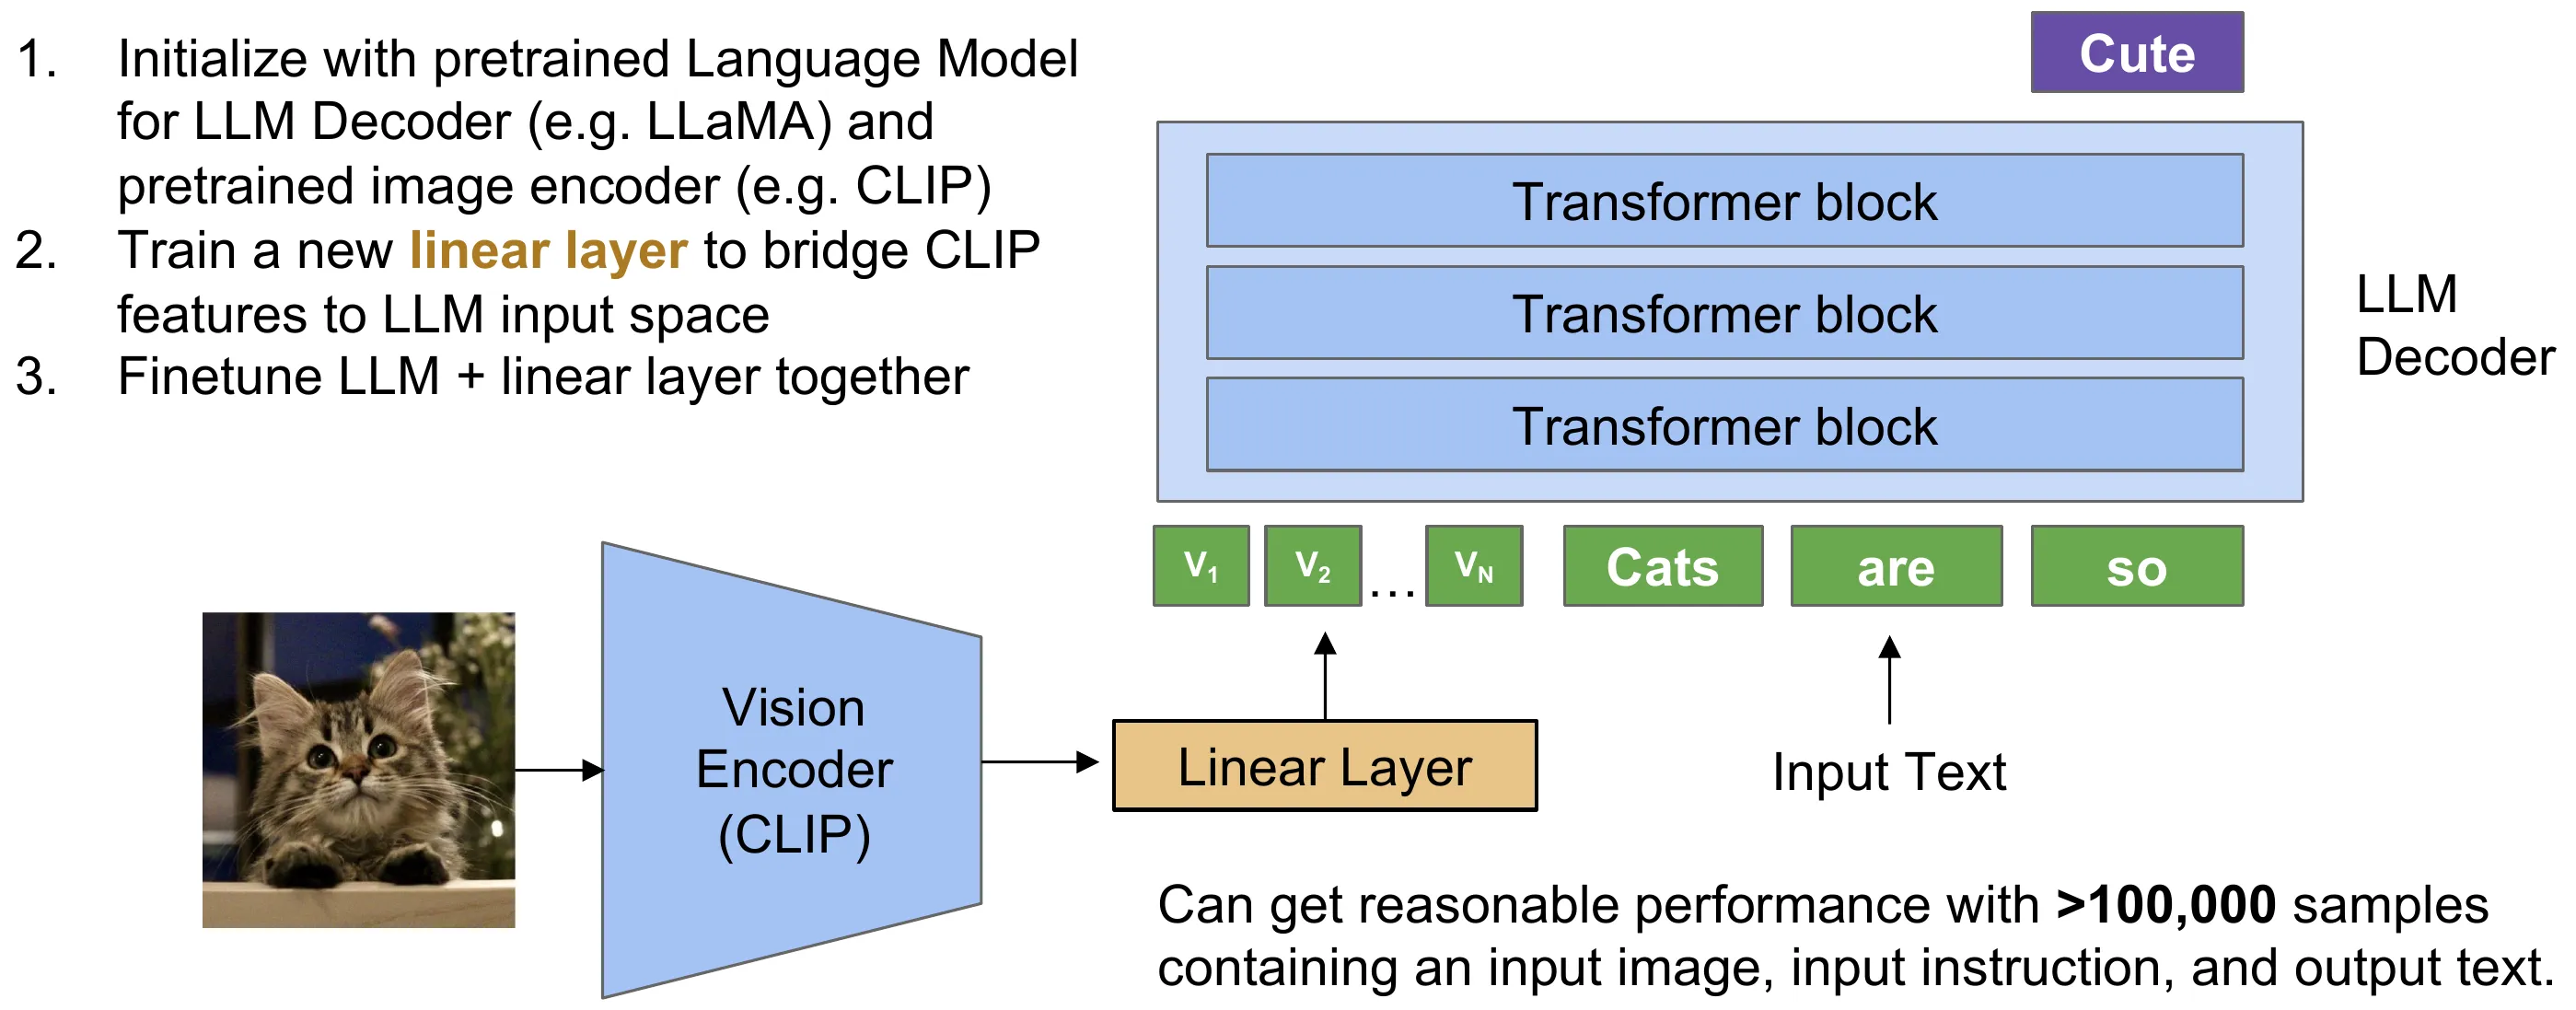
Global CLS token 하나만 쓰면 이미지 전체 의미는 담을 수 있지만 공간적 세부 정보가 많이 압축된다. 실제 multimodal model은 CLIP ViT의 intermediate layer 또는 penultimate layer에서 patch token들을 가져오는 경우가 많다. 이 token들은 최종 global embedding보다 위치별 정보를 더 많이 유지한다.
Input fusion과 cross-attention fusion
LLaVA식 input fusion은 projected visual token을 text token과 함께 language model 입력에 넣는다. Visual token 수가 늘면 self-attention의 context 길이와 연산량이 커진다.
Flamingo는 시각 정보를 language model의 여러 layer에 cross-attention으로 주입한다. Language hidden state가 query가 되고 compressed visual token이 key와 value가 된다.
각 language layer는 현재 token을 생성하는 데 필요한 visual region을 선택해서 읽을 수 있다.
Flamingo의 Perceiver Resampler와 gated cross-attention
이미지와 비디오는 입력 크기에 따라 visual token 수가 달라질 수 있다. Flamingo의 Perceiver Resampler는 variable-length visual feature를 고정된 개수의 latent token으로 압축한다.
은 이미지 해상도와 무관하게 고정된 latent token 수이다. 이 token을 language model layer 사이의 cross-attention에 제공한다.
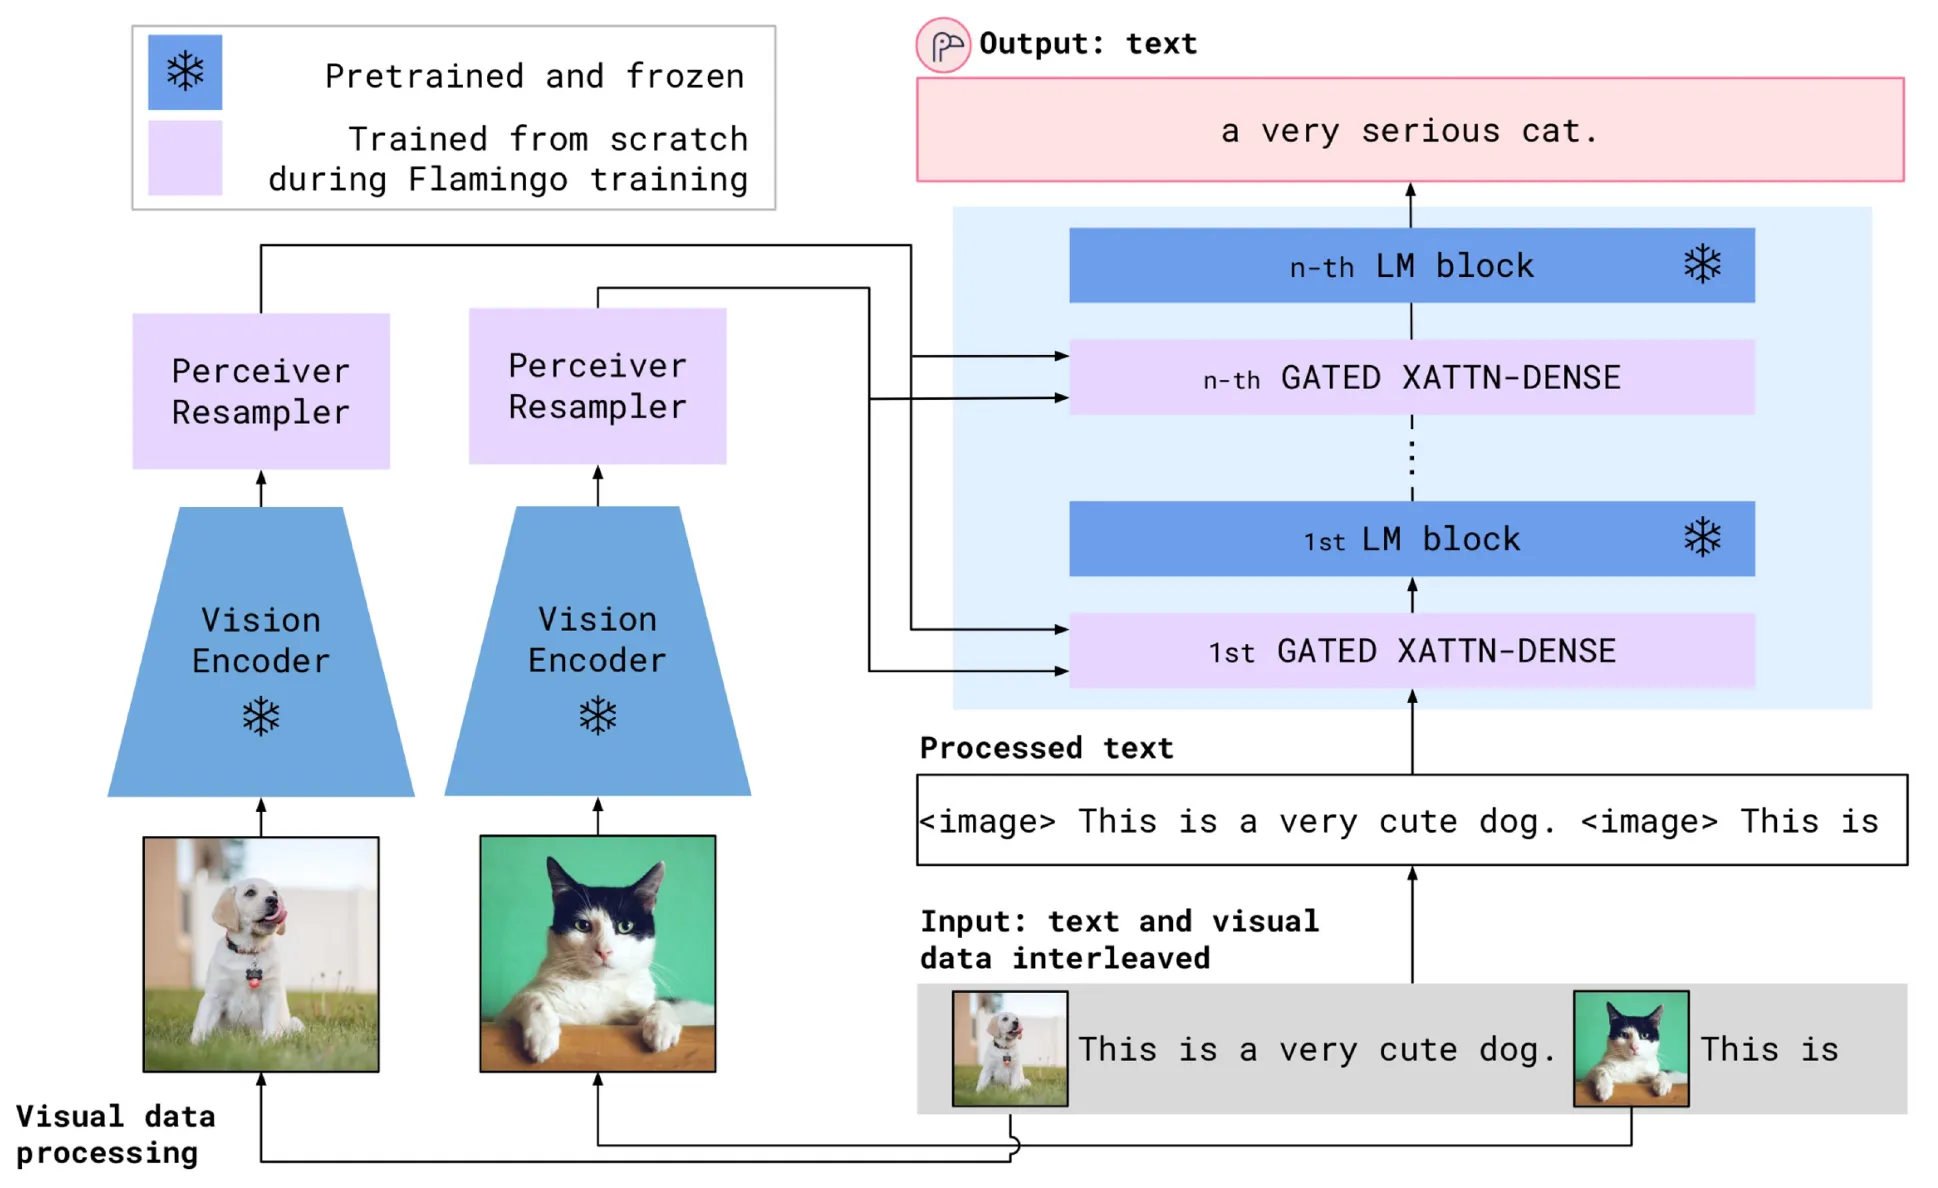
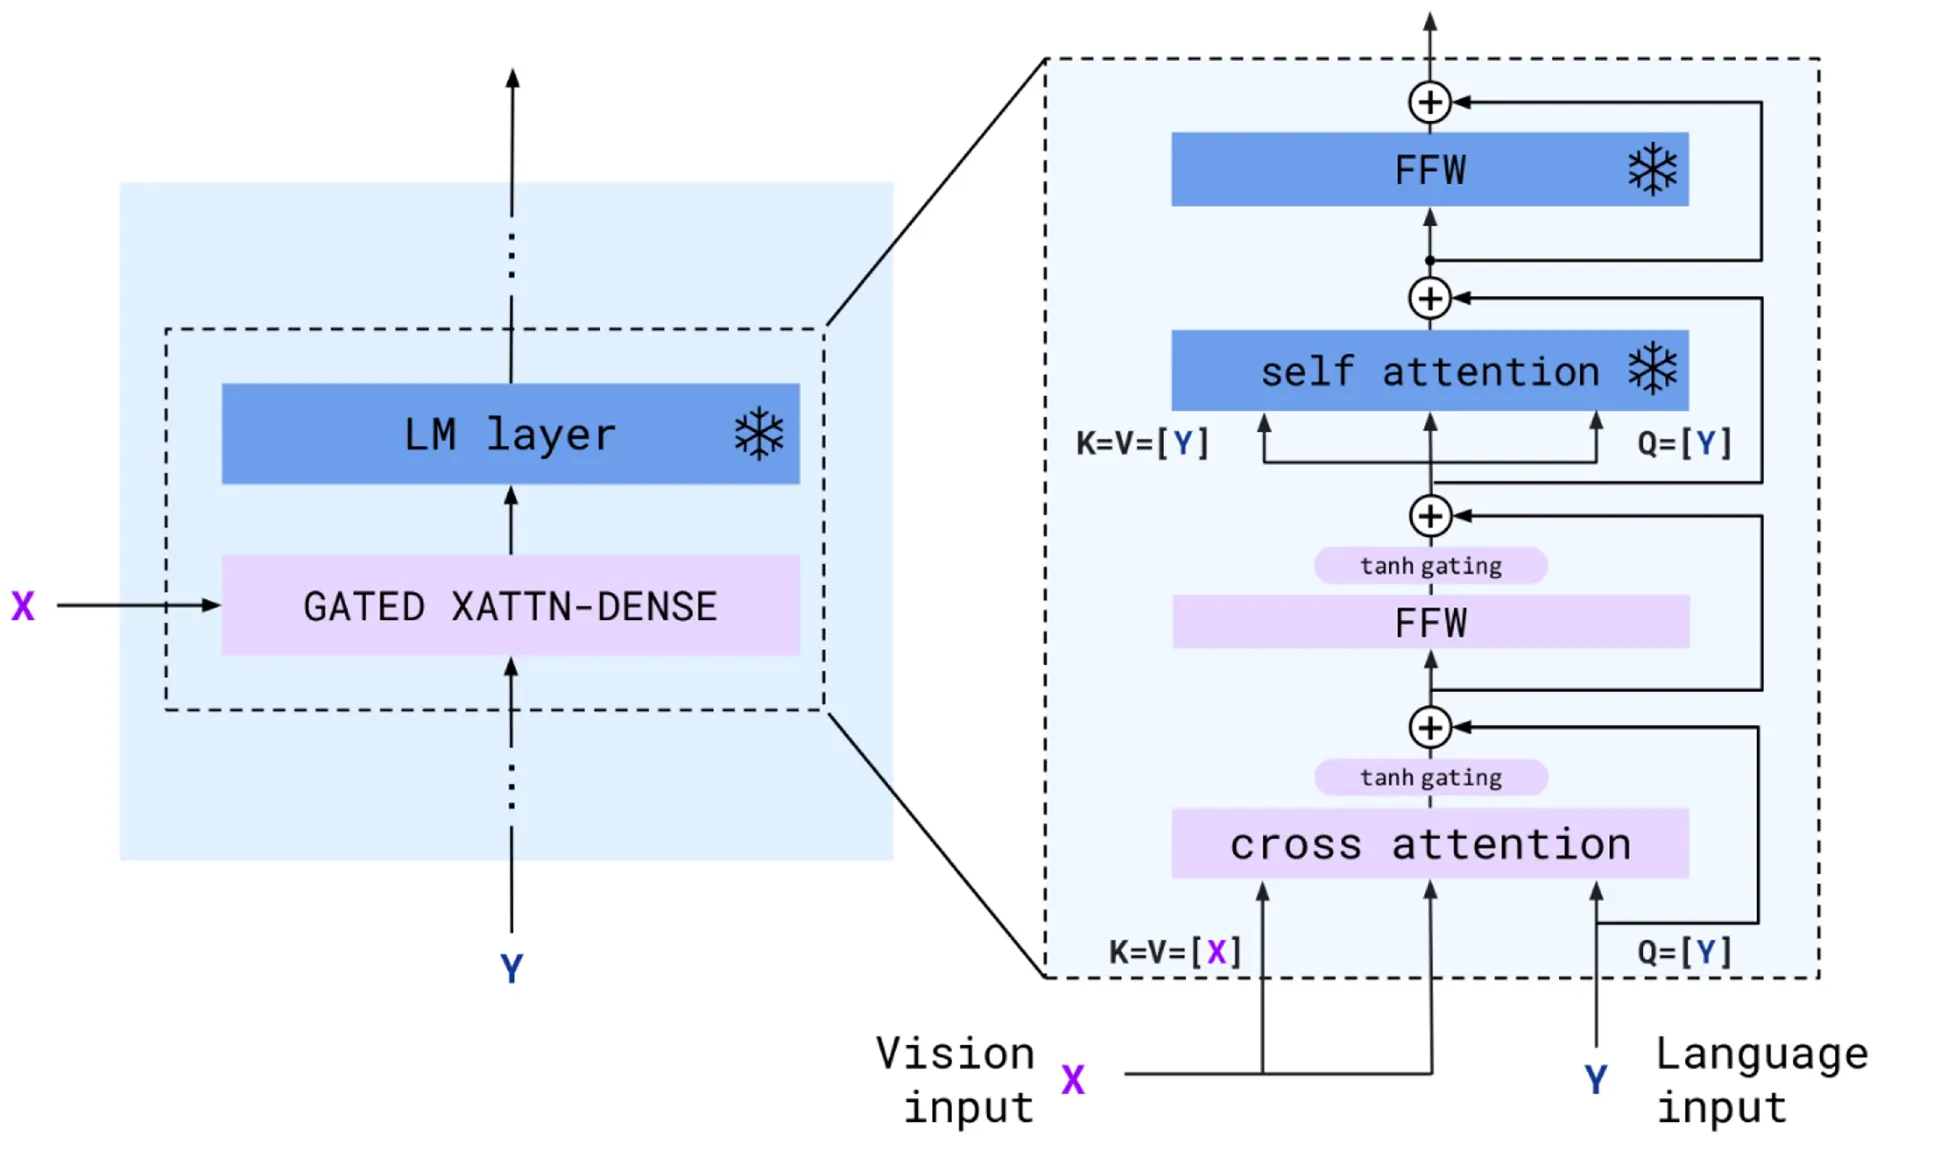
Flamingo는 pretrained vision encoder와 language model을 대부분 고정하고 Perceiver Resampler와 새로 삽입한 gated cross-attention block을 학습한다. Residual update를 단순화해 쓰면 다음과 같다.
는 학습 가능한 gate parameter이다. Gate를 0에 가깝게 초기화하면 학습 시작 시 기존 language model의 동작을 거의 유지하면서 시각 정보를 점진적으로 추가할 수 있다.
그림의 는 visual feature, 는 language feature이다. Cross-attention에서는 가 query이고 가 key와 value이다.
%% title: LLaVA와 Flamingo의 Visual-Language Fusion
%% caption: LLaVA는 visual token을 language token sequence에 직접 삽입하고, Flamingo는 visual feature를 resample한 뒤 language model 사이의 gated cross-attention으로 참조한다.
flowchart TB
    subgraph llava["LLaVA: Input Fusion"]
        li["Image"] --> lv["Vision Encoder"]
        lv --> lp["Projector"]
        lp --> lvt["Visual Tokens"]
        lt["Text Tokens"] --> lseq["Combined Token Sequence"]
        lvt --> lseq
        lseq --> llm1["Causal Language Model"]
    end
    subgraph flamingo["Flamingo: Cross-Attention Fusion"]
        fi["Image / Video"] --> fv["Vision Encoder"]
        fv --> pr["Perceiver Resampler"]
        pr --> fixed["Fixed Visual Tokens"]
        ft["Text Tokens"] --> llm2["Language Model Layers"]
        fixed --> cross["Gated Cross-Attention"]
        llm2 --> cross
        cross --> next["Next Language Layers"]
    end
Interleaved image-text training
Flamingo는 이미지와 텍스트가 섞인 긴 sequence를 학습한다.
Image-causal masking을 사용해 텍스트 를 생성할 때 대응하는 현재 이미지와 허용된 이전 맥락만 보도록 한다. 다른 이미지의 feature를 잘못 참조하는 것을 막으면서 multi-image context와 대화 형식을 학습한다.
Cross-attention에서는 각 텍스트 token이 바로 앞 이미지의 visual token만 보게 한다. 더 이전 이미지의 정보는 language self-attention을 통해 전달된다.
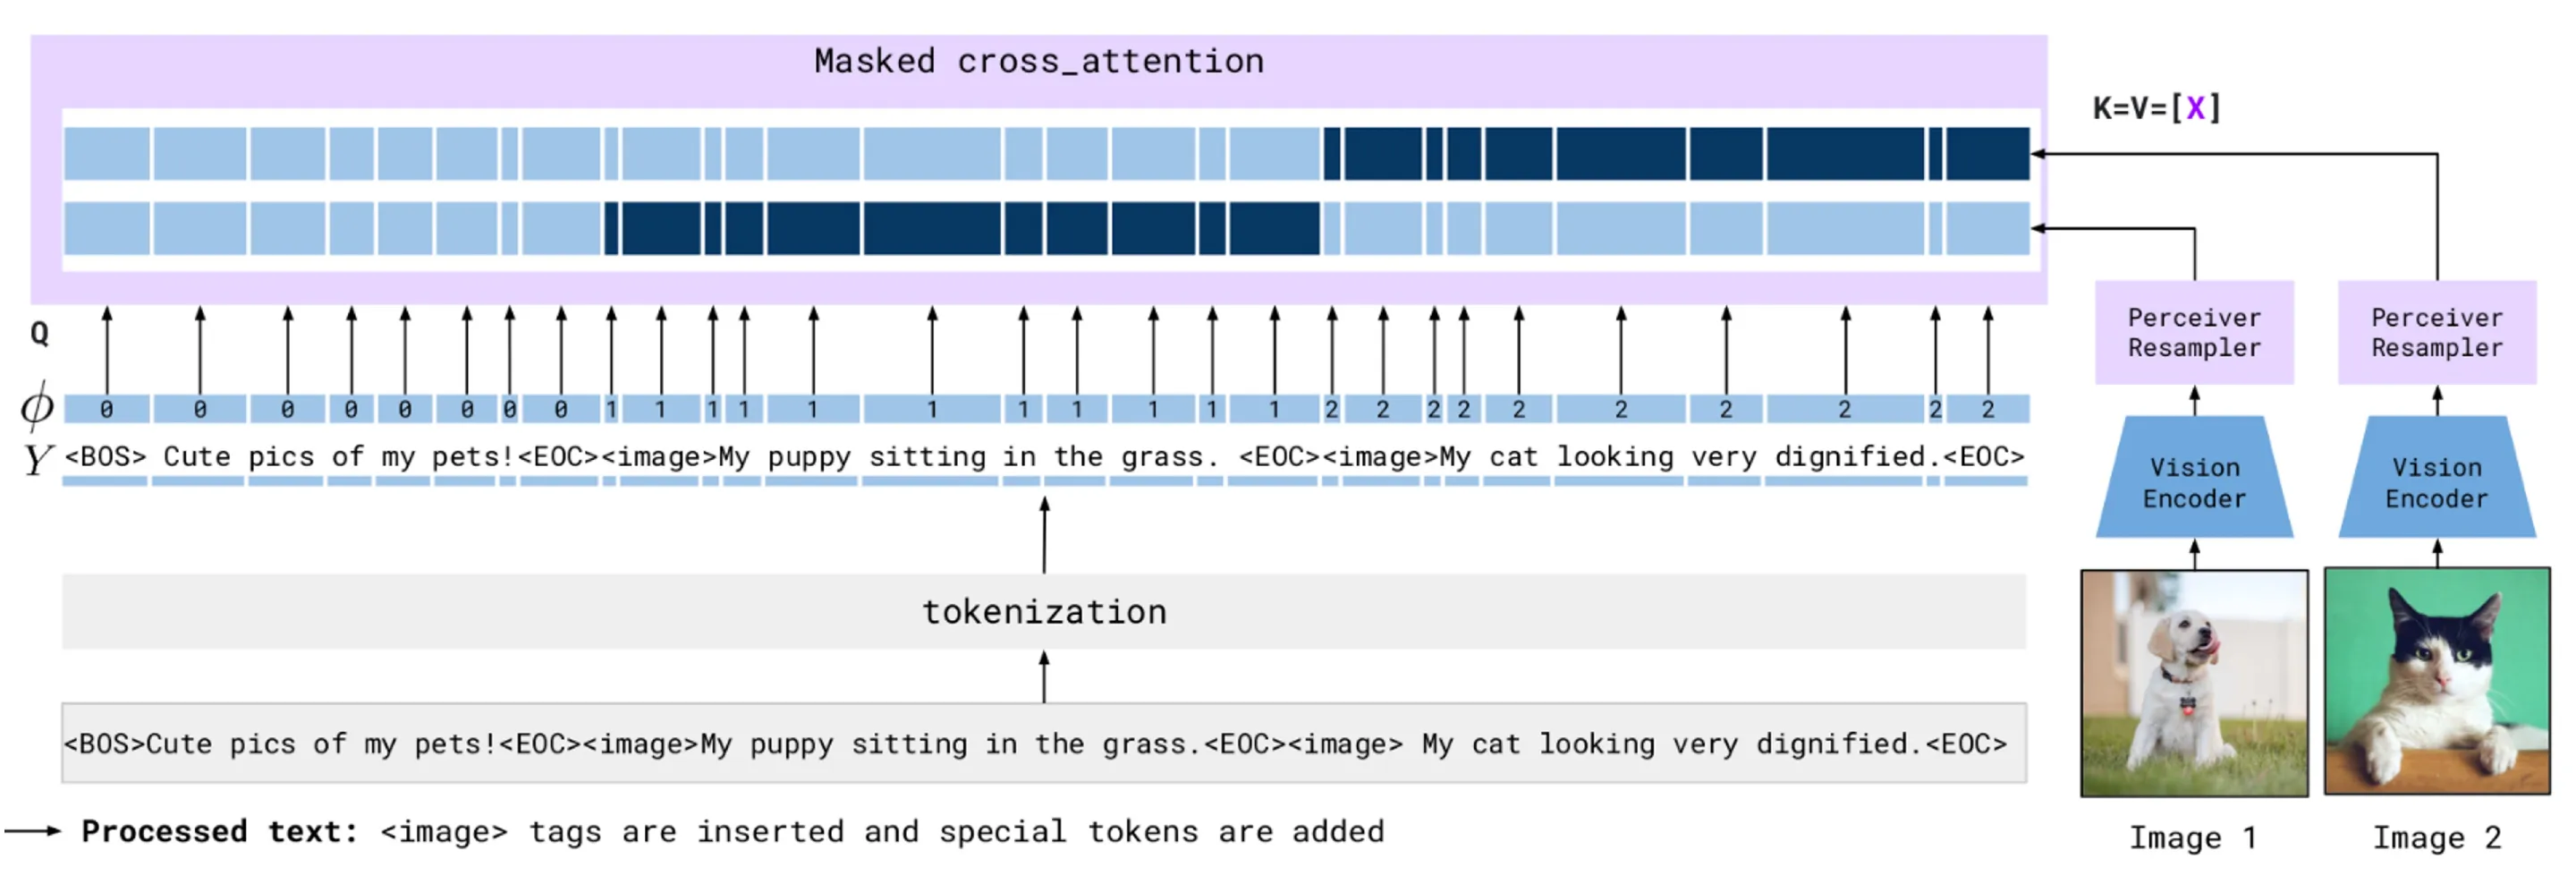
이 방식은 다음 능력으로 이어진다.
- 한 이미지에 대한 multi-turn dialogue
- 여러 이미지의 공통점과 차이 비교
- Image-caption 예시를 보고 새 이미지를 설명하는 in-context learning
- 이미지·질문·답변 예시를 보고 새 VQA 문제에 답하는 few-shot learning
- OCR와 visual arithmetic을 text generation으로 처리
Zero-shot은 과제 예시 없이 instruction만 주는 것이고, few-shot은 같은 context 안에 몇 개의 demonstration을 제공하는 것이다. 둘 다 gradient update 없이 inference context만 바꾼다.
Benchmark만으로 multimodal model을 평가하기 어려운 이유
- 과제 benchmark의 정답률
- 새로운 domain과 compositional example에서의 robustness
- Pixel-level grounding과 근거의 일관성
- Hallucination과 답변을 보류하는 행동
- Human preference와 실제 workflow 성공률
- 모델, 데이터, 코드의 재현 가능성
강의의 Molmo 사례에서는 870명가량의 참여자가 약 32만 5천 쌍별 비교를 수행한 사용자 연구가 소개되었다. 이런 선호도 평가는 정답 하나로 평가하기 어려운 자유 형식 응답을 비교하는 한 방법이다. 다만 선호가 사실관계의 정확성을 자동으로 보장하지는 않는다.
Data quantity보다 빠져 있는 supervision이 중요할 수 있다
웹 caption에는 공간적 관계, 상대적 크기, 재질, 정확한 텍스트, UI 요소의 위치처럼 이미지에 보이지만 글에서는 생략되는 정보가 있다.
강의의 Molmo 사례는 약 70만 개의 dense curated image-text pair로 다음 정보를 직접 수집했다.
- 물체의 위치와 서로의 공간적 관계
- 크기, 형태, 재질, 방향
- 이미지 안의 적힌 텍스트와 숫자
- 점 좌표로 표현한 근거
- 개수 세기와 비교 과정
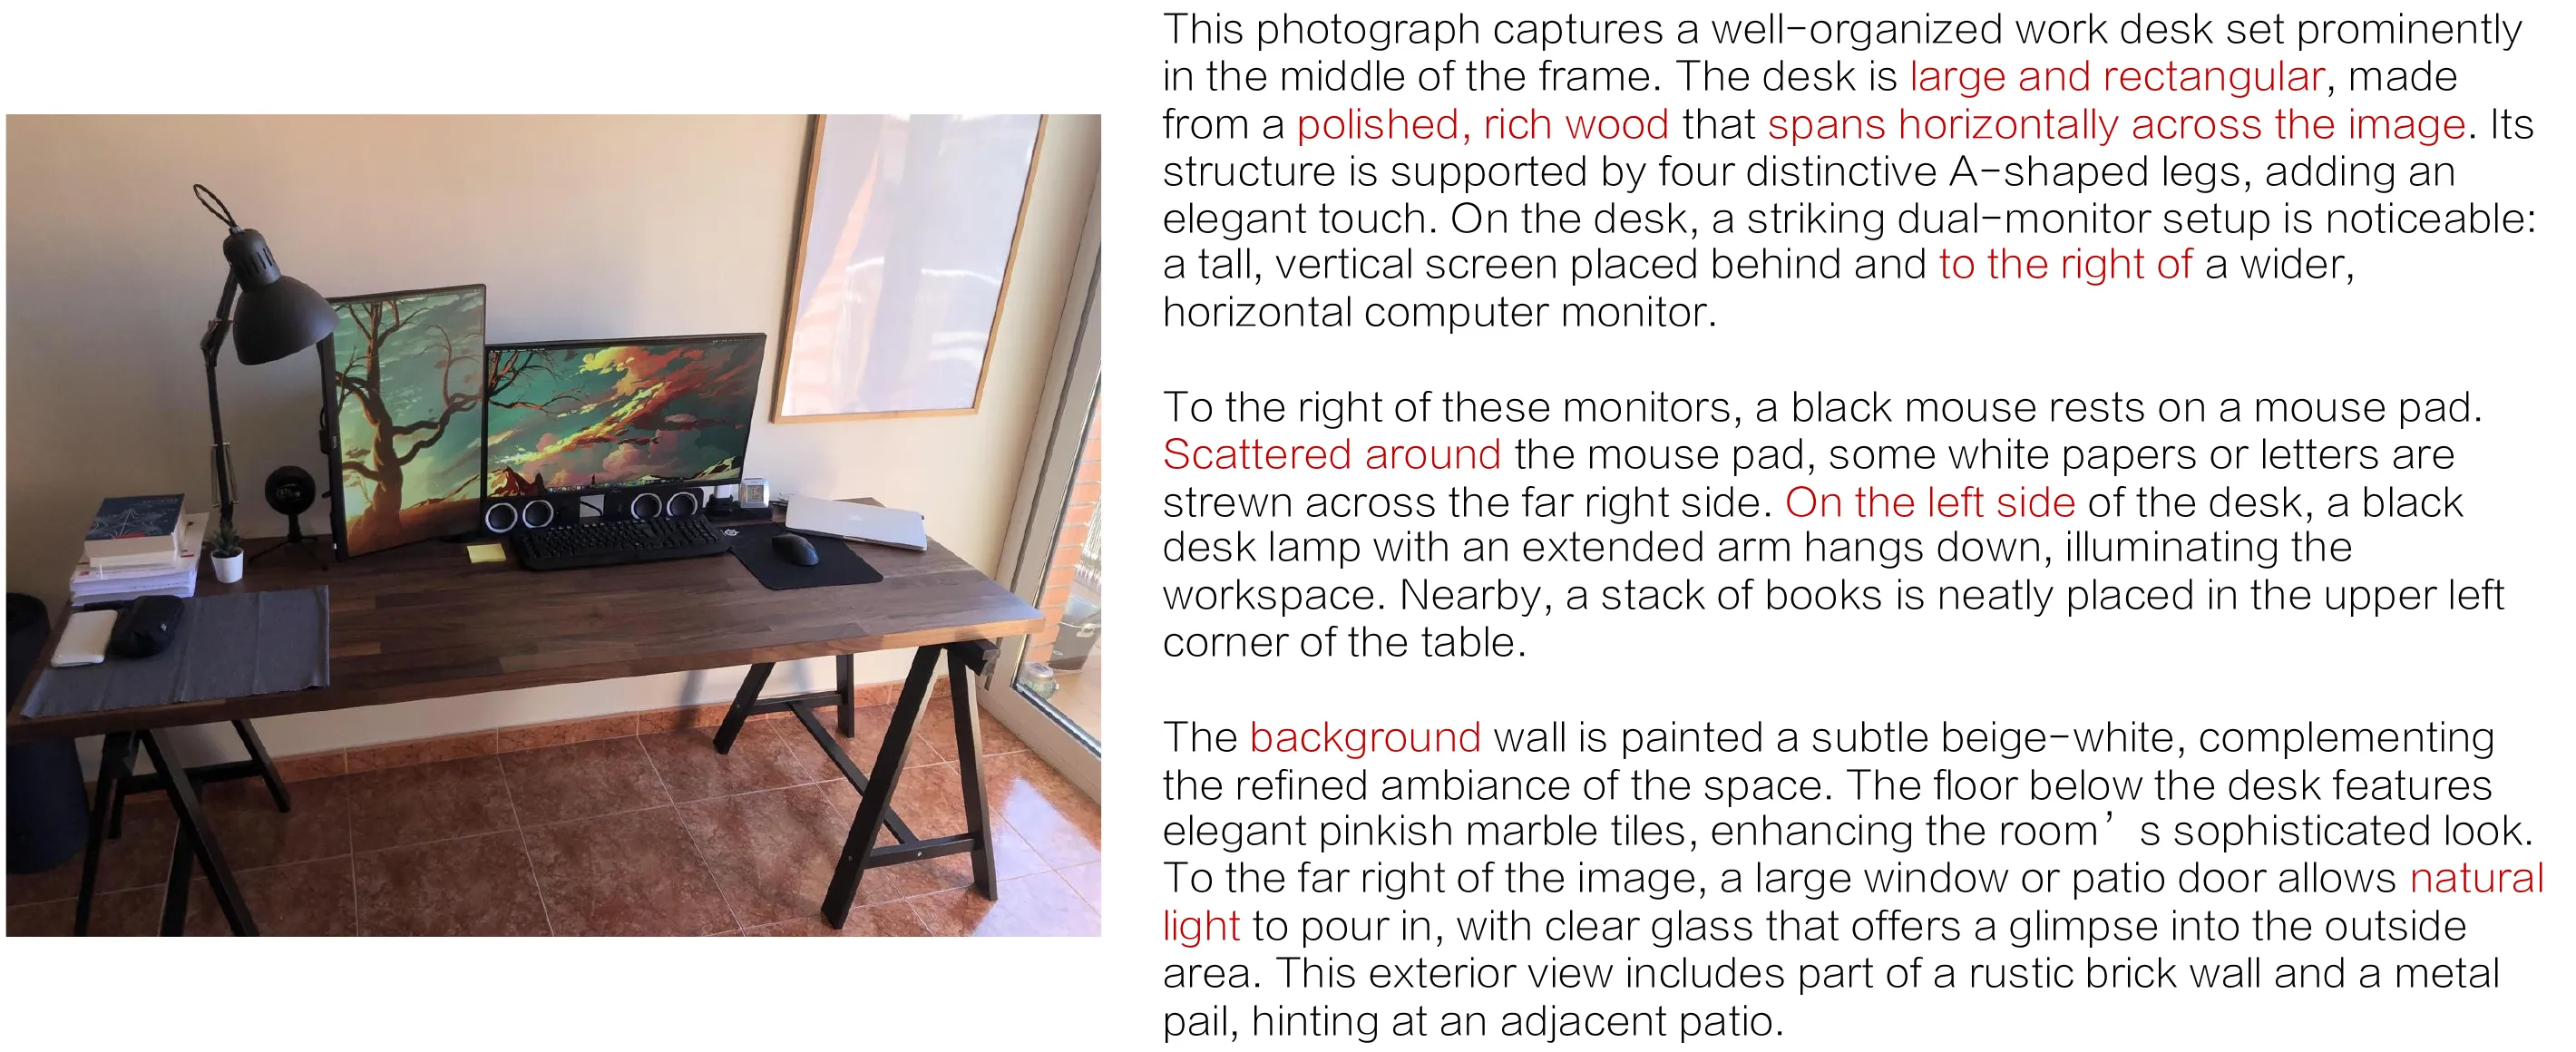
비교 대상으로 언급된 모델은 수십억 개 web pair를 사용했다.
Annotation 작업자는 이미지 설명을 말로 녹음했다. 말로 설명하면 글로 쓸 때 생략하던 공간적 정보를 더 많이 드러낼 수 있다.
Pixel grounding과 pointing
일반적인 multimodal language model은 답변 텍스트만 생성한다. Grounded model은 답변을 만들기 전에 또는 함께 이미지 좌표를 출력한다.
개수를 세는 과제라면 모델은 발견한 물체마다 점을 생성한 뒤 점 수를 답변으로 연결할 수 있다.
Pointing은 다음 장점이 있다.
- 답변이 어떤 픽셀 근거를 사용했는지 사람이 확인할 수 있다.
- 개수를 셀 때 누락과 중복을 발견하기 쉽다.
- OCR이나 UI 질문에서 읽은 위치를 함께 제시할 수 있다.
- 점을 detector, segmenter, 로봇의 planner의 입력으로 전달할 수 있다.
왼쪽은 배마다 점을 생성해 개수를 세고, 오른쪽은 버스의 노선 표시를 읽은 위치를 제시하는 예이다.
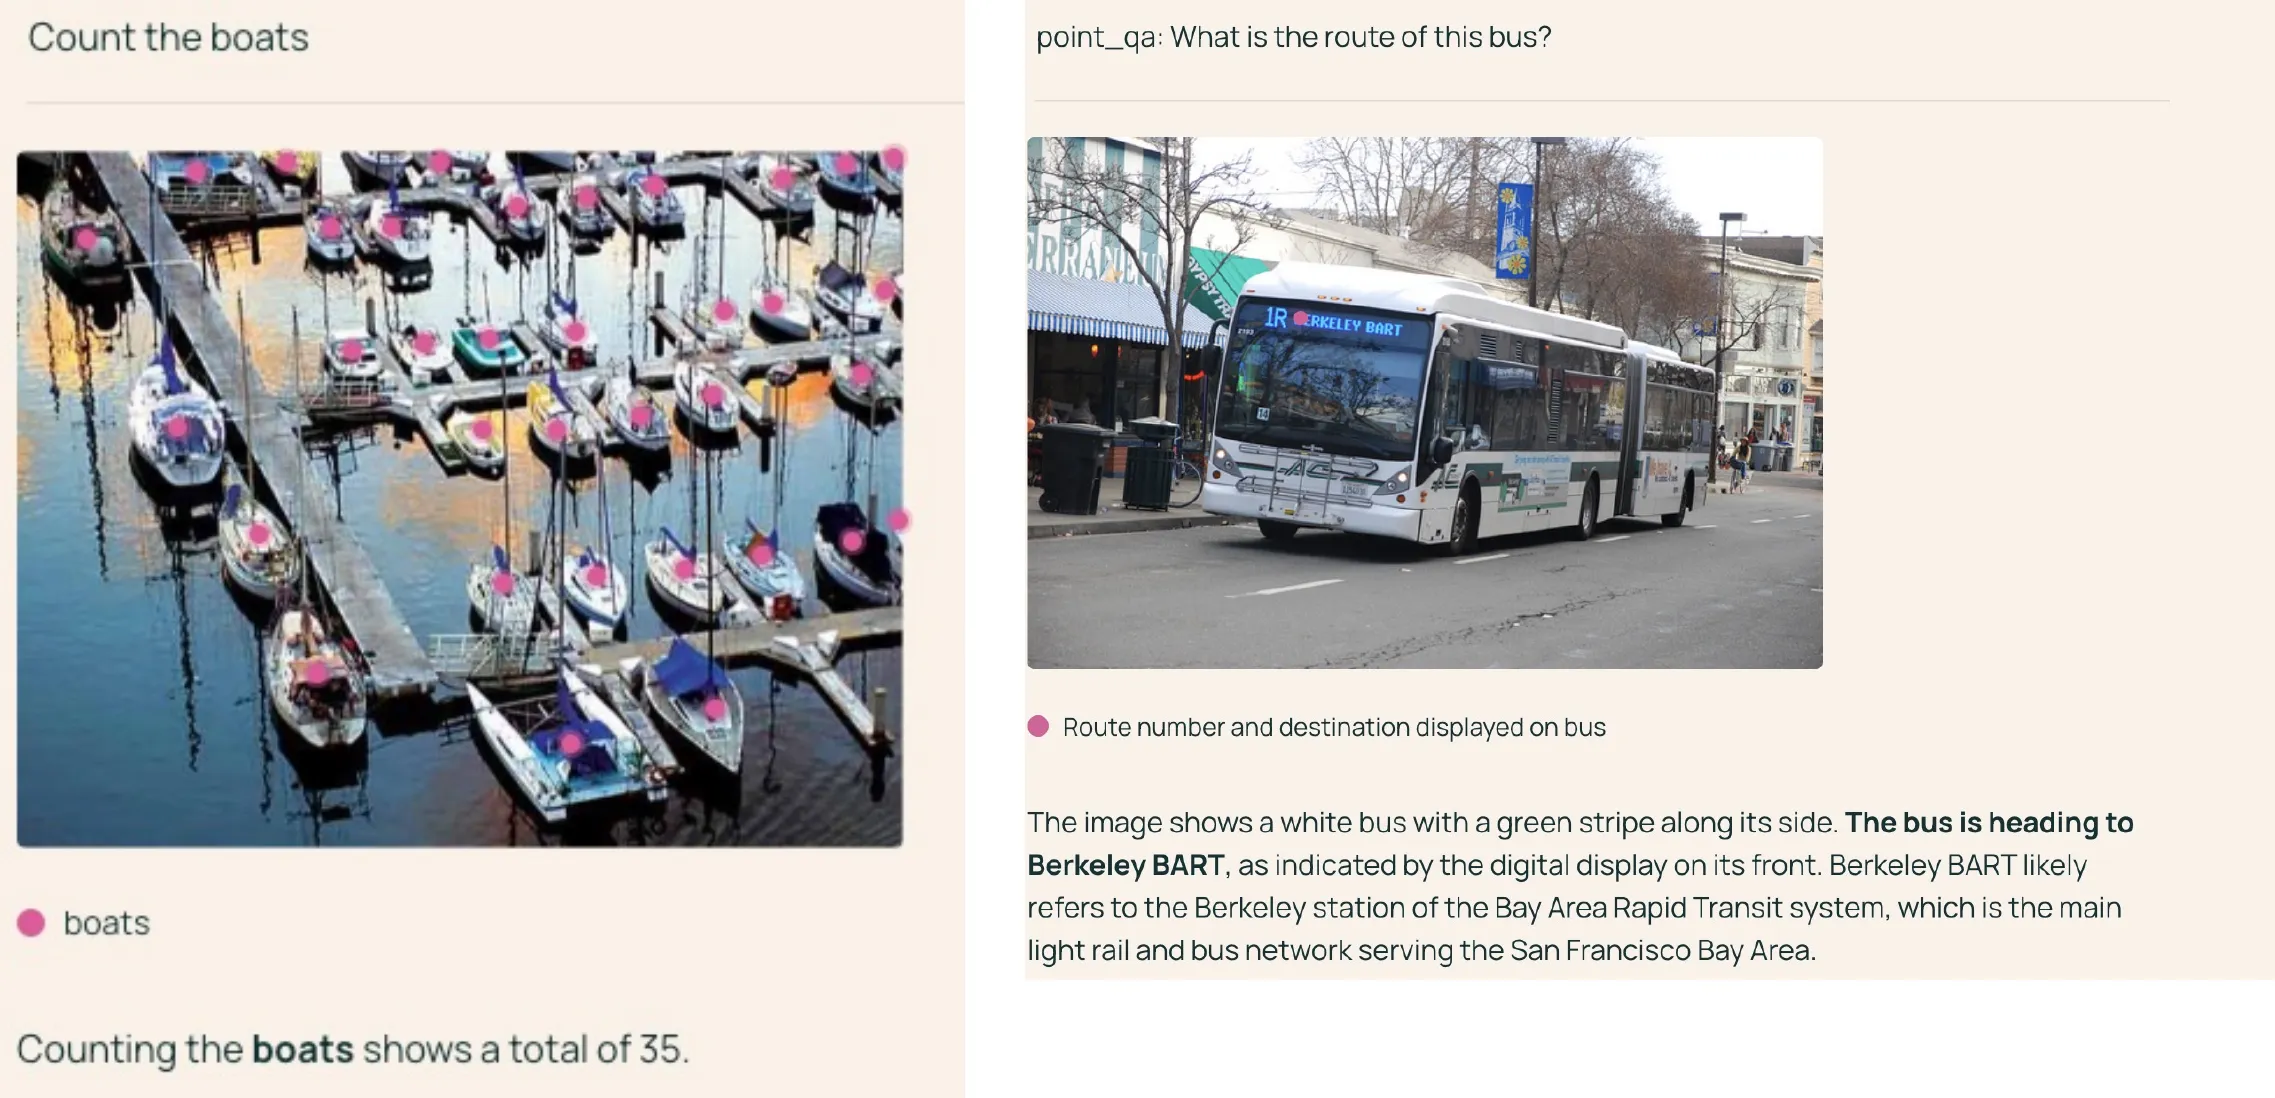
모델이 잘못된 위치를 가리킬 수도 있으므로, 점이 실제 대상 물체와 일치하는지 확인하는 verifier와 uncertainty estimate가 필요하다.
Segment Anything Model
Segment Anything Model, SAM은 범주가 고정된 semantic segmentation 대신 사용자 prompt로 지정한 물체의 mask를 출력한다.
는 이미지이고 는 점, bounding box, mask 같은 spatial prompt이다. 초기 SAM의 native prompt는 점, box, mask이며 text prompt는 별도 text-grounding model이나 확장을 통해 연결한다.
SAM은 세 구성 요소로 나뉜다.
- Image encoder가 image embedding을 계산한다.
- Prompt encoder가 점, box, mask를 embedding한다.
- Lightweight mask decoder가 이미지와 prompt embedding에서 mask를 예측한다.
는 각 mask의 predicted quality score이다. Image embedding을 한 번 계산해 cache하면 여러 prompt에 대해 작은 decoder만 반복 실행할 수 있어 interactive segmentation에 적합하다.
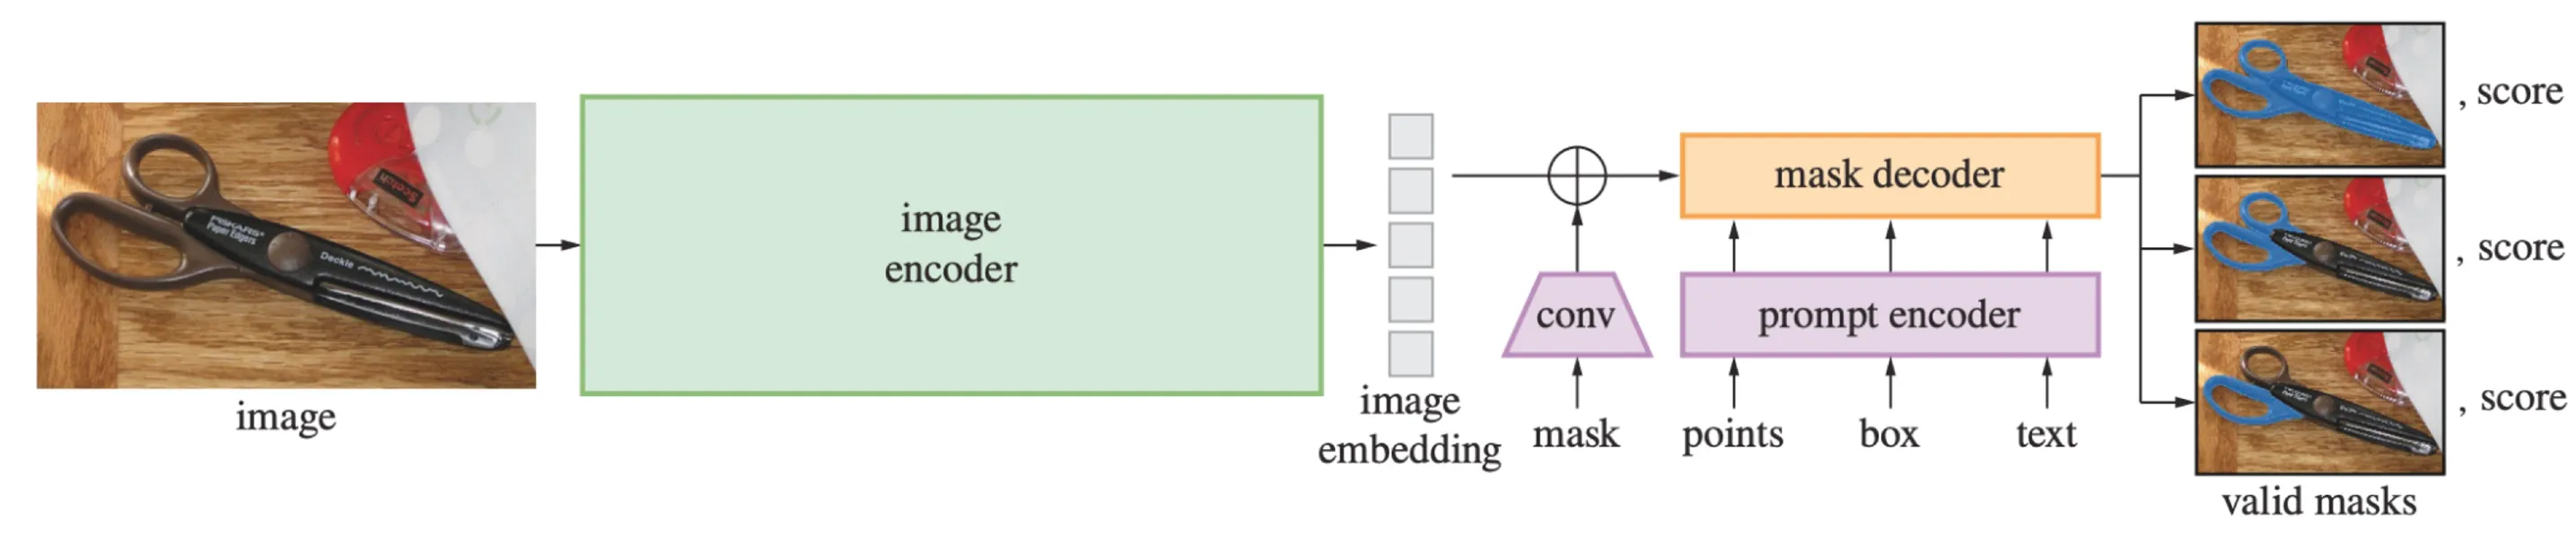
%% title: Segment Anything Model의 Promptable Segmentation
%% caption: Image encoder는 image embedding을 한 번 계산하고, 점·box·mask prompt를 따로 encoding한 뒤 가벼운 mask decoder가 여러 후보 mask와 quality score를 출력한다.
flowchart LR
    image["Image"] --> imageenc["Image Encoder<br/>ViT"]
    imageenc --> embedding["Reusable Image Embedding"]
    point["Point Prompt"] --> promptenc["Prompt Encoder"]
    box["Box Prompt"] --> promptenc
    maskin["Optional Mask Prompt"] --> promptenc
    embedding --> decoder["Lightweight Mask Decoder"]
    promptenc --> decoder
    decoder --> masks["Multiple Candidate Masks"]
    decoder --> quality["Predicted Mask Quality"]
    masks --> select["Select / Refine Mask"]
    quality --> select
Ambiguous prompt와 multiple masks
한 점은 여러 유효한 대상 범위를 가리킬 수 있다. 가위의 손잡이 위 점은 한쪽 손잡이, 손잡이 전체, 가위 전체를 뜻할 수 있다.
SAM은 서로 다른 세분화 수준의 mask 여러 개를 예측해 prompt의 모호성을 반영한다. 강의에서는 세 개의 mask를 출력하는 경우를 설명했다.
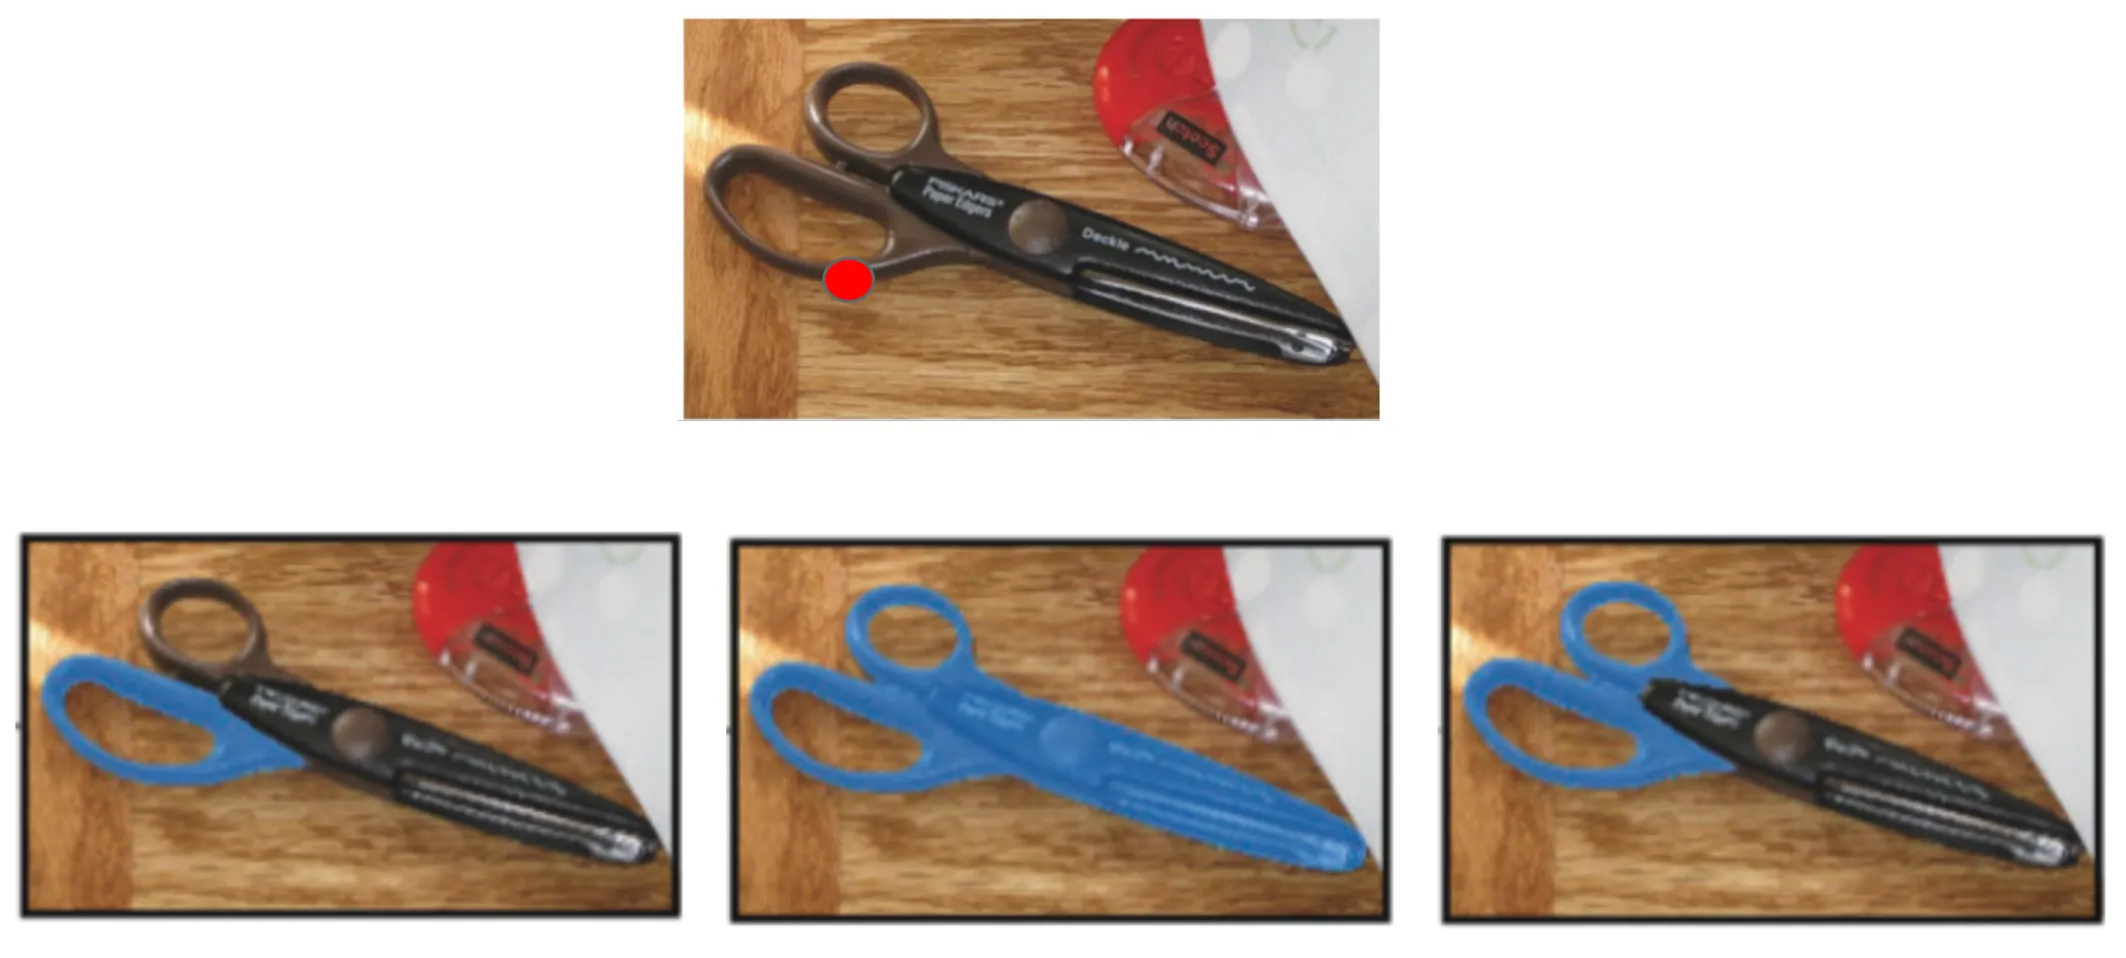
학습에서는 ground-truth mask와 가장 잘 맞는 후보를 선택해 mask loss를 계산할 수 있다.
SAM의 data engine
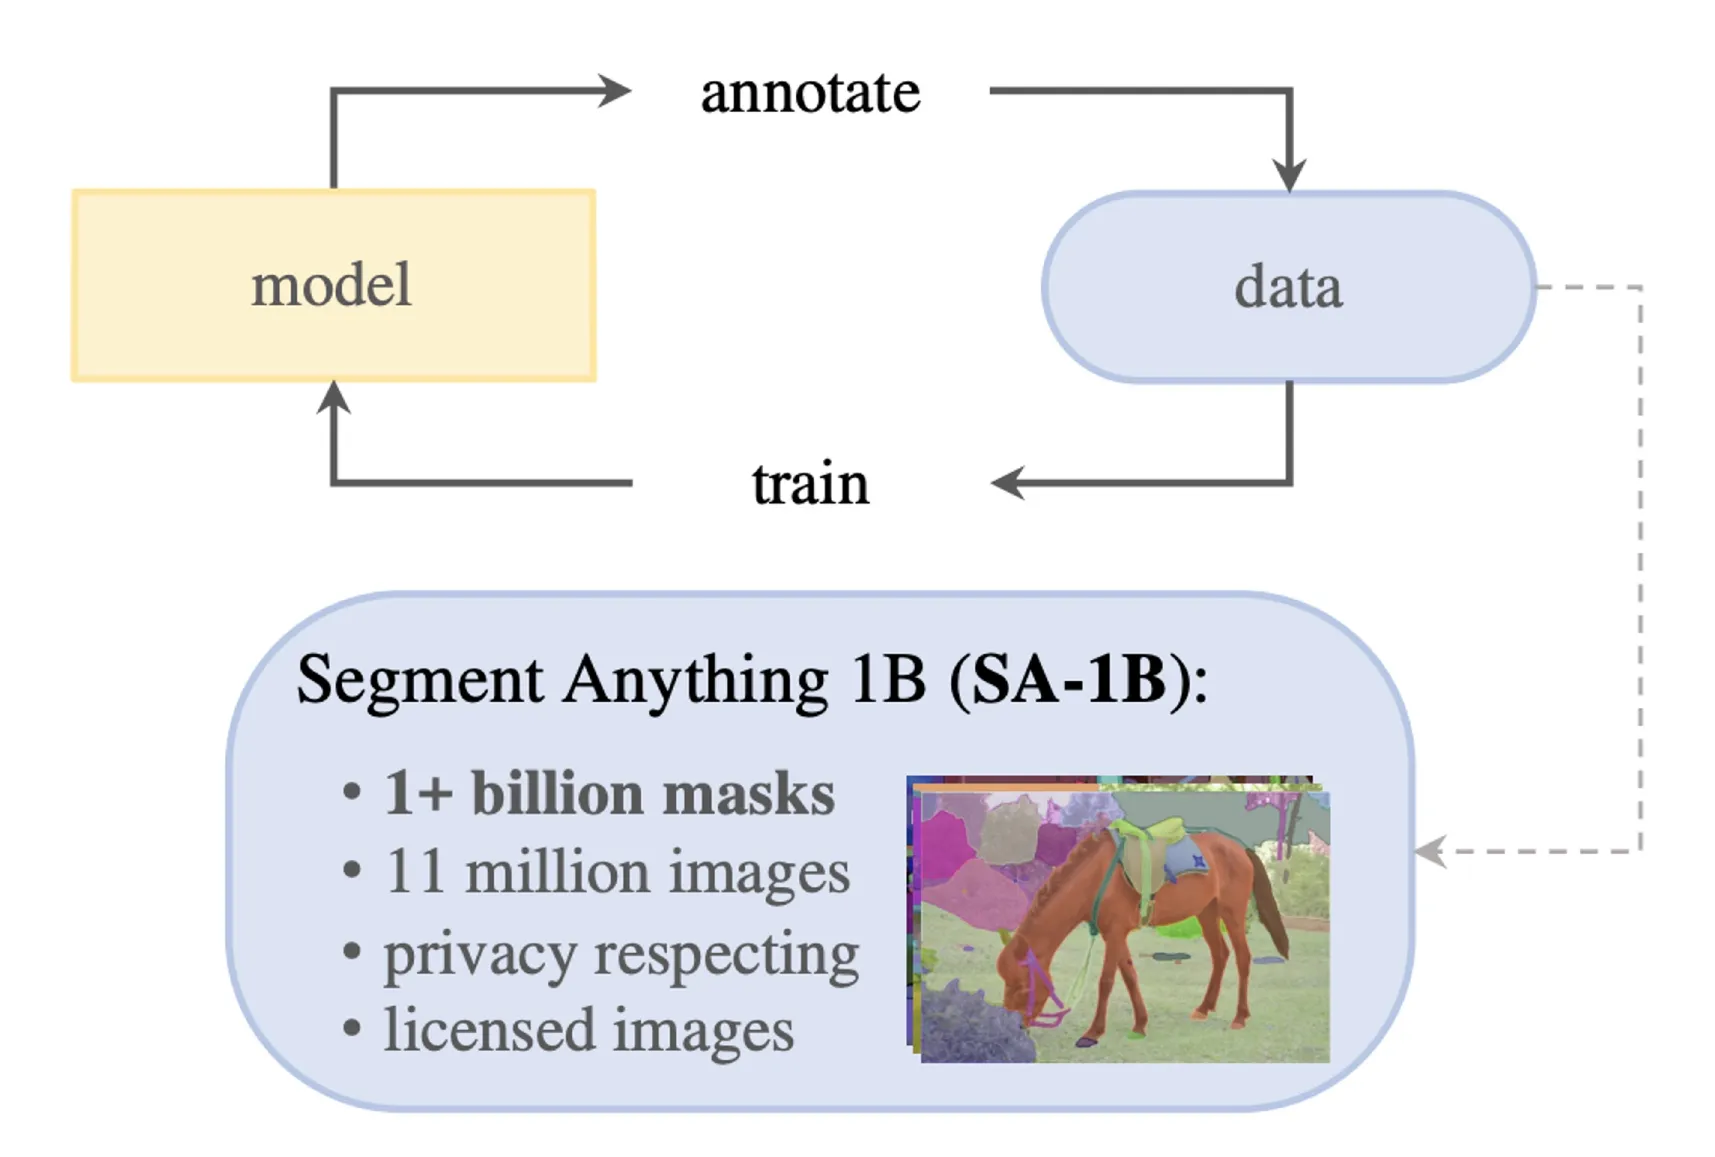
Promptable segmentation이 범주를 넘어 일반화하려면 매우 다양한 mask가 필요하다. 강의에서는 기존 데이터셋과 비교해 이미지 수를 약 6배, mask 수를 약 400배 늘린 데이터 수집을 소개했다.
수집은 사람과 모델을 반복해서 연결하는 data engine으로 이루어진다.
- 사람이 초기 mask를 annotation한다.
- 초기 모델을 학습한다.
- 모델이 새 이미지에 mask 후보를 만든다.
- 사람이 후보를 수정한다.
- 개선된 데이터로 모델을 다시 학습한다.
모델이 정확한 mask 초안을 제시하면 작업자는 윤곽을 처음부터 그리는 대신 오류를 수정할 수 있다. 이 수집 방식의 이득은 mask당 수정 시간과 검수 후 오류율로 확인한다.
Model chaining
Chaining은 한 모델의 출력을 다른 모델의 입력으로 전달하는 방식이다.
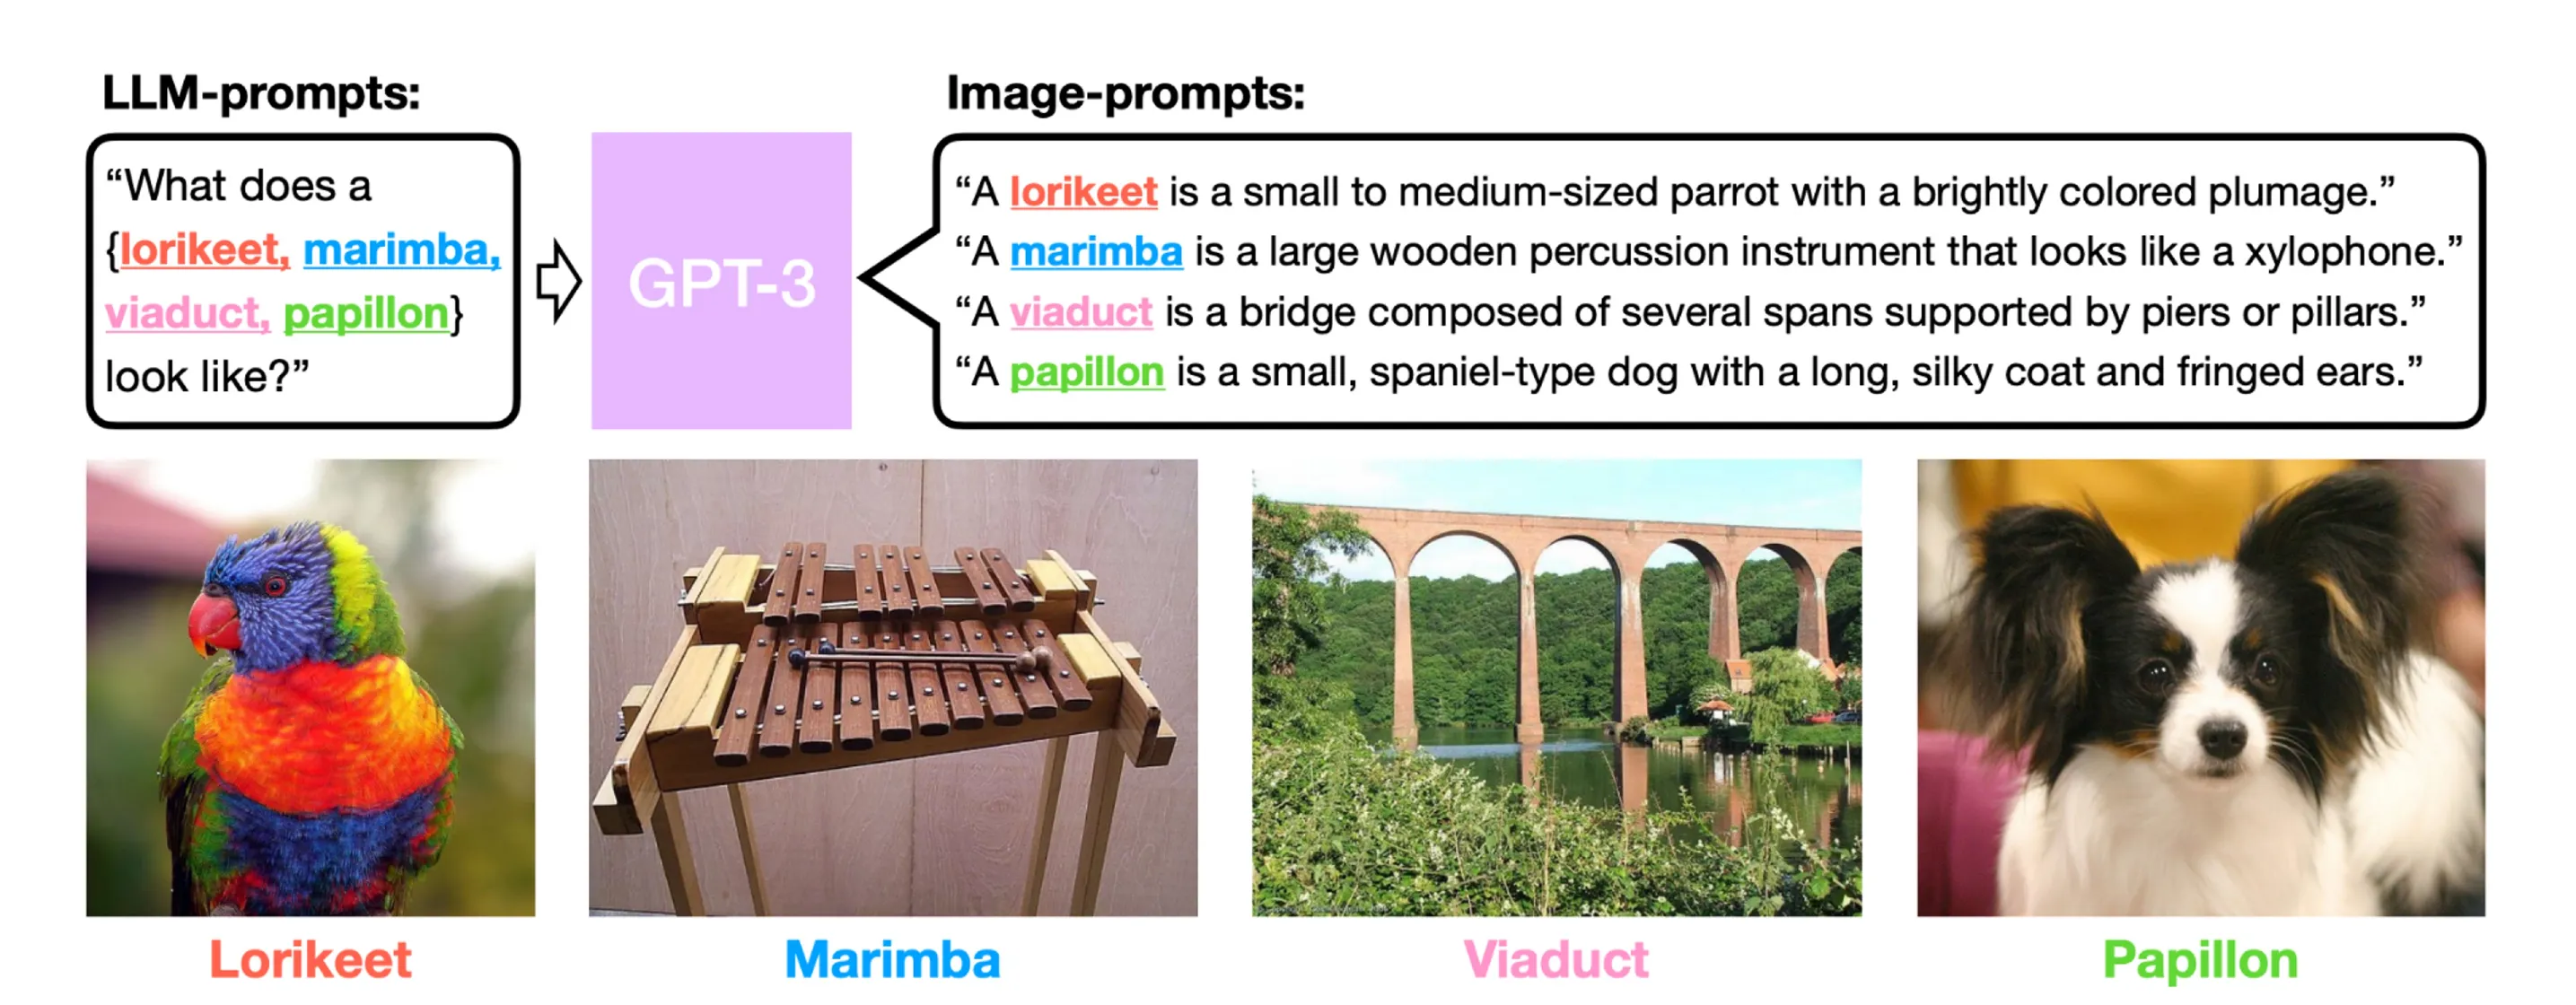
예를 들어 CLIP이 처음 보는 fine-grained class name만으로 분류하기 어렵다면 language model이 각 클래스의 시각적 특징에 대한 설명을 만든 뒤 그 설명을 CLIP prompt로 사용할 수 있다.
클래스 이름보다 형태, 색상, 부위를 설명한 prompt가 image embedding과 더 잘 정렬될 수 있다.
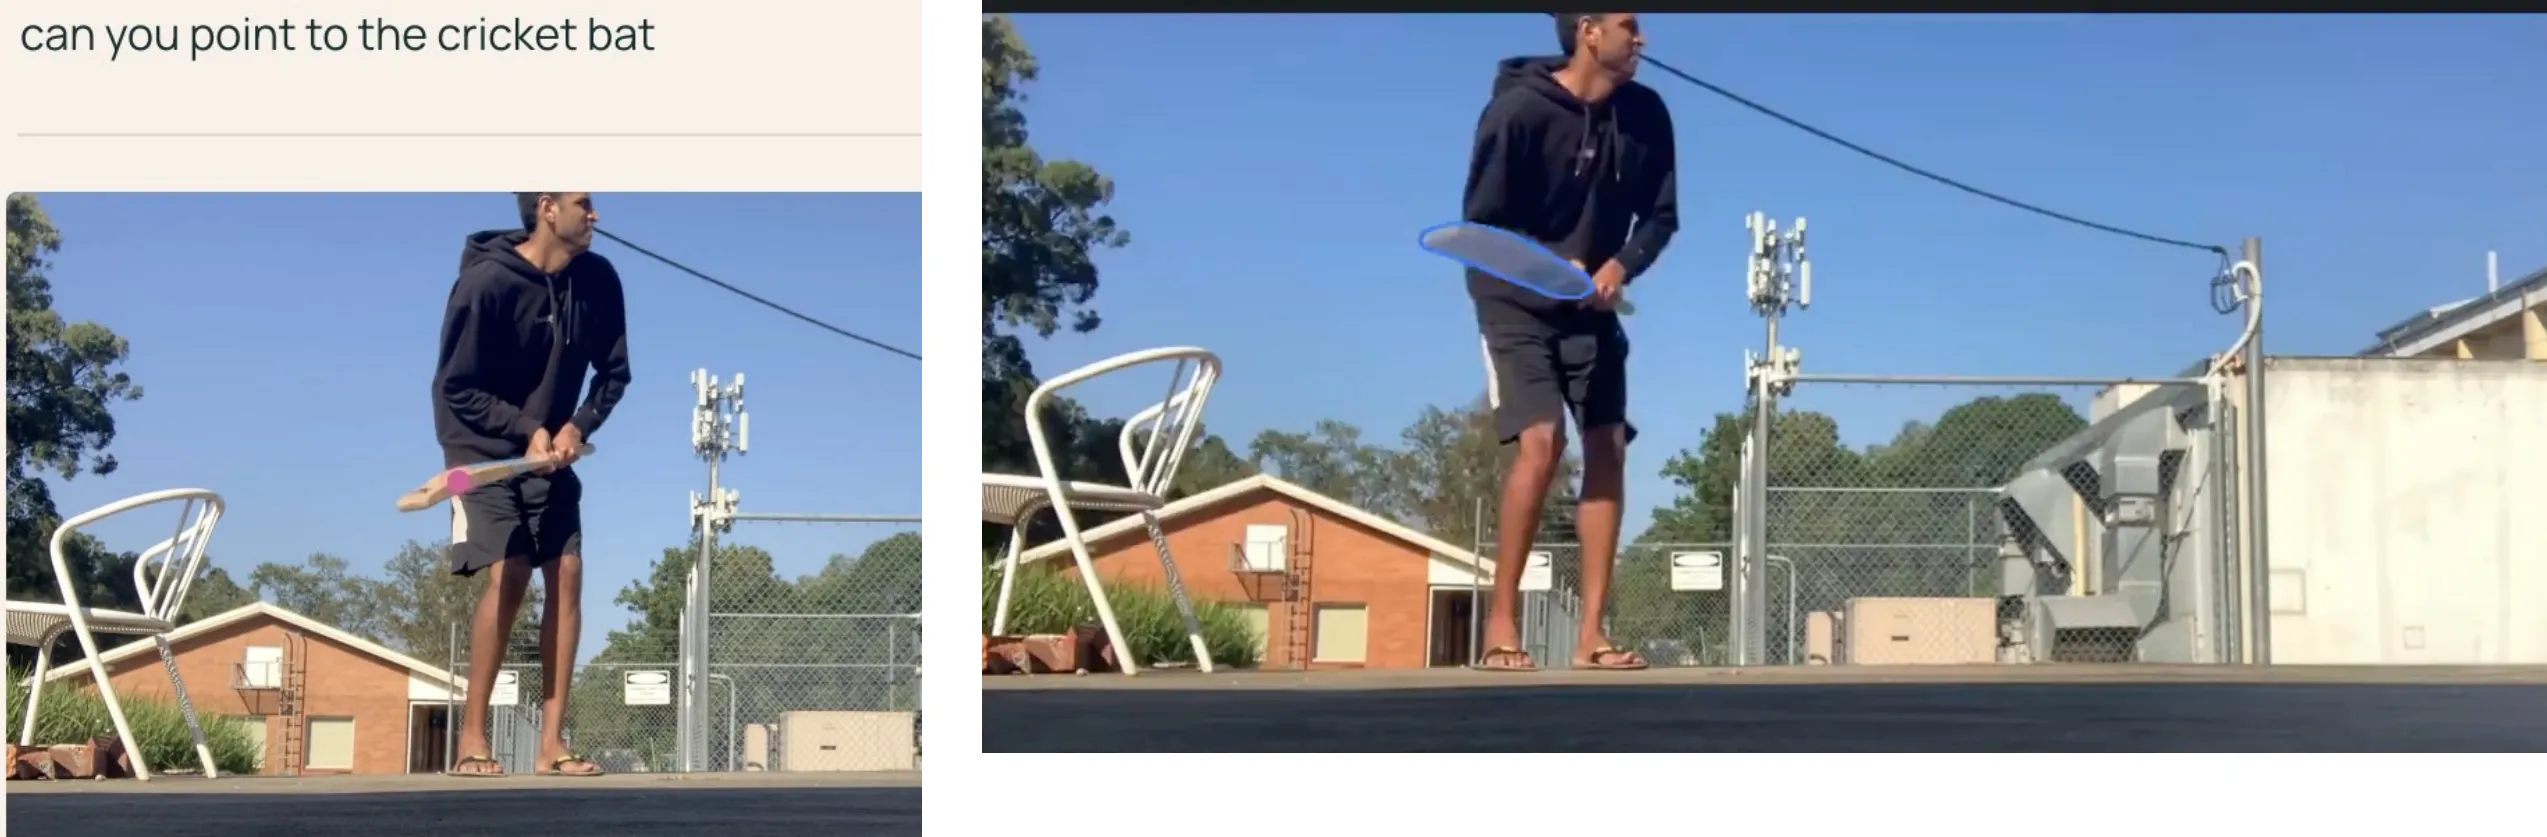
다른 예로 grounded language model이 크리켓 방망이의 점을 출력하고 SAM 2가 그 점에서 비디오 mask를 추적할 수 있다.
로봇에서는 language model이 출력한 점을 motion planner의 목표로 전달할 수 있다.
%% title: Vision Model Chaining을 사용한 구성
%% caption: Language model이 detector·segmenter·vision model을 호출하고, box·mask·분석 결과를 모아 답변이나 action을 만든다.
flowchart LR
    request["Language Request"] --> planner["LLM Planner / Agent"]
    image["Image"] --> detect["Open-Vocabulary Detector"]
    detect --> boxes["Named Boxes"]
    boxes --> segment["SAM"]
    image --> segment
    segment --> masks["Object Masks"]
    masks --> crop["Masked Crops / Regions"]
    crop --> vlm["CLIP / VLM / OCR"]
    planner --> detect
    planner --> segment
    planner --> vlm
    vlm --> evidence["Structured Evidence"]
    boxes --> evidence
    masks --> evidence
    evidence --> planner
    planner --> answer["Answer / Program / Action"]
Visual programming과 agent
Visual programming에서는 language model이 질문을 처리할 프로그램을 생성한다. 프로그램은 detector, classifier, segmenter, OCR, 계산 함수를 호출한다.
예를 들어 두 이미지에 있는 사람 수의 합을 묻는다면 다음 순서로 분해할 수 있다.
- 첫 번째 이미지에서 person detector를 실행한다.
- 두 번째 이미지에서 person detector를 실행한다.
- 각 detection 수를 센다.
- 두 값을 더한다.
- 자연어 답변을 만든다.
그림의 프로그램은 각 이미지의 사람·보트 수를 Vqa로 구한 뒤, Eval로 “합계가 사람 6명·보트 2개인가”를 검사한다.
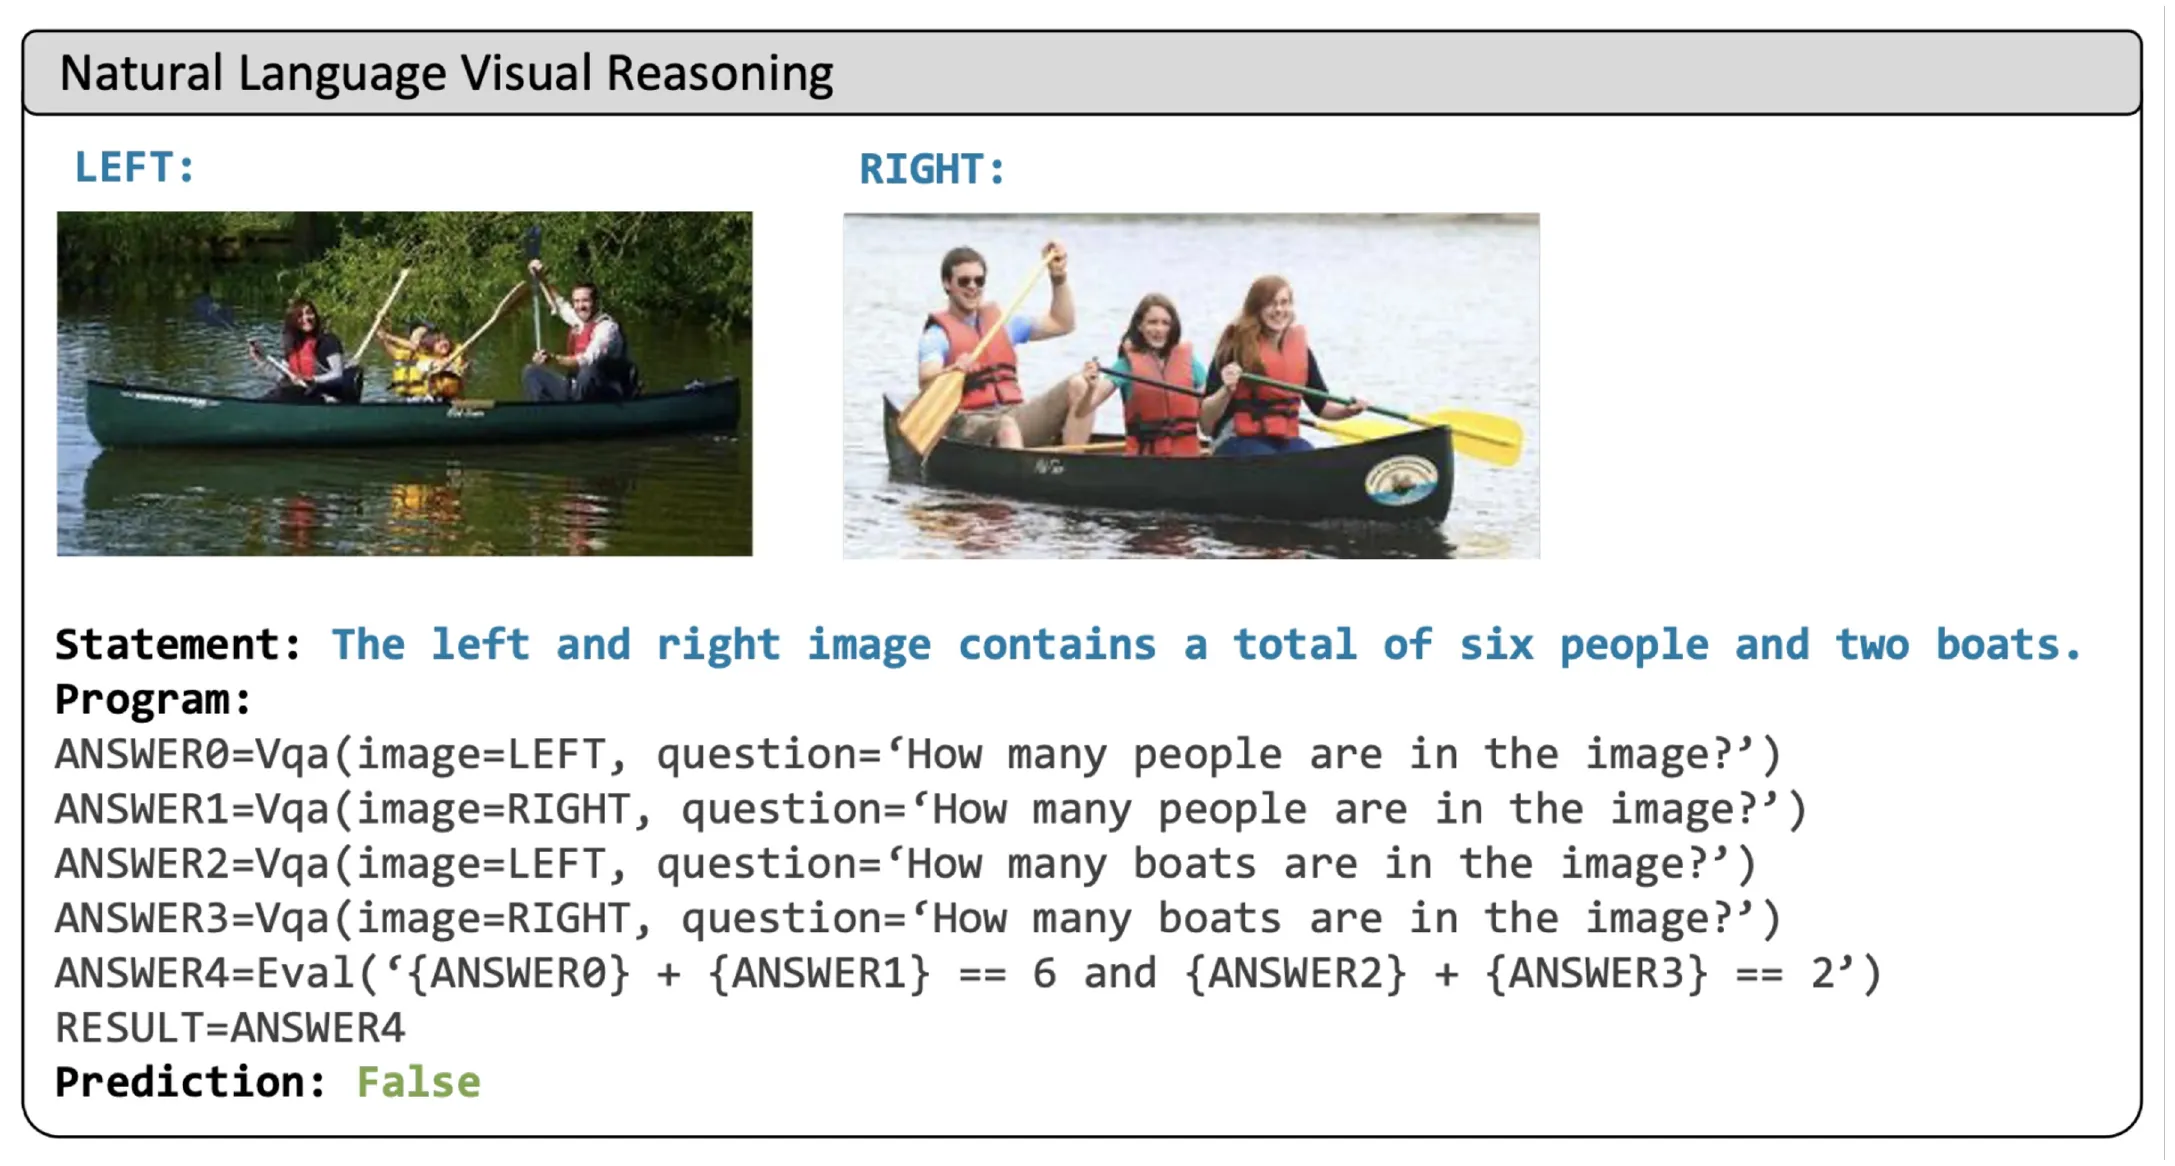
In-context 예시로 질문과 프로그램 쌍을 보여 주면 새로운 질문에서도 비슷한 프로그램을 생성할 수 있다. Dynamic prompting은 현재 질문과 유사한 demonstration을 retrieval해 context에 넣는다.
이 구조는 agent로도 볼 수 있다. Agent는 문제를 분석하고 사용할 도구와 실행 순서를 선택하며 중간 결과를 결합한다.
Chaining의 장점과 비용
- 각 도구의 출력을 검토할 수 있어 debugging이 쉽다.
- Detector나 segmenter를 새 버전으로 교체할 수 있다.
- 학습 데이터가 없는 과제도 프로그램 조합으로 풀 수 있다.
- 명시적인 중간 결과를 verifier로 확인할 수 있다.
반면 다음 비용도 있다.
- 여러 모델을 memory에 올리고 순차 실행하므로 latency와 compute가 커진다.
- 앞 단계의 오차가 뒤 단계로 전파된다.
- 서로 다른 좌표, label, confidence 형식을 맞춰야 한다.
- Language model이 잘못된 도구나 인자를 선택할 수 있다.
- API 모델에 의존하면 재현 가능성과 개인정보 보호 문제가 생길 수 있다.
자주 사용하는 chain을 하나의 모델로 distillation하면 추론 비용을 낮출 수 있지만 modularity와 interpretability 일부를 잃을 수 있다.
Hallucination을 줄이는 방법
Multimodal model의 유창한 답변은 visual evidence와 일치하지 않을 수 있다. 강의에서 제시한 대응 방향은 다음과 같다.
- 목표로 하는 reasoning과 grounding을 포함한 고품질 데이터를 수집한다.
- 답변과 함께 점, box, mask 같은 근거를 생성한다.
- Detector, OCR, retrieval 같은 전문 도구로 사실을 확인한다.
- 별도의 verifier가 답변과 근거의 일관성을 검사한다.
- Confidence가 낮을 때 답을 보류하거나 추가 관측을 요청한다.
전체 흐름 정리
- CLIP은 이미지와 텍스트를 shared embedding space에 정렬해 open-vocabulary retrieval과 classification을 가능하게 했다.
- CoCa는 contrastive loss와 captioning loss를 함께 사용해 이미지와 텍스트를 학습했다.
- LLaVA는 visual patch token을 projector로 language model 입력에 연결했다.
- Flamingo는 fixed visual token과 gated cross-attention으로 이미지를 language model 여러 layer에 주입하고 interleaved context를 학습했다.
- Molmo 사례는 위치·공간 관계·이미지 속 텍스트와 점 좌표를 annotation으로 수집해, web caption에 드문 supervision을 직접 제공했다.
- SAM은 spatial prompt로 지정한 대상의 mask를 출력한다.
- Chaining은 language model, grounding model, detector, segmenter를 프로그램으로 묶어 새로운 능력을 구성했다.
과제에서 확인할 것
CLIP similarity matrix
Batch의 image embedding 와 text embedding 를 normalize한 뒤 의 shape가 인지 확인한다. Row-wise cross entropy와 column-wise cross entropy가 각각 image-to-text, text-to-image 손실이 되는 이유를 본다.
In-batch negative
Positive pair는 similarity matrix의 diagonal이고 나머지는 negative이다. Batch size와 데이터 샘플링 방식이 hard negative의 종류를 어떻게 바꾸는지 확인한다.
Zero-shot prompt classifier
클래스마다 여러 prompt embedding을 normalize하고 평균낸 뒤 다시 normalize하는 순서를 확인한다. Class prototype과 image embedding의 cosine similarity가 linear classifier logit처럼 사용되는 과정도 본다.
CLIP patch token
CLS token과 patch token의 shape와 역할을 구분한다. Global contrastive loss가 patch token에 간접 gradient를 주지만 patch-level text alignment를 직접 감독하지는 않는다는 점을 확인한다.
LLaVA projector shape
Vision feature의 dimension 와 language embedding dimension 이 다를 때 projector 가 필요한 이유를 확인한다. Visual token 수가 language model context length와 self-attention 비용에 미치는 영향도 계산한다.
LLaVA와 Flamingo의 fusion 비교
Visual token을 input sequence에 직접 붙이는 방식과 language layer마다 cross-attention을 삽입하는 방식의 차이를 비교한다. Frozen backbone을 유지할 때 학습되는 parameter가 무엇인지도 구분한다.
Grounding 검증
개수 세기 답변과 점 개수를 비교하고, 각 점이 실제 대상 물체 위에 있는지 확인한다. 텍스트 답변, 점으로 표시한 근거, detector 출력 사이 일관성을 검사하는 verifier를 생각해 본다.
SAM의 ambiguous mask
점 하나가 물체 전체와 part를 동시에 가리킬 수 있는 예시를 만들고, 여러 후보 mask 중 ground truth와 가장 가까운 mask에 손실을 주는 이유를 확인한다.
Chaining의 failure propagation
Language model이 만든 계획, detector의 결과, counting logic 중 어느 단계에서 오차가 발생했는지 중간 출력으로 추적한다. End-to-end model과 비교해 modular chain이 얻는 interpretability와 추가 latency의 trade-off를 정리한다.