
Google 공식 원문: Deep neural network models, Softmax training
이전 글의 matrix factorization은 사용자와 item마다 하나의 embedding을 학습하고, 두 embedding의 내적으로 선호도를 예측했다. 단순하고 대규모 corpus에도 잘 확장되지만 다음과 같은 한계가 있다.
- user ID와 item ID 이외의 side feature를 모델에 넣기 어렵다.
- 학습 데이터에 없던 새로운 user나 item을 바로 처리하기 어렵다.
- dot product를 그대로 사용하면 norm이 큰 인기 item이 많은 사용자에게 반복해서 추천되기 쉽다.
- 사용자의 현재 문맥이나 구체적인 관심사를 세밀하게 반영하기 어렵다.
Deep neural network(DNN)는 입력층을 자유롭게 구성할 수 있으므로 사용자의 시청 이력, 국가, 시간대와 같은 여러 feature를 함께 사용할 수 있다. 이 글에서는 추천 문제를 multiclass classification으로 보는 Softmax DNN, 그 모델에서 얻는 embedding의 의미, 대규모 item 집합을 다루기 위한 negative sampling, item feature까지 활용하는 two-tower model을 차례로 정리한다.
약간의 정보가 있다면 MF처럼 굳이 고정된 id임베딩 말고 인코더로 유저 정보 벡터를 그때그때 만들어 낸다는 것
Softmax DNN으로 추천 문제 표현하기
문제 설정과 기호
item corpus의 크기를 , embedding 차원을 라고 하자. 하나의 query에 대해 Softmax DNN은 다음과 같이 동작한다.
- 사용자 정보와 현재 context를 나타내는 feature vector 를 입력받는다.
- DNN이 를 차원 query embedding 로 변환한다.
- 각 item과의 score를 계산한다.
- softmax를 적용해 개 item에 대한 확률분포 를 출력한다.
즉 입력은 하나의 query이고, 출력은 corpus의 각 item과 상호작용할 확률이다. YouTube를 예로 들면 는 현재 사용자가 영상 를 클릭하거나 시청할 확률로 해석할 수 있다.
이 글에서 사용하는 기호는 다음과 같다.
| 기호 | 의미 | 크기 |
|---|---|---|
| query를 표현하는 입력 feature vector | 입력 feature 수에 따라 달라짐 | |
| 마지막 hidden layer의 출력이자 query embedding | ||
| softmax 출력층의 weight matrix | ||
| item에 대응하는 의 번째 행 | ||
| softmax 적용 전 score인 logits | ||
| 모델이 예측한 item 확률분포 | ||
| 실제 상호작용을 나타내는 정답 분포 |
입력: dense feature와 sparse feature
DNN의 입력 에는 서로 다른 표현 방식의 feature를 함께 넣을 수 있다.
- dense feature: 시청 시간, 마지막 시청 이후 경과 시간처럼 연속적인 수치로 표현되는 feature이다.
- sparse feature: 시청 이력, 국가, 언어처럼 가능한 값은 많지만 한 query에서 일부 값만 활성화되는 feature이다.
여기서 side feature는 dense와 sparse에 이은 별도의 표현 형식이 아니라, 나이, 국가, 기기, 시간대처럼 query ID나 item ID 이외에서 가져온 추가 정보를 뜻한다. Side feature도 값의 성격에 따라 dense 또는 sparse하게 표현할 수 있다.
범주형 sparse feature는 보통 embedding lookup을 거쳐 dense vector로 바꾼 뒤 다른 수치 feature와 결합한다. matrix factorization은 학습한 ID embedding에 의존하지만, DNN은 이처럼 여러 feature로부터 query representation을 계산할 수 있다는 차이가 있다.
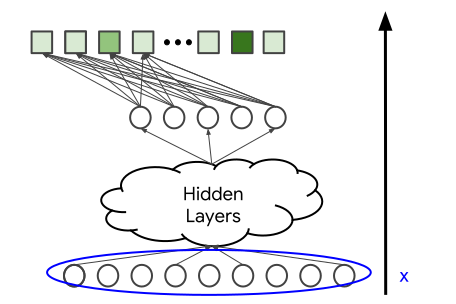
그림 1. user와 문맥을 나타내는 feature vector 가 Softmax DNN의 입력으로 들어간다.
hidden layer와 query embedding
입력 는 여러 hidden layer와 비선형 activation을 통과한다. 마지막 hidden layer의 출력을 다음과 같이 나타낸다.
는 입력 feature를 추천에 사용할 차원 공간으로 보내는 nonlinear mapping이다. hidden layer와 ReLU 같은 비선형 activation을 추가하면 단순한 선형 모델보다 복잡한 feature interaction을 표현할 수 있다. 예를 들어 같은 시청 이력이라도 국가, 시간대, 기기에 따라 다른 query embedding을 만들 수 있다.
다만 layer와 parameter가 많아질수록 표현력과 함께 학습 비용, overfitting 위험, serving latency도 증가한다. 따라서 더 복잡한 구조가 항상 더 좋은 추천을 보장하는 것은 아니다.
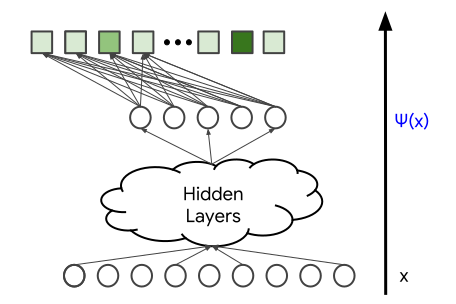
그림 2. 마지막 hidden layer의 출력 가 query embedding 역할을 한다.
Softmax 출력
item 의 logit은 query embedding과 item별 output weight의 내적으로 계산한다.
모든 item의 logit을 한 번에 쓰면 다음과 같다.
이 식에서는 를 row vector로 표기한다. 이므로 두 행렬을 곱하면 item별 logit을 모은 vector 를 얻는다.
softmax 함수 는 logits를 합이 1인 확률분포로 변환한다.
는 item 에 배정된 확률이고, 는 분모에서 corpus의 모든 item을 순회하는 index이다.
따라서 모델의 최종 출력은 다음과 같다.
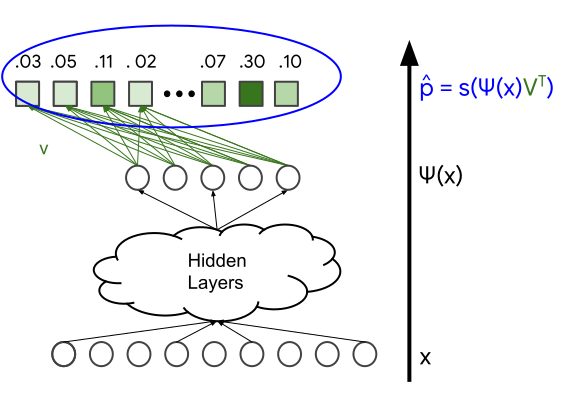
그림 3. 개 item의 logits를 softmax에 통과시키면 예측 확률분포 가 된다.
softmax라는 이름은 hard max와 대비하면 이해하기 쉽다. hard max는 가장 큰 score를 가진 item에 확률 1을 주고 나머지에는 0을 준다. softmax는 score가 큰 item에 더 높은 확률을 주면서도 모든 item에 0보다 큰 확률을 부여한다. logits에 양의 scale 를 곱한 는 가 커질수록 가장 큰 logit에 확률이 집중된다.
최댓값이 하나라고 가정하면 위 극한은 hard max와 같아진다. 반대로 가 작으면 확률분포가 더 평평해진다. 이는 temperature를 사용한 softmax와도 연결되는 직관이다.
정답 분포와 손실함수
정답 는 사용자가 실제로 상호작용한 item을 나타내는 확률분포이다. 하나의 정답 item만 있으면 one-hot vector를 사용할 수 있다. 여러 item과 상호작용했다면 활성화된 위치를 정규화한 multi-hot distribution을 사용할 수 있다.
예를 들어 세 item과 동일한 비중으로 상호작용했다면 각 item에 을 배정하여 이 되게 한다. 모델은 예측 분포 와 정답 분포 사이의 cross-entropy를 최소화한다.
는 item 의 정답 확률이고, 는 모델이 예측한 확률이다. one-hot label에서 실제 item을 라고 하면 손실은 로 단순해진다. 실제 item에 높은 확률을 줄수록 손실이 작아진다.
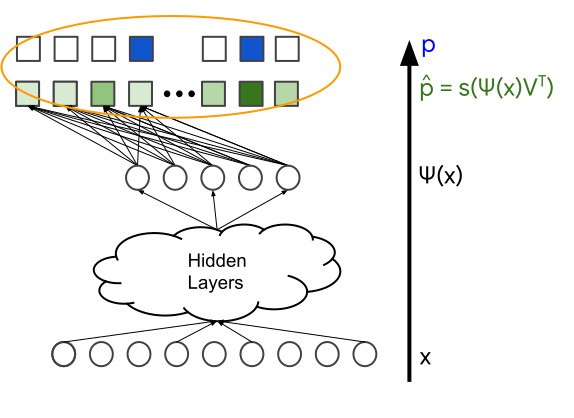
그림 4. 예측 분포 와 정답 분포 를 비교해 손실을 계산한다.
Softmax weight를 embedding으로 해석하기
softmax 식에서 item 의 확률을 따로 쓰면 다음과 같다.
정규화 상수 는 모든 item의 지수화된 score를 더한 값이다.
하나의 query 가 고정되면 는 item 에 따라 달라지지 않는다. 양변에 log를 취하면 다음 관계를 얻는다.
query 가 고정된다는 것은, 지금 이 사용자, 이 상황에 대해 추천한다고 정해 놓고 item만 1번, 2번, 3번, ..으로 바꿔가며 비교한다.
따라서 item의 log probability는 query embedding과 item embedding의 dot product에 query별 상수()를 더한 형태이다.
같은 query안에서는 확률을 직접 비교하거나, dot product를 비교하든 item ranking이 변하지 않는다.
- 는 query 의 embedding이다.
- 는 마지막 hidden layer와 출력 를 연결하는 weight이자 item 의 embedding이다.
는 단조 증가 함수이고 같은 query 안에서는 가 모든 item에 공통으로 적용된다. 그러므로 가 큰 item을 찾는 것과 가 큰 item을 찾는 것은 같은 ranking을 만든다. 이 때문에 dot product를 query와 item 사이의 similarity로 볼 수 있다.
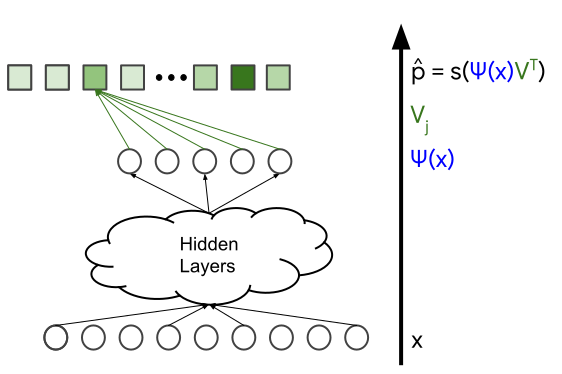
그림 5. 출력층 weight 를 item 의 embedding으로 해석할 수 있다.
Matrix factorization과의 관계
matrix factorization과 Softmax DNN은 모두 item마다 하나의 embedding 를 학습한다. matrix factorization에서의 item embedding matrix 가 Softmax DNN에서는 출력층의 weight matrix가 된다.
query 쪽은 다르게 구성된다.
- Matrix factorization은 query 또는 user 마다 독립적인 embedding 를 직접 학습한다.
- Softmax DNN은 feature vector 를 query embedding 로 바꾸는 함수 자체를 학습한다.
matrix factorization의 score는 다음과 같다.
Softmax DNN의 score는 다음과 같다.
즉 Softmax DNN은 query ID lookup 를 nonlinear mapping 로 일반화한 모델로 이해할 수 있다. 학습에서 보지 못한 user ID이더라도 필요한 feature 를 만들 수 있다면 query embedding을 계산할 수 있으므로 새로운 query에 대응하기 쉽다.
Item feature까지 사용하는 Two-Tower model
Softmax DNN의 는 item 마다 직접 학습되는 embedding parameter이므로, 학습에 없던 새로운 item은 대응하는 임베딩이 없어 바로 다루기 어렵다. 이를 완화하기 위해 query와 마찬가지로 item의 feature를 입력받아 item 임베딩을 계산하는 별도의 encoder를 사용할 수 있다. 이처럼 query와 item을 각각 독립적인 encoder로 embedding한 뒤 두 embedding의 유사도를 계산하는 구조를 two-tower model이라고 한다.
- query tower는 query feature 를 query embedding으로 변환한다.
- item tower는 item feature 을 item embedding으로 변환한다.
여기서 와 는 각각 query tower와 item tower가 학습하는 nonlinear mapping이고, 와 는 두 tower가 출력한 embedding이다.
두 tower의 출력 차원을 같게 만든 뒤 내적을 relevance score로 사용한다.
이 모델은 각 query마다 corpus 전체의 확률분포를 직접 출력하는 softmax 모델과 구조가 다르다. 하나의 쌍을 입력받아 하나의 score를 예측한다. item tower가 metadata나 content feature를 사용하면 학습 시점에 없던 item도 feature로부터 embedding을 만들 수 있다.
two-tower 구조는 serving에도 유리하다. item feature가 자주 바뀌지 않는다면 item embedding을 미리 계산해 vector index에 저장하고, 요청 시에는 query tower만 실행한 뒤 가까운 item embedding을 검색할 수 있다. retrieval 단계가 이 구조와 연결된다.
Softmax DNN 학습
학습 데이터와 parameter
Softmax DNN의 한 학습 예시는 다음 두 요소로 구성된다.
- query feature
- 사용자가 상호작용한 item을 확률분포로 나타낸 정답
모델이 학습하는 parameter는 각 hidden layer의 weight와 bias, 그리고 softmax 직전의 item score를 계산하는 output weight matrix 이다. 일반적으로 mini-batch와 SGD 계열 optimizer를 사용해 cross-entropy를 최소화한다.
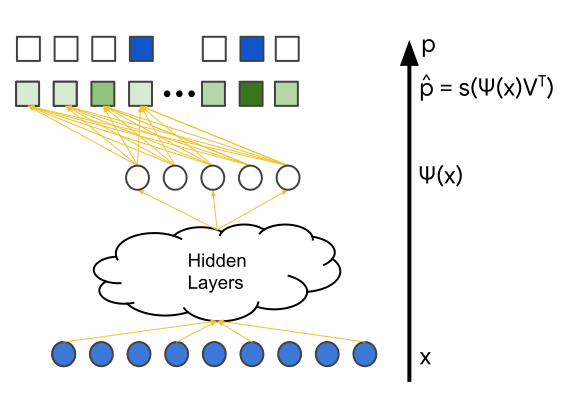
그림 6. 파란색은 학습 데이터인 와 , 주황색은 gradient로 갱신하는 모델 parameter를 나타낸다.
Full softmax의 계산 비용
정답과 예측은 모두 차원 벡터이다.
full softmax는 query 하나를 처리할 때 모든 item의 logit과 정규화 상수 를 계산해야 한다. embedding 차원이 라면 출력층 계산은 대략 가 필요하다. corpus가 수백만 개 이상이면 학습 예시마다 모든 item을 계산하는 것이 매우 비싸다.
그렇다고 실제 상호작용이 있는 positive item만 학습에 사용하면 다른 문제가 생긴다. 모델은 함께 있어야 하는 query와 item을 가까이 놓는 법은 배우지만, 관련 없는 query와 item을 서로 멀리 놓아야 한다는 신호는 받지 못한다.
Folding 문제
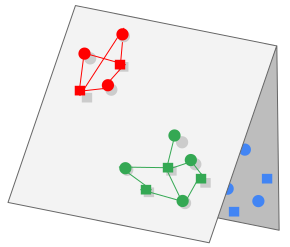
그림 7. 서로 다른 그룹이 embedding 공간에서 겹쳐지는 folding의 개념도이다.
그림에서 색은 서로 다른 query와 item 그룹을 나타낸다. 각 query는 주로 같은 색의 item과 상호작용한다고 가정한다. YouTube라면 색을 언어 그룹으로 생각할 수 있다. 한 사용자는 보통 자신이 이해하는 언어의 영상을 주로 시청한다.
positive pair만 사용해도 같은 색 내부에서 query와 item의 상대적인 위치는 학습할 수 있다. 하지만 서로 다른 색 사이의 관계를 제약하는 학습 신호가 없으므로, 독립적으로 학습된 그룹이 우연히 embedding 공간의 같은 위치에 겹칠 수 있다. 이를 folding이라고 한다.
folding이 발생하면 query와 실제로 관련 없는 다른 그룹의 item도 높은 dot product를 얻는다. 예를 들어 한국어 영상만 본 사용자의 query embedding 근처에 다른 언어 영상 embedding이 겹쳐지면, 모델이 해당 영상을 관련성이 높다고 잘못 판단할 수 있다.
Negative sampling
negative example은 특정 query와 관련 없다고 간주하는 item이다. 학습 시 positive item은 query에 가까워지게 하고 negative item은 멀어지게 하면 그룹 사이의 상대적인 위치도 학습할 수 있다.
모든 item을 사용하는 full softmax와 positive만 사용하는 학습 사이의 실용적인 절충이 negative sampling이다. query 하나에 대해 다음 item만 사용하여 gradient를 근사한다.
- 정답에 포함된 모든 positive item
- 전체 item 집합 에서 뽑은 일부 negative item
negative를 고르는 대표적인 방법은 다음과 같다.
- Uniform sampling: 모든 item을 같은 확률로 뽑는다. 구현은 단순하지만 너무 쉬운 negative가 많이 선택될 수 있다.
- Popularity-based sampling: 인기 item이 뽑힐 확률을 높인다. 노출될 가능성이 높은 item을 더 자주 구분하도록 만들 수 있지만 sampling bias를 고려해야 한다.
- Hard negative sampling: 현재 모델이 높은 score를 주지만 실제로는 positive가 아닌 item을 우선해서 뽑는다.
hard negative 는 보통 다음 score가 큰 item이다.
이런 item은 모델이 이미 명확히 구분하는 쉬운 negative보다 gradient에 더 크게 기여할 수 있다. 다만 실제로는 사용자가 아직 발견하지 못했을 뿐 좋아할 수 있는 item을 false negative로 선택할 가능성도 있으므로, 지나치게 공격적인 hard negative mining은 주의해야 한다.
negative sampling은 full softmax의 정확한 gradient 대신 표본으로 만든 근사 gradient를 사용한다. 따라서 sampling distribution과 보정 방법에 따라 학습 목적이 달라질 수 있으며, negative 수가 너무 적으면 계산은 싸지만 품질이 떨어질 수 있다.
Matrix factorization과 Softmax DNN 비교
| 비교 항목 | Matrix factorization | Softmax DNN |
|---|---|---|
| Query feature | ID embedding 중심이라 추가하기 어렵다. | 다양한 query feature를 입력할 수 있다. |
| Cold start | 새로운 query와 item을 직접 처리하기 어렵다. 유사 embedding 평균 같은 heuristic이 필요하다. | feature가 있으면 새로운 query를 처리하기 쉽다. item cold start는 two-tower로 완화할 수 있다. |
| Folding | WALS에서 관측되지 않은 항목의 weight를 조정해 줄이기 쉽다. | folding에 취약하므로 negative sampling이나 gravity 같은 방법이 필요하다. |
| 학습 확장성 | 입력 행렬이 sparse하면 매우 큰 corpus에도 비교적 쉽게 확장된다. | 출력 item 수가 커질수록 full softmax가 비싸다. hashing과 negative sampling 등이 필요하다. |
| Serving | user와 item embedding이 정적이므로 candidate를 미리 계산할 수 있다. | item embedding은 저장할 수 있지만 query embedding은 보통 요청 시 DNN으로 계산해야 한다. |
| 표현력 | 주로 user-item interaction의 저차원 구조를 표현한다. | side feature와 비선형 feature interaction을 활용할 수 있다. |
matrix factorization은 corpus가 매우 크고 interaction matrix가 sparse할 때 좋은 출발점이다. 학습과 serving이 단순하고 folding도 상대적으로 제어하기 쉽다.
DNN은 더 많은 feature와 비선형 관계를 사용해 개인화된 선호를 정교하게 표현할 수 있지만, 학습과 serving 비용이 더 크다. 특히 candidate generation보다 scoring 단계에서 DNN이 자주 사용된다. scoring 단계는 이미 관련성이 있다고 판단한 작은 candidate 집합만 다루므로 더 복잡한 모델을 실행할 수 있고, 제한된 candidate 안에서의 ranking이 핵심이기 때문이다. 또한 scoring 입력은 앞 단계에서 관련성이 있다고 판단한 candidate로 제한되어 있으므로, 전체 corpus에서 retrieval할 때보다 folding으로 무관한 그룹이 섞이는 문제가 상대적으로 덜 치명적이다.
추가 읽을거리
- Covington et al., Deep Neural Networks for YouTube Recommendations
- Xin et al., Folding: Why Good Models Sometimes Make Spurious Recommendations
- Bengio and Senécal, Adaptive Importance Sampling to Accelerate Training of a Neural Probabilistic Language Model
정리
- Softmax DNN은 추천을 개 item에 대한 multiclass prediction으로 표현한다.
- 는 feature에서 계산한 query embedding이고, softmax weight 는 item embedding으로 해석할 수 있다.
- item 확률의 순위는 의 순위와 같으므로 dot product 기반 retrieval로 연결할 수 있다.
- matrix factorization이 user embedding을 직접 학습한다면 DNN은 query feature를 embedding으로 바꾸는 함수 를 학습한다.
- two-tower model은 query와 item 양쪽에 neural network를 두어 양쪽의 feature를 모두 embedding으로 변환한다.
- corpus가 크면 full softmax가 비싸므로 negative sampling으로 일부 negative만 사용한다.
- positive pair만 학습하면 서로 다른 그룹의 embedding이 겹치는 folding이 생길 수 있으므로 negative 학습 신호가 필요하다.
출처
- Google for Developers, Deep neural network models
- Google for Developers, Softmax training
- 본문의 원문 기반 내용과 그림은 Creative Commons Attribution 4.0 License에 따라 정리하였다.