
Google 공식 원문: Retrieval, Scoring, Re-ranking, Course summary
대규모 추천 시스템은 corpus 전체를 하나의 복잡한 모델로 정렬하지 않는다. 수백만 개 이상의 item을 요청마다 모두 평가하면 latency와 compute 비용을 감당하기 어렵기 때문이다. 대신 대상을 단계적으로 줄이는 funnel 구조를 사용한다.
- Retrieval 또는 candidate generation: 전체 corpus에서 관련 가능성이 있는 candidate 수백~수천 개를 빠르게 가져온다.
- Scoring과 ranking: 더 많은 feature와 복잡한 모델로 candidate의 relevance를 평가하고 순서를 정한다.
- Re-ranking: freshness, diversity, fairness, 정책 같은 추가 기준과 제약을 반영해 최종 노출 목록을 만든다.
앞 단계는 recall과 속도가 중요하고, 뒤 단계는 정밀한 순서와 전체 목록의 품질이 중요하다. 각 단계가 푸는 문제가 다르므로 같은 모델과 같은 score를 모든 단계에 그대로 사용하는 것은 적절하지 않을 수 있다.
Retrieval: embedding 공간에서 candidate 찾기
Query embedding 준비
embedding 모델이 학습되어 있다고 하자. serving 시점에는 먼저 현재 요청을 나타내는 query embedding 가 필요하다. 모델 종류에 따라 를 얻는 방법이 다르다.
- Matrix factorization: user 또는 query embedding이 학습된 행렬에 정적으로 저장되어 있으므로 ID로 lookup한다.
- DNN 또는 two-tower model: 요청 시 query feature vector 를 network에 넣어 embedding을 계산한다.
는 user history, 언어, 국가, 시간대와 같은 feature를 차원 query embedding으로 변환하는 함수이다. matrix factorization의 lookup은 빠르지만 학습에서 보지 못한 query를 다루기 어렵고, DNN은 계산 비용이 더 들지만 현재 문맥을 반영할 수 있다.
Nearest neighbor 검색
query embedding 를 얻은 뒤에는 embedding 공간에서 와 가까운 item embedding 를 찾는다. 각 item 에 similarity score 를 계산하고 score가 큰 상위 개 item을 반환한다.
는 query 에 대해 retrieval 된 top- item candidate 집합, 은 전체 item 수, 는 retrieval에서 남길 candidate 수이다. 처럼 큰 값이 좋은 similarity에는 dot product와 cosine similarity를 사용할 수 있다. Euclidean distance를 그대로 사용한다면 거리가 작은 item을 골라야 하며, 큰 값이 좋은 score로 통일하려면 로 정의할 수 있다. 중요한 점은 학습 때 사용한 score와 serving index의 거리 함수가 서로 맞아야 한다는 것이다.
앞 글의 Softmax DNN에서는 같은 query에 대한 softmax 정규화 항이 모든 item에 공통이고 softmax가 logit의 대소 관계를 보존한다. 따라서 item의 예측 확률 순위와 다음 dot product의 순위가 같다.
따라서 학습한 softmax 출력층 weight 를 item embedding으로 저장하고, query embedding과의 maximum inner product search로 candidate를 찾을 수 있다.
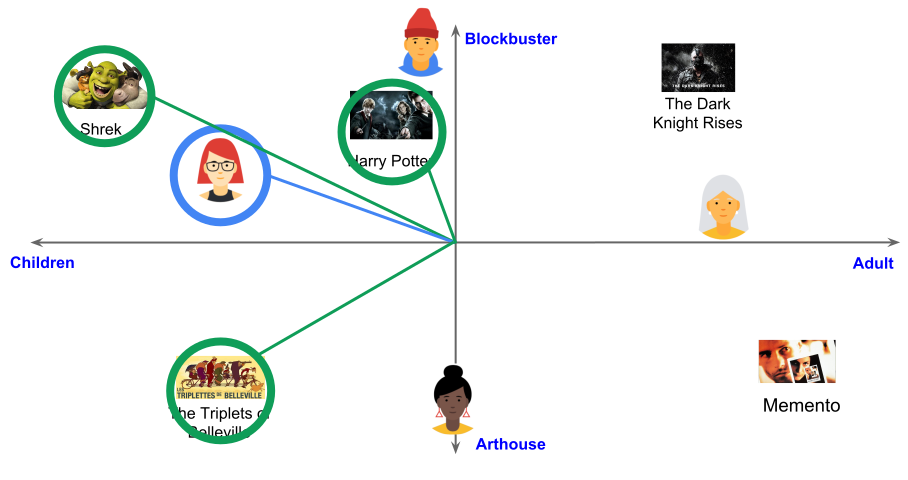
그림 1. query embedding과 가까운 두 item이 retrieval 결과로 선택된다. 실제 embedding은 보통 2차원보다 훨씬 높은 차원이다.
이 방식은 personalized recommendation뿐 아니라 related-item recommendation에도 사용할 수 있다. 사용자가 보고 있는 item의 embedding을 query로 삼고, 그 주변의 다른 item embedding을 검색하면 된다. 예를 들어 현재 YouTube 영상과 embedding 공간에서 가까운 영상을 관련 영상 candidate로 가져올 수 있다.
Exact search의 비용
가장 단순한 방법은 query마다 모든 item을 순회하며 score를 계산하는 exhaustive search이다. item 수가 이고 embedding 차원이 라면 query 하나의 계산량은 대략 이다.
이 방식은 정확한 top-를 보장하지만 corpus가 매우 크고 요청량이 많으면 비싸다. 대규모 retrieval에서는 정확도, latency, memory 사용량 사이의 trade-off를 고려해야 한다.
대규모 retrieval 전략
원문은 대규모 corpus에서 다음 두 전략을 제시한다.
Offline precomputation
query embedding이 정적으로 알려져 있으면 exhaustive scoring을 offline에서 수행하고 query별 top candidate를 미리 저장할 수 있다. 요청 시에는 저장된 목록을 lookup하므로 serving이 매우 빠르다.
이 방법은 item-to-item 추천처럼 query 집합이 제한적이고 embedding이 자주 바뀌지 않을 때 특히 유용하다. 반면 최신 user context를 즉시 반영하기 어렵고, embedding이나 corpus가 바뀌면 목록을 다시 계산해야 한다.
Approximate nearest neighbor
모든 item을 정확히 비교하는 대신 approximate nearest neighbor(ANN) index를 사용하면 작은 품질 손실을 감수하고 검색 속도를 크게 높일 수 있다. Google은 대규모 vector similarity search를 위한 open-source 도구인 ScaNN을 제공한다.
ANN은 공간을 분할하거나 후보를 압축하는 방식으로 실제 nearest neighbor일 가능성이 높은 일부 vector만 자세히 비교한다. index 설정은 보통 다음 항목에 영향을 준다.
- Recall: exact top- 중 ANN 결과가 얼마나 많이 포함되는가이다.
- Latency: query 하나를 처리하는 데 걸리는 시간이다.
- Memory: item embedding과 검색 구조를 저장하는 비용이다.
- Build 및 refresh 비용: 새 item이나 새 embedding을 index에 반영하는 비용이다.
retrieval에서는 완벽한 순서보다 관련 item을 다음 단계에 누락하지 않고 전달하는 것이 중요하다. 따라서 약간의 순서 오차를 허용하고 높은 recall과 낮은 latency를 얻는 ANN이 실용적이다.
Scoring: 작은 candidate 집합을 정교하게 평가하기
여러 candidate source 합치기
실제 추천 시스템은 하나의 candidate generator만 사용하지 않는 경우가 많다. 서로 다른 source는 추천 목록의 coverage와 diversity를 높인다.
- matrix factorization이나 embedding 검색이 가져온 related item
- user feature와 history를 사용한 personalized candidate
- 지리 정보에 따른 가까운 item과 먼 item
- 인기 item 또는 최근 trending item
- 친구가 좋아하거나 추천한 item 같은 social graph 기반 candidate
각 generator의 결과를 하나의 candidate pool로 합친 뒤, 공통 scoring model이 각 candidate를 같은 기준으로 평가한다. 중복 item은 이 단계에 들어가기 전이나 후에 제거할 수 있다.
YouTube 예시에서 scoring model은 user가 특정 영상을 시청할 확률을 예측할 수 있다. 입력 feature의 예는 다음과 같다.
- Query feature: 시청 이력, 언어, 국가, 시간, 기기, 현재 session 문맥
- Item feature: 제목, tag, 영상 embedding, 길이, 업로드 시각, 품질 신호
- Cross feature: user 언어와 영상 언어의 일치 여부, user 관심사와 영상 topic의 관계
scoring model을 라고 하면 candidate 의 score는 다음처럼 나타낼 수 있다.
는 학습되는 model parameter이고, 는 현재 요청의 query feature vector, 는 item 의 feature vector이다. 는 클릭 확률처럼 calibration된 값일 수도 있고, candidate의 상대적인 순서만 의미하는 ranking score일 수도 있다.
최종 ranking은 score가 큰 순서로 candidate를 정렬해 만든다.
는 여러 generator의 결과를 합치고 중복을 제거한 candidate pool이며, 는 가 큰 item부터 나열한 ranking이다.
Candidate generator의 score를 그대로 쓰지 않는 이유
candidate generator도 embedding similarity 같은 score를 계산하므로 그 값을 그대로 ranking에 사용할 수 있어 보인다. 하지만 다음 이유로 별도 scoring model이 필요하다.
- 서로 다른 generator의 score는 비교 가능하지 않을 수 있다. dot product, popularity, geographic distance 등은 scale과 의미가 다르다.
- Retrieval score는 제한된 feature만 사용한다. 빠른 검색을 위해 보통 미리 계산한 embedding과 단순한 similarity를 사용한다.
- Candidate 수가 줄어들면 더 복잡한 모델을 사용할 수 있다. corpus 전체에는 적용하기 어려웠던 DNN과 많은 context feature를 수백 개 candidate에는 적용할 수 있다.
retrieval은 관련 가능성이 있는 item을 넓게 모으는 단계이고, scoring은 그 안에서 더 정확한 순서를 만드는 단계이다. retrieval 단계에서의 1등과 scoring 단계에서의 1등이 달라도 이상한 일이 아니다.
Scoring objective가 추천 결과를 결정한다
모델은 주어진 objective를 최적화한다. 따라서 무엇을 label과 loss로 정의하는지가 최종 사용자 경험을 크게 바꾼다.
| Objective | 모델이 학습할 수 있는 행동 | 발생할 수 있는 문제 |
|---|---|---|
| Click rate 최대화 | 클릭할 가능성이 큰 item을 위로 올림 | 자극적인 제목과 thumbnail의 clickbait가 늘 수 있음 |
| Watch time 최대화 | 오래 시청할 가능성이 큰 item을 위로 올림 | 단순히 긴 영상이 과도하게 유리해질 수 있음 |
| Session watch time과 diversity 고려 | session을 이어 가면서 다양한 item을 추천 | 여러 지표의 비중과 장기 효과를 함께 설계해야 함 |
click 수가 늘었다고 만족도까지 좋아졌다고 단정할 수 없다. 짧은 영상 여러 개를 만족스럽게 본 경험은 긴 영상 하나를 오래 본 것과 다른 의미를 가질 수 있다. 단일 proxy metric만 최적화하면 모델이 그 metric의 허점을 이용할 수 있다.
여러 목표를 함께 고려하는 가장 단순한 형태는 가중합이다.
, , 는 서로 다른 목표에 대한 예측값이고, , , 는 제품 목표에 따른 non-negative weight이다. 실제 시스템에서는 지표의 scale, calibration, 장기 효과, 제약 조건을 함께 고려해야 한다. 가중합은 가능한 설계 중 하나일 뿐이며, objective를 선택한 뒤에는 offline metric과 online experiment로 실제 사용자 경험을 확인해야 한다.
Positional bias
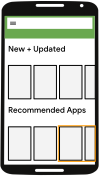
그림 2. 화면 아래쪽 item은 내용이 같아도 위쪽 item보다 보거나 클릭하기 어렵다.
화면 아래에 배치된 item은 위에 배치된 item보다 클릭될 확률이 낮다. 이 차이는 item의 relevance뿐 아니라 노출 위치 때문에 발생한다. 과거 click을 label로 사용하면 모델이 위치 효과까지 item 품질로 잘못 학습할 수 있다.
scoring 시점에는 item이 최종적으로 어느 위치에 놓일지 아직 모르는 경우가 많다. 모든 가능한 position을 넣어 여러 번 model을 호출하면 비용이 크고, position별 score를 얻어도 서로 일관된 하나의 ranking을 만들기 어려울 수 있다.
원문은 position-independent ranking을 만들기 위한 방법으로 모든 candidate가 화면의 최상단에 있다고 가정하고 score를 계산하는 방식을 제시한다. 즉 position feature를 고정하여 item 자체와 query의 관계를 같은 조건에서 비교한다.
이 접근은 ranking 단계에서 position 조건을 통일한다. 다만 학습 데이터 자체가 기존 노출 정책의 영향을 받는 문제까지 자동으로 사라지는 것은 아니다. 실제 시스템에서는 무작위 노출 데이터, propensity 보정, 별도의 bias model 등으로 학습 label의 노출 편향도 함께 다룰 수 있다.
Re-ranking: 최종 목록 전체를 조정하기
scoring model은 대개 candidate 하나마다 독립적인 score를 만든다. 하지만 최종 추천의 품질은 개별 item의 relevance뿐 아니라 목록 전체의 구성에도 영향을 받는다. re-ranking은 마지막 단계에서 추가 기준이나 제약을 적용한다.
대표적인 방법은 두 가지이다.
Filter로 candidate 제거하기
특정 조건을 만족하지 않는 candidate를 목록에서 제거한다. 예를 들어 video recommender에서는 다음과 같이 clickbait를 걸러낼 수 있다.
- 영상이 clickbait인지 분류하는 별도 model을 학습한다.
- scoring을 마친 candidate 목록에 이 model을 실행한다.
- clickbait로 분류된 영상을 제거한다.
그 밖에도 이미 본 item, 서비스할 수 없는 지역의 item, 연령 제한을 위반하는 item, 품절 item 등을 filter로 제거할 수 있다.
Score를 변환하기
ranker가 반환한 relevance score에 추가 요소를 반영하여 순서를 바꿀 수 있다.
는 원래 ranker score이고, 는 re-ranking에 사용할 score이다. 는 최신 item을 우대하거나 특정 길이의 item을 조정하는 규칙 또는 model이다. score 변환은 개별 relevance를 완전히 버리는 것이 아니라 제품 목표와 제약을 추가하는 과정이다.
Freshness
추천 시스템은 최신 사용자 행동과 새 item을 빠르게 반영해야 한다. 오래된 model은 최근 바뀐 관심사, 유행, 새로 등록된 item을 알지 못한다. 여기서 freshness는 단순히 새 item을 많이 보여 주는 의미가 아니라 최신 상태를 model과 serving 결과에 반영하는 능력이다.
원문이 제시하는 방법은 다음과 같다.
- 자주 재학습한다. 최신 interaction을 사용해 가능한 한 자주 model을 갱신한다.
- Warm start를 사용한다. 이전 model의 parameter에서 학습을 시작하면 매번 처음부터 학습하는 것보다 시간이 줄어든다. matrix factorization에서는 이전 model에도 있던 item embedding을 초기값으로 사용할 수 있다.
- 새 user를 대표할 embedding을 만든다. matrix factorization에서는 평균 user embedding을 사용하거나 user feature로 cluster를 만든 뒤 cluster별 초기 embedding을 사용할 수 있다.
- DNN 또는 two-tower model을 사용한다. Softmax DNN은 feature가 있는 새로운 query를 처리할 수 있고, query와 item 양쪽에 network를 둔 two-tower model은 새로운 item도 item feature에서 embedding을 계산할 수 있다.
- Item age를 feature로 추가한다. 영상의 생성 이후 시간이나 마지막 시청 이후 경과 시간을 feature로 넣어 model이 시간 효과를 학습하게 한다.
freshness는 model 재학습 주기만의 문제가 아니다. item embedding 생성, ANN index 갱신, feature pipeline, cache invalidation까지 함께 최신 상태를 유지해야 실제 추천에 반영된다.
Diversity
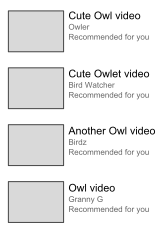
그림 3. 현재 영상과 가장 가까운 item만 고르면 비슷한 부엉이 영상으로 목록이 채워질 수 있다.
query embedding과 가장 가까운 item만 선택하면 candidate가 서로 매우 비슷해지는 경향이 있다. 각 item은 개별적으로 관련성이 높더라도 목록 전체가 같은 topic, creator, genre로 채워지면 사용자는 금방 흥미를 잃을 수 있다.
원문은 diversity를 높이는 방법으로 다음을 제시한다.
- 서로 다른 source를 사용하는 여러 candidate generator를 학습한다.
- 서로 다른 objective를 사용하는 여러 ranker를 학습한다.
- genre나 다른 metadata를 기준으로 re-ranking하여 같은 종류의 item이 지나치게 몰리지 않게 한다.
실제로는 relevance와 diversity 사이의 균형을 정해야 한다. diversity만 지나치게 높이면 query와 무관한 item이 섞일 수 있고, relevance만 높이면 목록이 반복적이 된다. 한 가지 단순한 관점은 이미 선택된 item과 너무 비슷한 candidate에 penalty를 주는 것이다.
는 이미 최종 목록에 선택된 item 집합이고, 는 candidate 와 선택된 item 의 embedding similarity이다. 첫 항은 query에 대한 relevance, 둘째 항은 이미 선택된 item과의 최대 중복성이다. 가 크면 relevance를, 작으면 diversity를 더 중시한다. 첫 item은 가 비어 있으므로 relevance만으로 선택하고, 두 번째 item부터 이 식을 적용할 수 있다. 이 식은 diversity re-ranking의 직관을 보여 주는 예이며, 실제 서비스에서는 genre quota나 creator 중복 제한처럼 명시적인 규칙을 사용할 수도 있다.
Fairness
추천 model은 학습 데이터에 들어 있는 기존의 편향을 그대로 학습하거나 더 강화할 수 있다. 특정 사용자 집단의 데이터가 적거나 과거 시스템에서 충분히 노출되지 않았다면 전체 평균 성능이 좋아도 그 집단의 성능은 낮을 수 있다.
원문이 제시하는 대응 방법은 다음과 같다.
- 설계와 개발 과정에 다양한 관점을 포함한다.
- 충분히 포괄적인 dataset으로 학습하고, 특정 범주의 데이터가 sparse하면 auxiliary data를 추가한다.
- demographic group별 accuracy와 absolute error 같은 metric을 추적해 편향을 관찰한다.
- 충분한 근거가 있다면 서비스가 부족한 집단을 위한 별도 model을 만든다.
fairness는 하나의 보편적인 수치만으로 결정되지 않는다. 어떤 집단과 결과를 비교할지, 사용자 측 fairness와 item 공급자 측 fairness 중 무엇을 다룰지, 품질과 노출을 어떻게 측정할지를 제품 맥락에서 먼저 정의해야 한다. 전체 평균 metric만 보면 작은 집단에서 발생하는 큰 오류가 가려질 수 있으므로 group별 평가가 필요하다.
전체 파이프라인 연결하기
하나의 추천 요청이 처리되는 과정을 정리하면 다음과 같다.
| 단계 | 입력 규모 | 주요 연산 | 우선 목표 | 출력 |
|---|---|---|---|---|
| Retrieval | 전체 corpus | embedding lookup, DNN query tower, ANN search | 낮은 latency와 높은 candidate recall | 수백~수천 개 candidate |
| Scoring | candidate pool | rich feature를 사용한 DNN 또는 ranking model | 정교한 relevance 예측 | candidate별 공통 score와 순서 |
| Re-ranking | 상위 candidate | filter, score 조정, 목록 단위 제약 | freshness, diversity, fairness, 정책 반영 | 최종 노출 목록 |
예를 들어 영상 추천 요청은 다음처럼 처리할 수 있다.
- 현재 user history와 context에서 query embedding 를 계산한다.
- ANN index에서 와 가까운 영상 candidate를 가져온다.
- trending, social graph, 지역 기반 generator의 candidate를 추가한다.
- 중복을 제거하고 공통 scoring model로 시청 가능성이나 만족도를 예측한다.
- clickbait와 볼 수 없는 영상을 filter한다.
- 새 영상의 freshness를 반영하고 topic과 creator가 반복되지 않게 re-ranking한다.
- 최종 상위 item을 화면에 노출한다.
앞 단계에서 좋은 item을 놓치면 뒤 단계는 그 item을 복구할 수 없다. 반대로 retrieval recall만 높이고 너무 많은 candidate를 넘기면 scoring 비용이 커진다. 각 단계의 품질뿐 아니라 단계 사이의 candidate 수, latency budget, feature freshness를 함께 설계해야 한다.
과정 전체 정리
Google Recommendation Systems 과정에서 다룬 핵심 내용을 한 번에 연결하면 다음과 같다.
- 추천 시스템은 방대한 corpus에서 사용자에게 관련 있는 작은 item 집합을 선택하고 순서를 정한다.
- candidate generation, scoring, re-ranking은 서로 다른 규모와 목적을 가진다.
- embedding은 query와 item을 같은 vector 공간에 표현하고 similarity search를 가능하게 한다.
- content-based filtering은 item feature를 활용하고, collaborative filtering은 user-item interaction에서 유사성을 학습한다.
- matrix factorization은 feedback matrix를 user embedding과 item embedding의 곱으로 근사한다.
- DNN은 side feature와 비선형 관계를 사용하여 matrix factorization의 일부 한계를 보완한다.
- 실제 serving에서는 retrieval로 candidate를 줄이고, scoring으로 정교하게 정렬한 뒤, re-ranking으로 목록 전체의 품질과 제약을 조정한다.
추천 품질은 model 하나의 offline accuracy만으로 결정되지 않는다. candidate가 충분히 다양하게 생성되는지, objective가 원하는 사용자 경험과 맞는지, positional bias가 label을 왜곡하지 않는지, 최신 정보와 공정성이 최종 목록에 반영되는지를 end-to-end로 확인해야 한다.
출처
- Google for Developers, Retrieval
- Google for Developers, Scoring
- Google for Developers, Re-ranking
- Google for Developers, Course summary
- 본문의 원문 기반 내용과 그림은 Creative Commons Attribution 4.0 License에 따라 정리하였다.