
공식 원문: Collaborative filtering: Basics, Matrix factorization, Advantages & disadvantages
핵심 한 줄 정리
Collaborative filtering은 여러 사용자의 user–item interaction을 함께 이용해 user와 item의 latent embedding을 자동으로 학습하며, matrix factorization은 feedback matrix 를 저차원 행렬 와 의 곱으로 근사해 관측되지 않은 선호를 예측하는 대표적인 collaborative filtering 방법이다.
왜 collaborative filtering이 필요한가
Content-based filtering은 사용자가 좋아한 item과 feature가 비슷한 item을 추천한다. Item feature를 직접 설계해야 하며, 이미 드러난 관심사 밖의 item을 발견하기 어렵다는 한계가 있다.
Collaborative filtering은 여러 사용자와 여러 item의 관계를 동시에 본다. 핵심 가정은 다음과 같다.
- 과거에 비슷한 item을 좋아한 사용자는 앞으로도 비슷한 item을 좋아할 가능성이 높다.
- 비슷한 사용자 집단이 함께 소비한 item은 서로 관련 있을 가능성이 높다.
예를 들어 사용자 A의 profile만 보면 shopping app에 대한 관심을 알 수 없더라도, A와 비슷한 행동을 보인 사용자 B가 그 app을 좋아했다면 A에게도 추천할 수 있다. 이처럼 기존 관심사와 직접 닮지 않은 item을 우연히 발견하게 하는 특성을 serendipity라고 한다.
또한 item category를 사람이 정의하지 않아도 interaction pattern에서 embedding을 학습할 수 있다. “어린이용 영화”, “blockbuster” 같은 의미를 label로 주지 않아도 함께 시청되는 pattern을 설명하는 latent feature가 만들어진다.
Feedback matrix
영화 추천을 예로 들면 training data를 feedback matrix 로 나타낼 수 있다.
- 은 사용자 수
- 은 item 수
- Row 는 사용자 의 feedback
- Column 는 영화 에 대한 여러 사용자의 feedback
- 는 사용자 와 item 사이에서 관측한 feedback
Feedback은 두 종류로 나눌 수 있다.
Explicit feedback
사용자가 선호도를 직접 표현한 data이다. 별점, 좋아요·싫어요, 설문 응답 등이 해당한다. 값의 의미가 분명하지만 feedback을 남긴 interaction만 관측되므로 보통 matrix가 매우 sparse하다.
Implicit feedback
사용자의 행동으로 관심을 추론한 data이다. 영화 시청, 상품 구매, 클릭, 재생 시간 등이 해당한다. Data 양은 많지만 행동이 곧 선호를 뜻하지는 않는다. 영화를 클릭했지만 싫어서 바로 종료했을 수도 있고, 노출되지 않아 보지 못한 item도 있다.
원문의 예제는 설명을 단순하게 하기 위해 binary feedback을 가정한다.
여기서 을 곧바로 “싫어한다”로 해석하면 안 된다. 대부분은 아직 관측되지 않은 interaction이다. 이 차이는 뒤에서 objective function을 설계할 때 중요하다.
영화 예제로 보는 embedding의 필요성
원문에서는 다음 다섯 영화를 사용한다.
| 영화 | 등급 | 내용의 특징 |
|---|---|---|
| The Dark Knight Rises | PG-13 | DC Comics 세계관에서 배트맨이 고담시티를 구하는 영화 |
| Harry Potter and the Sorcerer’s Stone | PG | 마법사임을 알게 된 소년이 호그와트에서 모험을 시작 |
| Shrek | PG | 슈릭과 당나귀가 피오나 공주를 구하러 떠난다. |
| The Triplets of Belleville | PG-13 | 납치된 사이클리스트를 구하기 위한 할머니와 개의 독특한 여정 |
| Memento | R | 기억 장애가 있는 주인공이 단서를 추적해 아내의 죽음을 밝힘 |
사용자가 좋아할 영화를 예측하려면 영화와 사용자의 성향을 비교할 representation이 필요하다. 먼저 사람이 의미를 부여한 낮은 차원의 embedding으로 직관을 살펴보고, 이후 그 embedding을 data에서 자동으로 학습하는 matrix factorization으로 확장한다.
1D embedding
각 영화에 범위의 scalar를 하나 부여한다고 하자. 음수에 가까울수록 어린이용 영화이고, 양수에 가까울수록 성인용 영화라는 축이다.
사용자에게도 같은 축의 scalar를 부여한다. 에 가까우면 어린이용 영화를 선호하고, 에 가까우면 성인용 영화를 선호한다.
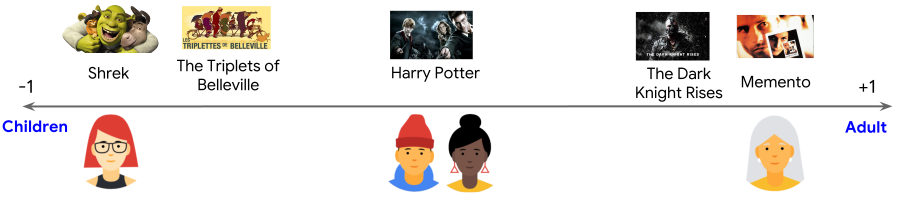
User embedding과 movie embedding의 곱으로 relevance를 계산할 수 있다.
두 값의 부호와 크기가 비슷하면 곱이 에 가까워진다. 어린이용 영화를 좋아하는 사용자의 음수 embedding과 어린이용 영화의 음수 embedding을 곱하거나, 성인용 영화를 좋아하는 사용자의 양수 embedding과 성인용 영화의 양수 embedding을 곱한 경우이다.
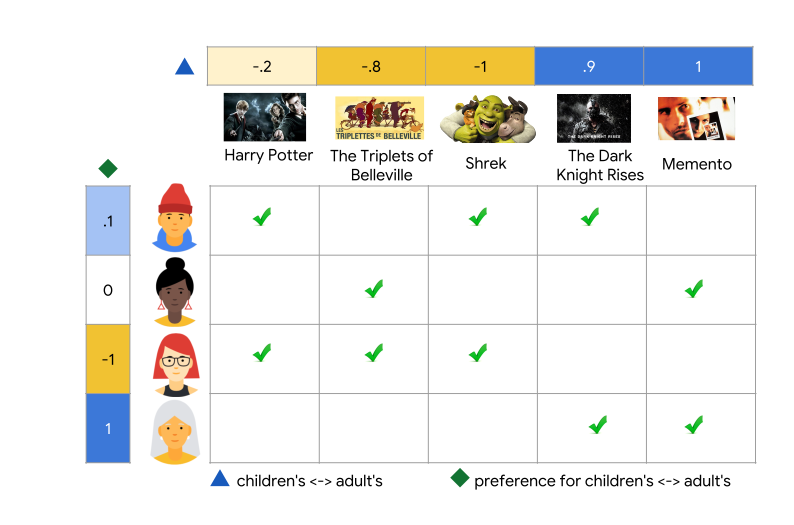
그림에서 checkmark는 사용자가 실제로 본 영화를 나타낸다. 세 번째 사용자의 어린이용 영화 선호와 네 번째 사용자의 성인용 영화 선호는 이 한 축으로 잘 설명된다. 그러나 첫 번째와 두 번째 사용자의 시청 pattern은 어린이용–성인용이라는 feature 하나만으로 충분히 설명되지 않는다.
즉, dimension이 너무 작으면 서로 다른 취향을 같은 위치에 압축하게 되어 필요한 pattern을 놓치는 underfitting이 발생한다.
2D embedding
두 번째 축으로 영화가 blockbuster에 가까운지 arthouse 영화에 가까운지를 추가한다. 이제 각 영화와 사용자는 2차원 vector로 표현된다.
- 첫 번째 dimension은 어린이용–성인용 성향이다.
- 두 번째 dimension은 arthouse–blockbuster 성향이다.
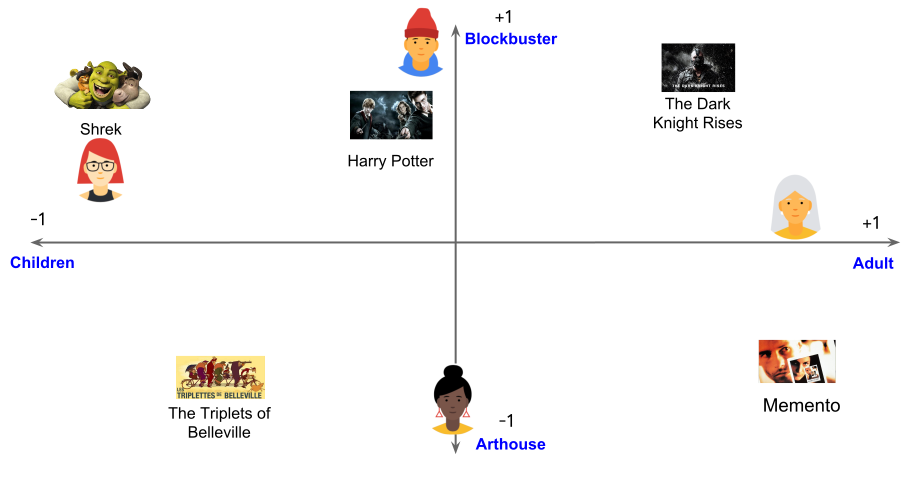
두 vector의 dot product로 예측 score를 계산한다.
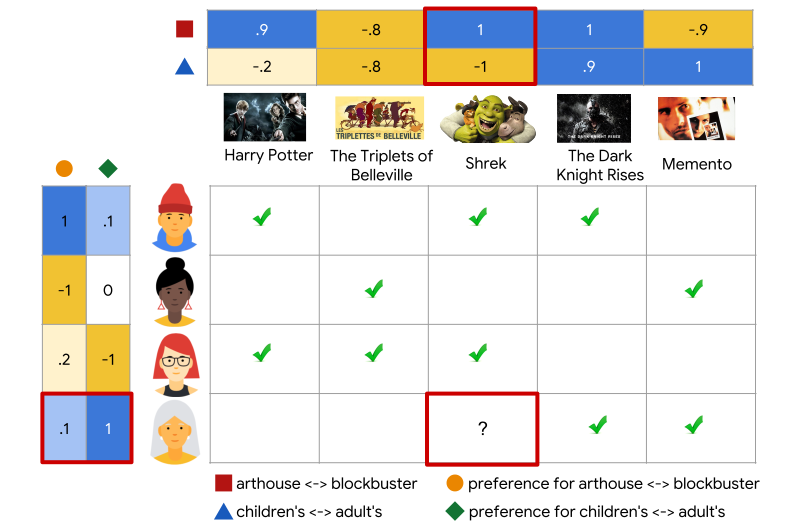
각 user–item pair에 대해 실제로 영화를 봤다면 dot product가 에 가깝고, 그렇지 않다면 에 가깝도록 user와 movie의 위치를 정한다. Dimension을 하나 더 사용하자 1D에서 설명하기 어려웠던 첫 번째와 두 번째 사용자의 취향도 더 잘 구분할 수 있다.
서로 다른 entity를 같은 공간에 놓는 이유
사용자와 영화는 서로 다른 종류의 entity이지만 같은 embedding space에 표현한다. 이 공간은 실제 물리적 속성을 뜻하는 공간이 아니라 user–item relevance를 계산하기 위한 공통 좌표계이다.
두 vector가 같은 차원이므로 dot product를 계산할 수 있다. User vector의 각 방향은 취향을, item vector의 같은 방향은 그 취향을 만족하는 정도를 나타낸다고 볼 수 있다.
원문의 1D와 2D 예제에서는 이해를 위해 축에 사람이 이름을 붙였다. 실제 collaborative filtering이 학습한 dimension은 “어린이용”이나 “blockbuster”처럼 하나의 말로 해석되지 않을 수 있다. 여러 속성이 섞인 latent factor여도 interaction을 잘 예측하면 유용하다.
Collaborative하다는 의미
Movie embedding을 고정하고 user embedding을 학습하면 비슷한 영화를 좋아한 사용자들이 가까운 representation을 갖게 된다. 반대로 user embedding을 고정하고 movie embedding을 학습하면 비슷한 사용자들이 좋아한 영화들이 가까워진다.
따라서 한 사용자의 embedding은 그 사용자의 행동만으로 고립되어 정해지지 않는다. 여러 사용자가 여러 item에 남긴 interaction pattern이 서로를 통해 user와 item representation을 함께 결정한다.
Matrix factorization
Matrix factorization은 feedback matrix를 두 개의 작은 embedding matrix로 분해하는 방법이다. Feedback matrix가 다음과 같다고 하자.
Model은 user embedding matrix 와 item embedding matrix 를 학습한다.
- 는 의 번째 row이며 사용자 의 차원 embedding이다.
- 는 의 번째 row이며 item 의 차원 embedding이다.
- 는 embedding dimension이며 보통 과 보다 훨씬 작다.
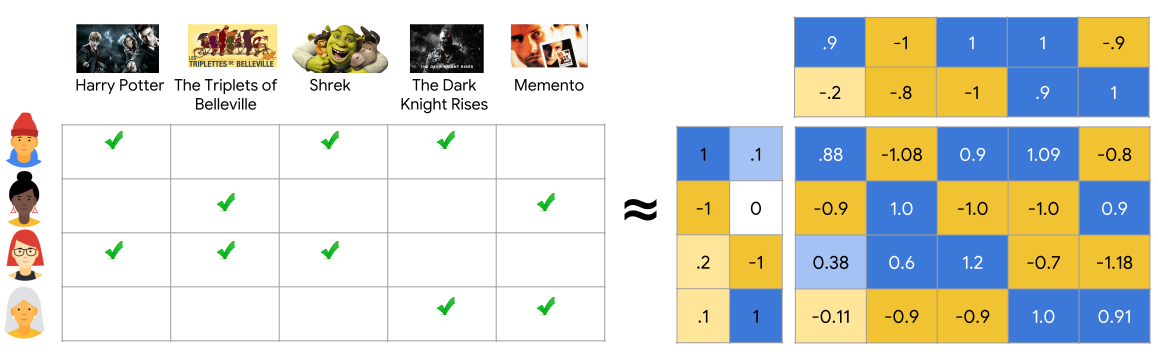
두 embedding matrix의 곱이 원래 feedback matrix를 잘 근사하도록 학습한다.
위치의 예측값은 사용자 와 item embedding의 dot product이다.
Training에서는 관측한 feedback을 잘 복원하도록 와 를 찾는다. Inference에서는 관측하지 않은 pair에도 dot product를 계산할 수 있으므로 사용자가 아직 소비하지 않은 item의 선호를 예측할 수 있다.
왜 저차원 분해가 가능한가
전체 matrix 의 원소 수는 개이므로 저장 비용이 이다. Matrix factorization은 와 에 총 개의 원소를 저장한다.
이면 훨씬 compact하다. 예를 들어 사용자와 item이 각각 백만 개라면 전체 matrix에는 최대 개 entry가 필요하지만, 인 두 embedding matrix에는 약 개 parameter가 필요하다.
이 압축은 단순히 memory만 줄이는 것이 아니다. 많은 interaction이 소수의 latent preference 조합으로 설명된다는 low-rank assumption을 둔다. 개별 interaction을 외우는 대신 반복되는 구조를 학습하므로 관측되지 않은 pair로 generalize할 수 있다.
Objective function 설계
Embedding을 학습하려면 어떤 approximation을 좋은 것으로 볼지 loss를 정해야 한다. Implicit feedback에서는 관측된 과 관측되지 않은 entry를 어떻게 다룰지가 핵심이다.
관측된 entry만 사용하는 경우
가장 먼저 생각할 수 있는 방법은 관측된 pair의 squared error만 minimize하는 것이다. 관측된 pair 집합을 라고 하자.
Binary implicit feedback에서 관측된 값은 모두 이다. 이 entry만 loss에 넣으면 모든 pair의 score를 로 만드는 해도 관측 data에서는 작은 loss를 얻는다. 보지 않은 item을 구분할 압력이 없으므로 추천 ranking을 만들지 못하고 generalization도 좋지 않다.
모든 unobserved entry를 0으로 처리하는 경우
반대로 관측되지 않은 entry를 모두 확실한 negative 으로 보고 matrix 전체의 squared error를 minimize할 수 있다. 이는 와 사이의 squared Frobenius norm이다.
Frobenius norm은 matrix 모든 원소의 squared error를 더한 값이다.
이 quadratic problem은 의 Singular Value Decomposition, SVD를 이용해 low-rank approximation으로 풀 수 있다. 그러나 실제 추천 matrix는 극도로 sparse하다. 한 사용자가 YouTube의 모든 영상 중 시청한 영상은 극히 일부이므로 거의 모든 entry가 이다.
모든 에 같은 비중을 주면 loss가 압도적으로 많은 unobserved entry에 지배된다. Model은 대부분의 예측을 에 가깝게 만드는 쪽으로 학습되고, 실제 선호를 표현하는 관측 signal을 충분히 반영하지 못할 수 있다. 또한 “노출되었지만 선택하지 않은 item”과 “존재조차 몰랐던 item”을 똑같은 negative로 취급하는 문제가 있다.
Weighted Matrix Factorization
Weighted Matrix Factorization은 관측 entry와 unobserved entry의 loss를 분리하고 서로 다른 weight를 준다.
두 번째 항은 unobserved target을 으로 취급하되 weight 를 적용한다. 보통 unobserved entry 하나의 confidence를 관측 entry보다 작게 두어, 많은 이 objective를 완전히 지배하지 않도록 조절한다.
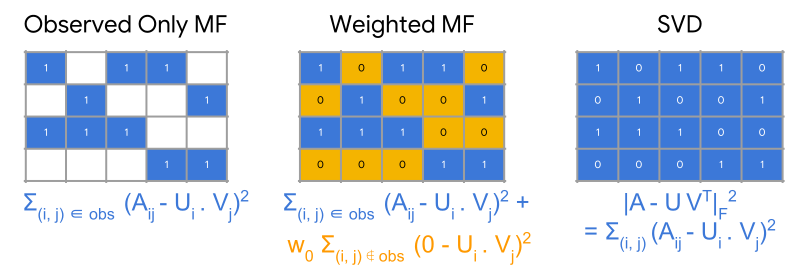
는 두 종류의 signal 사이 균형을 결정하는 중요한 hyperparameter이다.
- 가 너무 작으면 unobserved item의 score를 낮출 압력이 약해져 모든 item에 높은 score를 줄 수 있다.
- 가 너무 크면 sparse matrix의 수많은 이 loss를 지배해 관측된 preference까지 약해질 수 있다.
관측된 example에도 weight 주기
관측된 interaction도 모두 같은 신뢰도를 갖지 않는다. 매우 인기 있는 item이나 interaction이 많은 heavy user가 objective를 지배할 수 있다. 이를 보정하려면 관측 pair별 weight 를 사용한다.
는 사용자 와 item 의 빈도, 시청 시간, 반복 소비, feedback confidence 등을 반영할 수 있다. 예를 들어 반복 시청은 단순 클릭보다 큰 weight를 줄 수 있고, 지나치게 인기 있는 item은 모든 user embedding을 같은 방향으로 끌지 않도록 contribution을 줄일 수 있다.
실제 구현에서는 embedding이 지나치게 커지는 것을 막기 위해 regularization도 자주 추가한다.
는 regularization strength이다. 이 항은 Google 원문의 기본 식을 보강한 것이다.
Objective를 minimize하는 방법
Matrix factorization loss를 푸는 대표적인 방법은 Stochastic Gradient Descent, SGD와 Weighted Alternating Least Squares, WALS이다.
SGD
SGD는 minibatch의 example로 loss gradient를 계산하고 와 를 함께 update한다.
는 learning rate이다. Squared error 외에도 logistic loss, pairwise ranking loss 등 다른 objective를 쉽게 사용할 수 있다는 장점이 있다. 계산을 parallelize할 수도 있다.
Implicit feedback에서 모든 unobserved pair를 직접 처리하면 비용이 지나치게 크다. SGD에서는 보통 일부 unobserved pair를 negative로 sampling하거나, 전체 unobserved score의 크기를 제어하는 gravity term을 사용한다.
WALS(Weighted Alternating Least Squares)
Squared loss는 를 고정하면 에 대한 quadratic problem이고, 를 고정하면 에 대한 quadratic problem이다. 두 matrix를 동시에 볼 때는 jointly convex가 아니지만 한쪽을 고정했을 때는 least-squares subproblem을 정확히 풀 수 있다.
WALS는 embedding을 random하게 initialize한 뒤 두 단계를 반복한다.
- 를 고정하고 를 푼다.
- 를 고정하고 를 푼다.
각 단계는 linear system의 해를 구하는 문제이며 user나 item 단위로 분산할 수 있다. 매 단계가 loss를 증가시키지 않으므로 반복하면 수렴한다. 다만 non-convex problem이므로 얻은 해가 global optimum이라는 보장은 없다.
SGD와 WALS 비교
| 구분 | SGD | WALS |
|---|---|---|
| Loss 선택 | Squared loss 외의 다양한 loss를 사용할 수 있음 | Least squares objective에 의존함 |
| 병렬화 | 가능함 | 가능하며 user 또는 item subproblem으로 나누기 좋음 |
| 수렴 속도 | 보통 WALS보다 느릴 수 있음 | 각 subproblem을 정확히 풀어 비교적 빠름 |
| Unobserved entry | Negative sampling이나 gravity 같은 처리가 필요함 | Weighted loss에 직접 포함하기 쉬움 |
| 구현 유연성 | Neural model이나 추가 feature와 결합하기 쉬움 | 특정 matrix factorization 구조에 특화됨 |
어느 방법이 항상 더 좋은 것은 아니다. Objective의 형태, data 크기와 sparsity, distributed training 환경, side feature의 필요성에 따라 선택한다.
Collaborative filtering의 장점
Domain knowledge 없이 latent feature를 학습한다
기본 matrix factorization은 user–item feedback matrix만으로 embedding을 학습할 수 있다. Movie genre나 app category를 사람이 정교하게 설계하지 않아도 interaction을 설명하는 latent structure를 찾는다.
사람이 ‘이거는 SF취향이야’ 라고 알려주지 않아도 누가 무엇을 좋아했는지만 보고 숨은 취향 축을 스스로 만든다.
Serendipitous recommendation이 가능하다
Content가 직접 비슷하지 않아도 유사한 사용자들이 좋아한 item을 추천할 수 있다. 사용자가 아직 명시하지 않은 새로운 관심사를 발견하는 데 유리하다.
내가 본 것과 닮지 않았더라도 나와 비슷한 사람들이 좋아했다면 의외의 item을 추천 받을수도 있다.
Candidate generator의 좋은 출발점이다
User embedding과 item embedding의 dot product가 높은 item을 찾으면 personalized candidate를 만들 수 있다. 실제 시스템에서는 content-based model, 인기 item, rule 기반 source와 함께 여러 candidate generator 중 하나로 사용한다.
내 취향 벡터와 가까운 item을 먼저 빠르게 뽑아서 랭킹 모델에 넘길 수 있다.
Collaborative filtering의 한계
새 item과 새 사용자를 바로 다룰 수 없다
Matrix factorization의 prediction은 학습된 user와 item embedding의 dot product이다.
Training에서 보지 못한 새 item은 가 없으므로(그 item ID에 대응하는 학습된 latent vector가 없음) score를 계산할 수 없다. 새 사용자도 가 없다. 이 문제를 cold-start problem이라고 한다.
Interaction으로 ID 별 embedding을 배우는 방식이라 처음 보는 user나 item은 꺼내 쓸 임베딩 자체가 없다.
Interaction이 조금 있는 새 item은 projection할 수 있다
WALS에서는 기존 user embedding 를 고정하고 새 item 의 embedding만 least squares로 구할 수 있다. 새 item에 대한 사용자 interaction column을 라고 하면 다음 문제를 푼다.
이는 WALS에서 를 고정하고 를 update하는 한 번의 단계와 같다. 전체 model을 다시 학습하지 않고 새 item embedding만 계산할 수 있다. 새 사용자에게 몇 개의 interaction이 생겼을 때도 를 고정하고 같은 방식으로 user embedding을 구할 수 있다.
몇번이라도 interaction이 생기면 누가 반응했는지를 보고 기존 latent space에서 새 item이 들어갈 위치를 역으로 찾을 수 있다.
Interaction이 전혀 없는 item은 heuristic이 필요하다
아무 interaction도 없다면 위 projection을 풀 signal이 없다. 이때는 같은 category, 같은 creator나 uploader, 비슷한 content feature를 가진 기존 item embedding의 평균으로 초기 embedding을 만들 수 있다.
는 새 item과 metadata가 비슷한 기존 item 집합이다. 이는 heuristic이며 정확한 해결책은 아니다. Content-based model과 collaborative model을 결합한 hybrid system이 cold start를 다루는 일반적인 방법이다.
행동 정보가 하나도 없으면 CF만으로는 위치를 정할 수 없으니 ‘비슷한 item이라도 일단 근처에 놓자’ 같은 휴리스틱한 외부 정보가 필요하다.
Side feature를 넣기 어렵다
기본 WALS는 user ID와 item ID의 interaction matrix를 분해한다. 사용자의 국가·나이, 영화의 장르·언어 같은 side feature를 자연스럽게 넣기 어렵다.
WALS를 확장하는 한 방법은 feedback matrix에 user와 item feature block을 붙이는 것이다. User feature matrix를 , item feature matrix를 라고 하면 다음과 같은 block matrix를 만들 수 있다.
- Block 은 원래 feedback matrix
- Block 은 user feature의 multi-hot encoding
- Block 은 item feature의 multi-hot encoding
- Block 은 일반적으로 비워 두거나 으로 둔다.
를 factorize하면 user와 item뿐 아니라 side feature의 embedding도 함께 학습할 수 있다. 다만 feature를 자유롭게 결합하거나 nonlinear interaction을 표현해야 한다면 다음 글에서 다룰 DNN 기반 recommendation model이 더 자연스러울 수 있다.
기본 MF는 ‘누가 무엇을 했는가’ 에 맞춰진 정형적인 구조라 나이/장르/텍스트 같은 추가 정보를 넣으려면 구조를 따로 확장해야 한다.
Popularity와 exposure bias가 반영될 수 있다
Interaction data는 사용자의 순수한 선호만 기록하지 않는다. 기존 추천 system이 무엇을 노출했는지, 어떤 item이 인기 있었는지의 영향도 함께 포함한다. 인기 item은 더 많이 노출되고 더 많은 interaction을 얻으므로 model이 다시 그 item을 추천하는 feedback loop가 생길 수 있다.
따라서 frequency weight, negative sampling, debiasing, exploration, offline·online evaluation을 함께 고려해야 한다. Matrix factorization이 latent feature를 자동으로 학습하더라도 training data 자체의 bias까지 자동으로 제거하는 것은 아니다.
많이 클릭됐다 = 사람들이 원래 더 좋아한다 가 아닐수도 있다. 많이 보여줬기 때문에 많이 클릭된 것일수도 있다.
정리
- Collaborative filtering은 여러 사용자의 interaction을 함께 보고 user와 item의 latent embedding을 학습한다.
- 1D보다 2D embedding이 더 다양한 취향을 표현하듯, embedding dimension 는 model capacity를 결정한다.
- Matrix factorization은 로 feedback matrix를 저차원 근사하며, 예측값은 이다.
- 관측된 entry만 학습하면 모든 score가 높아질 수 있고, 모든 unobserved entry를 동일한 으로 보면 sparse matrix의 이 loss를 지배한다.
- Weighted Matrix Factorization은 관측·미관측 entry에 다른 weight를 주어 두 문제 사이의 균형을 맞춘다.
- SGD는 loss 선택이 유연하고, WALS는 squared loss에 특화되어 unobserved entry를 다루기 쉽고 빠르게 수렴한다.
- Domain feature 없이도 serendipitous recommendation을 만들 수 있지만 cold start와 side feature, exposure bias 문제가 남는다.
출처
- Google for Developers, Collaborative filtering: Basics
- Google for Developers, Collaborative filtering: Matrix factorization
- Google for Developers, Collaborative filtering: Advantages & disadvantages
이 글은 위 Google Developers 문서를 바탕으로 개인 학습용으로 재구성하고 설명을 보강한 글이다. 원문 콘텐츠와 그림은 Creative Commons Attribution 4.0 License에 따라 이용하였다.