
공식 원문: Content-based filtering: Basics, Advantages & disadvantages
핵심 한 줄 정리
Content-based filtering은 item과 사용자를 같은 feature space의 vector로 표현하고 두 vector의 similarity로 candidate의 relevance를 계산하는 방법이며, 다른 사용자의 행동 없이 개인의 취향을 세밀하게 반영할 수 있지만 추천 품질이 사람이 설계한 feature와 사용자의 기존 관심사에 크게 제한된다.
Content-based filtering이 사용하는 정보
Content-based filtering은 사용자가 이전에 좋아했던 item과 내용이 비슷한 item을 추천한다. 여기서 내용은 제목이나 설명문만을 뜻하지 않는다. Category, tag, publisher, creator, 가격대처럼 item을 설명할 수 있는 모든 속성이 feature가 될 수 있다.
예를 들어 Google Play의 app을 추천한다고 하자. 다음과 같은 feature를 만들 수 있다.
- Category:
Education,Casual,Health등이다. - Publisher:
Science R Us,TimeWastr,Healthcare등이다. - 그 밖의 속성: 대상 연령, 유료 여부, 언어, topic 등이다.
Item 를 차원 feature vector로 표현하면 다음과 같다.
- 는 item의 index이다.
- 는 전체 feature의 수이다.
- 는 item 가 feature 를 얼마나 가지고 있는지 나타낸다.
원문의 예시는 binary feature를 사용한다. 따라서 각 원소는 또는 이며, 은 해당 feature가 존재함을 뜻한다.
하나의 app은 여러 category나 속성을 동시에 가질 수 있으므로 이 표현은 one-hot vector라기보다 multi-hot vector에 가깝다. 실제 시스템에서는 binary 값만 사용할 필요가 없다. 장르별 비중, text encoder가 만든 embedding, 가격처럼 continuous feature를 함께 사용할 수도 있다.
사용자를 같은 feature space에 놓기
추천하려면 item뿐 아니라 사용자도 같은 차원 feature space에 표현해야 한다. 사용자 의 profile vector를 라고 하자.
사용자 feature는 크게 두 종류의 signal로 만들 수 있다.
Explicit signal
사용자가 직접 제공한 정보이다. Profile에서 관심 category로 Entertainment나 Education을 선택하거나, item에 별점과 좋아요를 남기는 경우가 여기에 해당한다. 의미가 비교적 명확하지만 모든 사용자가 충분한 정보를 입력한다고 기대하기는 어렵다.
Implicit signal
사용자의 행동에서 관심을 추론한 정보이다. App 설치, 상품 클릭, 영상 시청, 체류 시간, 검색 기록 등이 여기에 해당한다. 예를 들어 사용자가 Science R Us가 만든 app을 여러 번 설치했다면 publisher feature에 대한 선호가 있다고 추론할 수 있다.
사용자가 선호한 item의 feature vector를 합치면 간단한 user profile을 만들 수 있다. 사용자 가 상호작용한 item 집합을 라고 하고, 각 상호작용의 선호 강도를 라고 하면 가중 평균은 다음과 같다.
는 별점처럼 직접 주어진 값일 수도 있고, 클릭보다 구매에 더 큰 값을 주는 식으로 설계한 implicit weight일 수도 있다. 최근 행동을 더 중요하게 보려면 시간에 따른 decay weight도 곱할 수 있다.
이렇게 만든 의 각 원소는 사용자가 해당 feature를 얼마나 선호하는지를 나타낸다. 핵심은 와 의 각 차원이 같은 의미를 가져야 한다는 점이다. 그래야 두 vector를 비교한 값이 사용자와 item의 relevance를 나타낼 수 있다.
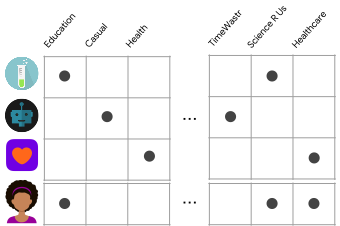
위 그림은 user profile과 여러 app을 같은 feature matrix로 나타낸 것이다. 왼쪽 부분은 category, 오른쪽 부분은 publisher feature를 나타내며, 활성화된 칸은 해당 feature가 존재하거나 사용자가 그 feature에 관심이 있음을 뜻한다.
Similarity로 candidate scoring하기
User vector와 candidate item vector를 얻었으면 similarity function으로 각 candidate의 score를 계산한다.
는 사용자 에게 item 가 얼마나 관련 있는지 나타내는 score이다. 모든 candidate에 score를 계산한 다음 높은 순서로 정렬하면 추천 목록을 만들 수 있다.
Content-based filtering에서 이 score는 오직 현재 사용자의 profile과 item feature로 계산된다. 다른 사용자가 어떤 item을 좋아했는지는 직접 사용하지 않는다.
Dot product를 similarity로 사용하기
가장 단순한 similarity는 dot product이다.
- 는 사용자 의 feature 에 대한 선호이다.
- 는 item 의 feature 값이다.
- 는 feature space의 dimension이다.
와 가 모두 binary vector이면 해석이 특히 간단하다. 같은 차원에서 두 값이 모두 일 때만 곱 가 이 된다. 따라서 dot product는 사용자와 item에서 동시에 활성화된 feature의 수이다.
공통 feature가 많을수록 score가 커지므로 더 유사한 item이라고 판단한다.
원문 예제의 score 계산
원문의 app 예제에서 세 candidate의 dot product는 다음과 같다.
| Candidate app | User와 겹치는 feature 수 | Dot product | 해석 |
|---|---|---|---|
Science R Us의 교육 app | 2 | 교육 category와 선호 publisher가 모두 일치한다. | |
Healthcare의 건강 app | 1 | feature 하나만 일치한다. | |
TimeWastr의 casual app | 0 | 활성 feature가 겹치지 않는다. |
따라서 Science R Us가 만든 교육 app의 score가 가장 높고, 이 app을 먼저 추천한다. 이 계산은 model이 내린 추천을 공통 feature로 설명할 수 있다는 장점도 보여 준다.
Dot product에서 주의할 점
Binary feature 예제에서는 dot product가 자연스럽지만, 실제 vector의 크기가 서로 다르면 norm이 큰 vector가 높은 score를 받기 쉽다. Item이 많은 feature를 가지거나 user profile에 많은 feature가 활성화되어 있다는 이유만으로 score가 커질 수 있다.
Vector 방향의 유사성에 집중하려면 cosine similarity를 사용할 수 있다.
Cosine similarity는 두 vector의 norm으로 dot product를 나눈다. 어떤 similarity를 사용할지는 feature의 의미와 추천 목표에 따라 결정해야 한다. Dot product, cosine similarity, Euclidean distance는 같은 embedding이라도 서로 다른 ranking을 만들 수 있다.
전체 추천 흐름
Content-based filtering의 기본 흐름은 다음과 같다.
- Domain 지식을 이용해 item을 설명할 feature를 정한다.
- 각 item을 feature vector 로 변환한다.
- 사용자의 explicit·implicit feedback을 같은 공간의 vector 로 변환한다.
- 각 candidate에 대해 를 계산한다.
- 이미 소비한 item이나 정책상 제외할 item을 filter한다.
- Score가 높은 candidate를 추천한다.
실제 대규모 시스템에서는 모든 item을 매번 비교하기보다 approximate nearest neighbor search를 이용해 user vector와 가까운 item을 빠르게 찾을 수 있다. 이 경우에도 핵심 원리는 같은 embedding space에서 가까운 vector를 찾는 것이다.
장점
다른 사용자의 data가 없어도 된다
현재 사용자의 feature와 item feature만 있으면 score를 계산할 수 있다. 다른 사용자의 interaction을 함께 처리하지 않아도 되므로 user 수가 늘어날 때 비교적 독립적으로 확장할 수 있다.
이 특성은 사용자 간 행동 data를 공유하기 어려운 환경에서도 유용하다. 다만 실제 privacy는 feature 생성과 log 저장 방식까지 함께 고려해야 하며, content-based라는 이유만으로 자동으로 보장되는 것은 아니다.
개인의 구체적인 관심사를 반영한다
대다수 사용자가 좋아하는 인기 item이 아니더라도 현재 사용자의 profile과 잘 맞으면 높은 score를 줄 수 있다. 따라서 소수 사용자만 찾는 niche item을 추천하는 데 유리하다.
새 item을 비교적 쉽게 다룬다
새 item에 대한 interaction이 아직 없더라도 feature vector를 만들 수 있으면 기존 user profile과 바로 비교할 수 있다. Collaborative filtering에서 자주 나타나는 item-side cold-start 문제를 어느 정도 줄일 수 있다.
추천 이유를 feature로 설명하기 쉽다
Score에 크게 기여한 공통 feature를 확인하면 “교육 category를 선호하고 같은 publisher의 app을 사용했기 때문에 추천했다”와 같은 설명을 만들 수 있다. Hand-engineered feature를 사용하는 단순 model일수록 이 해석이 직접적이다.
한계
Feature engineering에 domain knowledge가 필요하다
Model이 볼 수 있는 정보는 사람이 정의한 feature representation에 제한된다. 중요한 feature를 빠뜨리거나 서로 다른 의미를 같은 category로 묶으면 좋은 similarity를 계산할 수 없다.
예를 들어 영화의 장르와 감독만 feature로 사용하면 영상미, 서사 구조, 분위기처럼 취향을 가르는 요소를 반영하기 어렵다. Text-image encoder로 feature를 자동 추출할 수 있지만, 어떤 data와 objective로 representation을 학습할지라는 설계 문제는 여전히 남는다.
아이템 feature에 들어있지 않은 정보는 추천 모델도 활용할 수 없다.
기존 관심사 밖으로 확장하기 어렵다
User profile과 비슷한 item을 찾는 구조이므로 사용자가 이미 좋아한 것과 유사한 item이 반복해서 추천되기 쉽다. 사용자가 아직 접하지 않은 새로운 category에 관심이 있을 가능성을 발견하는 serendipity가 약하다.
이 문제는 overspecialization 또는 filter bubble로 이어질 수 있다.
exploration candidate, 인기 item, editorial candidate 등을 섞거나 re-ranking 단계에서 diversity를 반영해 완화한다.
새 사용자에게는 signal이 부족하다
새 item은 metadata가 있으면 추천할 수 있지만, 행동 이력이 없는 새 사용자는 profile vector를 만들 정보가 부족하다. Onboarding에서 관심 category를 선택하게 하거나 context, 인기 순위, 짧은 exploration을 이용해야 한다.
Feature 간 상호작용을 직접 표현하기 어렵다
단순 dot product는 같은 차원의 feature가 겹치는지를 더한다. “특정 publisher의 교육 app은 좋아하지만 같은 publisher의 game은 싫다”처럼 feature 조합에 따른 복잡한 취향은 선형 score만으로 충분히 표현하기 어렵다. 이런 경우 cross feature나 nonlinear model을 추가할 수 있다.
Content-based와 collaborative filtering의 차이
두 방법의 가장 중요한 차이는 추천 근거이다.
| 구분 | Content-based filtering | Collaborative filtering |
|---|---|---|
| 핵심 data | Item feature와 한 사용자의 feedback | 여러 사용자의 user–item interaction |
| 추천 근거 | 사용자가 좋아한 item과 내용이 비슷함 | 비슷한 사용자가 좋아했거나 같은 사용자들이 함께 소비함 |
| Feature 설계 | Domain knowledge가 많이 필요함 | Latent embedding을 interaction에서 학습 가능함 |
| 새로운 관심사 발견 | 제한적임 | 상대적으로 유리함 |
| 대표 cold start | 새 사용자 | 새 사용자와 새 item |
“최근 설치한 app과 비슷한 app을 추천했다”면 다른 사용자를 고려하지 않았으므로 content-based filtering이다. 다음 글에서는 여러 사용자의 interaction을 동시에 이용해 latent user·item embedding을 학습하는 collaborative filtering을 다룬다.
정리
- Content-based filtering은 item과 사용자를 같은 feature space에 표현한다.
- User profile은 explicit preference와 과거 행동에서 얻은 implicit signal로 만들 수 있다.
- Dot product를 사용하면 binary vector에서는 공통으로 활성화된 feature 수가 score가 된다.
- 다른 사용자의 data 없이도 개인의 구체적인 관심사와 niche item을 반영할 수 있다.
- 추천 성능은 feature quality에 크게 의존하며, 기존 관심사와 유사한 item에 갇히기 쉽다.
- 새 item은 feature만 있으면 다루기 쉽지만, interaction이 없는 새 사용자는 별도의 onboarding이나 exploration이 필요하다.
출처
- Google for Developers, Content-based filtering: Basics
- Google for Developers, Content-based filtering: Advantages & disadvantages
이 글은 위 Google Developers 문서를 바탕으로 개인 학습용으로 재구성하고 설명을 보강한 글이다. 원문 콘텐츠와 그림은 Creative Commons Attribution 4.0 License에 따라 이용하였다.