
Google 공식 원문: Candidate generation overview
Candidate generation은 전체 corpus에서 현재 query와 관련 있을 가능성이 높은 item을 빠르게 추려내는 추천 시스템의 첫 단계이다. 대규모 서비스에서는 모든 item을 정교한 scoring model에 넣을 수 없으므로, 이 단계가 수백만∼수십억 개의 item을 수백∼수천 개 수준의 후보로 줄인다.
이 과정에서 자주 사용하는 핵심 표현이 embedding이다. Query와 item을 같은 vector 공간에 놓고 가까운 item을 찾으면, 거대한 corpus를 vector 검색 문제로 바꿀 수 있다. 다만 무엇을 가까움으로 볼지는 하나로 정해져 있지 않다. Cosine, dot product, Euclidean distance는 vector의 방향과 크기를 서로 다르게 반영하므로 같은 후보라도 순위가 달라진다.
Candidate generation의 역할
전체 item 집합을 , 한 추천 요청을 , candidate generator가 반환하는 후보 집합을 라고 하자.
대규모 추천 시스템에서는 후보 수가 전체 corpus보다 훨씬 작아야 한다.
Candidate generator의 목표는 최종 순위를 완벽하게 맞히는 것이 아니다. 사용자에게 실제로 좋은 item이 작은 후보 집합에서 누락되지 않도록 하면서, 제한된 latency 안에 결과를 반환하는 것이 우선이다. 이 때문에 candidate generation은 보통 precision보다 recall을 더 중시한다. 다소 관련 없는 후보가 섞이더라도 이후 scoring에서 걸러낼 수 있지만, 이 단계에서 제외된 item은 뒤 단계가 다시 살릴 수 없기 때문이다.
한 서비스는 서로 다른 신호를 쓰는 여러 generator를 함께 운영할 수 있다.
는 content-based, collaborative, 인기 item, 구독 feed처럼 서로 다른 source가 만든 후보 집합이다. 합친 후보는 중복 제거와 간단한 filtering을 거쳐 scoring 단계로 전달된다.
두 가지 기본 접근
공식 과정은 candidate generation의 대표적인 접근으로 content-based filtering과 collaborative filtering을 소개한다.
| 접근 | 비교에 사용하는 정보 | 기본 직관 | 예시 |
|---|---|---|---|
| Content-based filtering | item feature와 사용자가 좋아한 item | 좋아한 것과 내용이 비슷한 item을 추천한다. | 고양이 영상을 본 사용자에게 귀여운 동물 영상을 추천한다. |
| Collaborative filtering | 여러 사용자의 item 상호작용 패턴 | 비슷한 행동을 한 사용자가 좋아한 item을 추천한다. | 사용자 A와 B의 취향이 비슷하고 B가 영상 1을 좋아했다면 A에게도 영상 1을 추천한다. |
Content-based filtering
Content-based filtering은 item의 속성을 이용한다. 영상이라면 제목, 설명, topic, creator 같은 feature를 표현하고, 사용자가 과거에 선호한 item과 비슷한 후보를 찾는다.
이 접근은 왜 이 item을 추천했는지를 item feature로 설명하기 쉽고, 다른 사용자의 행동이 적은 상황에서도 콘텐츠 정보가 있으면 동작할 수 있다. 반면 사용할 feature를 잘 설계해야 하며, 사용자가 이미 소비한 것과 비슷한 범위에 추천이 갇히기 쉽다.
Collaborative filtering
Collaborative filtering은 사용자와 item의 상호작용을 함께 이용한다. Item의 내용이 직접 비슷하지 않더라도 같은 사용자들이 반복해서 함께 소비했다면 가까운 관계로 학습할 수 있다.
예를 들어 한 사용자가 본 영상들과 표면적인 topic이 전혀 다른 영상이라도, 비슷한 시청 패턴의 사용자들이 그 영상을 선호했다면 후보가 될 수 있다. 이는 예상하지 못한 item을 발견하게 하는 장점이 있지만, 상호작용이 거의 없는 새 사용자나 새 item에서는 충분한 신호를 얻기 어렵다.
두 접근은 배타적이지 않다. 실제 시스템에서는 content feature와 interaction feature를 함께 학습하거나, 각각의 generator가 만든 후보를 합치는 하이브리드 구성이 흔하다.
Embedding 공간
Embedding은 query와 item을 저차원 vector 공간으로 mapping한 표현이다. Embedding 공간을 다음과 같이 둔다.
는 embedding dimension이다. 보통 는 전체 item 수 보다 훨씬 작다. 추천 요청과 item은 각각 다음 vector로 표현된다.
여기서 기호의 의미는 다음과 같다.
- : 사용자 history와 현재 context를 포함한 query이다.
- : 추천 가능한 item이다.
- : query를 embedding으로 변환하는 model이다.
- : item을 embedding으로 변환하는 model이다.
- : query embedding이다.
- : item 의 embedding이다.
- : embedding vector의 dimension이다.
Embedding의 각 dimension을 사람이 지정한 장르 하나와 일대일로 해석할 필요는 없다. 학습은 사용자와 item의 관계를 설명하는 latent factor를 여러 dimension에 분산해 표현할 수 있다. 같은 사용자가 자주 소비하거나 유사한 context에서 선택되는 item은 가까운 곳에 놓이도록 학습된다.
Query와 item을 같은 공간에 두면 candidate generation은 query vector 근처의 item vector를 찾는 nearest-neighbor search로 바뀐다. 유사도 함수를 라고 하면 다음과 같이 쓸 수 있다.
주어진 에 대해 높은 유사도를 갖는 item 개를 찾는 문제는 다음과 같다.
Corpus가 작다면 모든 를 비교할 수 있지만, item이 수백만 개 이상이면 매 요청마다 exact search를 수행하기 어렵다. 실제 retrieval에서는 item embedding을 미리 계산해 index에 저장하고, approximate nearest neighbor search를 이용해 속도와 recall 사이의 균형을 맞출 수 있다.
유사도를 정의하는 세 가지 방법
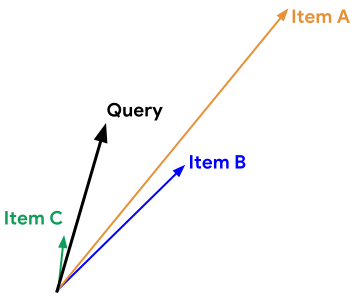
공식 과정은 embedding의 가까움을 정하는 대표적인 방법으로 cosine similarity, dot product, Euclidean distance를 제시한다.
Cosine similarity
Cosine similarity는 두 vector 사이 angle의 cosine을 계산한다.
Vector의 norm을 나누기 때문에 크기보다 방향을 비교한다. 두 vector가 같은 방향이면 , 직교하면 , 반대 방향이면 이다. 추천 embedding이 모두 양수일 필요는 없으므로 일반적으로 값의 범위는 다음과 같다.
Cosine similarity는 item embedding의 norm에 순위가 좌우되는 것을 원하지 않을 때 유용하다. 학습 데이터에 자주 등장한 인기 item의 vector가 커지더라도 방향이 query와 맞지 않으면 높은 점수를 받지 않는다.
Dot product
Dot product는 같은 위치의 원소를 곱해 모두 더한다.
Angle과 norm으로 풀어 쓰면 다음과 같다.
따라서 dot product는 방향이 잘 맞는지뿐 아니라 vector의 크기도 함께 반영한다. Query 하나에 대해 후보를 비교할 때 는 모든 후보에 공통이므로, 상대 순위에는 주로 item norm 가 추가 영향을 준다.
모든 embedding을 L2 normalization하면 norm이 이므로 dot product와 cosine similarity가 같아진다.
Euclidean distance
Euclidean distance는 두 vector 사이의 직선거리를 계산한다.
Cosine과 dot product는 값이 클수록 비슷하지만, Euclidean distance는 작을수록 가깝다. 모든 점수를 큰 값이 좋은 형태로 통일해야 한다면 음수를 붙여 similarity로 정의할 수 있다.
Embedding을 normalization한 경우 squared Euclidean distance와 dot product 사이에는 다음 관계가 성립한다.
식을 전개하면 그 이유를 확인할 수 있다.
직관적으로는 두 embedding을 길이 인 구의 표면에 올려놓는 것과 같다. 길이가 고정되면 두 vector 사이의 거리를 바꿀 수 있는 것은 방향뿐이다. 두 vector의 방향이 가까워질수록 가 커지고 두 끝점을 잇는 직선거리는 짧아진다. 두 embedding의 길이를 로 맞춰놓으면, 내적이 클수록 두 vector 사이의 Euclidean distance가 작아진다는 것이다.
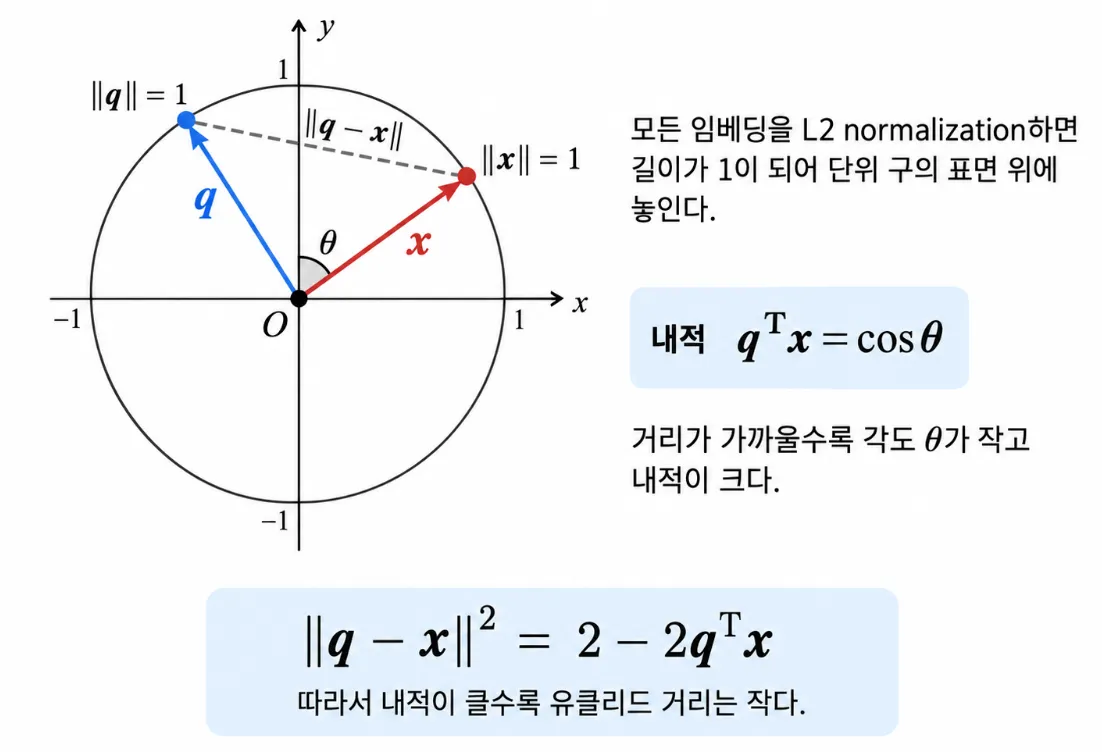
따라서 모든 vector의 norm이 이면 cosine, dot product, Euclidean distance는 같은 순위를 만든다. 세 방법의 차이는 embedding norm이 서로 다를 때 뚜렷해진다.
같은 vector도 metric에 따라 순위가 달라진다
앞의 그림에서 검은 vector는 query, A, B, C는 후보 item이다. 각 metric은 서로 다른 특성을 우선하므로 1위가 달라진다.
- Dot product는 Item A를 선호한다. A의 norm이 가장 크기 때문에 angle이 최상이 아니어도 내적값이 커질 수 있다.
- Cosine similarity는 Item C를 선호한다. C가 query와 이루는 angle이 가장 작아 방향이 가장 비슷하다.
- Euclidean distance는 Item B를 선호한다. Embedding 공간에서 B의 끝점이 query의 끝점과 물리적으로 가장 가깝다.
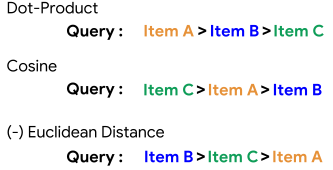
이 예시는 유사도 함수가 단순한 구현 세부사항이 아님을 보여준다. Model은 선택한 metric에서 positive pair의 점수를 높이도록 embedding을 학습하므로, 학습 objective와 serving 단계의 retrieval metric도 서로 맞아야 한다.
어떤 similarity measure를 선택할 것인가
Cosine과 dot product의 가장 중요한 차이는 embedding norm을 정보로 사용할지 여부이다.
인기 신호를 반영하고 싶은 경우
학습 데이터에 자주 등장하는 item은 더 많은 gradient update를 받는다. 학습 방식에 따라 인기 있는 item의 embedding norm이 커질 수 있으며, dot product는 이 norm을 통해 popularity를 점수에 반영한다.
이는 인기 item을 우선하는 것이 서비스 목표에 맞을 때 유용하다. 그러나 큰 norm의 item이 query 방향과 조금만 맞아도 상위권을 지배할 수 있다. 개인화보다 popularity가 과도하게 강해지는 문제가 생길 수 있다는 뜻이다.
Norm의 영향을 줄이고 싶은 경우
Cosine similarity는 norm을 제거하고 방향만 비교한다. Dot product와 cosine 사이의 중간 정도로 norm을 반영하고 싶다면 다음 family를 사용할 수 있다.
까지 확장해서 생각하면 cosine similarity가 되고, 이면 dot product가 된다.
를 validation data에서 조정하면 방향 유사도는 유지하면서 item norm, 즉 popularity와 연결될 수 있는 신호의 영향력을 완화할 수 있다.
희소한 item과 초기화 문제
상호작용이 드문 item은 학습 중 embedding update를 거의 받지 못한다. 이런 item의 embedding이 우연히 큰 norm으로 초기화되면 dot product 기반 retrieval에서 관련성보다 높은 점수를 받을 수 있다.
이를 줄이기 위해 다음 요소를 함께 점검해야 한다.
- Embedding 초기 norm이 지나치게 크지 않도록 initialization을 설계한다.
- L2 regularization이나 norm constraint로 vector 크기를 제어한다.
- Item frequency별 score와 추천 노출량을 관찰한다.
- Cold-start item에는 content feature를 함께 사용한다.
metric 선택은 Popular item의 집중도, tail item의 노출, 새 item의 cold start, retrieval latency까지 함께 평가해야 한다.
실무 관점의 점검 순서
Embedding 기반 candidate generator를 설계할 때는 다음 순서로 생각할 수 있다.
- Query를 정의한다. 사용자 ID, history, 현재 item, context 중 어떤 정보를 사용할지 정한다.
- Positive 관계를 정의한다. 클릭, 시청 완료, 구매 등 어떤 행동을 가까운 pair로 학습할지 정한다.
- Embedding model을 학습한다. Query와 positive item은 가깝게, negative item은 멀게 만든다.
- Similarity measure를 정한다. Norm을 popularity 신호로 사용할지 판단한다.
- Retrieval index를 구성한다. 학습된 item embedding을 저장하고 Top- 검색을 제공한다.
- 후보 품질과 편향을 평가한다. Recall뿐 아니라 coverage, popularity concentration, latency를 함께 확인한다.
Candidate generation에서 만든 후보가 이후 단계의 상한을 결정한다. 좋은 scoring model이 있어도 필요한 item이 후보에 없으면 최종 추천에 포함할 수 없다.
확인 문제
Candidate generation에서 recall이 중요한 이유는 무엇인가?
관련 item이 후보에서 빠지면 scoring과 re-ranking이 그 item을 복구할 수 없기 때문이다. 일부 불필요한 후보는 뒤 단계에서 제거할 수 있으므로 첫 단계에서는 좋은 item을 넓게 포함하는 것이 중요하다.
Normalized embedding에서는 세 metric이 어떤 관계인가?
Cosine similarity와 dot product가 같아지고, squared Euclidean distance는 가 된다. 따라서 세 metric이 만드는 후보 순위는 같다.
Dot product가 popularity를 반영할 수 있는 이유는 무엇인가?
Dot product에는 item embedding의 norm이 곱해진다. 자주 등장한 item의 norm이 학습 과정에서 커지는 경우, 방향이 비슷한 두 item 중 norm이 큰 인기 item이 더 높은 점수를 얻을 수 있다.
정리
- Candidate generation은 거대한 corpus를 scoring 가능한 작은 후보 집합으로 줄인다.
- Content-based filtering은 item feature의 유사성을, collaborative filtering은 사용자와 item의 상호작용 패턴을 이용한다.
- Query와 item을 같은 embedding 공간에 두면 후보 생성은 nearest-neighbor search가 된다.
- Cosine은 방향, dot product는 방향과 norm, Euclidean distance는 두 점의 물리적 거리를 반영한다.
- Normalized embedding에서는 세 metric이 같은 순위를 만들지만, norm이 다르면 metric에 따라 순위가 달라진다.
- Dot product에서 embedding norm은 popularity 신호가 될 수 있으므로 initialization, regularization, 노출 편향을 함께 점검해야 한다.
출처
- Google for Developers, Candidate generation overview
- TensorFlow, Embedding Projector
이 글은 Google for Developers의 Recommendation Systems 과정 내용을 바탕으로 재구성하고 설명을 보강한 학습 노트이다. 원문 콘텐츠와 그림은 Creative Commons Attribution 4.0 License에 따라 이용하였다.