
핵심 한 줄 정리
GAN은 discriminator와 generator의 adversarial game으로 data distribution을 암묵적으로 맞추고, diffusion과 rectified flow는 노이즈와 데이터 사이의 경로를 학습해 반복적인 reverse process로 샘플을 생성한다.
중요 개념 정리
Implicit generative model
명시적 밀도 모델(explicit density model)은 데이터 에 대한 확률밀도 를 명시적으로 정의한다. Autoregressive model은 이를 정확하게 계산하고, VAE는 로그우도의 하한인 ELBO를 계산한다.
Autoregressive model은 의 결합분포를 각 성분의 조건부분포의 곱으로 분해한다.
여기서 는 모델의 파라미터이고, 은 한 샘플 를 이루는 성분의 개수이다. 는 번째 성분이며, 앞의 성분 이 주어졌을 때의 조건부분포를 계산한다. 첫 번째 성분에는 앞선 성분이 없으므로 을 사용한다.
따라서 이미지 하나가 주어지면 그 이미지의 우도를 계산할 수 있으며, 관측된 훈련 데이터의 우도를 직접 최대화하는 최대우도(maximum likelihood) 학습이 가능하다.
VAE는 관측되지 않은 잠재변수 를 도입하고, 가능한 모든 를 주변화하여 를 정의한다. 이 적분을 직접 계산하기 어려우므로 ELBO를 최대화하는 방식으로 학습한다.
는 사전분포, 는 디코더가 모델링하는 조건부분포, 는 인코더가 만드는 근사 사후분포이다. 오른쪽의 두 항이 ELBO이며, 은 두 분포 사이의 차이를 나타내는 KL divergence이다.
슬라이드의 표기에는 부등식 왼쪽의 가 생략되어 있다. ELBO가 하한을 제공하는 대상은 로그우도 이며, 정확한 관계는 다음과 같다.
Autoregressive model과 VAE는 모두 관측 데이터의 우도를 높이는 관점에서 학습한다. Autoregressive model은 정확한 우도를 직접 다루고, VAE는 직접 계산하기 어려운 로그우도 대신 계산 가능한 하한을 최적화한다.
암묵적 밀도 모델(implicit density model)은 주어진 데이터 의 확률밀도 값을 직접 계산하는 대신, 학습한 분포에서 샘플을 생성하는 절차를 학습한다. 쉽게 샘플링할 수 있는 분포에서 잠재변수나 노이즈를 뽑고, 이를 데이터 샘플로 변환하는 방식이다.
는 표준정규분포처럼 쉽게 샘플링할 수 있는 분포이고, 는 학습한 생성 과정이 암묵적으로 정의하는 분포이다. GAN에서는 이 변환을 generator 가 수행한다.
새로운 를 뽑아 generator에 넣으면 새로운 샘플을 생성할 수 있다. 하지만 특정 이미지 를 주었을 때 그 이미지의 확률밀도 를 직접 계산할 수는 없다. 분포가 샘플을 만들어 내는 과정 안에 암묵적으로 정의되어 있다는 점에서 GAN은 암묵적 밀도 모델이다.
GAN은 generator forward 한 번으로 샘플을 만드는 direct sampling 방식이다. Diffusion model은 여러 denoising 또는 integration step을 반복하는 iterative sampling 방식이다.
Generative Adversarial Networks (GAN)
GAN은 샘플을 만드는 generator와 실제 샘플인지 구분하는 discriminator를 함께 학습하는 생성적 적대 신경망이다. Generator는 실제 데이터처럼 보이는 샘플을 만들려 하고, discriminator는 실제 샘플과 생성된 샘플을 구분하려 한다. 두 신경망이 서로 경쟁하는 과정에서 generator가 실제 데이터 분포를 따르는 샘플을 만들도록 학습한다.
기본 설정은 훈련 데이터 가 알 수 없는 실제 데이터 분포 에서 샘플링되었다는 것이다.
여기서 는 번째 훈련 샘플이다. 실제 데이터 분포 의 정확한 형태는 알지 못하지만, 그 분포에서 관측된 훈련 샘플은 주어져 있다. 목표는 이 훈련 데이터를 이용해 같은 분포에서 새로운 샘플을 생성하는 방법을 학습하는 것이다.
예를 들어 고양이 사진을 생성하는 GAN이라면, 고양이 사진이 나타나는 어떤 확률분포를 가정하고 수집된 사진들을 그 분포의 관측 표본으로 보는 것이다. 분포 자체의 정확한 식을 아는 대신, 사진들을 통해 그 분포의 특징을 학습한다.
이 가정이 사람이 데이터를 선별하거나 전처리하지 않았다는 뜻은 아니다. 특정 클래스의 사진만 모으거나 전처리한 데이터셋도 학습에 사용할 수 있으며, 이때는 그 데이터셋이 나타내는 분포를 로 둔다.
이를 위해 generator 가 만드는 분포 를 에 가깝게 만들고자 한다.
먼저 미리 정해진 사전분포(known prior)에서 latent vector를 샘플링한다.
Generator는 를 data space의 샘플로 매핑한다.
Generator parameter 가 정해지면 mapping이 generated distribution 를 암묵적으로 정의한다. 의 density 값은 계산하지 못하더라도 를 뽑아 샘플을 생성할 수 있다.
Generator와 discriminator
GAN은 generator가 만든 샘플과 real sample을 구분하는 discriminator 를 함께 학습한다.
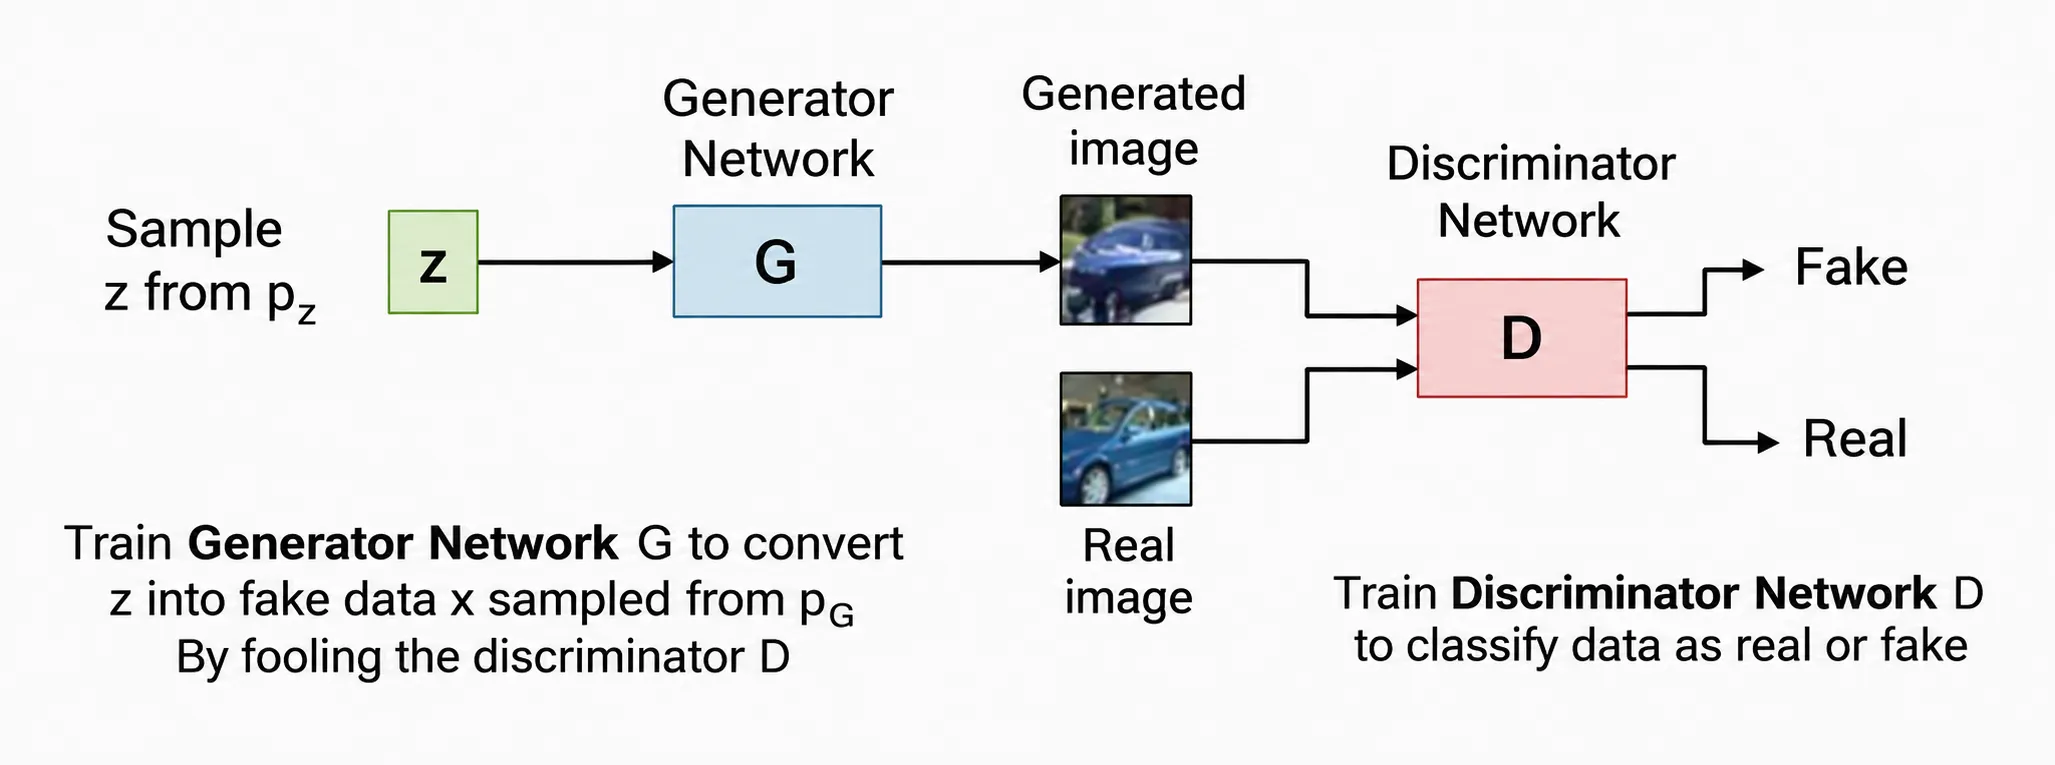
는 input 가 real data일 확률을 나타낸다.
- 에 가까우면 real이라고 판단한 것이다.
- 에 가까우면 generated sample이라고 판단한 것이다.
Discriminator는 사실(real)과 거짓(fake)를 정확히 구분하려 한다. Generator는 discriminator가 generated sample을 real이라고 판단하게 만들려 한다.
Generator는 정답 이미지와 직접 비교하는 reconstruction loss를 받지 않는다. Generated image가 discriminator를 통과할 때 생기는 gradient가 discriminator에서 이미지를 거쳐 generator까지 backpropagation된다.
Discriminator는 fixed dataset만 분류하는 일반적인 classifier와 다르다. Generator가 학습하면서 fake distribution이 계속 변하므로 discriminator가 풀어야 하는 classification problem도 non-stationary하다.
%% title: GAN의 Generator·Discriminator 경쟁 구조
%% caption: Generator는 latent noise를 fake sample로 바꾸고, discriminator는 real data와 fake sample을 구분한다. 두 네트워크는 반대 목표를 번갈아 최적화한다.
flowchart LR
    z["Latent Noise<br/>z ~ p(z)"] --> generator["Generator G"]
    generator --> fake["Fake Sample G(z)"]
    real["Real Sample<br/>x ~ p_data"] --> discriminator["Discriminator D"]
    fake --> discriminator
    discriminator --> realprob["Probability of Real"]
    realprob --> dloss["D: real ↑, fake ↓"]
    realprob --> gloss["G: fake를 real로 판단하게"]
    dloss -. "update" .-> discriminator
    gloss -. "gradient through D" .-> generator
GAN minimax objective
Original GAN objective는 다음과 같다.
Generator 는 파란색, discriminator 는 빨간색으로 구분한다. 초록색은 사전분포와 그 분포에서 샘플링한 를 나타낸다.
Discriminator는 를 최대화한다.
- Real sample에서는 을 원한다.
- Fake sample에서는 을 원한다.
Generator는 를 최소화한다. 첫 번째 항은 와 관계없으므로 generator는 두 번째 항만 바꿀 수 있다. Generator가 성공하려면 이 되어야 한다.
여기서 는 두 모델이 함께 최소화하는 공통 손실함수가 아니라, generator와 discriminator가 서로 반대 방향으로 최적화하는 minimax 게임의 가치함수이다. 같은 에 대해 G는 값을 낮추려 하고 D는 값을 높이려 한다.
Alternating optimization
Generator와 discriminator는 같은 파라미터를 공유하지 않으며 서로 반대 목표를 가진다. 따라서 미니배치마다 두 optimization을 번갈아 수행한다.
Discriminator는 를 최대화하므로 gradient를 더하고, generator는 를 최소화하므로 gradient를 뺀다. 두 업데이트를 번갈아 반복한다.
와 는 각각 discriminator와 generator의 learning rate이다. 업데이트되는 대상은 각 신경망의 parameter이며, 와 는 각각 그 파라미터에 대한 grad를 나타낸다. D를 업데이트할 때는 G를 고정하고, G를 업데이트할 때는 D를 고정한다.
Discriminator loss를 최소화하는 형태로 쓰면 다음과 같다.
한 iteration은 다음과 같이 볼 수 있다.
- Real minibatch 와 latent minibatch 를 샘플링한다.
- 를 만들되 discriminator update에서는 generator gradient를 막는다.
- 로 discriminator를 업데이트한다.
- 새 latent 를 샘플링해 를 만든다.
- Discriminator를 통과한 gradient로 generator를 업데이트한다.
Discriminator를 여러 번 업데이트한 뒤 generator를 한 번 업데이트하거나, 두 네트워크에 다른 learning rate를 사용하는 등 밸런스를 조정할 수 있다. 어느 한쪽이 지나치게 앞서면 상대 네트워크가 유용한 gradient를 받지 못한다.
Saturating generator loss의 문제
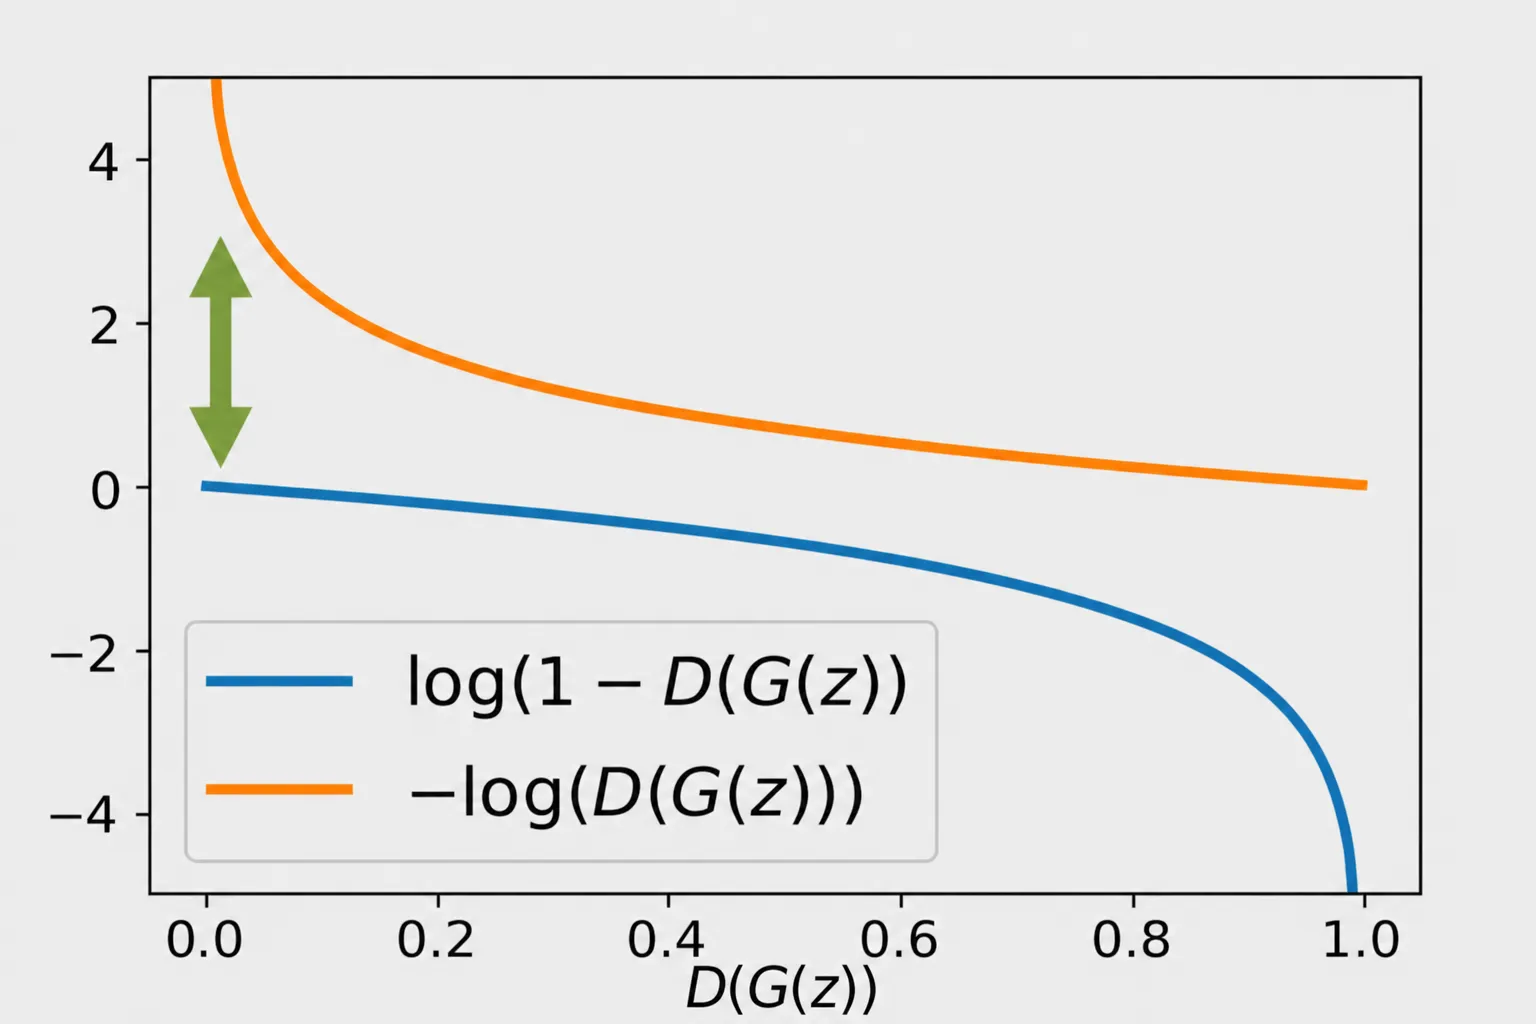
원래의 minimax 목적함수에서 generator가 최소화하는 항은 다음과 같다.
훈련 초기에 G는 무작위로 초기화되어 실제 이미지와 크게 다른, 무작위 잡음에 가까운 이미지를 만든다. D는 실제 샘플과 생성 샘플의 차이를 쉽게 학습하므로, 초기에 다음과 같이 두 종류의 샘플을 확실하게 구분할 수 있다.
기댓값 안에서 한 샘플의 손실항을 보면, 일 때 는 0에 가까워진다.
하지만 손실값이 0이라는 사실 자체가 문제는 아니다. 핵심은 D를 거쳐 G에 전달되는 gradient가 거의 0에 가까워져, G가 생성 결과를 개선하기 어렵다는 것이다.
생성 샘플에 대한 D의 sigmoid 직전 출력인 logit을 라고 두고, sigmoid 함수를 로 나타내면 다음과 같다.
D가 생성 샘플이라고 강하게 확신할 때는 logit이 큰 음수가 된다.
따라서 sigmoid 출력도 거의 0이다.
이처럼 sigmoid가 0에 가까운 값으로 포화되는 영역에서는 원래 minimax 손실을 통해 G에 전달되는 gradient가 매우 작아질 수 있다. D는 생성 샘플을 잘 구분하지만, G는 충분한 학습 신호를 받지 못해 학습이 느려지는 문제이다.
실제로는 다음 non-saturating generator loss를 많이 사용한다.
두 objective는 모두 을 원하지만 non-saturating loss는 discriminator가 fake를 확실하게 구분하는 초기 구간에서 더 큰 gradient를 제공한다.
Optimal discriminator와 distribution matching
Generator 를 고정했을 때 pointwise optimal discriminator는 다음과 같다.
이를 원래의 minimax 목적함수에 대입하면 다음 관계를 얻는다.
Jensen-Shannon divergence(JSD)는 두 확률분포의 차이를 재는 대칭적인 척도이다. , 일 때 중간 분포 를 만들고, 각 분포와 사이의 KL divergence를 평균낸다.
두 분포가 같으면 JSD는 0이다. 자연로그를 사용하면 의 유한한 범위를 가진다.
Jensen-Shannon divergence는 두 분포가 같을 때 0이다. 따라서 무한한 표현 능력(infinite capacity)의 와 , optimal discriminator, 완전한 optimization을 가정하면 global optimum은 다음 조건에서 생긴다.
최적의 discriminator 를 항상 가정할 수 있다면, G가 를 최소화하는 것은 와 사이의 JS divergence를 줄이는 것과 같다. 이상적인 최종점은 두 분포가 같아지는 상태이다.
하지만 이 결과는 실제 학습이 그 최적에 도달한다는 것을 보장하지 않는다. 신경망은 표현능력이 제한되어 있고 discriminator도 매 단계 최적화되지 않으며, data도 유한한 샘플만 관찰한다.
GAN loss를 해석하기 어려운 이유
일반적인 supervised model은 loss가 감소하면 training objective가 개선되고 있다고 해석할 수 있다. GAN에서는 generator와 discriminator가 동시에 바뀌므로 한쪽 loss의 절댓값만으로 sample quality를 판단하기 어렵다.
교대 학습 중의 값 자체나 그 절댓값만으로 generator와 discriminator가 문제를 얼마나 잘 해결하고 있는지 판단할 수 없다. 는 두 신경망의 상태에 함께 영향을 받기 때문에, 값이 낮아졌다는 사실만으로 생성 분포가 개선되었다고 볼 수 없다. 중요한 것은 생성 분포 가 실제 데이터 분포 와 얼마나 잘 맞는가이다.
같은 generator loss도 discriminator가 약해서 쉽게 속는 경우와 generator가 좋아서 강한 discriminator를 속인 경우에 모두 나타날 수 있다. Discriminator loss 역시 generator distribution이 계속 변하므로 stationary benchmark가 아니다.
따라서 GAN training에서는 다음을 함께 확인해야 한다.
- 일정한 latent seed에서 생성되는 샘플의 변화
- Sample diversity와 class coverage
- Nearest training sample과의 차이
- Fréchet Inception Distance, FID 같은 별도의 distribution-level metric
- Gradient norm, activation, NaN과 infinity 발생 여부
GAN loss curve가 쓸모없다는 뜻은 아니다. Optimization failure를 찾는 신호는 될 수 있지만, loss 하나가 perceptual quality를 직접 나타내지는 않는다.
FID는 real image와 generated image를 Inception feature space로 옮긴 뒤, 두 feature distribution을 Gaussian으로 근사하여 mean과 covariance의 차이를 측정한다. 값이 낮을수록 generated distribution이 real distribution에 가깝다고 해석하지만, feature extractor와 sample 수의 영향을 받으므로 단독 기준으로 사용하면 안 된다.
Mode collapse
Mode collapse는 서로 다른 latent 가 소수의 비슷한 출력으로 매핑되는 현상이다.
극단적으로 generator가 training sample 몇 개만 습득하고 거의 모든 에서 그 샘플들만 출력할 수 있다. 이 경우 일부 출력은 매우 사실적이라서 discriminator를 속일 수 있지만 의 다양한 mode를 덮지 못한다.
Mode collapse는 sample quality와 diversity가 다른 축이라는 점을 보여준다. 선명한 이미지 몇 장만 반복하는 모델은 좋은 generative model이 아니라고 설명한다.
GAN latent space
잘 학습된 GAN에서는 두 latent vector 사이를 interpolation하면 출력도 부드럽게 변하는 경우가 많다.
여기서 이다.
StyleGAN 계열에서는 latent를 이동할 때 얼굴이나 동물의 형태, 자세, 질감이 연속적으로 변하는 모습을 볼 수 있다. 이는 generator가 latent space에 데이터의 구조를 어느 정도 연속적으로 배치했음을 나타낸다.
하지만 매끄러운 latent space는 GAN 목적함수가 보장하는 성질이 아니다. Mode collapse처럼 를 무시하는 해결책도 가능하다.
일반적인 GAN에는 VAE encoder에 해당하는 변환이 없다. Generator는 만 학습한다. 주어진 이미지에 대응하는 latent를 찾으려면 를 직접 최적화하거나 별도의 encoder를 추가해야 한다.
훈련할 때 실제 이미지 와 prior에서 뽑은 는 정답 쌍으로 주어지지 않는다. 특정 가 특정 훈련 이미지를 복원하도록 감독하는 관계도 없다. Discriminator는 실제 이미지와 생성 이미지를 구분하고, generator는 그 판별을 이용해 생성 이미지 전체의 분포가 실제 데이터분포에 가까워지도록 학습한다.
라는 생성 관계는 있지만, 실제 훈련 이미지와 latent 사이의 개별 대응관계는 직접 감독하지 않고 두 분포를 맞춘다.
DCGAN과 StyleGAN
DCGAN은 convolutional generator와 discriminator, batch normalization, strided convolution 같은 설계 지침을 사용해 이미지 GAN의 안정성과 샘플 품질을 크게 높인 초기 모델이다. 제시된 구조는 대략 5-layer ConvNet으로 구성되었다.
StyleGAN 계열은 latent를 여러 layer에 주입하고 feature statistics를 조절하는 방식으로 고해상도 이미지와 조절 가능한 latent space를 만들었다. 복잡한 구조와 training recipe가 필요하지만 GAN이 매우 선명한 샘플을 만들 수 있음을 보여준다.
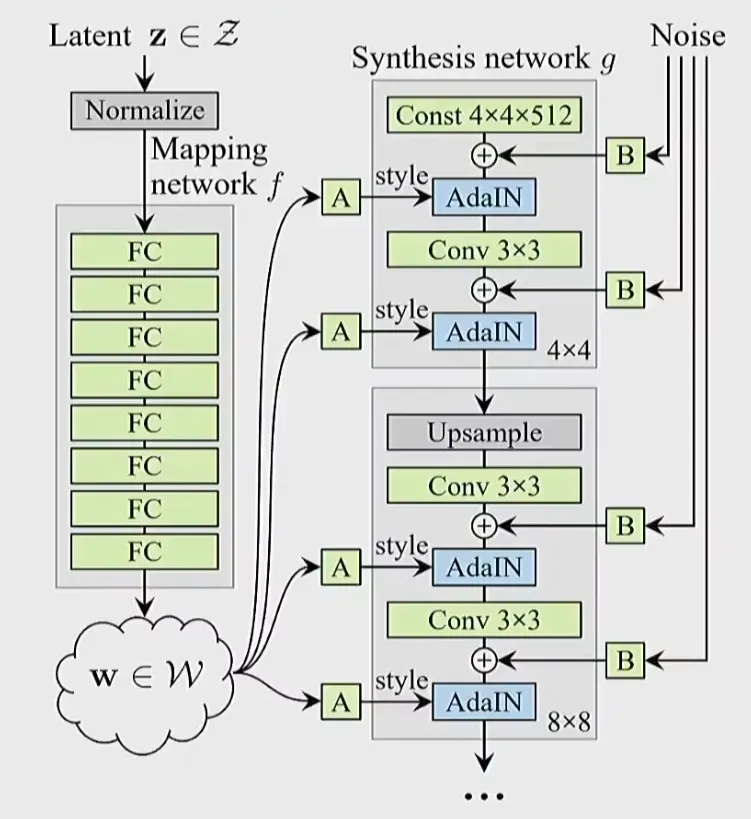
Inference에서는 discriminator를 버리고 generator만 사용한다.
Generator forward 한 번이면 되므로 샘플링 속도가 빠르다. 반면 adversarial training의 불안정성, mode collapse, 규모 확장의 어려움 때문에 이미지 생성의 중심은 점차 diffusion 계열로 이동하였다.
VAE와 GAN의 trade-off
VAE는 encoder가 입력 에 대한 approximate posterior 를 만들고, 여기서 뽑은 를 decoder가 원래 입력으로 복원하도록 학습한다. 따라서 주어진 이미지를 latent space로 보내는 경로와 재구성 관계를 모델 안에서 얻는다.
전통적인 VAE는 Gaussian reconstruction loss로 가능한 세부 특징을 평균내면서 흐릿한 이미지를 만드는 경향이 있었다. 잘 조정한 GAN은 더 선명하고 사실적인 샘플을 생성할 수 있지만, 기본 구조에 encoder가 없고 latent space의 매끄러움이나 조절 가능성도 목적함수만으로 보장되지 않는다.
GAN은 normalization, 샘플링 방식, 학습 설정에 민감해서 좋은 결과를 얻기까지 튜닝이 필요하다. 선명한 샘플과 빠른 생성이라는 장점에 더해, latent 역변환의 제약과 불안정한 학습이라는 비용을 함께 고려해야 한다.
Diffusion model의 핵심 직관
Diffusion model도 단순한 잡음 분포와 복잡한 데이터 분포 사이의 변환을 학습한다. GAN이 한 번의 deterministic generator forward로 를 로 바꾸는 데 비해 diffusion model은 여러 중간 noise level을 거쳐 이동한다.
연속적인 이미지 공간에서는 잡음과 데이터가 같은 shape를 갖는다.
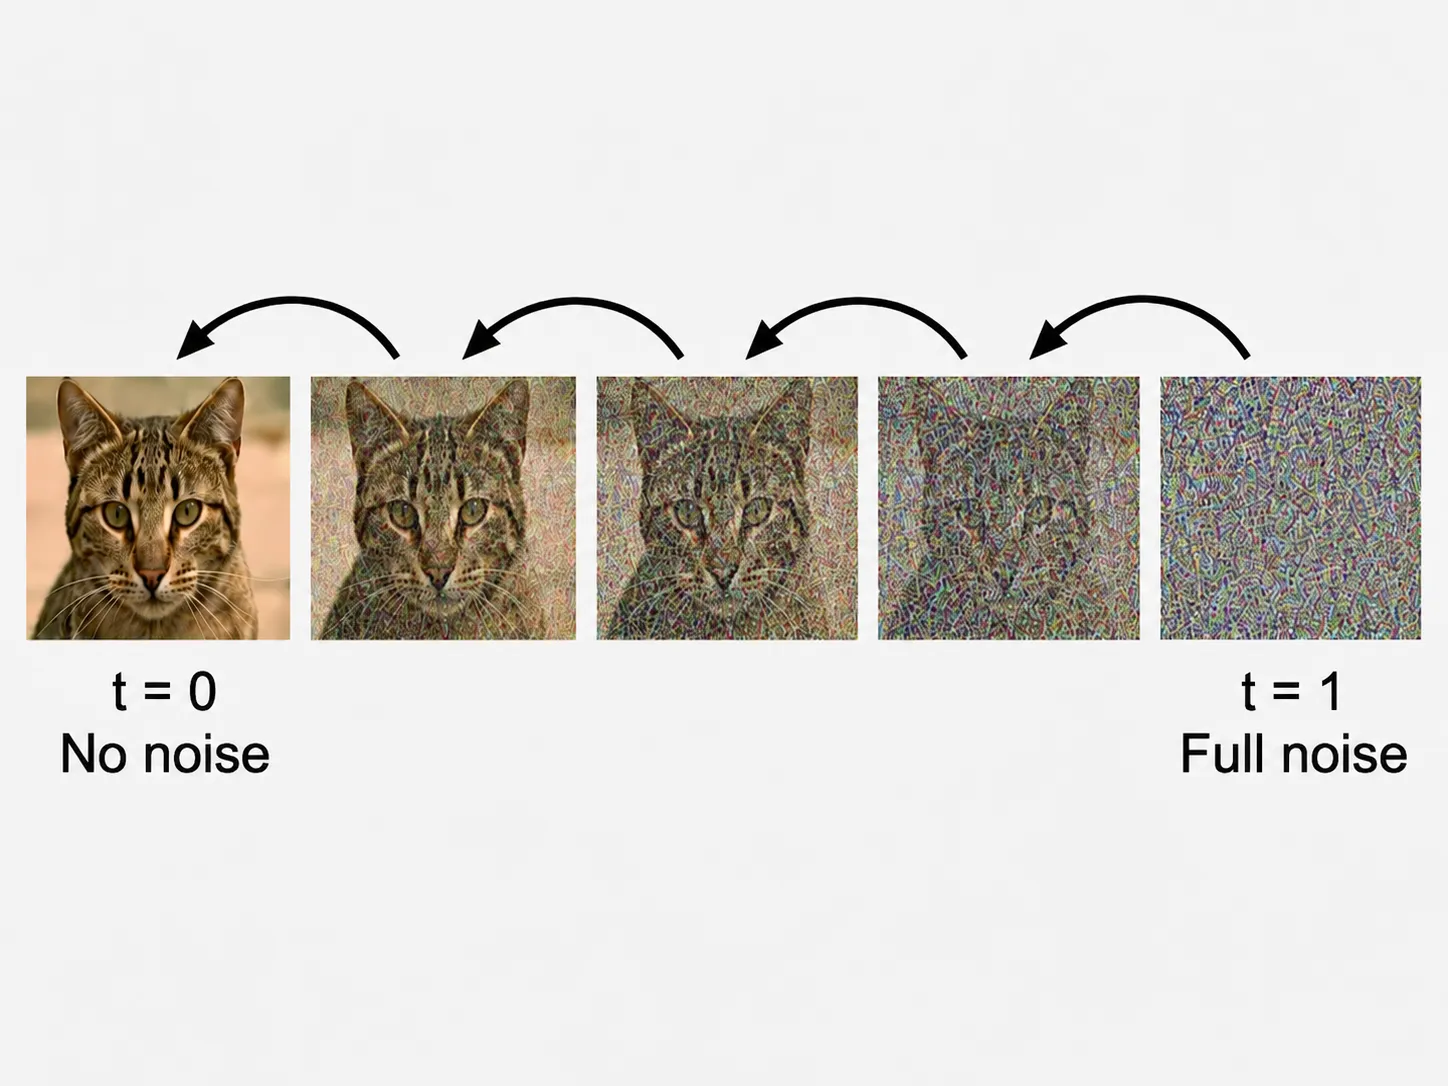
Noise level 를 에서 사이로 두면 다음처럼 해석할 수 있다.
- 은 잡음이 없는 데이터이다.
- 은 데이터와 잡음이 섞인 중간 상태이다.
- 은 순수한 잡음이다.
학습할 때는 원본 샘플에 알려진 잡음을 섞고, 모델이 잡음을 제거하는 데 필요한 방향이나 목표값을 예측하게 한다. 샘플링할 때는 순수한 잡음에서 시작해 에서 으로 반복 이동한다.
Forward corruption과 reverse generation
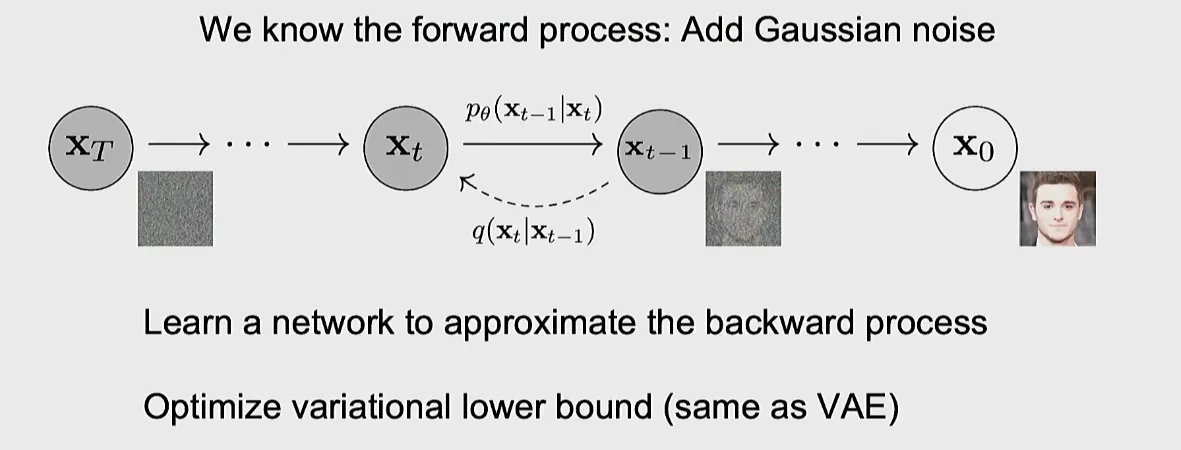
Diffusion 계열은 데이터 분포를 점차 단순한 잡음 분포로 바꾸는 forward process를 정의한다.
가 커질수록 에서 원본 데이터의 정보는 줄어들고 잡음이 많아진다.
훈련 데이터와 잡음이 주어지므로 forward process에서는 직접 샘플링할 수 있다. 어려운 부분은 reverse process이다.
모델은 각 와 noise level 를 보고 원본 데이터로 향하는 방향을 예측한다. 여러 작은 reverse step을 누적하면 잡음 샘플이 생성 데이터로 변한다.
%% title: Forward Corruption과 Reverse Generation
%% caption: Forward process는 원본 데이터에 잡음을 더해 단순한 분포로 이동하고, 샘플 생성은 학습한 벡터장을 따라 순수한 잡음에서 원본 샘플 방향으로 여러 단계를 거친다.
flowchart LR
    data["Clean Data x₀<br/>t = 0"] --> n1["Low Noise xₜ₁"]
    n1 --> n2["Medium Noise xₜ₂"]
    n2 --> noise["Pure Noise x₁<br/>t = 1"]
    noise -. "reverse step" .-> r2["Denoised State"]
    r2 -. "reverse step" .-> r1["Denoised State"]
    r1 -. "reverse step" .-> sample["Generated Sample x₀"]
Rectified flow
Rectified flow는 잡음 샘플과 데이터 샘플을 직선으로 연결하고 그 velocity field를 학습하는 방식이다.
직관적으로는 <데이터와 잡음 사이의 상태 공간 전체>에서 <어디로 움직이면 진짜 이미지 쪽으로 갈 수 있는지>를 알려주는 <화살표 지도>를 학습하는 것으로 볼 수 있다. 학습 과정에서는 데이터 -> 노이즈의 속도 벡터(velocity)를 배우고, 생성 과정에서는 그 방향을 거꾸로 따라 노이즈 -> 데이터로 이동한다.
이 강의에서는 Rectified flow를 diffusion model의 한 종류로 다룬다.
기본 가정은 Gaussian처럼 쉽게 샘플링할 수 있는 단순한 잡음 분포 와 실제 데이터분포 에서 얻은 샘플들이 주어져 있다는 것이다. 실제 데이터분포의 확률밀도 자체를 알 필요는 없고, 그 분포에서 관측한 훈련 데이터가 있으면 된다. 여기서는 잡음 분포로 를 사용한다.
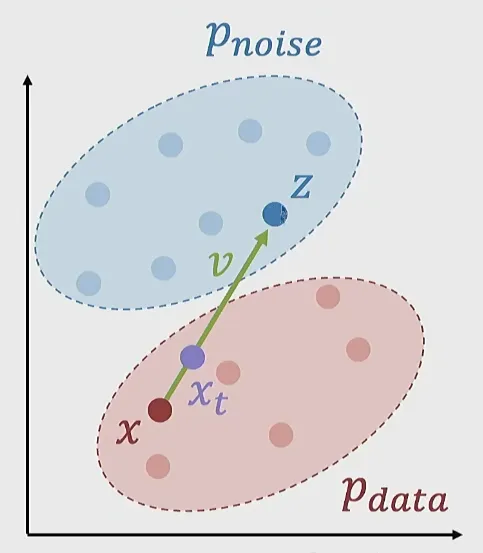
그림은 두 분포 사이의 관계를 2차원으로 단순화한 것이다. 실제 이미지와 잡음은 많은 픽셀 값을 가진 고차원 벡터이므로, 그림에서 얻은 거리나 공간 배치에 대한 직관이 고차원에서도 그대로 성립한다고 가정해서는 안 된다.
매 학습 단계에서 다음을 샘플링한다.
- 는 잡음 분포 에서 뽑은 잡음 샘플이다. 여기서는 이미지와 같은 크기의 표준정규 잡음을 사용한다.
- 는 실제 데이터분포 에서 얻은 훈련 샘플이다. 이미지 생성에서는 원본 이미지에 해당한다. 는 실제로는 유한한 훈련 데이터셋에서 샘플 하나를 선택한다는 뜻이다. 미지의 확률밀도를 계산해서 새 이미지를 뽑는 과정이 아니다.
- 는 데이터와 잡음을 얼마나 섞을지 정하는 시간 또는 noise level이다. 은 원본 데이터, 은 순수한 잡음에 해당한다.
- 은 과 사이의 균등분포이다. 같은 길이의 구간은 뽑힐 확률이 같으므로, 매 학습 단계에서 특정 noise level에 치우치지 않도록 를 무작위로 뽑는다.
와 는 서로 독립적으로 뽑는다. 특정 이미지에 원래 대응하는 잡음이나 latent를 알고 짝짓는 것이 아니라, 매 학습 단계에서 무작위로 훈련용 쌍을 만드는 것이다. 이 쌍에서 보간된 입력과 정답 velocity를 직접 계산할 수 있으므로, 미리 알려진 이미지와 latent의 대응관계 없이도 회귀 학습을 할 수 있다.
데이터와 잡음 사이의 보간(interpolation)과 ground-truth velocity를 다음처럼 정의한다.
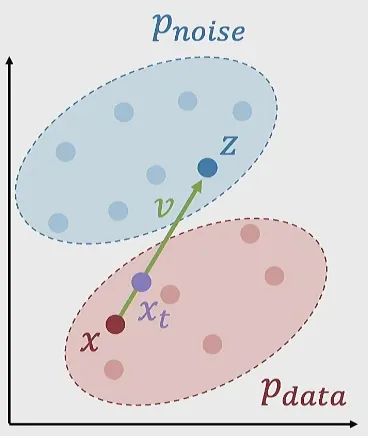
는 와 를 연결한 선분 위의 점이며, 가 그 위치를 정한다. 이면 이고 이면 이다. 여기서 잡음이 섞인 데이터를 만든다는 것은 원본 이미지와 잡음 사이를 선형 보간한다는 뜻이다.
는 데이터에서 잡음으로 향하는 ground-truth velocity이며, 이다.
학습할 parameter가 인 신경망 는 잡음이 섞인 샘플 와 시간 를 받아 velocity를 예측한다.
학습 목적함수는 단순한 mean squared error이다.
훈련에서는 직접 뽑은 와 가 있으므로 정답 를 계산할 수 있다. 예측 와 정답 사이의 MSE를 계산하고, 이 손실의 역전파를 통해 를 학습한다.
for x in dataset:
    z = torch.randn_like(x)
    t = random.uniform(0, 1)
    xt = (1 - t) * x + t * z
    v = model(xt, t)
    loss = (z - x - v).square().sum()
코드에서 v는 모델이 예측한 velocity이며, 정답은 z - x이다.
GAN과 달리 하나의 신경망과 회귀 손실을 사용한다. MSE가 낮아지면 목표 velocity에 대한 예측 오차가 줄어든다는 뜻이므로 학습 상태를 관찰하기 쉽다. 대규모 모델과 데이터셋으로 확장하기도 상대적으로 쉽다.
생성 모델의 공통 문제는 쉽게 샘플링할 수 있는 잡음과 생성하고 싶은 데이터 사이의 대응관계를 학습하는 것이다.
직관적으로 대응관계를 학습하는 이유는, 우리는 실제 데이터 분포에서 새 샘플을 직접 뽑는 방법을 모르기 때문이다. 우리가 가진 것은 훈련 데이터 몇개 뿐이고 실제 세상(universe)의 데이터 분포를 알고 있는것이 아니다. ( 는 불가능) 반면 가우시안 분포 같이 잘 알려진 단순한 분포에서는 원하는 만큼 샘플을 쉽게 뽑을 수 있다. () 그러면 자연스럽게 ‘쉽게 뽑을 수 있는 z를 하나 뽑아서 그걸 실제 데이터처럼 바꿔줄 수 있는 함수를 배우면 되지 않을까?’ 와 같은 발상이 가능하다. 결과적으로 생성모델은 를 학습하는것이다. 여기서 중요한점은 특정 z를 특정 훈련 이미지 하나에 대응시키는것이 아닌, z들을 많이 넣었을때 나온 전체 출력 분포가 실제 데이터 분포와 비슷해지게 만드는것이다. <샘플링하기 쉬운 분포를, 샘플링하고 싶은 복잡한 분포로 변환하는 방법을 학습한다.>
VAE는 encoder와 decoder의 재구성 관계를 학습하고 latent를 prior에 가깝게 규제한다. 생성할 때는 encoder 없이 prior에서 를 뽑아 decoder에 넣으므로, KL 항이 encoder가 만드는 를 샘플링하기 쉬운 prior에 가깝게 만들도록 압박한다.
GAN은 discriminator가 제공하는 분포 정합 목표를 통해 generator의 변환을 학습한다. 개별 의 정답 쌍은 없고, discriminator의 판별 신호가 전체 생성분포 를 실제 데이터분포 에 가깝게 만들도록 generator를 압박한다. 학습 후에는 를 generator에 넣어 한 번의 feedforward로 이미지를 얻는다.
Rectified flow는 무작위로 짝지은 데이터와 잡음에서 velocity 학습 목표를 만들고, 학습한 벡터장을 적분해 잡음에서 데이터로 이동하는 경로를 얻는다. 모델은 최종 이미지를 바로 출력하지 않고 현재 상태 와 시간 에서의 velocity를 예측한다. 부터 까지 중간 상태마다 velocity를 다시 예측하고 작은 이동을 누적하는 수치적분을 통해 최종 샘플 을 얻는다.
Rectified flow sampling
GAN은 generator 출력 자체가 생성 이미지이다. Rectified flow에서 의 출력은 현재 상태의 velocity이므로, 신경망을 한 번 통과시킨 결과가 완성된 이미지는 아니다. 예측 velocity를 이용해 샘플을 반복 갱신해야 한다.
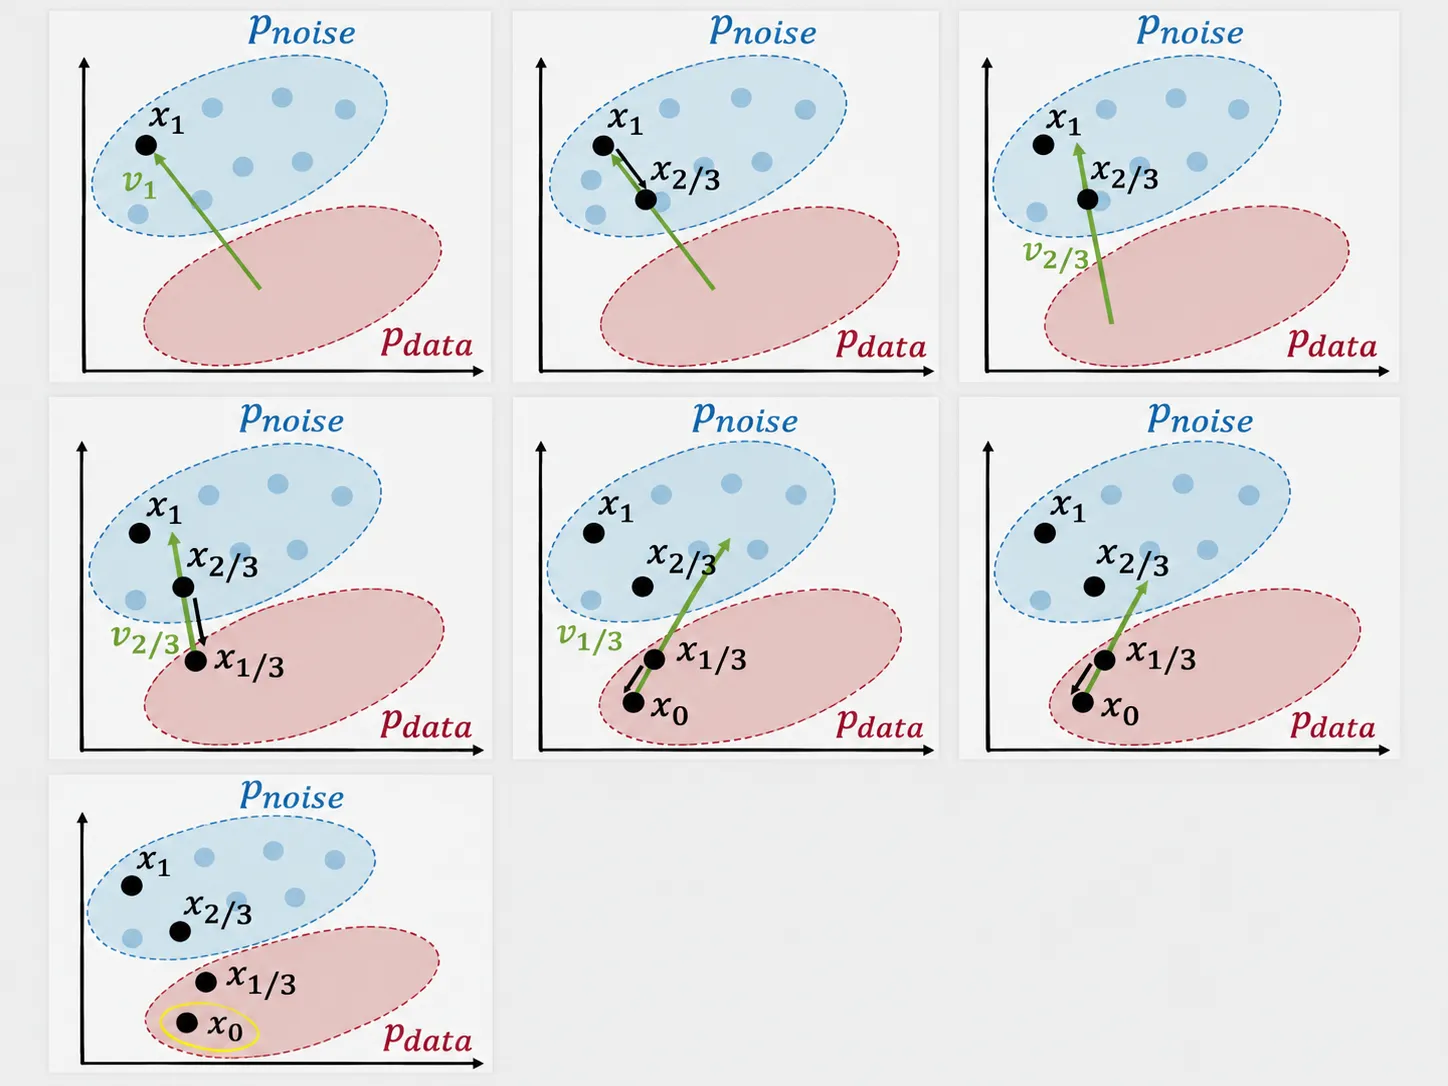
샘플링은 잡음에서 시작한다.
학습한 속도(velocity)는 가 증가하는 방향인 데이터에서 잡음으로 향한다. 샘플을 만들려면 에서 으로 ODE(상미분방정식)를 역방향으로 적분한다.
개 Euler step을 사용하고 라고 하면 다음과 같이 업데이트(수치적분)할 수 있다.
Euler step: 연속적인 적분을 작은 구간으로 쪼개서 근사하는 방법 아주 짧은 구간에서는 velocity가 거의 일정하다고 보고 로 이동량을 근사함.
시간이 줄어드는 방향으로 이동하므로() 예측 velocity에 를 곱해 현재 샘플에 더한다. 학습 목표 가 데이터에서 잡음으로 향하기 때문에, 샘플 생성에서는 그 반대 방향(잡음 -> 데이터)으로 작은 이동을 하는 것이다.
한 번 이동한 뒤에는 바뀐 샘플 와 시간 를 다시 신경망에 넣어 다음 velocity를 예측한다. 첫 예측 벡터 하나로 깨끗한 이미지까지 바로 이동하는 것이 아니라, 현재 위치에서 조금 이동하고 방향을 다시 예측하는 과정을 반복한다. 훈련용 보간 선분은 직선이지만, 학습한 벡터장을 따라 생성할 때의 전체 경로가 반드시 직선일 필요는 없다.
이 과정에서 모델의 parameter 는 고정되어 있고, 갱신하는 대상은 샘플이다. 업데이트 모양이 gradient descent와 비슷해도 손실함수의 gradient로 모델을 학습하는 단계가 아니라, 예측 velocity를 이용해 ODE를 수치 적분하는 단계이다.
이를 부터 까지 반복하면 최종 샘플 을 얻는다. 시작점으로 50 step을 사용할 수 있고, 모델과 solver의 성능이 충분하면 약 30 step에서도 적절한 결과를 얻을 수 있다.
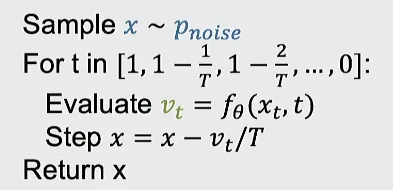
sample = torch.randn(x_shape)
for t in torch.linspace(1, 0, num_steps):
    v = model(sample, t)
sample = sample - v / num_stepsx_shape는 생성할 샘플의 shape이고, num_steps는 샘플링 반복 횟수이다. sample은 현재 샘플이며, v는 모델이 예측한 velocity이다.
Euler method는 가장 단순한 수치 적분 방법이다. 더 정교한 ODE solver를 사용하면 같은 품질을 더 적은 함수 평가 횟수로 얻거나 적분 오차를 줄일 수 있다.
Conditional rectified flow
Conditional rectified flow는 조건 정보 를 함께 입력받아, 원하는 조건에 해당하는 데이터분포에서 샘플을 생성하도록 Rectified flow를 확장한 방식이다.
전체 데이터분포 안에는 조건 에 따라 서로 다른 조건부 분포가 존재할 수 있다. 예를 들어 데이터가 사각형과 삼각형으로 구성되어 있다면, 다음 두 조건부 분포를 생각할 수 있다.
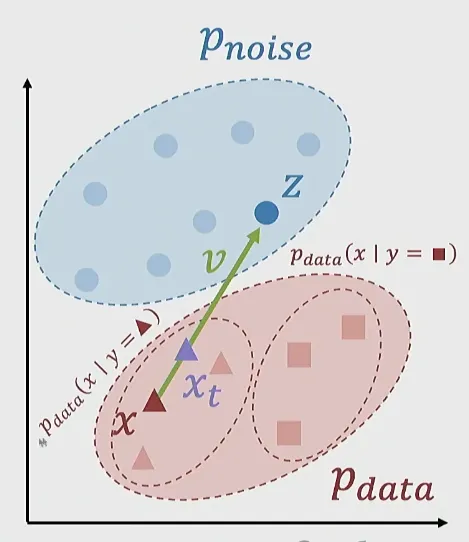
훈련에는 조건 가 함께 있는 데이터 쌍을 사용한다.
Rectified flow에서는 기존 입력 에 조건 를 추가로 넣어 조건에 맞는 velocity를 예측한다.
조건을 추가해도 예측 velocity를 정답 에 맞추는 회귀 학습 목표는 같다.
학습 예제는 다음과 같다.
for (x, y) in dataset:
    z = torch.randn_like(x)
    t = random.uniform(0, 1)
    xt = (1 - t) * x + t * z
    v = model(xt, y, t)
    loss = (z - x - v).square().sum()
예제의 model은 입력 샘플, 조건 y, 시간 t 순서로 받는다. 코드의 v는 예측 velocity이고, 정답은 z - x이다.
샘플링에서도 매 단계마다 같은 조건 를 모델에 함께 입력하므로, 그 조건에 맞는 데이터분포 쪽으로 이동한다. 조건에는 class label, text prompt의 embedding, 입력 이미지, segmentation map 등을 사용할 수 있다. 사용자는 추론 시 이 조건을 지정하거나 바꿔 생성 결과를 제어할 수 있다.
다만 조건을 입력해도 모델이 기대한 만큼 반영하지 않을 수 있다. 조건을 얼마나 강하게 따를지 조절하기 위한 방법이 다음의 classifier-free guidance이다.
Classifier-free guidance
Conditional model은 조건을 무시하거나 약하게 반영할 수 있다. Classifier-free guidance, CFG는 하나의 신경망이 conditional prediction과 unconditional prediction을 모두 학습하게 한다.
기존 classifier guidance는 생성 모델과 별도로 분류기 를 학습하고, 원하는 조건 의 확률을 높이는 방향을 샘플링에 사용했다. 분류기는 잡음이 섞인 현재 샘플에서도 조건을 예측할 수 있도록 학습하며, 입력에 대한 다음 gradient를 이용한다.
이 gradient는 현재 이미지 를 어느 방향으로 조금 바꾸면 더 답게 되는지를 알려준다. 예를 들어 라면 잡음이 섞인 이미지를 더 고양이처럼 보이게 하는 방향으로 밀어주는 신호이다.
CFG는 같은 생성 모델에서 얻은 조건부 예측 와 무조건부 예측 의 차이를 이용해 조건의 영향을 강화한다. 별도의 분류기가 필요 없다는 의미에서 Classifier-Free라는 이름이 붙었다.
학습 중 일정 확률로 조건 를 null token으로 바꾼다.
제시된 설정에서는 조건을 확률로 제거한다. 이는 고정 규칙이 아니라 조절 가능한 hyperparameter이다.
for (x, y) in dataset:
    z = torch.randn_like(x)
    t = random.uniform(0, 1)
    xt = (1 - t) * x + t * z
    if random.random() < 0.5: y = y_null
    v = model(xt, y, t)
loss = (z - x - v).square().sum()y_null은 조건이 없음을 나타내는 입력이다. 조건을 유지한 예와 제거한 예를 함께 학습하므로, 같은 모델이 조건이 있을 때와 없을 때의 velocity를 모두 예측할 수 있다.
샘플링할 때는 같은 에 대해 모델을 두 번 평가한다.
는 조건이 없는 입력으로, 코드의 y_null에 해당한다. 를 이용한 샘플링은 전체 데이터분포 로, 를 이용한 샘플링은 조건부 데이터분포 로 향한다. 도식의 v_uncond와 v_cond는 각각 이 두 예측을 나타낸다.
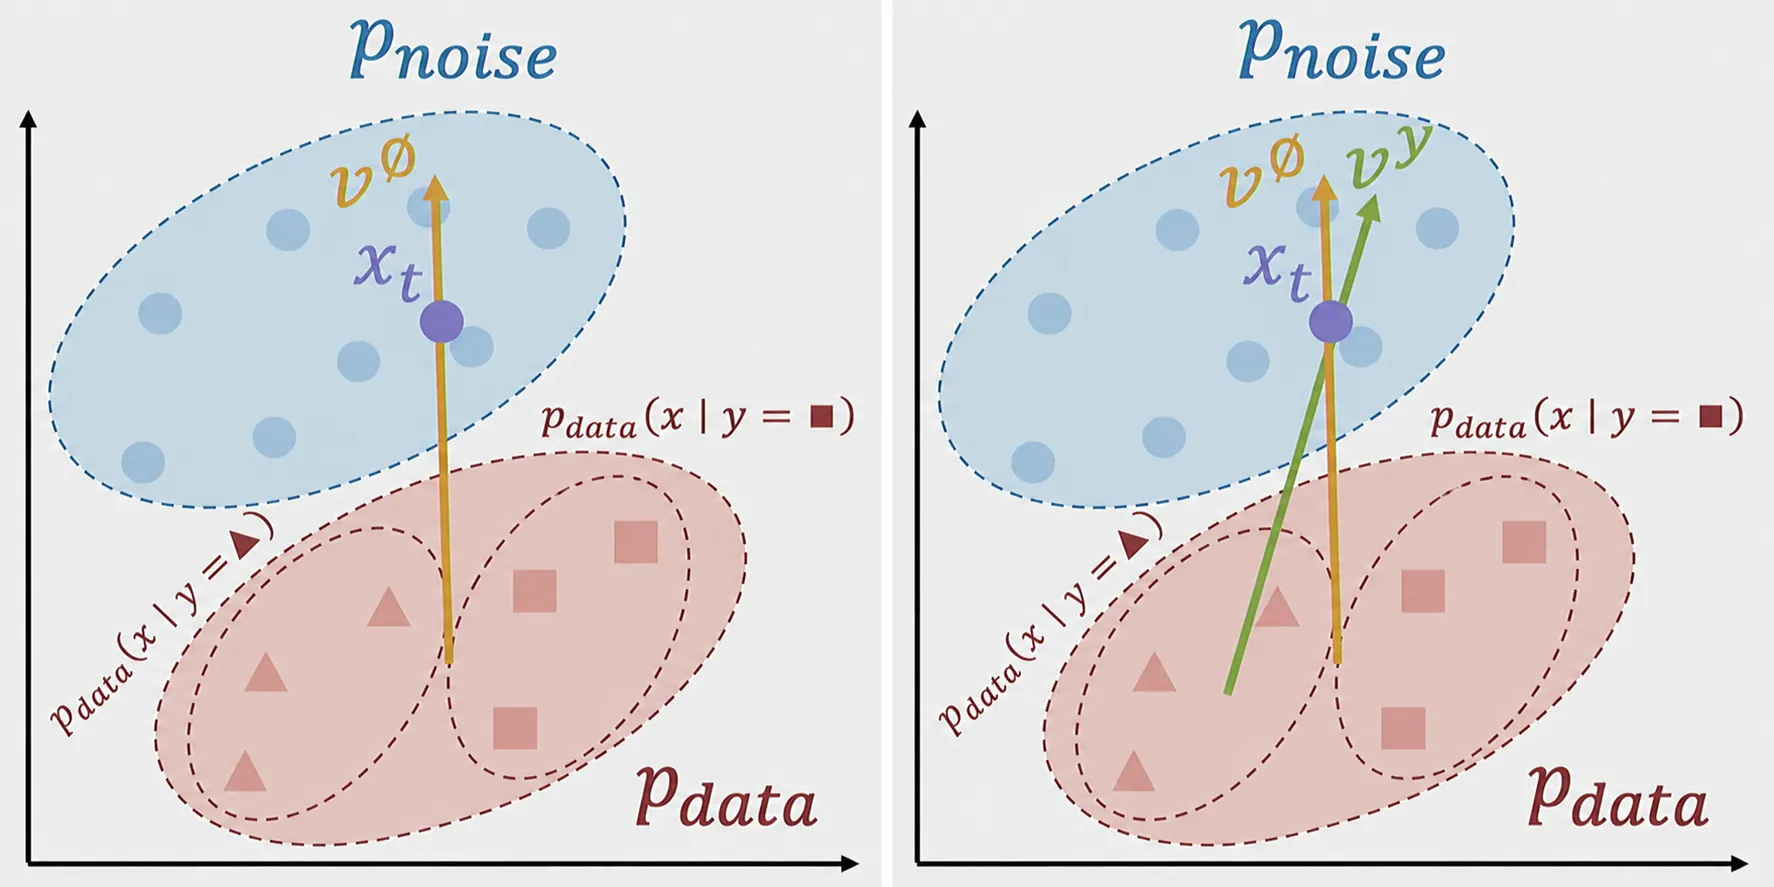
Guidance를 적용한 velocity는 다음과 같다.
샘플링에서는 두 예측을 조합한 를 사용해 각 단계의 샘플을 업데이트한다.
추론 예제는 다음과 같다.
y = user_input()
sample = torch.randn(x_shape)
for t in torch.linspace(1, 0, num_steps):
    vy = model(sample, y, t)
    v0 = model(sample, y_null, t)
    v = (1 + w) * vy - w * v0
sample = sample - v / num_stepsvy는 조건부 예측 , v0는 무조건부 예측 이며, 두 예측을 조합한 v가 이다.
같은 식을 다음 형태로 볼 수도 있다.
여기서 이다. 이면 원래의 conditional prediction을 사용하고, 를 높일수록 unconditional prediction의 방향에서 conditional prediction의 방향으로 더 멀리 외삽(extrapolation)한다.
직관적으로는 와 를 잇는 선을 생각하면 된다. 에서는 정확히 에 위치하고, 를 키울수록 방향을 그대로 연장한 바깥쪽으로 이동한다. conditioning이 가리키는 방향을 더 강하게 증폭하는 것이다.
Guidance scale을 높이면 프롬프트를 더 잘 따르고 시각적으로 더 선명한 결과를 얻을 수 있지만, 다양성이 줄고 artifact가 생길 수 있다. 또한 기본적인 CFG는 매 sampling step마다 신경망을 두 번 평가하므로 추론 계산량이 약 2배가 된다.
%% title: Classifier-Free Guidance의 두 예측
%% caption: 잡음이 섞인 같은 상태에서 conditional·unconditional prediction을 둘 다 계산하고, 두 방향의 차이를 확대해 조건을 더 강하게 따르는 업데이트를 만든다.
flowchart LR
    state["Noisy State xₜ + Time t"] --> cond["Model with Condition y<br/>v_cond"]
    state --> uncond["Model with Null Condition ∅<br/>v_uncond"]
    cond --> guide["v_CFG = v_uncond<br/>+ s(v_cond - v_uncond)"]
    uncond --> guide
    guide --> update["Guided Reverse Update"]
    update --> next["x_t-Δt"]
Optimal Prediction(Noise-level sampling)
Rectified flow의 기본 예에서는 을 사용한다. 이는 같은 길이의 noise level 구간에 같은 샘플링 확률을 준다.
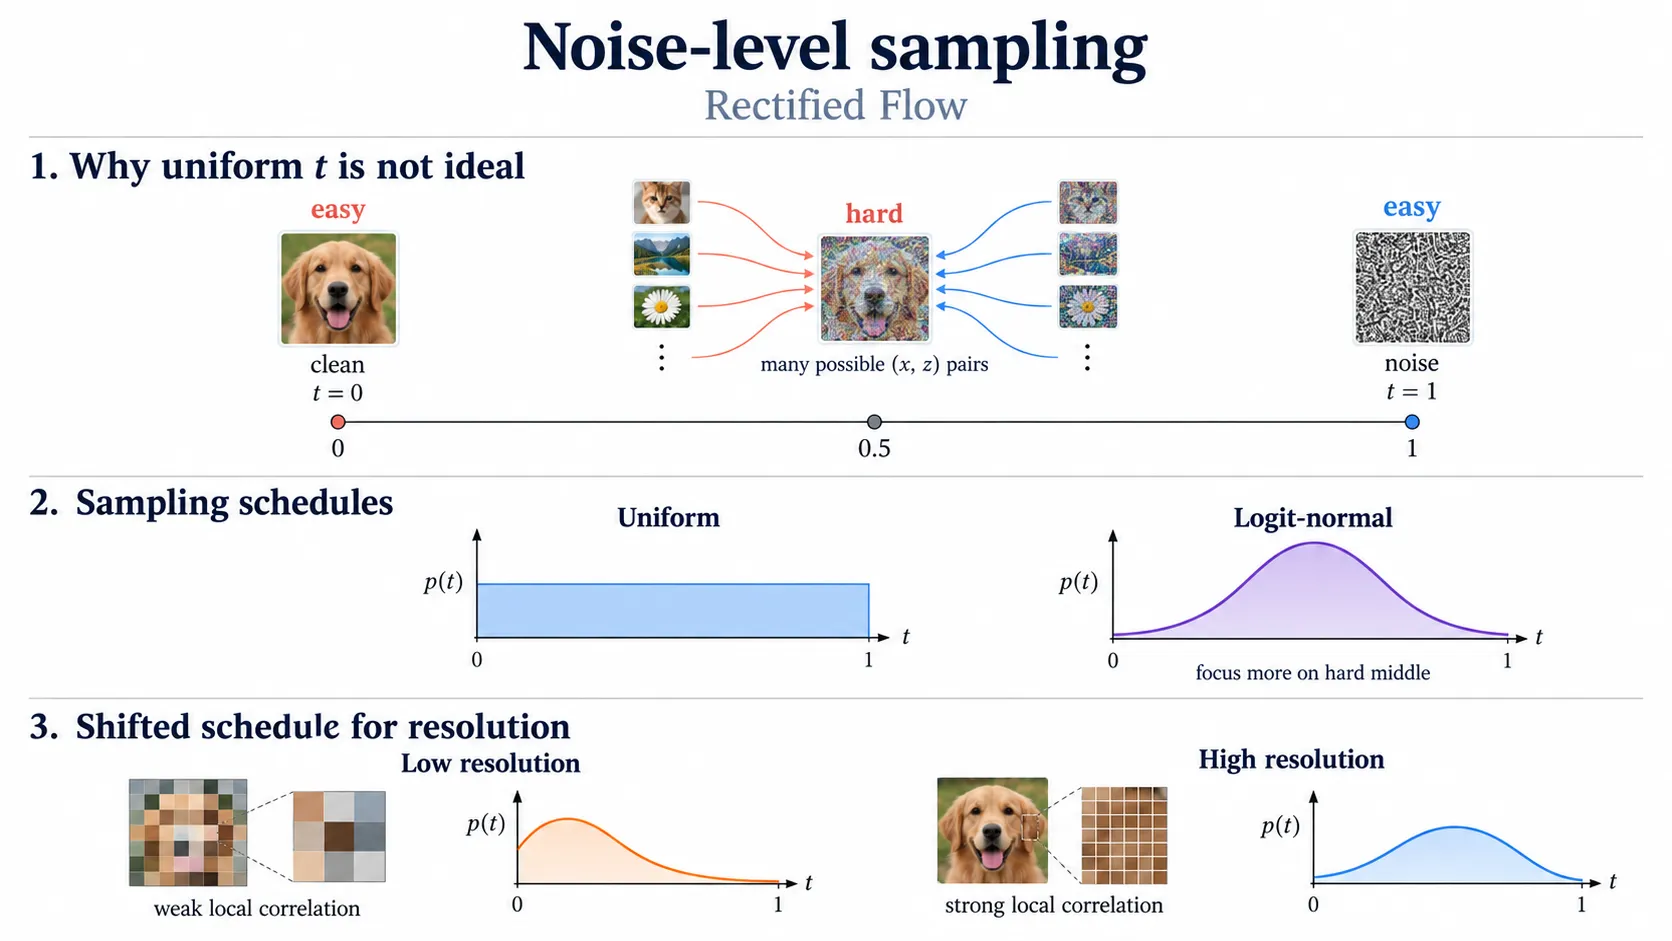
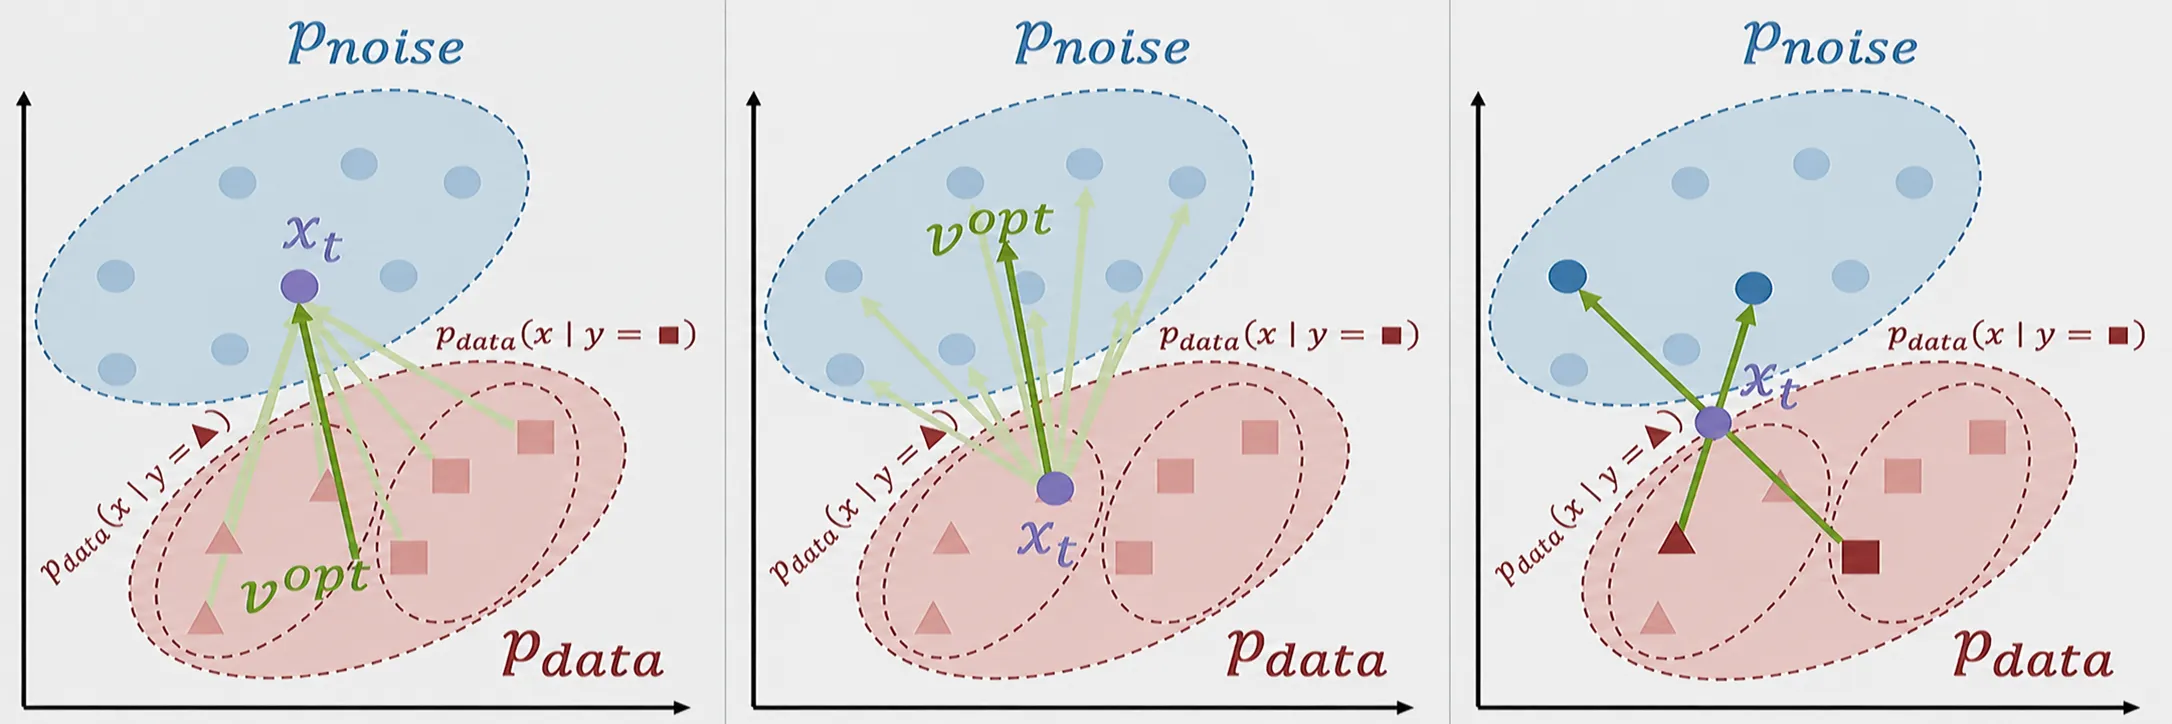
하지만 양 끝은 상대적으로 쉬울 수 있다. 순수한 잡음에 가까우면 데이터의 평균적인 방향을 예측하는 문제가 되고, 원본 데이터에 가까우면 잡음 분포의 평균 방향을 예측하는 문제가 된다. 중간 noise level에서는 같은 를 만들 수 있는 데이터와 잡음의 조합이 여러 개이므로 조건부 기댓값을 추론하기 더 어렵다.
Logit-normal schedule은 의 양 끝보다 중간 구간에 더 많은 가중치를 줄 수 있다. Shifted schedule은 해상도와 데이터의 상관관계에 맞춰 특정 잡음 영역을 강조한다.
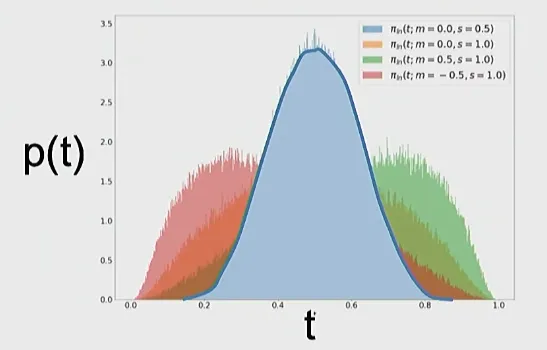
그래프의 는 학습에서 각 noise level을 뽑는 확률밀도이다. Logit-normal 분포에서는 정규분포에서 값을 뽑은 뒤 sigmoid 함수로 변환해 시간 를 만든다.
여기서 는 sigmoid 함수이다. 정규분포에서 뽑은 는 음수나 1보다 큰 값일 수도 있으므로, sigmoid를 통해 시간으로 사용할 수 있는 구간으로 옮긴다. 이면 이고, 음수이면 그보다 작고 양수이면 그보다 크다.
인 설정에서는 가 0 주변에서 자주 나오므로 도 0.5 주변에서 더 자주 나온다. 가 0이나 1에 가까워지려면 절댓값이 큰 가 필요한데, 그런 값은 상대적으로 드물다. 따라서 앞에서 설명한 예측이 어려운 중간 잡음 구간을 더 자주 학습하게 된다.
그래프의 두 매개변수는 학습할 noise level의 분포를 조절한다. Logit-normal sampling
- : sigmoid에 넣기 전 정규분포의 평균이다. 양수로 높이면 잡음이 많은 쪽을, 음수로 낮추면 데이터에 가까운 쪽을 더 자주 뽑는다.
- : sigmoid에 넣기 전 정규분포의 표준편차이다. 그래프에서 는 보다 0.5 주변에 더 좁게 모인다.
학습 예제는 다음과 같다.
for (x, y) in dataset:
    z = torch.randn_like(x)
    t = torch.randn(()).sigmoid()
    xt = (1 - t) * x + t * z
    if random.random() < 0.5: y = y_null
    v = model(xt, y, t)
loss = (z - x - v).square().sum()torch.randn(())은 표준정규분포에서 스칼라 하나를 뽑고, .sigmoid()는 그 값을 시간 로 변환한다. 이 코드는 에 해당한다. 두 값을 조절하려면 t = (m + s * torch.randn(())).sigmoid()로 쓸 수 있다. 학습 중 를 뽑는 분포를 바꾸며, 중간 상태 를 만들고 정답 velocity 에 맞추는 과정은 같다.
고해상도 이미지에서는 이웃한 픽셀 사이의 상관관계가 강하다. 같은 noise level에서도 구조적 정보가 더 많이 남을 수 있어, 저해상도에서 쓰던 스케줄을 그대로 적용하면 잘 작동하지 않을 수 있다. 이를 고려해 보통 더 높은 noise level 쪽으로 스케줄을 이동시킨다.
Latent Diffusion Models(LDMs)
Latent diffusion model, LDM은 이미지를 공간적으로 압축한 latent space에서 diffusion을 수행하고, 생성한 latent를 decoder를 통해 이미지로 복원하는 생성모델이다.
Pixel-space diffusion은 고해상도 tensor 전체에서 여러 번 신경망을 평가해야 하므로 비용이 크다. LDM은 이 반복 계산을 압축된 latent space에서 수행해 비용을 줄인다.
학습은 여러 단계로 진행되며, 먼저 encoder와 decoder로 구성된 autoencoder를 학습한다. Encoder는 이미지를 latent space로 보내면서 가로·세로 공간 해상도를 줄이고, decoder는 그 latent에서 이미지를 복원한다. 이후 이 latent space에서 diffusion model을 학습한다.
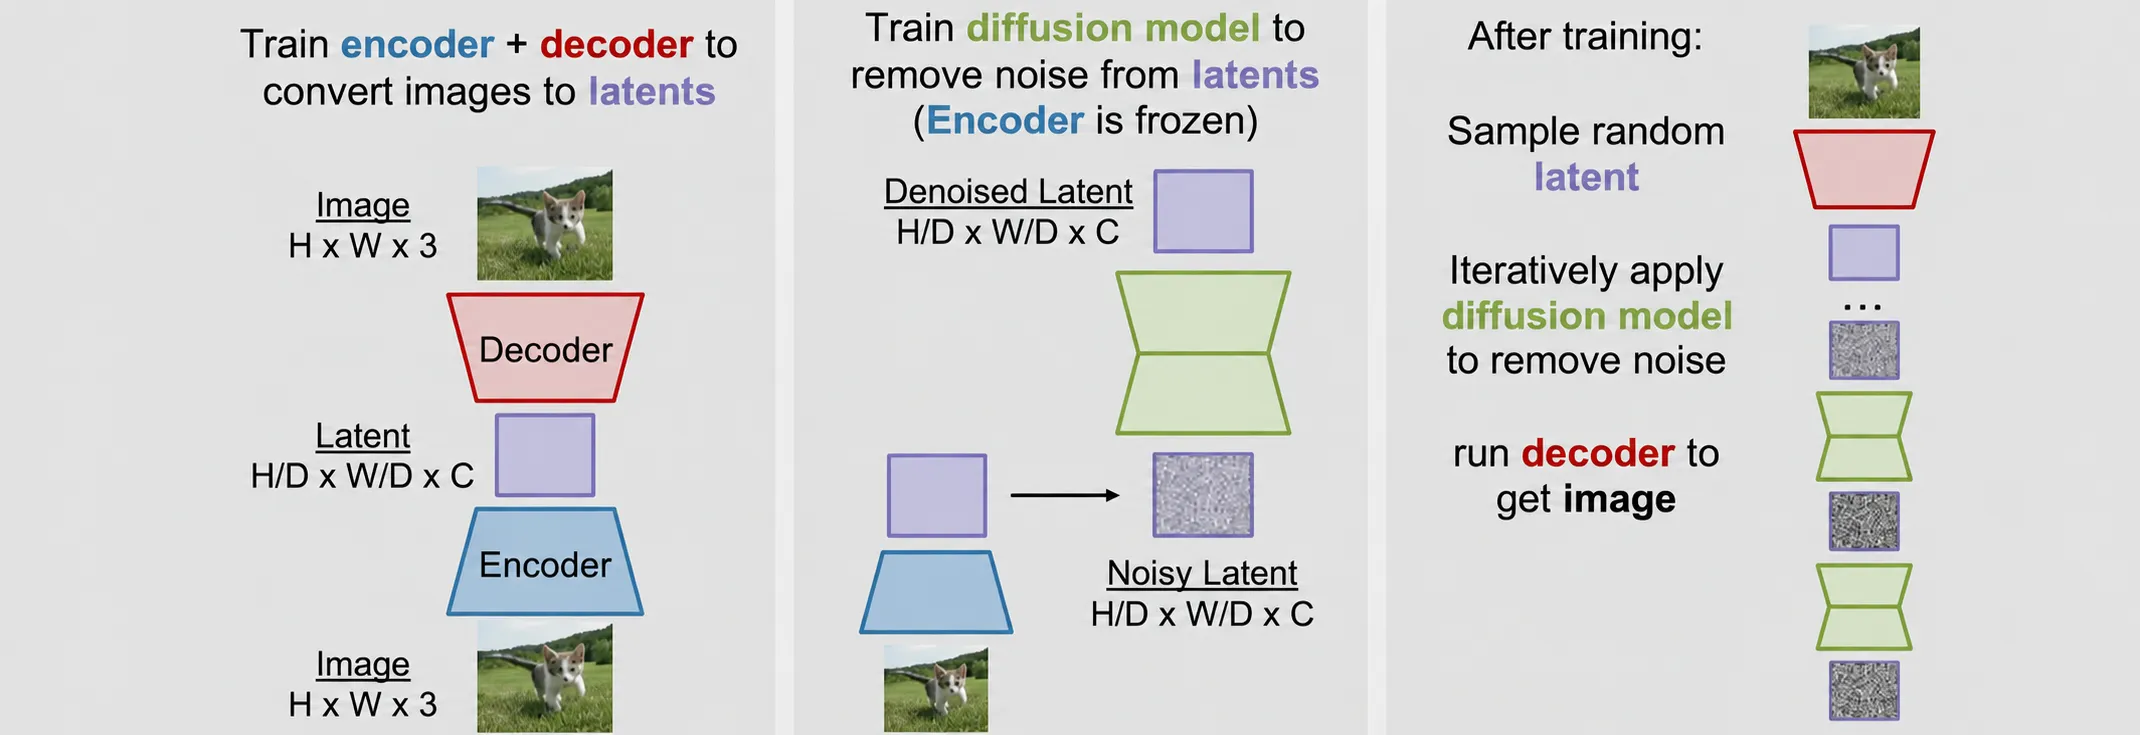
VAE, GAN, diffusion의 역할
LDM 파이프라인에서는 VAE 계열의 autoencoder, GAN의 discriminator, diffusion model이 서로 다른 역할을 맡는다.
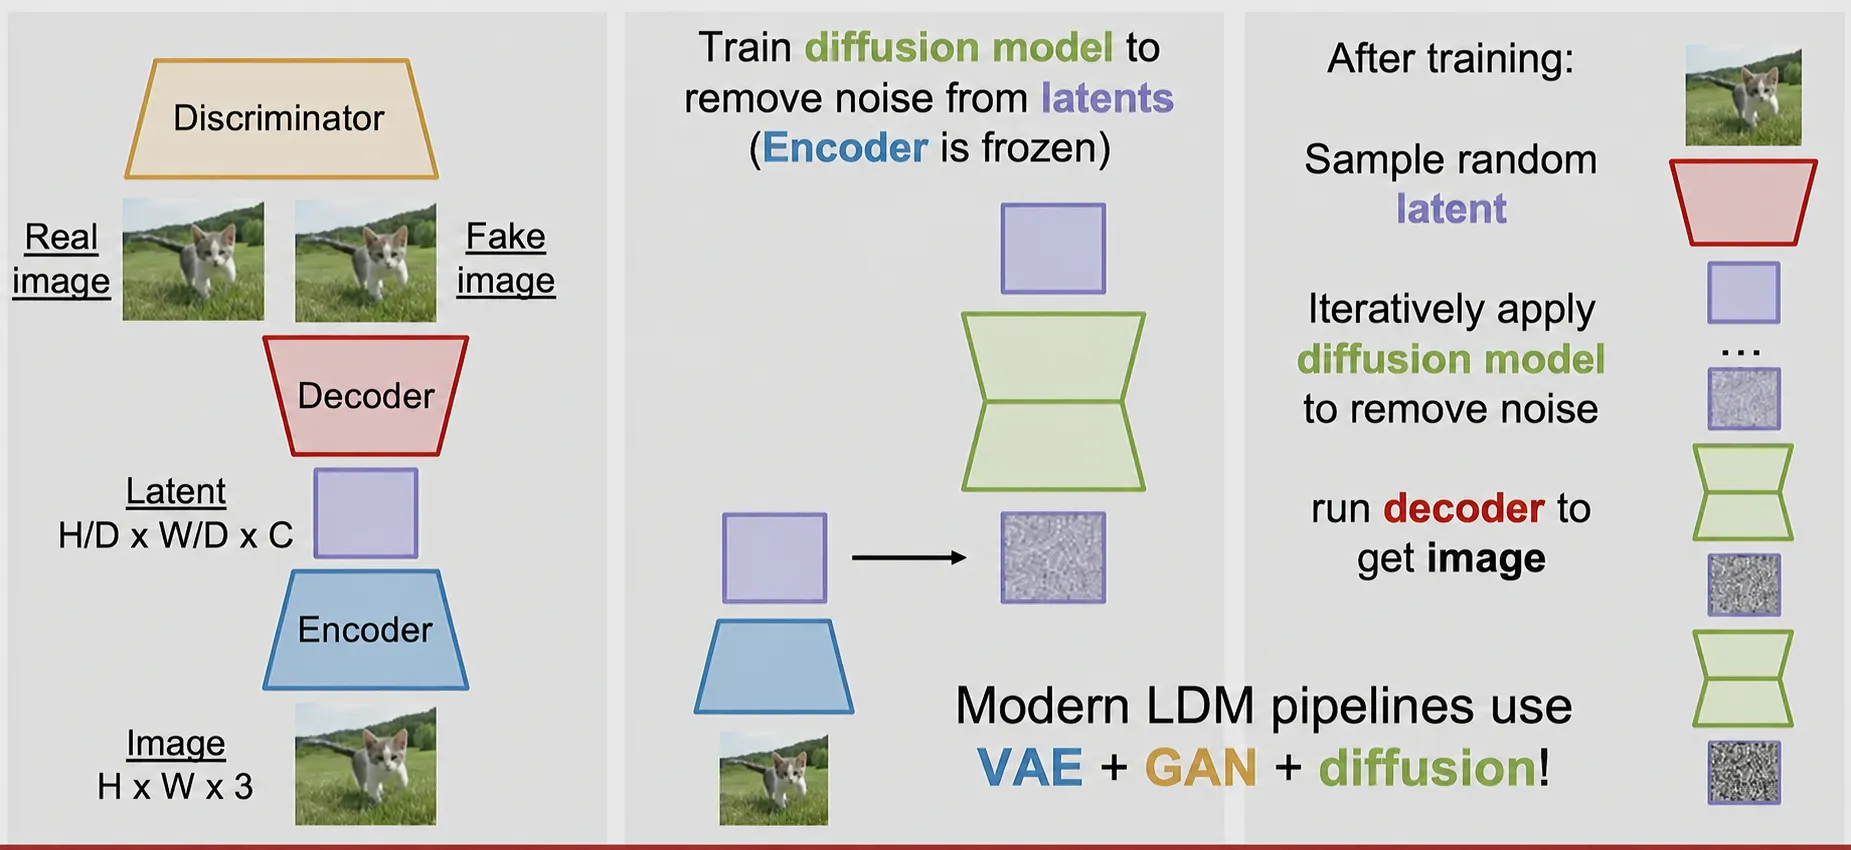
| 구성요소 | 역할 |
|---|---|
| VAE 계열의 encoder·decoder | 이미지를 latent로 압축하고, 그 latent에서 이미지를 복원한다. |
| GAN의 discriminator | 실제 이미지와 decoder의 복원 이미지를 구별하며, decoder가 더 선명하고 실제 같은 이미지를 복원하도록 학습 신호를 준다. |
| Diffusion model | Autoencoder가 만든 고정된 latent space에서 데이터 분포를 학습하고 새로운 latent를 생성한다. |
이들을 연결하는 핵심은 decoder의 복원 품질이다. Decoder가 흐릿한 이미지만 복원한다면 diffusion이 좋은 latent를 만들어도 최종 이미지는 흐려질 수 있다. 그래서 autoencoder 학습에 discriminator를 붙여 복원 품질을 높이고, 이후 그 latent space에서 diffusion을 학습한다.
학습에서는 먼저 autoencoder와 discriminator를 함께 학습한 뒤, encoder를 고정하고 latent diffusion model을 학습한다. 생성할 때는 latent noise에서 시작해 diffusion으로 잡음을 제거하고, 학습한 decoder로 이미지를 복원한다. 즉 VAE는 압축과 복원, GAN은 복원 품질 개선, diffusion은 latent 생성에 기여한다.
Latent 표현과 학습 과정
Encoder와 decoder는 다음 변환을 학습한다.
예시 구성은 공간 차원을 각 축에서 8배 downsampling하고 RGB 3채널을 latent 16채널로 바꾼다.
각 공간 축이 8배 줄어들면 token 위치 수는 pixel space의 이 된다. 채널 수는 늘지만 계산 비용이 큰 backbone이 처리하는 공간 시퀀스는 크게 짧아진다.
학습은 두 단계로 나뉜다.
- Encoder E와 Decoder D로 구성된 Autoencoder 를 이미지 복원으로 학습한다.
- 학습한 encoder를 freeze한 상태에서 를 추출하고, 여기에 잡음을 더해 diffusion model이 잡음을 제거하도록 학습한다.
AutoEncoder는 이미지를 어떤 잠재공간으로 압축할지 배우는 모델이고, Diffusion Model은 그 잠재공간의 분포를 어떻게 생성할지 학습하는 모델이다.
Diffusion 학습 중 gradient를 encoder로 전파하지 않는 것이 중요하다. Latent space가 계속 변하면 diffusion model이 학습할 목표 분포도 계속 변한다.
샘플링할 때는 latent noise에서 잡음이 제거된 latent를 만든 뒤 decoder로 이미지를 복원한다.
%% title: Latent Diffusion의 두 단계 파이프라인
%% caption: Autoencoder가 픽셀 이미지를 작은 spatial latent로 압축하고, diffusion·flow backbone은 고비용 반복 계산을 latent space에서 수행한다. 잡음이 제거된 최종 latent만 decoder에 넣어 이미지를 복원한다.
flowchart LR
    image["Training Image<br/>H × W × 3"] --> encoder["Frozen Autoencoder E"]
    encoder --> latent["Latent h<br/>H/8 × W/8 × 16"]
    latent --> noise["Add Noise at t"]
    text["Optional Condition<br/>Text / Class"] --> model["Latent Diffusion or Flow Model"]
    noise --> model
    model --> objective["Noise / Velocity Target Loss"]
    start["Latent Noise"] --> reverse["Iterative Reverse Process"]
    text --> reverse
    model -. "learned field" .-> reverse
    reverse --> clean["Clean Latent h₀"]
    clean --> decoder["Autoencoder Decoder D"]
    decoder --> output["Generated Image"]
Autoencoder에 adversarial loss를 더하는 이유
Gaussian reconstruction loss만 사용한 VAE decoder는 가능한 세부 특징을 평균내 흐릿한 복원 결과를 만들 수 있다. Latent diffusion의 최종 이미지 품질은 decoder의 복원 품질보다 좋아질 수 없으므로 autoencoder 자체가 선명한 이미지를 복원해야 한다.
이를 위해 reconstruction loss, perceptual loss, latent regularization에 adversarial discriminator loss를 함께 사용할 수 있다.
따라서 현재의 latent diffusion pipeline은 VAE 계열의 encoder-decoder, GAN 계열의 discriminator, diffusion 또는 flow model을 결합한다. 서로 경쟁하던 생성 모델 계열이 실제 시스템에서는 역할별 구성요소로 함께 쓰이는 셈이다.
Diffusion Transformer
Diffusion Transformer, DiT는 잡음이 섞인 latent를 token sequence로 바꾸고 Transformer block으로 예측 목표값을 계산한다. 모델은 최소한 세 종류의 입력을 받는다.
- 잡음이 섞인 latent
- Noise level 또는 timestep
- 텍스트와 같은 조건
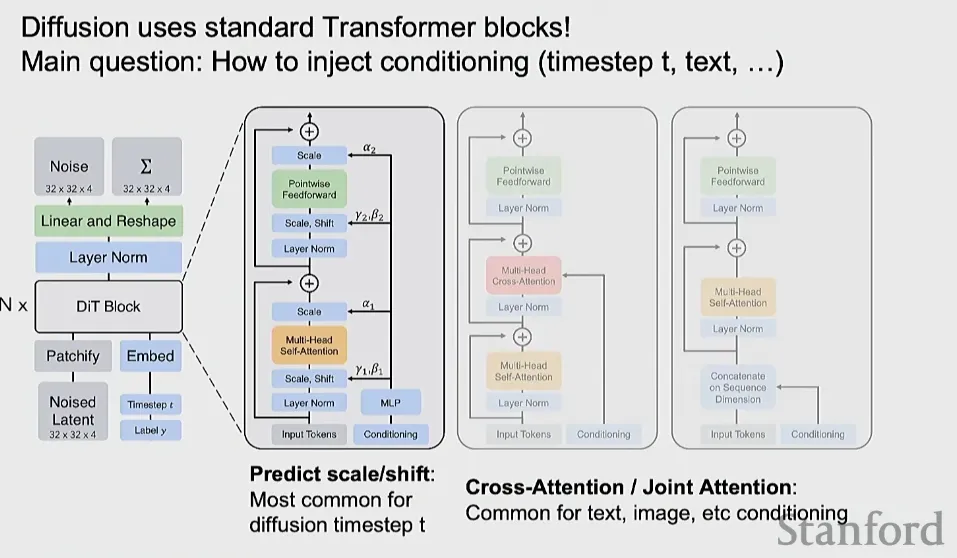
Timestep embedding은 scale과 shift를 예측하고, 이를 정규화된 activation에 적용해 값을 조절하는 방식으로 주입할 수 있다.
텍스트 조건은 cross-attention으로 image token이 text token을 참조하게 하거나, 두 종류의 token을 하나의 시퀀스로 합친 joint attention으로 처리할 수 있다.
U-Net은 multi-scale convolution과 skip connection으로 diffusion model의 표준 구조 역할을 오랫동안 맡았다. DiT는 Transformer scaling과 distributed training infrastructure를 활용하기 쉬워 대규모 모델에서 널리 사용된다.
Text-to-image pipeline
Text-to-image latent diffusion은 다음처럼 구성할 수 있다.
- Frozen text encoder가 프롬프트를 text embedding으로 바꾼다.
- Latent noise와 text embedding, timestep을 DiT에 넣는다.
- CFG를 적용한 예측값으로 latent를 반복 업데이트한다.
- 잡음이 제거된 latent를 autoencoder decoder로 이미지 픽셀로 복원한다.
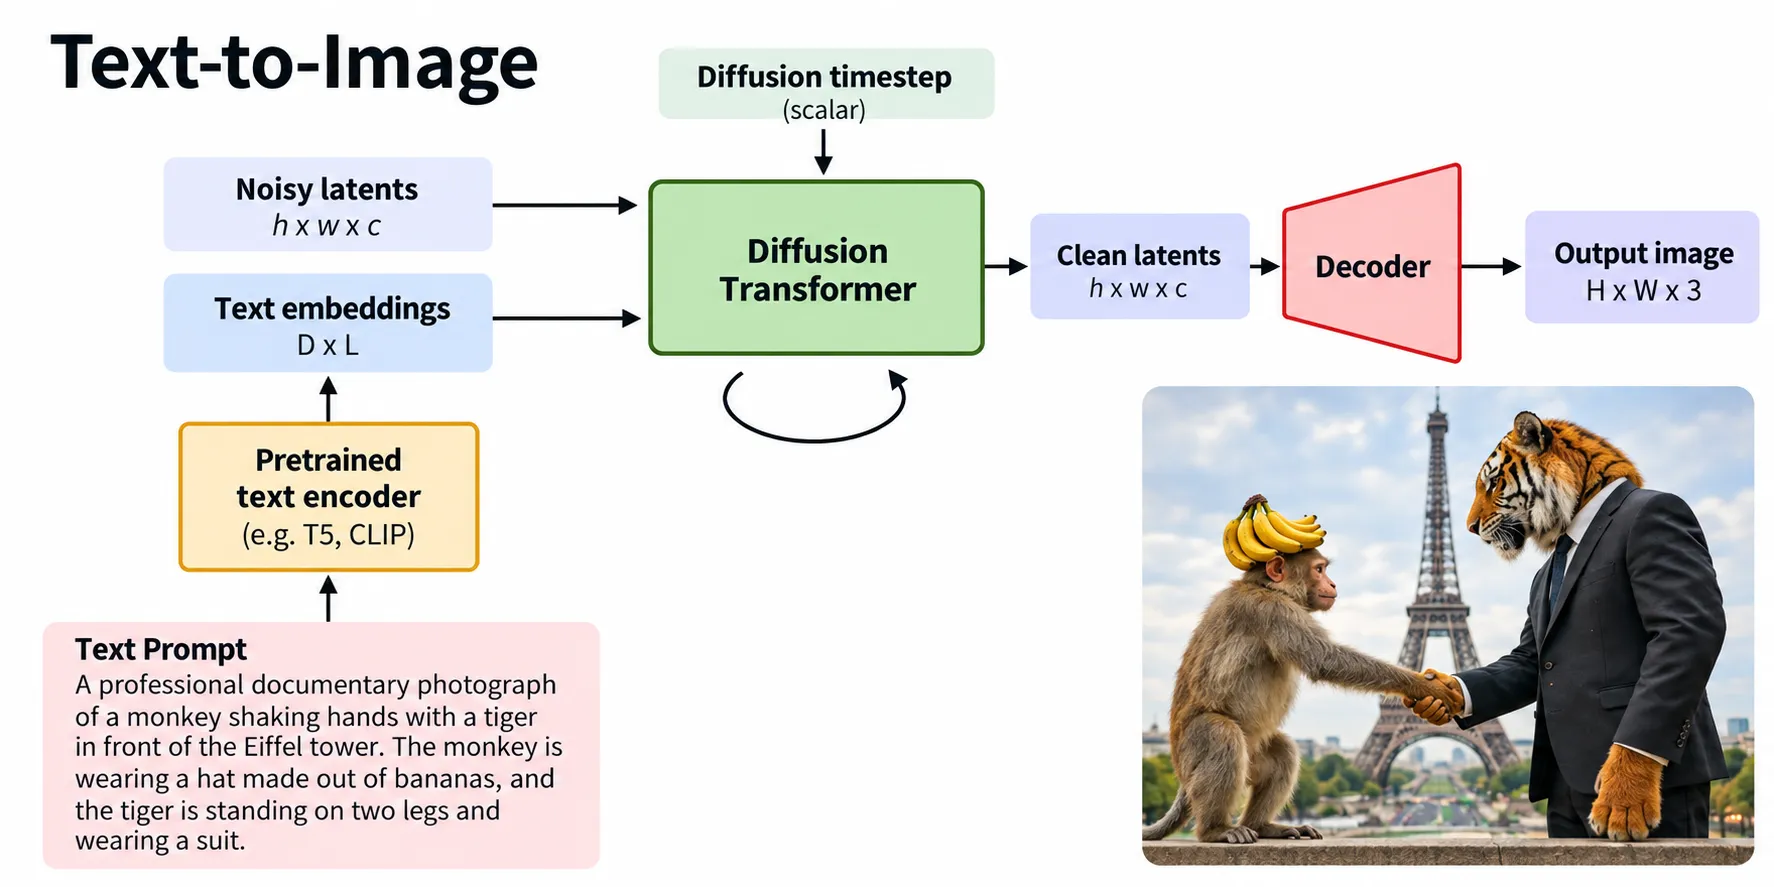
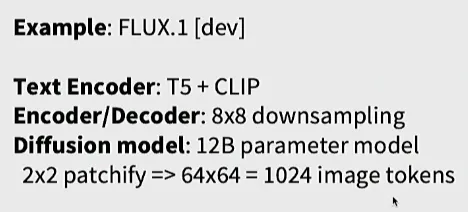
Text encoder로 T5나 CLIP 계열을 사용할 수 있다. 제시된 FLUX.1-dev 예시는 T5와 CLIP encoder, 8배 spatial downsampling encoder, 12-billion-parameter Transformer를 사용하며 추가 downsampling 뒤 1,024개의 image token을 처리한다.
Prompt 예시는 다음처럼 대상, 관계, 위치, 속성을 함께 포함한다.
A professional documentary photograph of a monkey shaking hands with a tiger in front of the Eiffel Tower. The monkey is wearing a hat made out of bananas. The tiger is standing on two legs and wearing a suit.
이렇게 복합적인 조건을 따르려면 text encoder와 디퓨전 모델의 핵심(backbone)이 객체의 동일성(object identity)뿐만 아니라 대상 간의 관계와 속성 결합(attribute binding)도 학습해야 한다.
Text-to-video pipeline
Video latent에는 두 공간 차원 외에 시간 차원이 추가된다.
Spatial-temporal autoencoder는 이미지의 너비와 높이뿐 아니라 frame 축도 압축한다. Diffusion backbone은 프레임마다 그럴듯한 이미지를 만드는 것과 동시에 움직임과 객체의 동일성이 시간에 따라 일관되게 유지되도록 해야 한다.
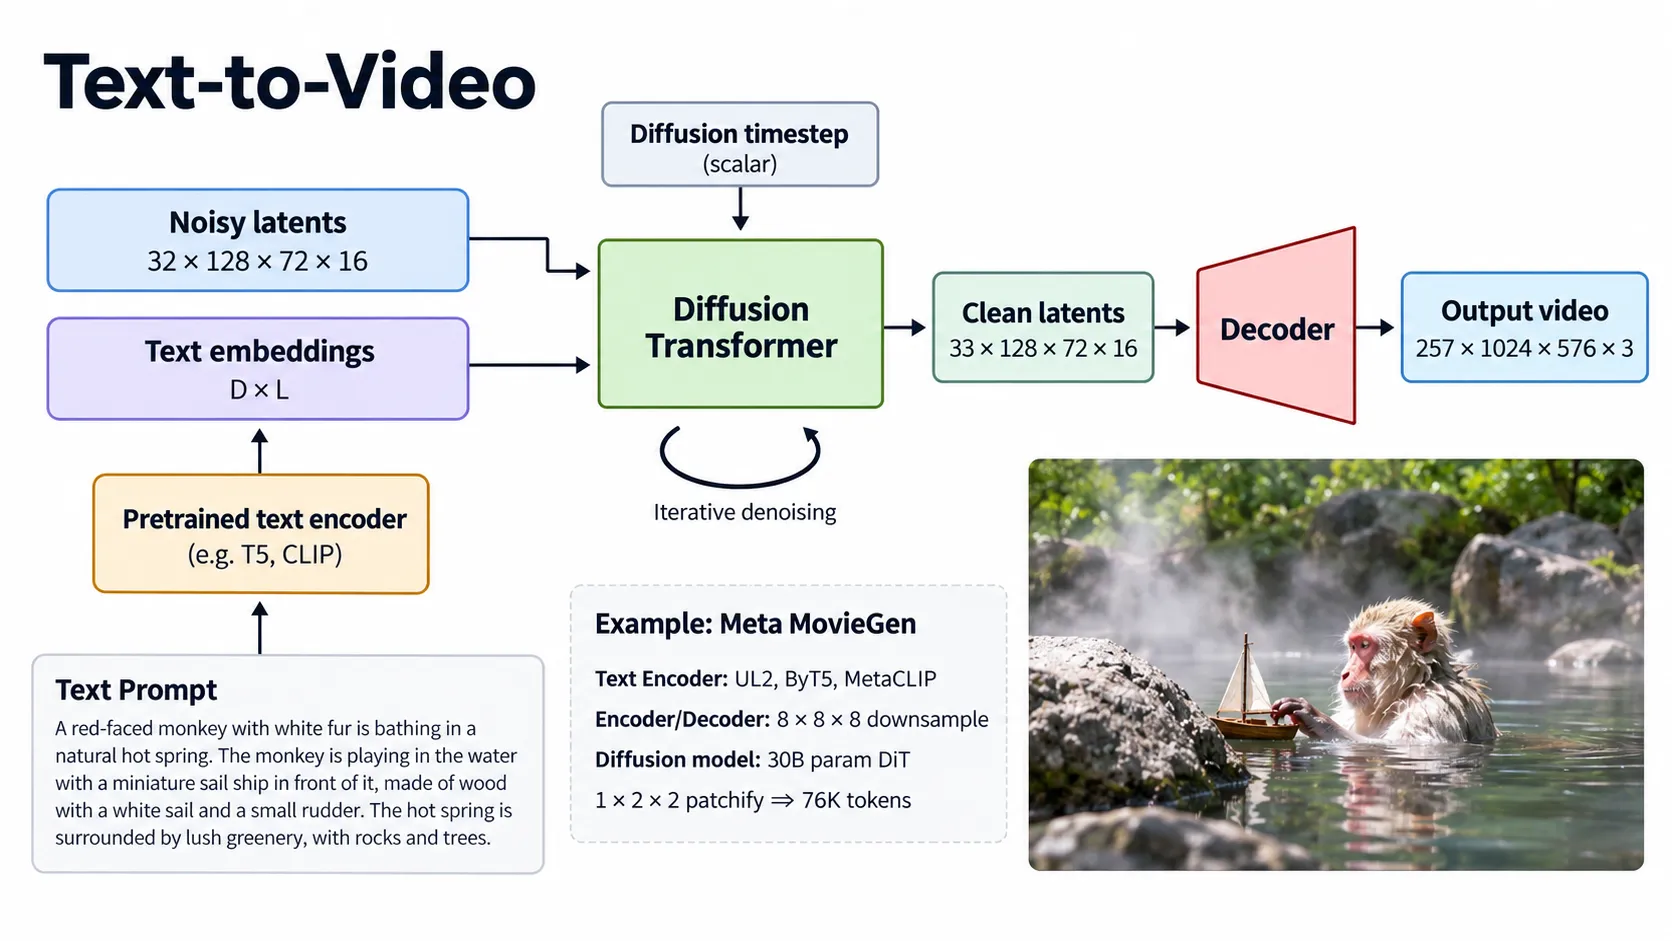
Text-to-image 예시가 1,024개의 image token을 처리했다면, 제시된 고해상도 video model 예시는 약 76,000개의 video token을 처리한다. 구조가 비슷해도 시간 차원 때문에 시퀀스 길이와 attention 비용이 크게 증가한다.
영상 생성 비용의 핵심은 다음과 같다.
- 고해상도는 frame당 spatial token 수를 늘린다.
- 영상이 길고 FPS가 높을수록 temporal token 수가 늘어난다.
- 매 sampling step마다 긴 시퀀스를 대규모 모델로 다시 처리한다.
- 오디오까지 공동 생성(joint generation)하면 추가적인 modality와 동기화가 필요하다.
Diffusion sampling과 distillation
GAN은 generator forward 한 번으로 샘플을 만들지만 diffusion은 보통 수십 번 신경망을 평가한다. Backbone이 수십억 파라미터이고 시퀀스도 길면 inference latency와 비용이 매우 커진다.
Diffusion distillation은 teacher가 여러 번의 작은 이동으로 수행하던 생성을 student가 몇 번의 큰 이동으로 근사하도록 학습하는 방법이다. 일반적으로 30, 50, 100 step이 필요했던 모델을 몇 step으로 줄이며, 일부 방법은 single-step sampling을 목표로 한다.
예를 들어 progressive distillation은 teacher의 두 step 결과를 student의 한 step 결과가 따라가도록 학습한다. 아래에서 이며, 같은 시작 상태 에서 최종 상태 에 도달하는 과정을 압축한다.
학습한 student를 다음 teacher로 삼아 이 과정을 반복하면 필요한 step 수를 단계적으로 절반씩 줄일 수 있다. 이때 압축하는 것은 여러 번의 업데이트가 수행한 변환이다. Progressive Distillation
기존 sampler에서 시간 간격만 크게 늘리면 같은 벡터장을 더 거칠게 적분하면서 오차가 커질 수 있다. 증류에서는 여러 step을 거친 teacher의 결과를 학습 목표로 삼아, student가 큰 이동에서도 그 결과를 근사하도록 별도로 학습한다.
Step 수를 줄일수록 한 번의 예측이 더 큰 변화를 담당하므로 샘플 품질을 유지하기 어려워질 수 있다. 특히 single-step에서는 품질 손실이 클 수 있으며, 핵심 trade-off는 샘플 품질을 최대한 유지하면서 신경망의 함수 평가 횟수를 줄이는 것이다.
NFE(Number of Function Evaluations)는 생성 중 신경망을 호출하는 횟수이다. CFG에서 조건부·무조건부 예측을 각각 계산하면 한 step에 두 번 호출하므로 step 수와 NFE는 다를 수 있다. NFE를 줄여도 text encoder와 decoder 등의 비용은 남으므로 실제 속도 향상이 호출 횟수의 감소 비율과 정확히 같지는 않다.
나중에 읽어볼 증류 논문(언젠간)
- Salimans and Ho, Progressive Distillation for Fast Sampling of Diffusion Models, ICLR 2022.
- Song et al., Consistency Models, ICML 2023.
- Sauer et al., Adversarial Diffusion Distillation, ECCV 2024.
- Sauer et al., Fast High-Resolution Image Synthesis with Latent Adversarial Diffusion Distillation, arXiv 2024.
- Lu and Song, Simplifying, Stabilizing and Scaling Continuous-Time Consistency Models, ICLR 2025.
- Salimans et al., Multistep Distillation of Diffusion Models via Moment Matching, NeurIPS 2024.
Generalized noising과 prediction target
Rectified flow의 학습을 다시 보면, , , 를 뽑아 를 만든다. 는 Uniform, Logit-normal, shifted schedule처럼 학습 시간을 뽑는 분포이다. 모델은 정답 velocity 를 예측하도록 L2 손실로 학습한다.
Rectified flow는 다음 일반화된 식의 단순한 경우로 볼 수 있다.
모델의 예측 목표도 원본 데이터와 잡음의 선형결합으로 둘 수 있다.
Rectified flow의 계수
Rectified flow에서는 네 계수가 다음처럼 정해진다.
이를 대입하면 입력은 , 예측 목표는 가 된다. 입력을 섞는 계수 는 시간에 따라 변하지만, 정답 velocity를 만드는 는 시간과 무관한 상수이다.
Variance Preserving (VP)
Variance-preserving schedule은 데이터와 잡음의 분산이 1이고 서로 독립일 때 의 분산을 일정하게 유지하도록 와 를 고른다.
여기서 이다. 독립인 두 신호를 섞으면 분산은 각 계수의 제곱을 곱한 분산들의 합이므로, 인 이 설정에서는 의 분산도 1로 유지된다. 두 계수를 따로 고르는 대신 하나의 함수 로 정하는 것이다.
Variance Exploding (VE)
Variance-exploding schedule은 데이터에 점점 큰 noise scale을 더한다.
따라서 이다. 여기서 는 잡음의 크기를 정하며, 마지막 시점의 은 데이터 의 신호를 충분히 압도할 만큼 커야 한다. 그래야 마지막 상태를 거의 잡음으로 볼 수 있다.
Prediction target
방법에 따라 모델은 다음 중 하나를 예측할 수 있다.
- 원본 샘플
- 추가한 잡음
- Velocity처럼 와 의 선형결합
- 분포의 score에 비례하는 값
표기와 예측 목표는 달라도 잡음이 섞인 입력과 시간을 받아 알려진 목표값에 대한 회귀 학습을 한다는 공통 구조가 있다.
Diffusion을 보는 세 관점
Diffusion 계열은 서로 다른 수학적 관점에서 유도할 수 있으며 최종 알고리즘의 형태가 비슷하게 나타나기도 한다.
Latent-variable model
원본 샘플 에 대응하는 잡음이 섞인 상태 를 latent variable로 본다. Forward corruption은 알려진 분포이고 reverse transition을 신경망으로 학습한다. VAE와 비슷하게 데이터 우도의 variational lower bound를 만들 수 있다.
Diffusion Learns the Score Function
분포 에서 일 때 score function은 로그밀도를 입력에 대해 미분한 벡터장이다.
Score는 현재 위치 주변에서 확률밀도가 빠르게 증가하는 방향을 가리킨다. 이 관점에서 diffusion은 데이터분포 의 score function을 근사하는 신경망을 학습한다. 즉 현재 샘플에서 더 그럴듯한 데이터 쪽으로 이동할 방향을 배우는 것이다.
Diffusion model은 여러 noise level 에 대한 score field를 학습하고, 잡음에서 데이터의 확률밀도가 높은 영역으로 샘플을 이동시킨다.
Score는 정규화된 확률밀도 값 자체를 몰라도 gradient field로 샘플링 방향을 제공할 수 있다는 점이 중요하다.
Differential equation
잡음 분포와 데이터 분포 사이의 이동을 시간에 따른 미분방정식으로 나타낼 수 있다.
가 있는 stochastic differential equation, SDE와 이를 제거한 probability-flow ODE 관점을 사용할 수 있다. 샘플링 알고리즘은 학습한 벡터장을 따라 미분방정식을 푸는 수치 적분 방법으로 해석된다.
Rectified flow의 단순한 Euler 업데이트는 ODE를 푸는 1차 방법이다. Heun method나 higher-order solver는 더 적은 step에서 경로를 정확하게 근사할 수 있다.
Generative model이 결합되는 방식
생성 파이프라인에서는 하나의 방법만 고집하지 않는다.
- VAE 또는 autoencoder가 픽셀을 작은 latent로 압축한다.
- GAN discriminator가 decoder의 복원 결과를 선명하게 만든다.
- Diffusion 또는 rectified flow가 연속적인 latent distribution을 생성한다.
- Pretrained text encoder가 조건을 제공한다.
- Autoregressive model은 discrete latent token의 분포를 모델링할 수 있다.
다른 구성 방식은 discrete autoencoder로 image token을 만든 뒤 causal Transformer가 token을 autoregressive하게 생성하는 것이다.
픽셀, latent, 텍스트 중 어느 공간에서 어떤 생성 목적함수를 사용할지는 품질, 제어 가능성, 우도, 학습 안정성, 샘플링 속도 사이의 trade-off로 결정한다.
GAN과 diffusion 비교
| 항목 | GAN | Diffusion 또는 rectified flow |
|---|---|---|
| 확률밀도 | 암묵적 | 대개 score, flow, variational 관점으로 다룸 |
| 학습 신호 | Adversarial classifier | 알려진 잡음 목표값에 대한 회귀 학습 |
| 신경망 | Generator와 discriminator | 주된 denoiser 또는 velocity network 하나 |
| 학습 안정성 | Minimax game으로 불안정 | 비교적 안정적인 regression loss |
| 샘플링 | Generator forward 한 번 | 여러 반복 단계 |
| 샘플 품질 | 잘 조정하면 매우 선명함 | 규모가 크고 데이터 분포의 포괄 범위가 넓은 편 |
| 대표 실패 유형 | Mode collapse | 느린 샘플링, schedule과 solver의 오차 |
| Latent inversion | 기본적으로 encoder 없음 | Latent diffusion은 별도 encoder 사용 |
GAN은 inference가 빠르고 선명한 출력을 만들 수 있지만 학습이 어렵다. Diffusion은 학습과 규모 확장이 상대적으로 안정적이지만 inference가 느리다. Latent diffusion과 distillation은 diffusion의 계산 비용 문제를 줄이고, adversarial decoder는 복원 결과의 세부 특징을 보완한다.