
핵심 한 줄 정리
Generative model은 data를 만든 probability distribution을 학습하는 모델이며, autoregressive model은 chain rule로 exact likelihood를 계산하고 VAE는 latent variable과 ELBO를 도입해 tractable한 lower bound로 학습한다.
중요 개념 정리
Supervised learning과 unsupervised learning
Supervised learning에서는 input과 target의 pair가 주어진다.
목표는 training set에서 관찰한 mapping을 학습하고 새로운 input에도 일반화하는 것이다. Image classification, captioning, object detection, semantic segmentation이 이에 해당한다.
Unsupervised learning에서는 label 없이 sample 만 주어진다.
이때는 data의 cluster, low-dimensional structure, representation, probability density처럼 직접 관찰되지 않은 structure를 찾는다. K-means clustering, PCA, density estimation이 대표적인 예이다.
Supervised와 unsupervised는 label을 사용하는지에 관한 구분이다. Discriminative와 generative는 어떤 probability distribution을 modeling하는지에 관한 구분이다. 두 기준은 서로 다른 축이므로 같은 의미로 섞어 쓰면 안 된다.
Probability distribution의 normalization
Continuous variable 의 probability density 는 다음 조건을 만족한다.
Discrete variable이라면 integral 대신 모든 값에 대한 sum이 1이다.
전체 probability mass는 1로 고정되어 있다. 어떤 영역의 probability를 높이면 다른 영역에 배분할 mass는 줄어든다. 결국 probabilistic modeling은 어떤 값들이 서로 probability mass를 놓고 경쟁하는지를 정하는 문제이기도 하다.
Discriminative model
Discriminative model은 input 가 주어졌을 때 target 의 conditional distribution을 학습한다.
Image classification에서는 각 image마다 class label들이 probability mass를 놓고 경쟁한다.
Image가 바뀌면 별개의 class distribution이 만들어진다. 서로 다른 image끼리는 probability mass를 경쟁하지 않는다.
Label space가 cat과 dog뿐이라면 input이 monkey나 abstract art여도 모델은 cat과 dog의 probability를 합해 1로 만들어야 한다. Standard discriminative classifier는 input 자체가 training distribution 밖이라는 사실을 표현하기 어렵다. 높은 softmax probability가 곧 input이 in-distribution임을 의미하지는 않는다.
Unconditional generative model
Unconditional generative model은 data 자체의 distribution을 학습한다.
Image generative model에서는 가능한 모든 image가 전체 probability mass 1을 나눠 가진다. Training data와 비슷한 plausible image에는 높은 density를, data distribution에서 벗어난 image에는 낮은 density를 부여해야 한다.
예를 들어 zoo animal image를 모델링 한다면 일반적인 동물 이미지에는 상대적으로 높은 density가 필요하고, abstract art에는 낮은 density가 필요하다. 세 다리인 dog와 세 팔인 monkey처럼 둘 다 드문 image라도 실제 세계에서 어느 쪽이 더 그럴듯한지 반영하려면 object와 world structure를 폭넓게 학습해야 한다.
Unconditional model로 할 수 있는 일은 다음과 같다.
- 새로운 sample 를 생성한다.
- Input의 density를 이용해 outlier를 탐지한다.
- Label 없이 data structure와 representation을 학습한다.
다만 sampling 결과를 직접 제어할 conditioning signal이 없으므로 실제 생성 application에서는 conditional model이 더 유용한 경우가 많다.
Conditional generative model
Conditional generative model은 condition 가 주어졌을 때 가능한 output 의 distribution을 학습한다.
는 category label, text prompt, 다른 image, audio, video frame처럼 다양한 정보가 될 수 있다. 각 condition마다 모든 output 가 probability mass를 놓고 경쟁한다.
Text prompt가 person teaching a class on generative models in front of a whiteboard라면 이를 만족하는 image는 하나가 아니다. 사람의 모습, 교실, camera angle, 조명 등이 다른 수많은 image가 가능하다. Conditional generative model은 하나의 deterministic answer가 아니라 가능한 output 전체의 distribution을 나타낸다.
이 관점은 여러 문제에 그대로 적용된다.
- Text-to-text는 prompt에 맞는 여러 문장이나 poem 중 하나를 생성한다.
- Text-to-image는 같은 description을 만족하는 여러 image를 생성한다.
- Image-to-video는 한 image 뒤에 이어질 수 있는 여러 그럴듯한 장면을 생성한다.
Output에 ambiguity가 존재하고 그 다양성을 보존해야 할 때 generative model이 필요하다. 반대로 정답이 사실상 하나인 task라면 deterministic discriminative model로 충분할 수 있다.
조건 가 범주라면 이 분포를 분류에도 사용할 수 있다.
각 범주에서 가 나타날 가능성을 비교해 가장 적합한 범주를 고른다. 모든 범주에서 그 가능성이 낮다면 어느 범주에도 잘 맞지 않는 이상치로 판단할 수도 있다.
여기서 는 입력 feature를 보기 전 label distribution이라고 볼 수 있다.
정답이 하나가 아니라 여러 plausible한 출력이 존재하고, 그 가능성들의 구조적인 분포까지 표현하고 싶을 때 생성 모델이 유용하다. GPT 같은 언어 모델도 다음 토큰 하나를 분류하는 것처럼 보이지만, 실제로는 이전 토큰들을 조건으로 다음 토큰의 확률분포를 반복적으로 모델링하고 그 분포에서 샘플링해 문장을 생성하므로 생성형 모델이다.
세 probability model의 관계
Discriminative model, unconditional generative model, conditional generative model은 베이즈정리로 연결된다.
베이즈정리는 동시확률(joint probability)에서 출발한다. 동시확률 는 와 가 함께 일어날 확률이며, 어느 변수를 먼저 기준으로 잡느냐에 따라 두 방식으로 분해할 수 있다.
이는 전체에서 가 일어날 확률에, 가 일어난 경우 도 일어날 조건부 확률을 곱한 것이다. 반대로 를 먼저 기준으로 잡으면 다음과 같다.
두 식은 같은 동시확률 를 나타내므로 다음 관계가 성립한다.
양변을 로 나누면 베이즈 정리 공식을 얻는다.
직관적으로는 evidence 를 관측했을 때 hypothesis 가 맞을 확률을 계산하는 식이다. 변수의 역할을 바꾸거나 위 식을 재배열하면 conditional generative model이 다루는 도 다음과 같이 표현할 수 있다.
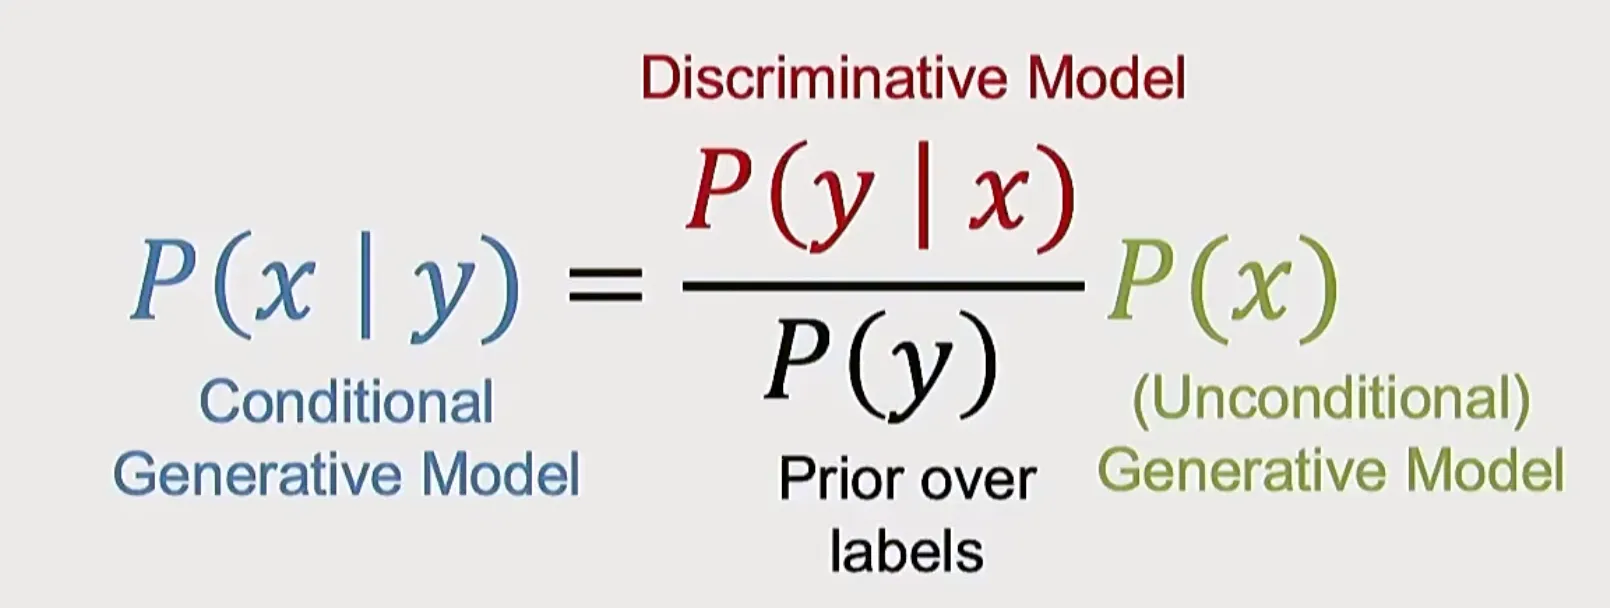
, , 를 알면 를 얻을 수 있다. 반대로 식을 재배열하면 다른 conditional distribution도 계산할 수 있다.
생성형 모델의 분류
Generative model은 density를 직접 계산할 수 있는지, sample을 어떤 방식으로 만드는지에 따라 나눌 수 있다.
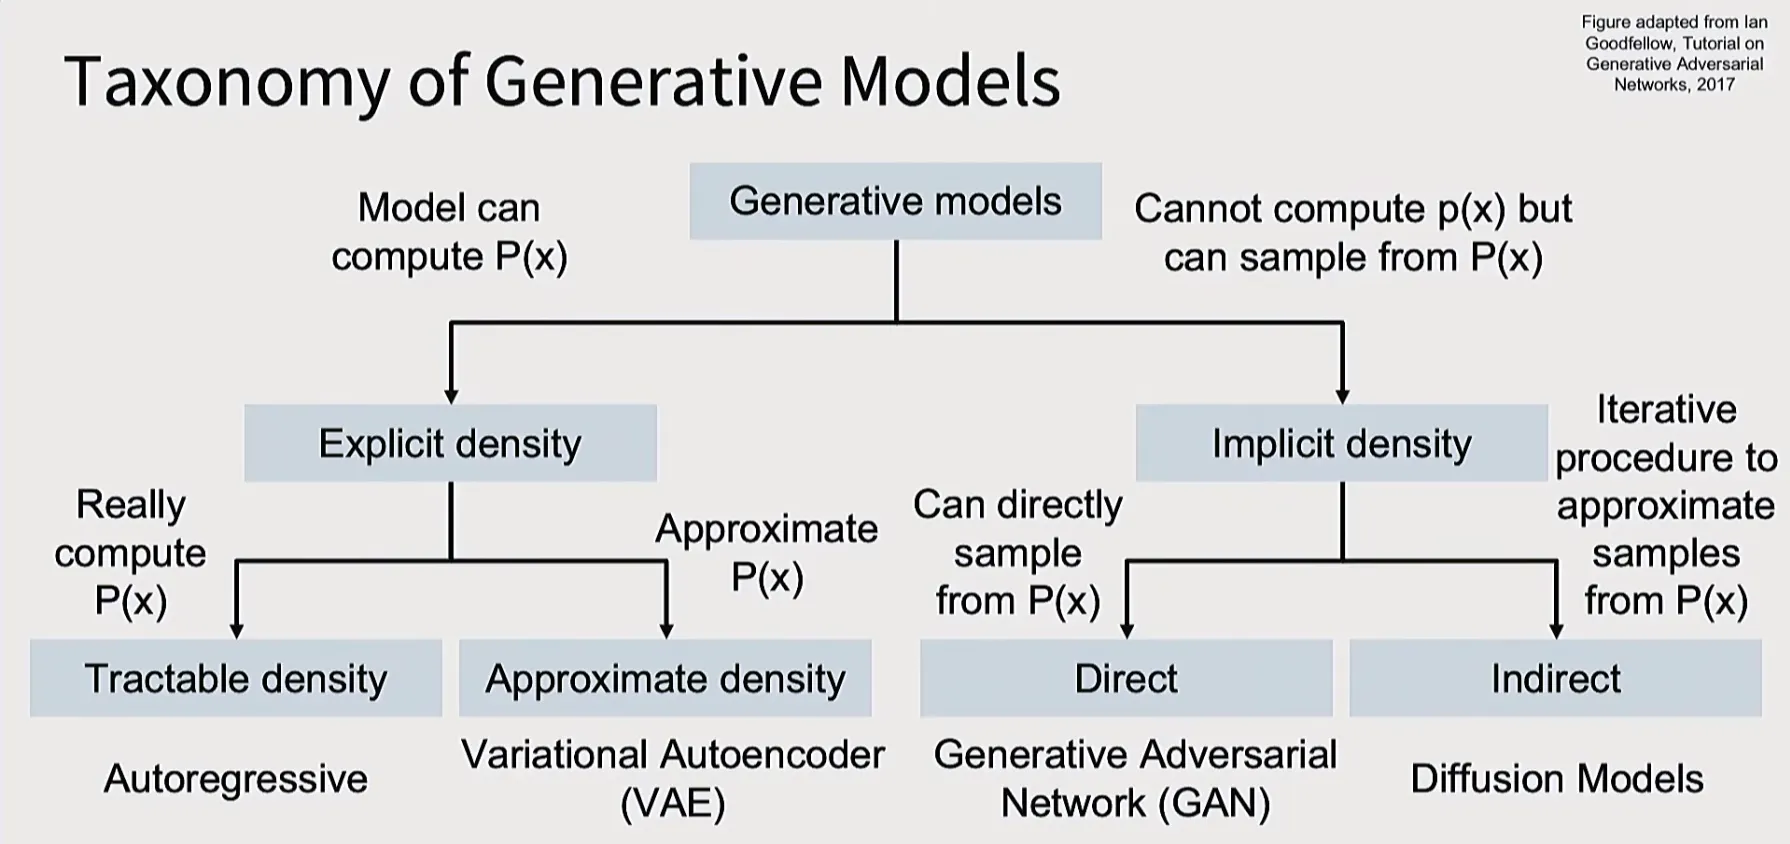
| 계열 | Density 평가 | Sampling | 대표 방법 |
|---|---|---|---|
| Explicit, exact density | Exact 계산 가능 | 대개 순차적이거나 구조에 의존 | Autoregressive model |
| Explicit, approximate density | 의 bound 또는 approximation 계산 | Latent에서 직접 생성 가능 | VAE |
| Implicit, direct sampling | 계산 불가 | 한 번의 generator forward | GAN |
| Implicit, iterative sampling | 를 직접 사용하지 않거나 계산이 복잡함 | 여러 refinement step 필요 | Diffusion model |
Explicit density model은 주어진 sample의 likelihood를 평가할 수 있다는 장점이 있다. 그러나 exact density를 쉽게 계산하는 구조가 sampling 속도나 model architecture를 제한할 수 있다.
Implicit model은 density 값보다 realistic sample 생성에 집중한다. GAN은 latent sample을 generator에 한 번 통과시켜 output을 만들고, diffusion model은 noise에서 시작해 여러 denoising step을 반복한다.
이 분류는 각 방법의 핵심 차이를 보는 틀이다. 실제 모델은 conditional generation을 추가하거나 latent token을 사용하는 등 여러 계열의 아이디어를 결합할 수 있다.
이후 수식에서는 표기를 단순하게 하려고 condition 를 생략하고 로 쓴다. 같은 논의는 에도 적용되며, 실제 응용에서는 조건부 생성을 다루는 경우가 많다.
%% title: Generative Model 분류
%% caption: Density를 얼마나 직접 다룰 수 있는지와 sample을 한 번에 만드는지 반복적으로 만드는지에 따라 대표 계열이 나뉜다.
flowchart TB
    gm["Generative Models"]
    gm --> explicit["Explicit Density"]
    gm --> implicit["Implicit / Sample-Based"]
    explicit --> exact["Exact Likelihood<br/>Autoregressive"]
    explicit --> approx["Approximate Likelihood<br/>VAE / ELBO"]
    implicit --> direct["Direct Sampling<br/>GAN"]
    implicit --> iterative["Iterative Sampling<br/>Diffusion / Flow"]
    exact --> trade1["likelihood 정확<br/>sampling 순차적"]
    approx --> trade2["latent sampling<br/>bound로 학습"]
    direct --> trade3["sampling 빠름<br/>density 없음"]
    iterative --> trade4["training 안정적<br/>sampling 반복"]
최대우도 추정(Maximum likelihood estimation)
최대우도 추정은 관찰한 data가 나타날 가능도를 가장 크게 만드는 parameter를 찾는 방법이다. 먼저 parameter 가 정해지면 의 확률을 계산할 수 있는 명시적인 함수로 distribution을 표현한다.
여기서 는 parameter 를 가진 신경망으로, 에 대한 확률을 계산한다.
학습에서는 data 는 고정하고 를 바꾸면서 관찰한 샘플들에 높은 확률을 부여하는 값을 찾는다.
최대우도추정 과정에서 하는 일은, 학습 데이터에 있는 고정된 샘플들의 확률을 최대화하도록 신경망이 모델링하는 분포를 변화시키는 것
관찰한 데이터는 알 수 없는 true distribution 에서 독립적으로 샘플링 되었다고 가정한다.(i.i.d-독립 동일 분포(independent and identically distributed))
Dataset 이 주어졌다고 하자. 샘플이 서로 독립이라는 가정을 사용하면 전체 likelihood를 각 샘플의 확률을 곱한 형태로 쓸 수 있다. 여기에 log를 적용하고 를 대입하면 학습 목표는 다음과 같이 정리된다.
Likelihood와 probability는 식의 모양은 같아도 무엇을 고정하고 변화시키는지가 다르다.
- Probability는 distribution parameter 를 고정하고 에 따라 값이 어떻게 달라지는지 본다.
- Likelihood는 관찰한 를 고정하고 에 따라 값이 어떻게 달라지는지 본다.
Log-likelihood와 negative log-likelihood
Log-likelihood는 모델이 각 학습 샘플에 부여한 log probability의 합이다.
Probability의 곱은 매우 작은 수가 되어 underflow가 발생하기 쉽다. 로그는 단조 함수(monotonic function)이므로 likelihood를 최대화하는 parameter와 log-likelihood를 최대화하는 parameter가 같다.
Optimization에서는 loss를 최소화하는 convention을 사용하므로 negative log-likelihood, NLL을 사용한다.
Dataset 크기에 관계없이 loss scale을 유지하려면 평균을 사용할 수 있다.
Categorical distribution에서 NLL은 cross entropy와 같은 형태가 된다. 따라서 language model의 next-token cross entropy도 autoregressive generative model의 maximum likelihood objective이다.
Autoregressive factorization
앞에서 정의한 를 계산하기 위해 하나의 data sample 를 순서가 있는 개 component로 나눈다고 하자.
여기서 아래첨자 는 한 샘플 안의 component 위치이고, 위첨자 는 dataset의 서로 다른 샘플을 나타낸다.
Probability chain rule을 사용하면 결합분포(joint distribution)를 조건부 분포(conditional distribution)의 곱으로 분해할 수 있다.
는 을 뜻한다. Log-likelihood는 다음과 같이 각 step의 합이 된다.
이렇게 분해할 때 변수들이 서로 독립이라고 가정할 필요는 없다. 그냥 모든 결합분포에 성립하는 확률의 연쇄법칙을 적용한 것이다. 모델이 해야 할 일은 전체 sequence의 모든 조합을 한 번에 모델링하는 대신 prefix가 주어졌을때 다음 컴포넌트의 분포를 예측하는 것이다.
각 가 개 값 중 하나를 갖는 discrete variable이라고 하면, 길이 의 토큰 시퀀스에는 총 개의 가능한 조합이 존재한다.
Autoregressive factorization은 개 결합 결과(joint outcome)를 테이블로 직접 저장하지 않고 매 step 개 category에 대한 conditional distribution을 예측하게 한다.
%% title: Autoregressive Factorization의 Training과 Sampling
%% caption: Training에서는 causal mask로 모든 next-token loss를 병렬 계산할 수 있지만, sampling은 새 token을 이전 prefix에 붙여 순차적으로 반복해야 한다.
flowchart TB
    sequence["Sequence x₁, x₂, …, xᵀ"] --> factor["p(x) = Π p(xₜ | x<ₜ)"]
    factor --> train["Training<br/>ground-truth sequence + causal mask"]
    train --> parallel["All Position Losses<br/>parallel computation"]
    factor --> sample["Sampling"]
    sample --> t1["sample x₁"]
    t1 --> t2["sample x₂ | x₁"]
    t2 --> t3["sample x₃ | x₁,x₂"]
    t3 --> more["… repeat until xᵀ"]
RNN과 causal Transformer
RNN hidden state 는 prefix 의 정보를 요약한다.
Hidden state에서 다음 토큰의 분포를 예측할 수 있다.
Causal Transformer는 attention mask로 position 가 미래 토큰을 보지 못하게 한다.
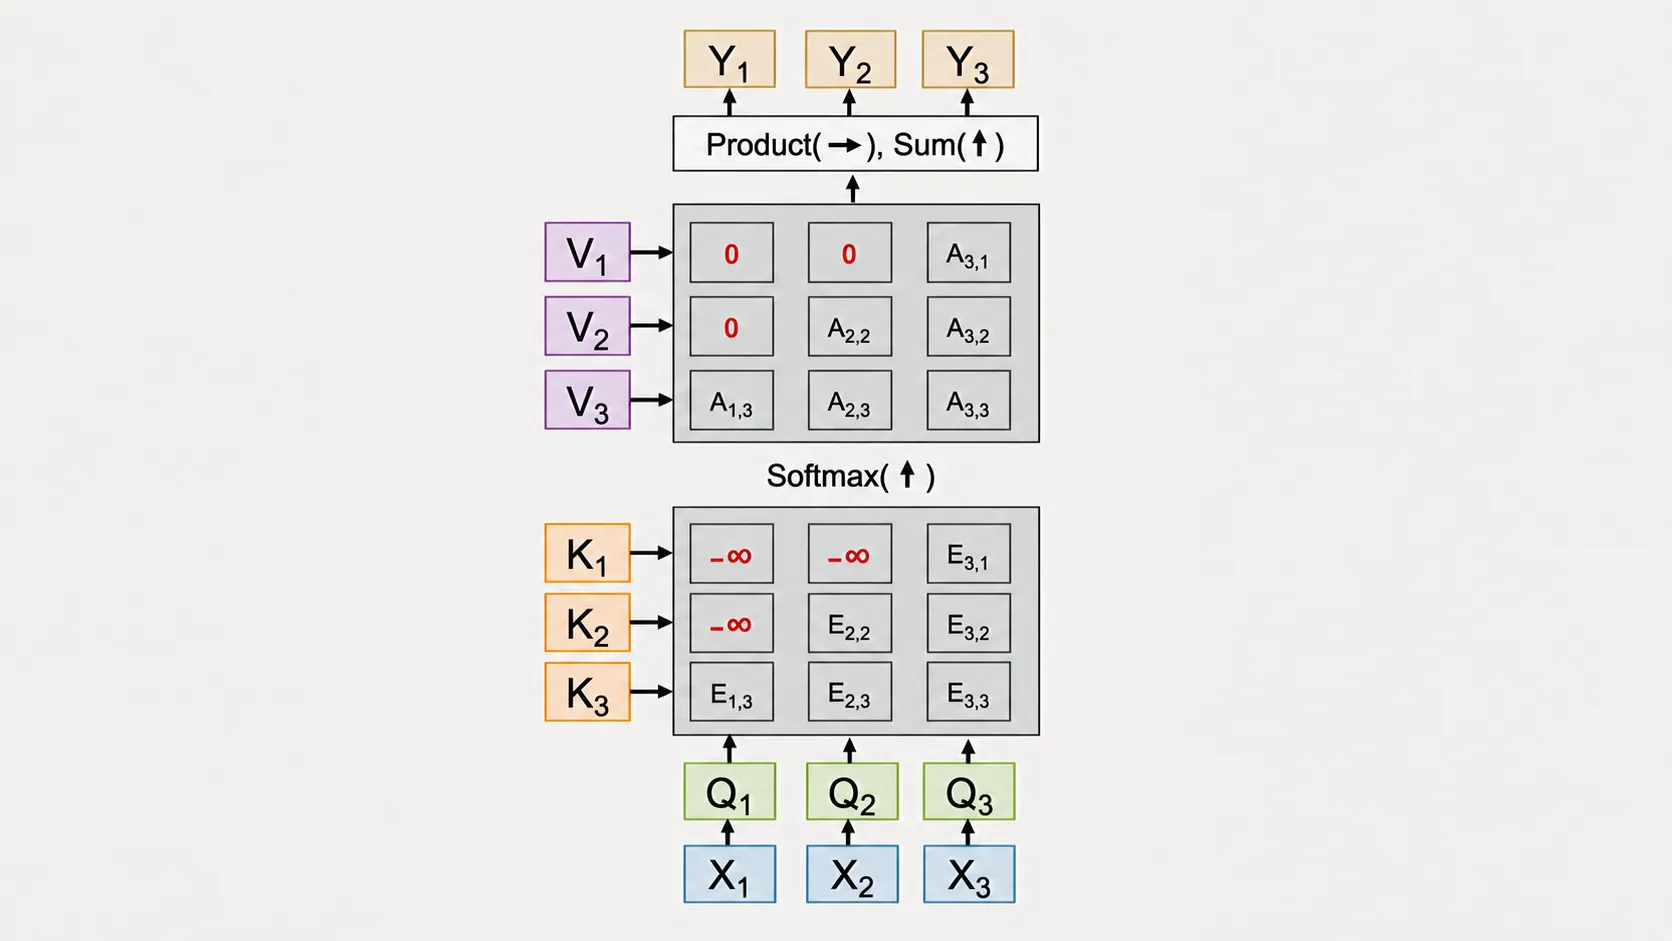
훈련에서는 GT sequence 전체를 한 번에 넣고 모든 position의 next-token loss를 병렬로 계산할 수 있다. 각 출력은 causal mask 때문에 prefix에만 의존한다.
Sampling에서는 아직 생성하지 않은 미래 토큰을 input으로 사용할 수 없다. 첫 token부터 하나씩 sampling하고 다시 모델에 넣어 다음 token을 생성해야 하므로 sequence length 방향으로 순차적이다.
Autoregressive model의 exact likelihood
주어진 complete sequence 를 모델에 넣으면 각 position에서 실제 next token에 부여한 probability를 얻는다. 이를 모두 곱하면 sample의 exact model likelihood가 된다.
구현상으로는 probability를 직접 곱하지 않고 log space에서 더한다.
Autoregressive model이 explicit exact-density model로 분류되는 이유이다. Model architecture와 parameter가 정해지면 임의의 sequence에 대한 normalized likelihood를 계산할 수 있다.
Image를 autoregressive sequence로 만들기
Text는 token의 1D sequence이고 각 token이 discrete vocabulary에 속하므로 autoregressive modeling과 자연스럽게 맞는다. Image는 2D이고 픽셀 밝기값(intensity)를 continuous value로 볼 수 있어 순서를 정하고 output distribution을 선택해야 한다.
8-bit RGB 이미지는 각 채널값이 0부터 255까지의 정수다. 이미지를 한줄로 읽는 Raster scan 순서로 픽셀과 채널을 펼치면 discrete sequence로 바꿀 수 있다.
RGB 이미지를 채널 단위로 펼치면 sequence length는 다음과 같다.
각 position에서 256-way softmax로 다음 channel 값을 예측할 수 있다. PixelRNN이나 PixelCNN 계열은 이 원리를 이미지에 적용한다.
문제는 sequence가 지나치게 길어진다는 점이다. Training computation이 크고 샘플링은 수백만 step을 순차적으로 실행해야 한다. 또한 raster order는 image의 2D structure를 자연스럽게 반영하는 유일한 순서가 아니다.
최근에는 raw pixel보다 압축된 latent token이나 discrete visual token을 autoregressive하게 모델링한다. Sequence가 짧아지고 high-level structure를 토큰 단위로 다룰 수 있지만, 이미지를 토큰으로 바꾸는 별도의 encoder나 tokenizer가 필요하다.
Autoregressive model의 장단점
장점은 다음과 같다.
- Probability chain rule에 기반해 exact normalized likelihood를 계산한다.
- NLL이라는 명확하고 안정적인 objective로 학습한다.
- RNN과 causal Transformer를 그대로 사용할 수 있다.
- Text처럼 순서와 discrete vocabulary가 자연스러운 데이터에 잘 맞는다.
한계는 다음과 같다.
- Sampling이 sequence length에 대해 순차적이다.
- Image처럼 순서가 명확하지 않은 데이터에는 순서를 인위적으로 정해야 한다.
- Raw pixel sequence는 너무 길어 고해상도 생성 비용이 크다.
- Likelihood가 높다는 것과 사람이 느끼는 인지적 품질(perceptual quality)가 항상 일치하지는 않는다.
(Non-Variational) Autoencoders (Deterministic Autoencoder)
Deterministic Autoencoder는 입력마다 확률분포가 아닌 하나의 고정된 latent code를 직접 생성하는 Autoencoder다.
같은 입력을 넣으면 항상 같은 latent representation이 나오며, latent space 자체에 확률적인 불확실성을 두지 않는다.
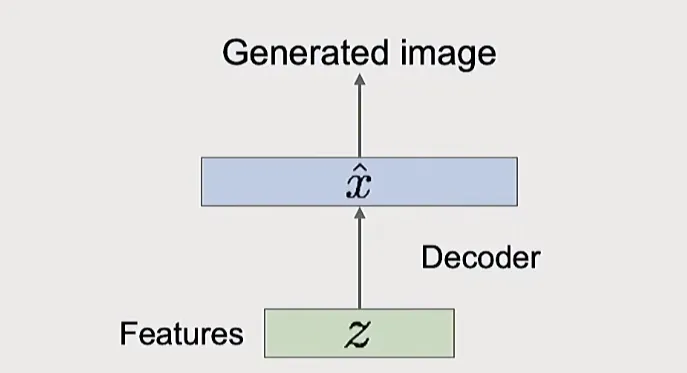
Autoencoder는 encoder가 input 를 latent code 로 압축하고 decoder가 이를 다시 reconstruction 로 복원한다. 입력을 압축해서 라는 표현으로 만들고, 그 만으로 원본을 얼마나 잘 복원하는지를 통해 입력의 중요한 정보를 학습하게 한다. reconstruction은 일종의 자기지도 학습용 훈련 과제라고 생각할 수 있다.
Reconstruction objective 자체가 최종 목적은 아니다. 입력을 그대로 복사하는 방법은 이미 알고 있으므로 제약 속에서 입력의 중요한 구조를 에 담는 representation을 학습하는 것이 목적이다.
대표적인 reconstruction objective는 L2 loss이다.
- : 원본 입력
- : parameter 를 가진 encoder
- : parameter 를 가진 decoder
- : 복원된 입력
- : 원본과 복원 결과 사이의 제곱 L2 거리
Encoder와 decoder의 capacity가 충분하고 가 크면 Autoencoder가 의미 있는 특징을 배우지 않고 입력을 단순히 복사할 수 있다. 이를 막기 위한 bottleneck은 latent dimension 를 작게 만들어 정보를 압축하도록 하는 제약이다. noise는 입력 일부를 가리거나 잡음을 섞어 단순 복사 대신 원래 구조를 복원하도록 만드는 제약이다.
예를 들어 RGB image는 약 300만 개 채널 값을 가지지만 를 128-dimensional vector로 제한할 수 있다. 모델은 모든 픽셀을 그대로 전달할 수 없으므로 reconstruction에 중요한 정보를 latent code에 압축해야 한다.
Representation learning에는 인코더와 를 사용할 수 있다. 그러나 deterministic autoencoder만으로 generation을 하기는 어렵다. 훈련 샘플이 latent space 어디에 매핑 되는지는 알 수 있지만, valid sample을 만드는 새로운 를 어떤 distribution에서 뽑아야 하는지는 정의되지 않기 때문이다.
핵심 문제는 일반 Autoencoder가 latent space에 알려진 probabilistic structure를 부여하지 않는다는 것이다. Reconstruction만 잘하면 되므로 latent code들이 공간에 어떤 형태로 배치되는지는 모델에게 맡겨진다. 따라서 latent space에서 임의의 를 뽑더라도 그것이 실제 데이터와 비슷한 결과를 만들어내는 valid latent인지 알 수 없다.
그렇다면 latent space를 아무렇게나 두지 않고 우리가 알고 있는 probability distribution의 형태에 가깝도록 정리할 수는 없을까?
VAE는 latent representation이 Gaussian distribution과 같은 알려진 distribution에 가까워지도록 제약한다. 그러면 학습 이후 새로운 입력 없이도 알려진 distribution에서 새로운 latent code를 샘플링 할 수 있다.
샘플링한 latent code를 디코더에 넣으면 새로운 데이터를 생성할 수 있다.
일반 Autoencoder에서는 새로운 latent code를 어디서 뽑아야 하는지가 불분명하지만 VAE는 latent space에 probabilistic structure를 부여하여 알려진 distribution에서 새로운 를 샘플링 할 수 있게 한다.
일반 Autoencoder는 의 reconstruction만 학습하고, 그 사이의 latent code 가 어떤 분포를 가져야 하는지는 따로 학습하지 않는다. 그래서 의 분포가 랜덤하게 형성될 수 있고, generation할 때 새로운 를 어디서 뽑아야 할지 알 수 없다.
새로운 를 만들 수만 있다면 이를 decoder에 넣어 새로운 를 생성할 수 있다.
Variational AutoEncoders(VAEs) - VAE의 latent-variable model
VAE는 관측 데이터 를 설명하는 잠재변수 의 분포를 학습하고, 그 latent space에서 샘플링해 새로운 데이터를 생성하는 latent-variable generative model이다.
서로 독립적으로 뽑힌 training data를 다음과 같이 두자.
VAE는 각 관측값 가 관찰되지 않은 잠재변수 로부터 생성되었다고 가정한다.
이미지를 예로 들면 는 물체의 속성이나 방향처럼 를 만들어낸 잠재 요인을 나타낸다고 해석할 수 있다.
이는 실제 데이터가 반드시 이러한 과정으로 만들어진다는 주장이 아니라 VAE가 데이터를 설명하기 위해 사용하는 probabilistic modeling assumption이다.
이 생성 가정을 어떻게 학습할 수 있을까? 기본 아이디어는 최대우도(maximum likelihood)이다. 그러나 훈련 데이터에서는 만 관찰되고 이를 생성한 는 관찰되지 않으므로, 의 우도를 구하려면 가능한 모든 를 고려해 주변화해야 한다.
PixelRNN과 PixelCNN 같은 autoregressive model은 다음과 같이 density를 명시적으로 계산하고 training data의 likelihood를 직접 최대화할 수 있다.
VAE는 이와 달리 exact likelihood를 직접 계산하는 대신 lower bound를 최적화한다. 그 대신 encoder가 데이터를 설명하는 structured latent vector를 제공하며, 이를 representation과 generation에 사용할 수 있다.
Variational Autoencoder, VAE는 latent code에 known probability distribution을 부여한다. Generative process는 먼저 사전분포에서 latent 를 뽑고, decoder distribution에서 data 를 뽑는 과정이다.
가장 흔한 사전분포(prior)는 standard Gaussian이다.
학습이 끝나면 사전분포에서 새로운 latent code를 뽑고, 학습된 decoder distribution에서 새로운 데이터를 샘플링한다.
여기서 는 학습을 마친 decoder의 파라미터다.
결합분포는 다음과 같다.
훈련 데이터에서는 만 관찰할 수 있고 를 생성한 는 관찰할 수 없다. 는 latent variable이다.
주변우도(Marginal likelihood)가 어려운 이유
Maximum likelihood로 decoder 를 학습하려면 latent variable을 모두 주변화(marginalize)해야 한다.
주변화(marginalization)는 관찰하지 못한 잠재변수 를 가능한 모든 값에 대해 적분하여 없애는 것이다. 어떤 에서 가 생성되었는지 알 수 없으므로, 가능한 모든 에서 가 나올 확률 또는 확률밀도를 합산한다.
첫 번째 등식은 결합분포 를 에 대해 적분하는 과정이고, 두 번째 등식은 이를 조건부분포와 사전분포의 곱으로 풀어 쓴 것이다. 직관적으로는 가능한 모든 를 고려한 뒤 가 나올 확률만 남기는 과정이다. 이렇게 를 없애고 만 남긴 를 주변분포(marginal distribution)라고 한다.
이때 사전분포 항은 모델이 정한 분포라 계산할 수 있고, 는 디코더가 를 입력받아 의 조건부분포를 계산하므로 주어진 에서 구할 수 있다. 어려운 것은 각 항의 계산이 아니라 가능한 모든 에 대해 이를 적분하는 과정이다. 그렇기에 적분항(integrand)은 계산할 수 있지만, 고차원 잠재공간 전체에 대한 적분은 일반적으로 계산하기 어렵다.
디코더가 신경망이면 는 에 대한 복잡한 nonlinear function이다. 고차원 latent space 전체를 정확히 적분하는 것은 일반적으로 불가능하다.(고 한다.) 또한 훈련 루프 내부에서 수치 적분을 시도하는것 또한 효과적인 방법은 아니다.
그렇기에 latent variable을 주변화하여 marginal likelihood를 정확히 계산하기 어렵다. 그런데 이 marginal likelihood는 latent variable의 정확한 사후분포를 계산할 때도 필요하다.
사후분포 수식정리
베이즈정리로 정확한 사후분포(true posterior)를 쓰면 다음과 같다.
강의에서는 이 베이즈정리를 에 대해 정리한 형태도 사용한다. 먼저 결합분포는 두 가지 방식으로 분해할 수 있다.
또한 순서를 반대로 쓰면 다음과 같다.
두 식은 같은 결합분포를 나타내므로 다음이 성립한다.
양변을 로 나누면 강의에 나온 식을 얻는다.
새로운 식이 아니라 베이즈정리를 에 대해 다시 정리한 것이다. 여기서는 고정된 사전분포를 사용하는 VAE 표기에 따라 로 썼다. 사전분포를 로 표기하더라도 유도 과정은 같다.
분모의 가 바로 계산하기 어려운 marginal likelihood이므로 사후분포도 직접 계산하기 어렵다. 여기서 근사 사후분포가 필요해진다.
근사 사후분포까지의 맥락을 정리해 보자면,
대략 다음 흐름을 머릿속에 정리하고자 한다.
-
먼저 사전분포(prior)에서 latent 를 샘플링 한다고 가정한다.
-
가 주어지면, Decoder가 조건부분포를 모델링하고, 그 분포에서 가 생성된다.
-
그런데 실제 학습 데이터에서는 만 관측하고, 어떤 가 를 만들었는지 모른다. 그래서 관측된 를 만들어낸 latent 를 추론하기 위해 다음 사후분포가 필요하다.
-
사후분포를 구하기 위해서 베이즈 정리를 쓰면 다음과 같다.
-
여기서 분모의 주변우도는 모든 가능한 를 주변화 해야한다.
-
그런데 Decoder가 신경망이라서 이 적분은 고차원 잠재공간에서 복잡한 비선형 함수를 적분하는 문제로 바뀌고, 일반적으로 정확하게 계산하기 어렵다.
-
따라서 정확한 사후분포(true posterior) 도 정확하게 계산하기 어렵다.
-
그래서 계산하기 쉬운 근사 사후분포를 둔다.
-
이 의 파라미터를 로부터 만들어주는 신경망이 Encoder이다.
-
이후 근사 사후분포에서 를 샘플링한다.
사후분포를 고려한 학습 전체 직관과 생성 직관은 다음과 같다.
근사 사후분포에서 를 샘플링하고, 그 를 디코더에 넣어 조건부 생성분포 를 얻고 그 분포를 통해 복원된 를 얻는다.
학습 이후 생성시에는 latent space를 prior에서 샘플링 가능하도록 정리되어 있기 때문에, 인코더를 거치지 않고 prior에서 바로 를 뽑는다.
근사 사후분포(Approximate posterior)와 encoder
근사 사후분포는 계산하기 어려운 정확한 사후분포(true posterior)를 대신해 사용하는 근사 확률분포다.
VAE는 true posterior 를 직접 계산하는 대신 encoder network로 approximate posterior를 학습한다.
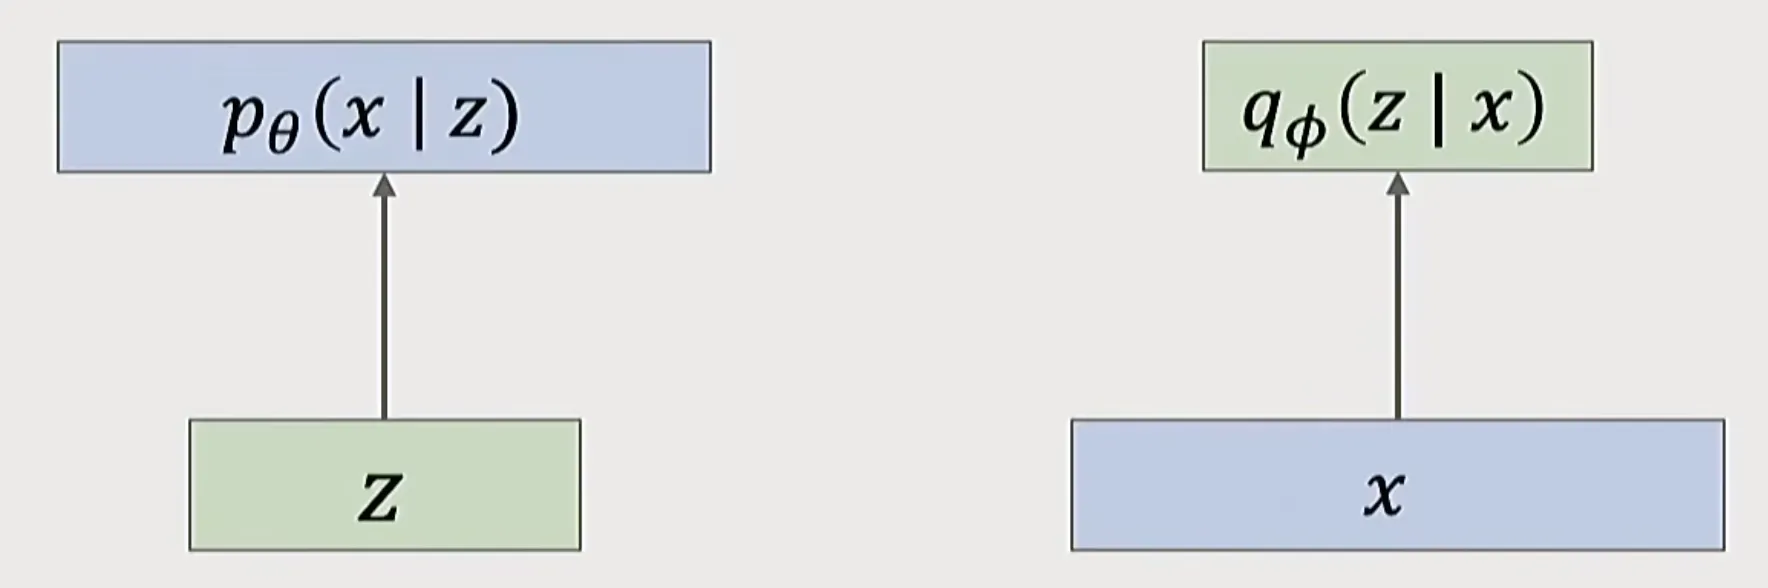
이 관계를 베이즈정리로 정리한 식에 대입하면 다음과 같이 를 근사할 수 있다.
이때 VAE는 서로 독립적인 가중치 와 를 가진 두 신경망인 디코더와 인코더를 함께 학습한다. 디코더는 잠재코드 를 입력받아 관측값 의 분포를 출력하고, 인코더는 를 입력받아 의 분포를 출력한다.
확률분포를 신경망이 출력하도록 만들기 위해 두 분포를 정규분포로 가정하고, 신경망이 그 매개변수를 출력하게 한다.
디코더가 출력하는 분포
연속형 이미지를 모델링하는 단순한 VAE에서는 디코더의 조건부분포를 고정 분산을 가진 대각 가우스 분포로 둘 수 있다.
디코더는 평균 를 출력하고 분산 는 고정한다.
디코더가 출력하는 평균 는 관측값 와 같은 형상이며, 고정 분산 는 모든 차원에 동일하게 적용된다.
픽셀마다 서로 다른 분산을 학습할 수도 있지만, 픽셀 사이의 공분산을 모델링하지 않으면 이 분포에서의 표본 생성은 평균 이미지에 픽셀별 분산으로 크기를 조절한 독립적인 잡음을 더하는 것과 같다. 이 방식은 픽셀 사이의 구조적인 변화를 표현하지 못하므로 디코더의 분산을 고정한다.
강의의 디코더는 를 확률분포로 정의하지만, 출력 이미지를 만들 때는 이 분포에서 픽셀별 잡음을 표본추출하지 않고 평균 를 그대로 사용한다.
인코더가 출력하는 분포
인코더가 모델링하는 근사 사후분포 를 대각 가우스 분포로 가정한다. 인코더는 잠재벡터 하나를 직접 출력하지 않고 이 분포의 매개변수를 출력한다.
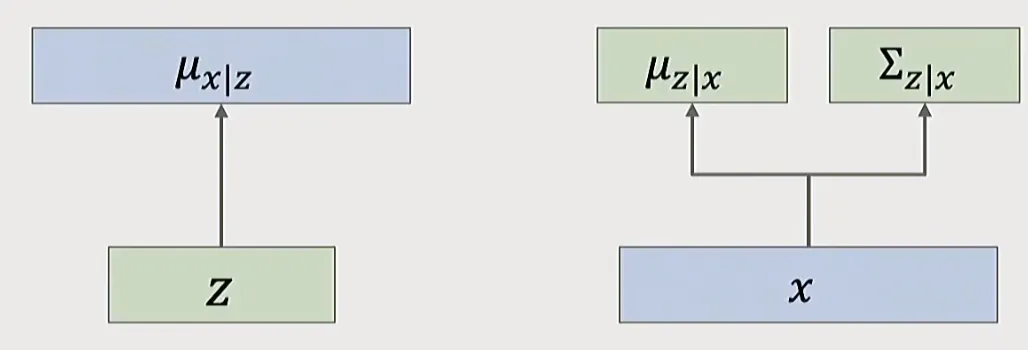
차원 잠재변수라면 인코더는 차원의 평균 벡터와 차원의 분산 또는 로그 분산 벡터를 출력한다. 대각 공분산의 각 항목은 잠재변수 각 차원의 분산을 나타낸다. 완전 공분산은 개의 값을 필요로 하므로 대각 공분산을 사용한다.
와 는 모두 잠재변수 와 같은 크기의 벡터다.
대각 공분산은 비대각 원소를 으로 두므로 서로 다른 잠재 차원 사이의 상관관계를 모델링하지 않는다. 예를 들어 개의 값에 대한 완전 공분산은 개의 항목을 필요로 하지만, 대각 공분산은 개의 분산만 필요로 한다.
분산은 항상 양수여야 하므로 제약이 없는 를 출력하고 지수함수를 적용해 분산을 얻는다.
복원 손실
위에서 가정한 디코더의 가우스 분포에 관측값 를 넣어 밀도함수를 풀어 쓰면 다음과 같다. 여기서 는 의 차원이다.
이 식에 를 취하면 곱은 합으로 바뀌고 지수함수가 풀린다.
분산 를 고정했으므로 첫 번째 항은 학습되는 와 관계없는 상수다. 따라서 음의 로그우도를 다음과 같이 쓸 수 있다.
따라서 고정 분산 가우스 우도를 최대화하는 것은 상수항과 고정된 비례계수를 제외하면 L2 복원 오차를 최소화하는 것과 같다. 픽셀별 독립 가우스 분포는 여러 가능한 이미지의 세부 표현을 평균내기 때문에 복원 결과와 생성 표본이 흐릿해질 수 있다.
Evidence Lower Bound
ELBO까지의 맥락을 정리해 보자면,
지금까지는 계산하기 어려운 정확한 사후분포(true posterior) 를 인코더가 만드는 근사 사후분포 로 대신하는 구조를 만들었다. 하지만 이것만으로는 인코더와 디코더를 어떤 학습 목표로 함께 학습할지가 아직 정해지지 않았다.
원래 목표는 관측 데이터 의 로그우도를 크게 만드는 것이다.
하지만 는 잠재변수 를 모두 주변화해야 하므로 직접 계산하기 어렵다.
따라서 직접 계산하기 어려운 를 그대로 최적화하는 대신 계산 가능한 하한을 training objective로 사용하고 이것을 최대화하는 방향으로 인코더와 디코더를 함께 학습한다. 그 하한이 ELBO다.
ELBO
VAE는 직접 계산하기 어려운 대신 Evidence Lower Bound, ELBO를 최대화한다.
직관적으로는 직접 계산하기 어려운 를 아래에서 받치는 하한을 두고, 그 하한을 끌어올려 실제 에 가깝게 만드는것이다.
먼저 베이즈정리로 정리한 식에 을 곱한 뒤 로그를 세 항으로 분리한다.
오른쪽에는 가 들어 있지만 세 항을 다시 합치면 가 상쇄되고, 베이즈정리에 따라 나머지 항도 로 돌아간다. 따라서 식 전체는 와 무관한 값이다.
와 무관한 상수 는 어떤 분포에서 를 표본추출하더라도 기댓값이 자기 자신과 같다.
는 에 의존하지 않으므로 에 대한 기댓값을 취해도 값이 같다.
위에서 분리한 세 항을 기댓값 안에 그대로 대입한다.
기댓값의 선형성에 따라 세 항을 각각의 기댓값으로 분리할 수 있다. 아래에서 는 에 대한 기댓값이다.
KL 발산(KL divergence)의 정의는 다음과 같다.
따라서 두 번째 항과 세 번째 항은 각각 다음 KL 발산이 된다.
첫 번째 항과 두 번째 항을 ELBO로 묶으면 전체 식은 다음과 같다.
첫 번째 항 - 데이터 복원(data reconstruction) 입력 에서 인코더가 만든 를 따라 를 표본추출하고, 디코더의 가 원래 에 높은 우도를 부여하도록 한다. 고정 분산 가우스 디코더에서 는 L2 복원 오차 형태로 계산할 수 있다.
두 번째 항 - 사전분포(prior) 는 인코더가 로부터 예측한 잠재공간의 분포이고, 는 사전분포다. ELBO를 최대화할 때 음의 KL 발산은 인코더의 출력 분포가 사전분포에 가까워지도록 한다. 두 분포가 가우스 분포이면 이 KL 발산을 닫힌 형태로 계산할 수 있다.
세 번째 항 - 사후분포 근사(posterior approximation) 인코더가 만든 근사 사후분포 가 정확한 사후분포 와 가까워져야 한다. 이 KL 발산은 와 ELBO 사이의 간격이며 항상 이상이다. 따라서 에서 음수가 아닌 KL 항을 빼고 보면 가 되므로 ELBO가 로그우도의 하한이 된다. 강의에서 KL 항을 drop 한다는 것은 등식에서 없애도 값이 같다는 뜻이 아니라 그 항을 제외한 값이 하한이 된다는 뜻이다. 정확한 사후분포를 계산하기 어려워 이 KL 항을 직접 계산해 학습하지는 못한다.
이를 간단히 쓰면 다음 항등식이 된다.
을 넣은 이유는 식의 값을 바꾸려는 것이 아니라 기댓값을 취했을 때 꼴을 KL 발산으로 바꿀 수 있게 만들기 위해서다.
KL divergence는 항상 0 이상이므로 ELBO는 log-likelihood의 lower bound이다.
직관적으로 log-likelihood가 ELBO에 0 이상의 값을 더한 형태이므로 ELBO가 보다 커질 수 없다.
ELBO는 다음 두 항으로 이루어진다.
두 식을 합치면 강의 슬라이드의 부등식을 다음과 같이 쓸 수 있다.
오른쪽 전체가 VAE의 학습 목표이며, 이 값을 최대화한다.
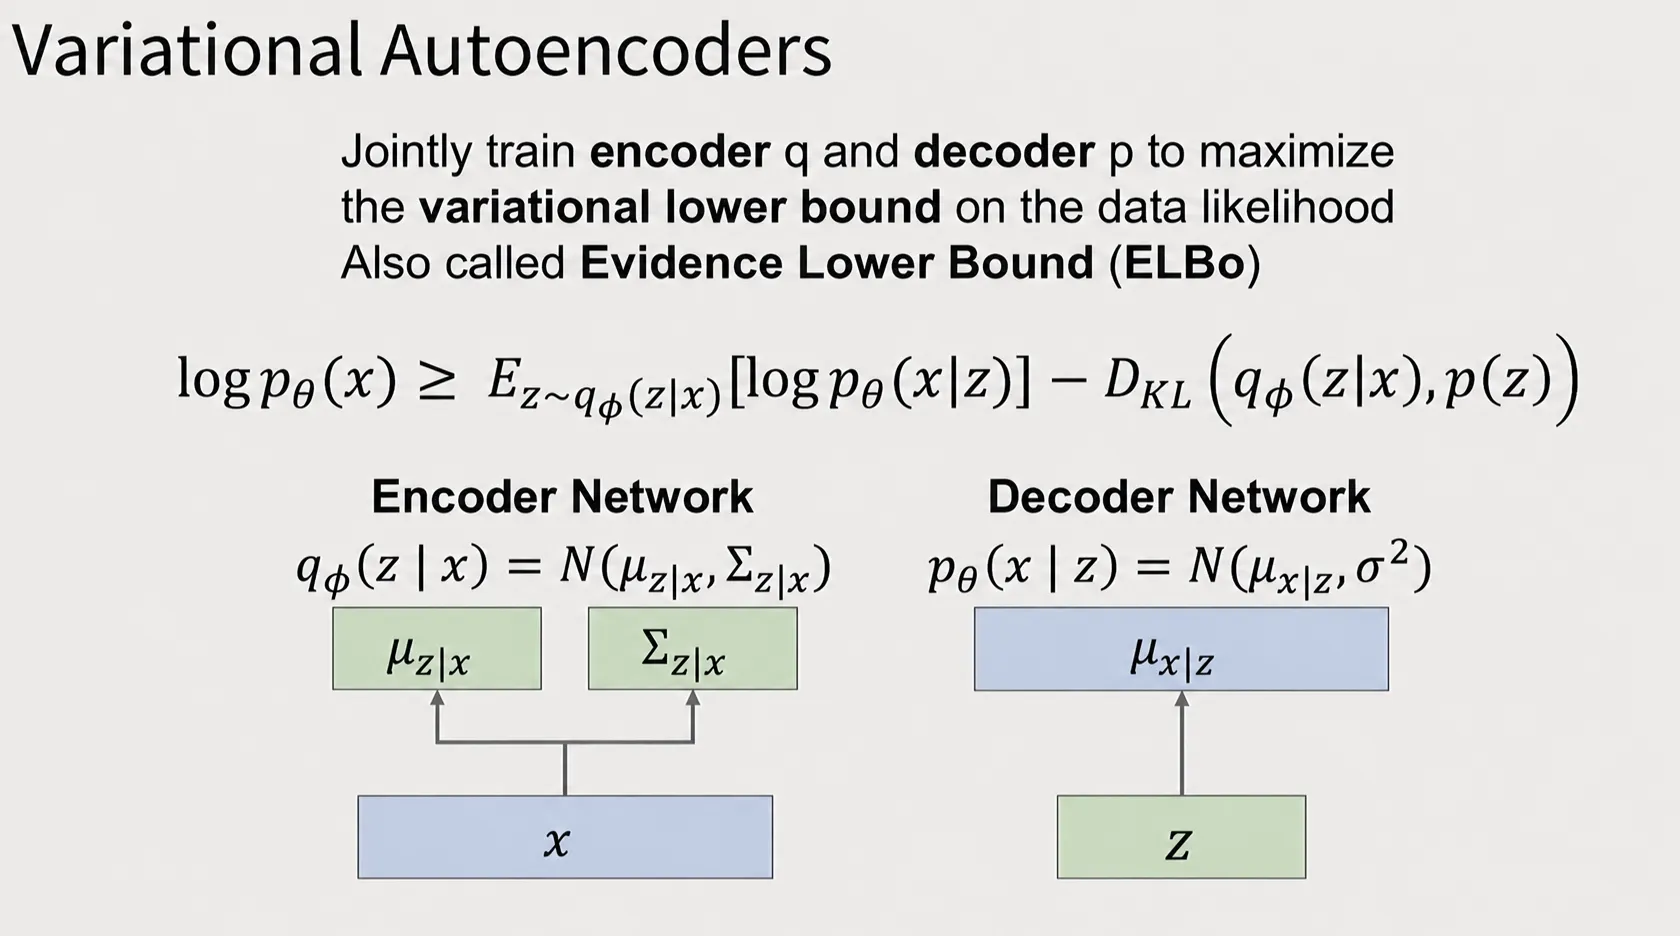
VAE는 ELBO를 최대화하도록 인코더의 와 디코더의 를 함께 학습한다. 인코더는 로부터 잠재분포의 평균과 공분산을 출력하고, 디코더는 표본추출한 로부터 의 분포를 출력한다.
첫 번째 항은 sampled latent 에서 original 를 높은 likelihood로 복원하게 한다. 두 번째 항은 encoder가 예측한 latent distribution을 미리 정한 사전분포 에 가깝게 만든다.
Loss를 최소화하는 형태로 쓰면 부호가 바뀐다.
그러므로 VAE loss는 reconstruction loss와 latent prior regularization의 합이다.
Gaussian KL divergence
Approximate posterior가 diagonal Gaussian이고 prior가 이면 KL 항을 샘플링 없이 정확히 계산할 수 있다.
이 항은 평균을 0에 가깝게, 분산을 1에 가깝게 유도한다. 모든 샘플의 posterior가 prior와 완전히 같아져야 한다는 뜻은 아니며, reconstruction objective와 균형을 이루며 latent space를 regularize한다.
재매개변수화 기법(Reparameterization trick)
Encoder distribution에서 직접 샘플링하는 연산은 일반적인 deterministic computation graph처럼 미분할 수 없다.
Sampling noise를 parameter와 분리하면 다음과 같이 다시 쓸 수 있다.
Randomness는 에만 있고, 는 와 에 대한 differentiable function이 된다. 따라서 decoder의 reconstruction gradient가 를 거쳐 encoder의 mean과 variance parameter까지 전달된다.
VAE training 과정
VAE는 variational lower bound를 최대화하는 방향으로 훈련한다.
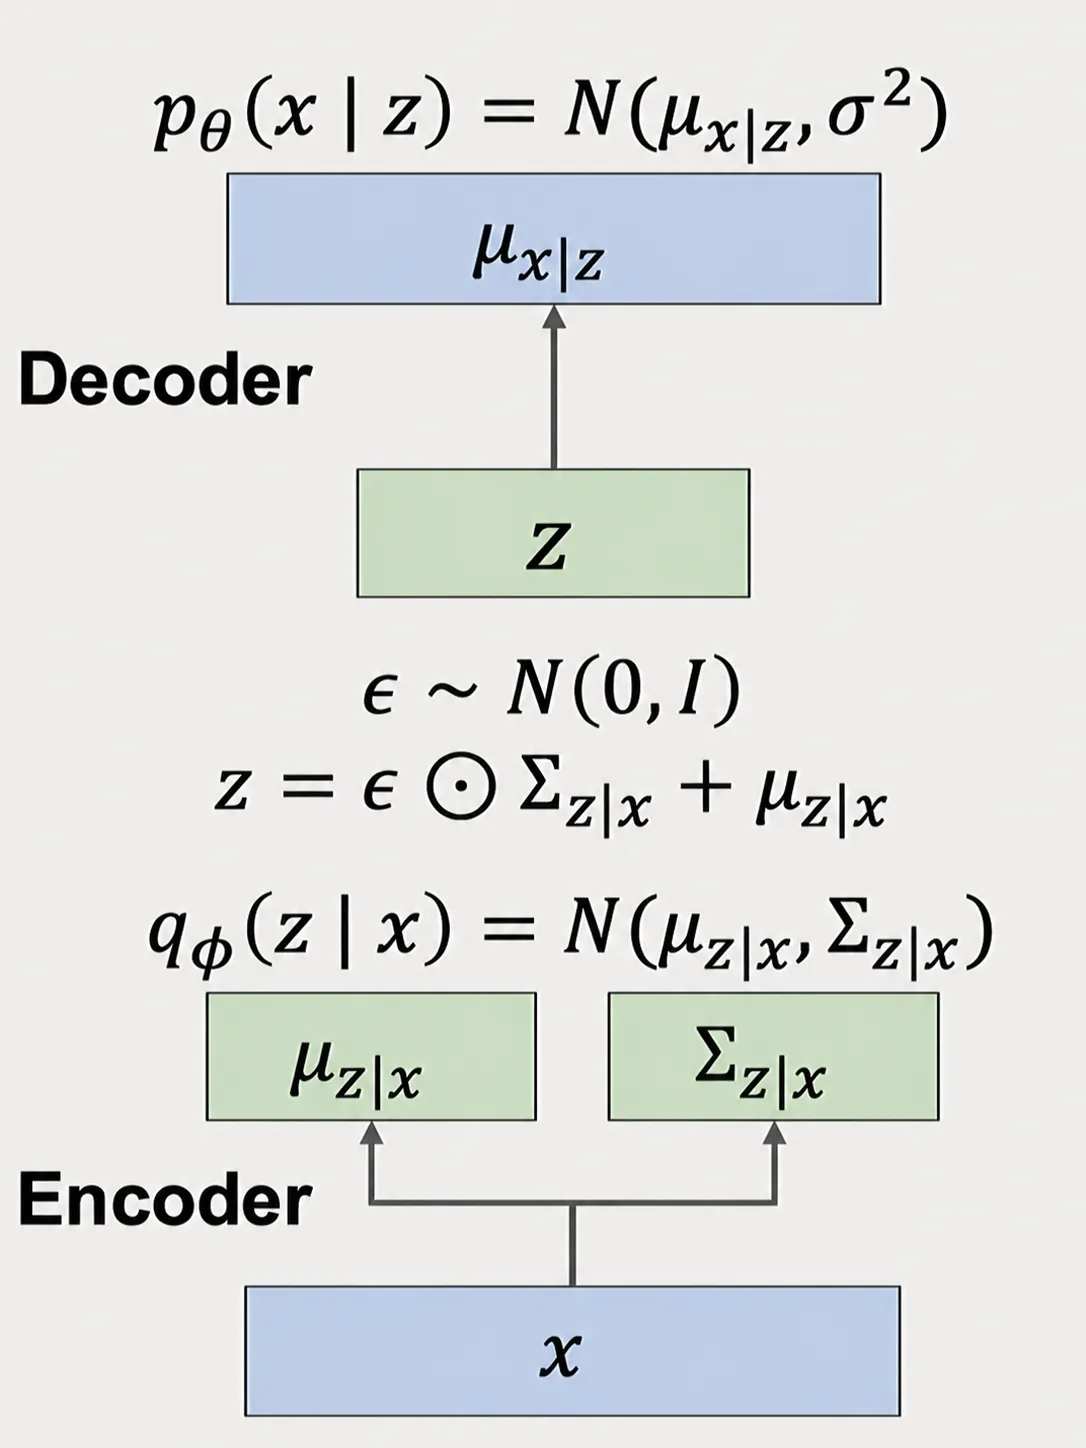
한 미니배치의 훈련 과정은 다음과 같다.
- 입력 데이터 를 인코더에 넣어 에 대한 분포 를 얻는다. 인코더는 와 를 출력하며, 표준편차는 로 구한다.
- 사전분포 손실(prior loss)을 계산하여 인코더 출력이 평균 0, 분산 1인 단위 가우스 분포 에 가까워지게 한다.
- 인코더가 출력한 에서 를 표본추출한다. 재매개변수화 기법(reparameterization trick)을 사용하여 를 뽑고 로 계산한다.
표기 참고: 강의자는 를 공분산의 대각성분으로 설명하지만, 재매개변수화 식에서는 이를 표준편차처럼 곱한다. 찾아보니 정확히는 다음과 같이 쓴다.
강의에서는 표기를 다소 느슨하게 사용한다.
- 를 디코더에 넣어 의 예측 데이터 평균 를 얻는다.
- 복원 손실(reconstruction loss)을 계산하여 예측 평균 가 원본 와 L2 거리에서 가까워지게 한다.
- 복원 음의 로그우도와 KL 발산을 더해 표본별 negative ELBO를 계산한다.
- 표본별 손실을 미니배치 전체에서 평균 낸다.
- 재매개변수화 경로로 역전파하고 인코더의 와 디코더의 를 함께 갱신한다.
이 두 손실을 통해 인코더 와 디코더 를 함께 학습한다. 기댓값은 각 훈련 표본마다 하나 또는 소수의 를 표본추출하여 몬테카를로 방식으로 근사한다. 재매개변수화 덕분에 이 확률적 추정값으로도 전체 경로의 기울기를 계산할 수 있다.
%% title: VAE의 End-to-End Training 경로
%% caption: Encoder가 approximate posterior의 μ와 σ를 만들고, reparameterization으로 latent z를 sample한 뒤 decoder가 x를 복원한다. Reconstruction NLL과 prior KL을 함께 최소화한다.
flowchart LR
    x["Input x"] --> encoder["Encoder qφ(z|x)"]
    encoder --> mu["μφ(x)"]
    encoder --> sigma["σφ(x)"]
    eps["ε ~ N(0,I)"] --> reparam["z = μ + σ ⊙ ε"]
    mu --> reparam
    sigma --> reparam
    reparam --> decoder["Decoder pθ(x|z)"]
    decoder --> recon["Reconstruction NLL"]
    x --> recon
    mu --> kl["KL(qφ(z|x) || N(0,I))"]
    sigma --> kl
    recon --> elbo["Negative ELBO"]
    kl --> elbo
    elbo -. "backpropagation" .-> encoder
    elbo -. "backpropagation" .-> decoder
Reconstruction과 prior의 trade-off
VAE의 reconstruction 항과 KL 항은 latent space 에 서로 반대되는 요구를 한다. 인코더는 입력 마다 하나의 고정된 를 바로 출력하는 대신, 가 따를 분포의 평균과 분산을 출력한다.
이 분포에서 실제 잠재벡터 를 하나 표본추출하여 디코더에 넣는다.
복원 항이 원하는 것
reconstruction loss는 원본 를 최대한 정확하게 복원하려 한다. 이를 위해 서로 다른 입력에는 서로 확실히 구분되는 고유한 평균을 부여하고, 같은 입력에서 표본추출되는 의 변동은 작게 만드는 편이 유리하다.
분산이 0에 가까우면 표본추출해도 거의 항상 평균과 같은 값이 나온다.
그러면 디코더는 각 잠재벡터를 입력 데이터의 식별자처럼 외워 복원할 수 있다. 복원은 쉬워지지만 평균들이 멀리 흩어지고 그 사이에 의미 없는 빈 영역이 생길 수 있다.
KL 항이 원하는 것
KL 항은 인코더가 만든 근사 사후분포 를 평균 0, 분산 1인 표준 가우스 사전분포에 가깝게 만든다.
따라서 입력마다 평균을 멀리 떨어뜨리는 대신 평균을 0 근처로 모으고, 0에 가까워지려는 분산은 1에 가까워지게 한다.
| 복원 항의 요구 | KL 항의 요구 |
|---|---|
| 서로 다른 입력을 확실히 구분함 | 잠재벡터를 같은 사전분포 안에 모음 |
| 입력마다 서로 다른 고유한 평균을 만듬 | 평균을 0 근처로 끌어당김 |
| 분산을 0에 가깝게 만듬 | 분산을 1에 가깝게 만듬 |
| 입력 정보를 최대한 많이 저장함 | 잠재공간을 연속적인 형태로 정돈함 |
복원 항만 사용하면 훈련 데이터는 잘 복원해도 각 데이터의 잠재벡터가 멀리 흩어져 중간 영역에 의미가 없을 수 있다. 그러면 사전분포에서 새로운 를 표본추출했을 때 실제 데이터와 비슷한 결과를 얻기 어렵다.
두 요구는 다음 ELBO 안에서 함께 최적화된다.
첫 번째 항은 를 복원할 정보를 에 충분히 보존하게 하고, 두 번째 항은 가 사전분포에서 크게 벗어나지 않도록 정돈한다.
복원 손실은 각 입력을 구별할 수 있도록 잠재벡터에 정보를 보존하려 하고, KL 발산은 그 잠재벡터들이 표준 가우스 분포를 따르도록 압축하고 정돈하려 한다.
VAE는 두 항의 균형을 통해 복원이 가능하면서 사전분포에서도 표본추출할 수 있는 연속적인 잠재공간을 학습한다. 반대로 KL 항이 지나치게 강하면 인코더가 입력 정보를 무시하고 항상 사전분포와 비슷한 분포를 내는 사후붕괴(posterior collapse)가 생길 수 있다.
VAE sampling과 latent interpolation
훈련할 때는 실제 데이터 를 인코더에 넣어 잠재분포를 만들고, 그 분포에서 를 표본추출한 뒤 디코더에 전달한다.
복원 항은 로부터 원래 데이터 를 설명할 수 있도록 디코더를 학습하고, KL 항은 인코더가 만드는 잠재분포를 미리 정한 사전분포와 호환되도록 만든다. 따라서 디코더는 사전분포와 호환되는 를 입력받아 의 조건부분포 를 만들도록 학습된다.
훈련과 생성에서 가 나오는 곳
훈련할 때 디코더가 받는 는 사전분포에서 직접 뽑은 값이 아니라 인코더의 근사 사후분포에서 뽑은 값이다.
KL 항이 이 근사 사후분포를 사전분포 쪽으로 규제했기 때문에, 생성할 때는 실제 와 인코더 없이 사전분포에서 를 직접 표본추출할 수 있다.
즉 는 입력 데이터의 분포에서 뽑는 것이 아니라 사전분포에서 뽑는다. 디코더는 이 를 조건으로 하는 의 조건부분포를 만들고, 그 분포에서 새로운 데이터 를 생성한다. 실제 출력으로는 조건부분포에서 표본추출하거나 그 분포의 평균 를 사용한다.
생성할 때는 사전분포에서 를 하나 표본추출하고, 그 를 디코더에 통과시켜 새로운 데이터를 만든다.
복원 손실만 사용했다면 각 데이터의 잠재벡터가 잠재공간 곳곳에 흩어질 수 있다. 이 경우 표준 가우스 분포에서 임의로 뽑은 가 디코더가 학습한 영역에 속한다는 보장이 없다. KL 항은 잠재분포를 사전분포 근처에 정돈하므로, 로 표본추출한 값이 학습된 잠재영역에 들어갈 가능성을 높인다. 반대로 학습에 사용한 사전분포와 크게 다른 분포에서 를 뽑으면 디코더가 거의 학습하지 않은 영역의 값이 들어갈 수 있으므로 제대로 된 데이터를 생성한다는 보장이 없다.
사전분포 제약으로 잠재공간이 연속적으로 정돈되므로 두 잠재벡터 사이를 보간하면 출력도 비교적 부드럽게 변한다.
손글씨 숫자 VAE에서 잠재차원을 움직이면 한 숫자가 다른 숫자로 부드럽게 변하는 모습을 볼 수 있다. 다음 그림은 두 잠재차원 과 를 각각 변화시키며 디코더가 생성한 결과를 배열한 것이다.
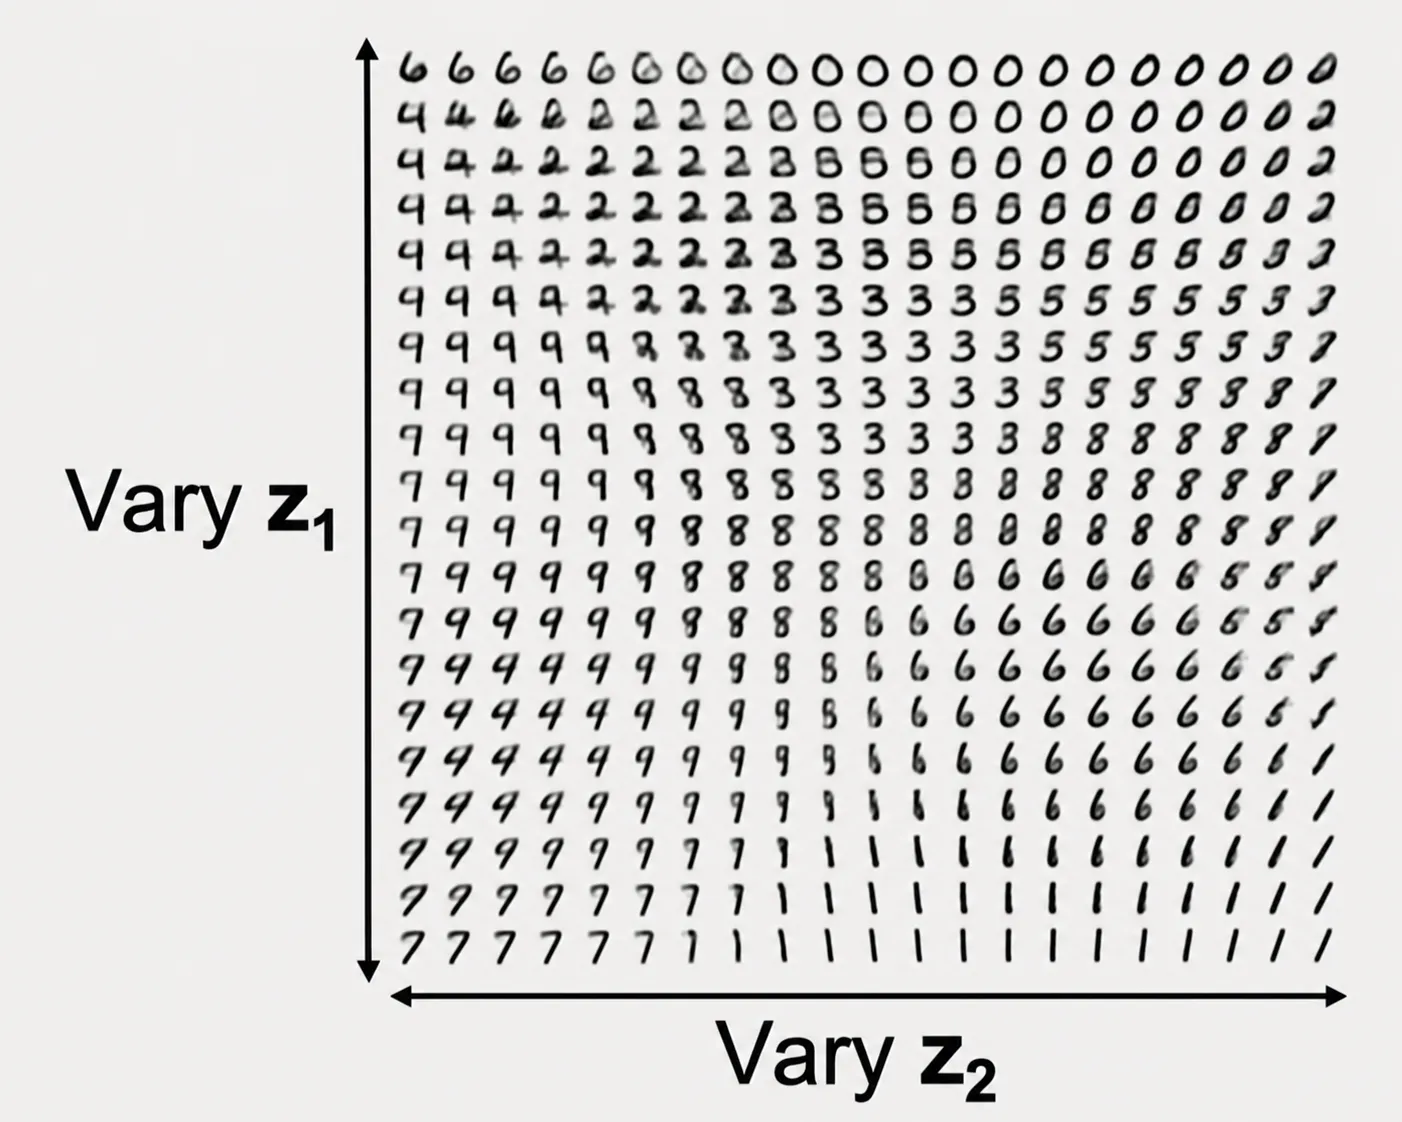
대각 가우스 사전분포는 의 각 차원이 서로 독립적인 형태를 갖도록 유도한다. 이 제약은 서로 다른 잠재차원이 데이터의 서로 다른 변화 요인을 나타내는 분리된 표현(disentangled representation)을 장려한다. 다만 각 차원이 반드시 독립적인 의미 요인을 표현하거나 분리된 표현이 자동으로 보장되는 것은 아니다.
%% title: VAE의 생성과 Latent Interpolation
%% caption: 새 sample을 만들 때는 encoder를 사용하지 않고 prior에서 z를 뽑아 decoder에 넣는다. 두 latent 사이를 이동하면 decoder output의 연속적인 변화를 볼 수 있다.
flowchart LR
    prior["Prior<br/>z ~ N(0,I)"] --> decoder["VAE Decoder<br/>pθ(x|z)"]
    decoder --> sample["Generated Sample x"]
    za["Latent z_a"] --> interp["z(α) = (1-α)z_a + αz_b"]
    zb["Latent z_b"] --> interp
    interp --> shared["Same Decoder"]
    shared --> path["Smooth Output Path<br/>x(0) … x(1)"]
Autoregressive model과 VAE 비교
| 항목 | Autoregressive model | VAE |
|---|---|---|
| Density | Exact normalized likelihood | ELBO로 log-likelihood를 lower-bound |
| Structure | Sequence factorization | Latent-variable model |
| Training | Next-token NLL | Reconstruction NLL + KL |
| Sampling | Token을 순서대로 생성 | Prior를 뽑아 decoder forward |
| Latent representation | 명시적인 global latent가 필수는 아님 | Encoder가 제공 |
| 장점 | Stable MLE, exact likelihood | Smooth latent space, fast generation |
| 한계 | Sequential sampling | Approximate likelihood, blurry output 가능 |
Autoregressive model은 exact density를 위해 sequence ordering과 sequential sampling을 받아들인다. VAE는 exact likelihood를 포기하고 tractable lower bound를 사용하지만, inference와 generation에 유용한 latent representation을 얻는다.