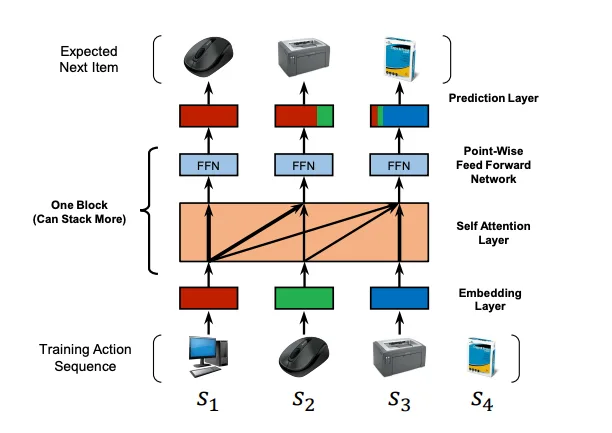
- 논문: Self-Attentive Sequential Recommendation
- 저자: Wang-Cheng Kang, Julian McAuley
- 학회: IEEE International Conference on Data Mining (ICDM)
- 연도: 2018
- 논문 링크: arXiv:1808.09781
1. TL;DR
SASRec은 사용자의 과거 행동 순서를 바탕으로 다음에 상호작용할 item을 예측하는 Sequential Recommendation 문제를 다룹니다. Markov Chain 기반 방법은 sparse data에서 강하지만 긴 범위의 dependency를 잡기 어렵고, RNN 기반의 방법은 상대적으로 긴 시퀀스를 모델링 할 수 있지만 dense data에서 더 잘 동작하는 경향이 있고 sequence를 순차적으로 처리해야 합니다.
SASRec는 Self-Attention을 이용하여 각 시점에서 과거 item 중 현재 prediction과 관련 있는 item에 서로 다른 weight를 부여합니다. 이를 통해 sparse한 데이터에서는 비교적 최근의 item에 집중하여 Markov Chain과 유사하게 동작하고, Dense한 데이터에서는 더 긴 범위의 item관계를 활용할 수 있습니다. 고정된 범위의 과거 정보만 사용하는 대신 필요한 과거 정보의 범위가 attention을 통해 적응적으로 결정됩니다.
SASRec는 4가지의 데이터셋에서 모든 비교 모델보다 높은 Hit@10과 NDCG@10을 기록했습니다. 각 데이터셋에서 가장 강한 baseline과 비교했을 때 평균적인 상대 개선폭은 Hit Rate 6.9%, NDCG 9.6%였으며, ML-1M의 학습 속도는 epoch 당 1.7초로 Caser의 19.1초, GRU4Rec+의 30.7초보다 훨씬 짧아 성능뿐만 아니라 학습 효율성에서도 강점을 보였습니다.
2. Problem & Motivation
문제 설정
사용자마다 시간 순서대로 정렬된 interaction sequence가 주어집니다. 모델의 목표는 이전 상호작용들을 이용하여 다음 item을 예측하는 것입니다. Sequence Rec에서는 interaction의 집합만 예측하는것뿐만 아니라 순서에 나타나는 패턴을 모델링 하는것이 중요합니다. 본 논문에서는 과거 행동을 많이 고려할수록 high-order sequential pattern(고차 순차 패턴)의 공간이 빠르게 커진다는 점을 문제로 인식합니다.
데이터 sparsity와 모델 복잡도
본 논문의 출발점은 MC(Markov Chain)과 RNN이 서로 다른 환경에서 강점을 보인다는 관찰입니다.
MC는 다음 행동이 직전 하나 또는 몇개의 행동에 주로 의존한다고 가정합니다. 모델이 비교적 단순하기 때문에 interaction이 적은 sparse dataset에서도 비교적 안정적입니다. 다만 멀리 떨어진 item 사이의 dependency를 표현하기 어렵다는 단점이 있습니다.
RNN은 hidden state를 통해 이전 sequence 전체의 정보를 전달할 수 있습니다. MC 대비 표현력은 높지만 충분한 dense data가 필요하고, time step 사이에 모델 자체의 구조적인 dependency가 존재하기 때문에 병렬화에 제약이 존재합니다.
3. Prior Work & Limitations
논문에서 중요한 비교 대상은 first-order MC, higher-order MC, RNN, CNN 기반 sequential recommendation입니다.
FPMC(Factorized Personalized Markov Chains)와 TransRec 같은 first-order MC 계열은 직전 item의 transition을 강하게 활용합니다. sparse dataset에서는 모델 구조가 단순하여 강점이 존재하지만 long-range dependency를 모델 자체가 직접 다루기 어렵습니다. Higher-order MC는 여러개의 이전 item을 사용할 수 있지만 order를 학습 전에 지정해야 하며, order가 커질수록 성능과 효율 측면에서 다루기 어려워 보통 작은 값을 사용합니다.
Caser(Convolutional Sequence Embedding Recommendation)는 최근 item들의 embedding matrix를 이미지처럼 구성하고, CNN으로 high-order transition을 추출합니다. GRU4Rec 계열은 RNN으로 전체 시퀀스를 처리합니다. RNN은 매 시점의 계산이 이전 시점에 구조적으로 의존하므로 시간축 방향의 병렬화가 어렵다는 단점이 있습니다.
Self-Attention에서는 한 레이어에서 임의의 두 position이 직접 연결될 수 있습니다. 본 논문은 RNN의 최대 path length가 sequence length에 따라 증가하는데 비해 Self-Attention의 path length는 일정하다는 점도 긴 의존성을 학습하는데 유리한 특성으로 제시합니다.
4. Core Idea & Contributions
SASRec의 핵심 아이디어는 과거 interaction을 몇개까지 볼 것인지를 미리 고정하지 않는 것입니다. 각 시점에서 Self-Attention이 이전 item마다 attention weight를 계산하고, 현재 next-item prediction과 관련 있는 item을 더 크게 반영합니다. sparse dataset에서는 최근 item에 높은 weight를 줄 수 있고, dense dataset에서는 더 먼 item까지 활용할 수 있습니다. 이 특징으로 MC와 RNN이 각각 강점을 보이는 특성을 하나의 모델에서 모두 활용할 수 있도록 합니다.
SASRec 논문의 주요 기여는 다음 세 가지로 볼 수 있습니다.
- recurrent 또는 convolutional 모듈 없이 Self-Attention을 중심으로 Sequential Recommendation 모델을 구성했습니다.
- history의 활용 범위를 attention으로 적응 가능하게 결정합니다. Figure 4에서 sparse한 Amazon Beauty 데이터셋에서는 최근 위치에 어텐션이 집중되고, dense한 MovieLens-1M은 상대적으로 먼 위치까지 weight가 퍼지는 현상을 확인하고 있습니다.
- 셀프 어텐션의 병렬 연산을 이용해 CNN/RNN 기반 시계열 모델보다 높은 학습 효율을 보였습니다.
5. Method
Overall Architecture
모델의 전체 흐름은 다음과 같습니다.
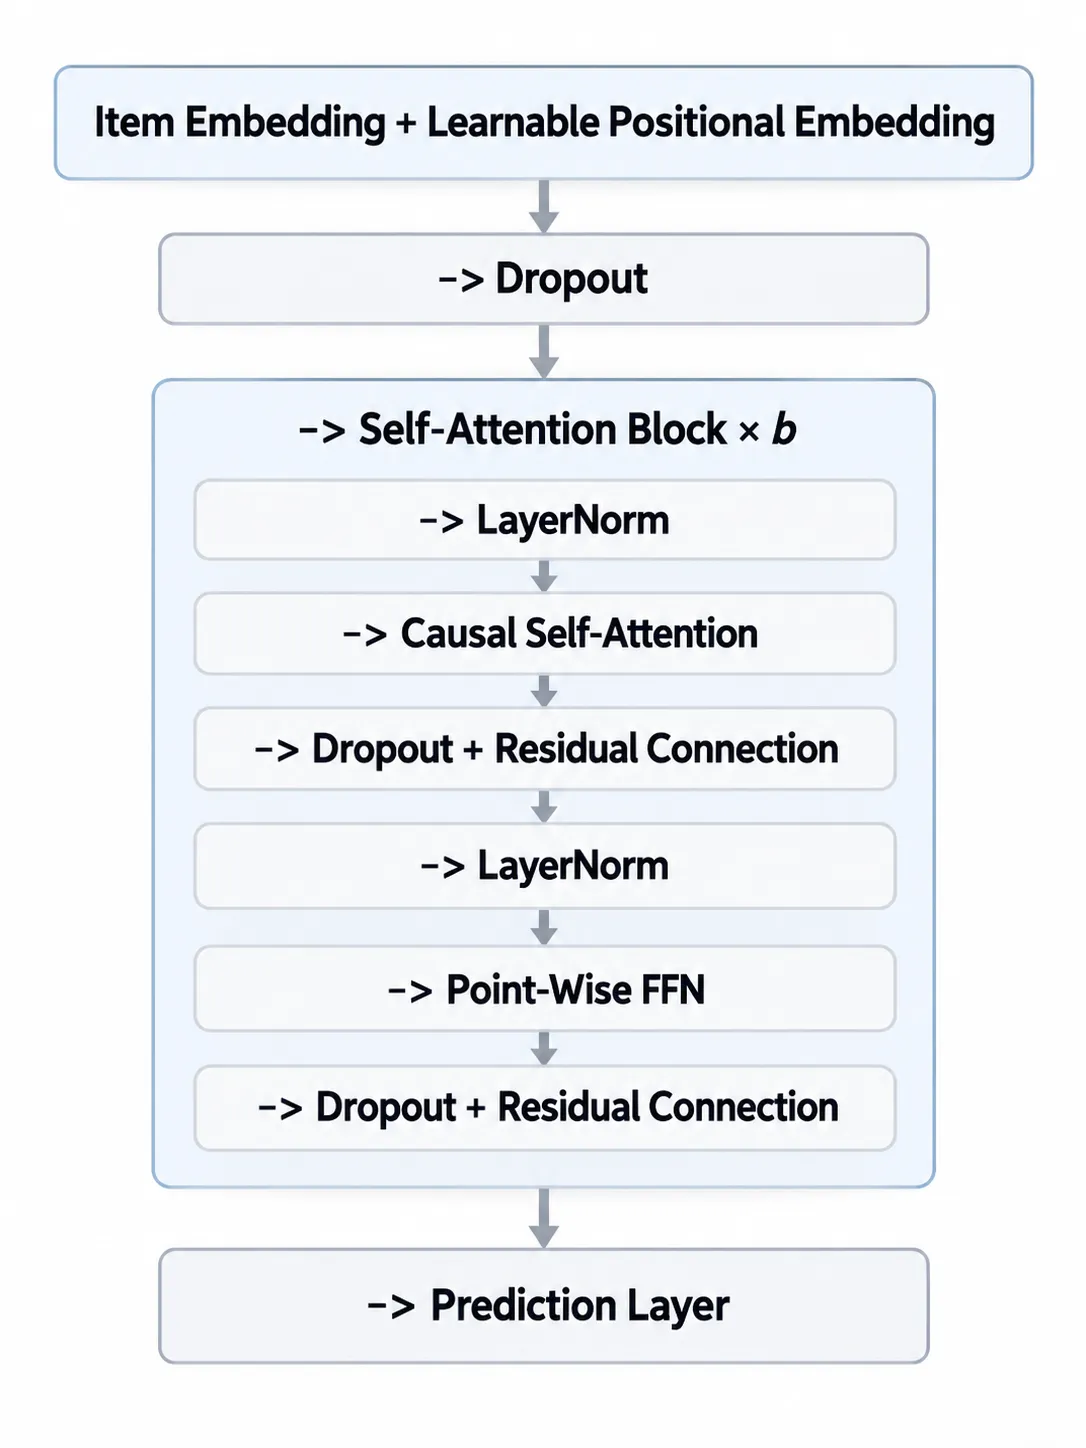
입력 시퀀스가 max length보다 길면 가장 최근 interaction만 남기고, 짧으면 왼쪽에 padding을 추가합니다. 논문 상 기본 설정에서 maximum length 는 Beauty, Games, Steam에서 50, ML-1M에서 200입니다.
각 item은 learnable item embedding으로 변환되고 learnable positional embedding이 더해집니다. Self-Attention 자체에는 순서 정보가 없기 때문에 positional embedding을 통해 시퀀스 위치를 제공합니다.
Self-Attention
SASRec는 Scaled dot-product attention 을 사용합니다.
Item representation으로부터 Query, Key, Value를 각각 linear projection 하여 Self-Attention을 계산합니다.
어텐션으로 다음 item을 예측할 때 미래 interaction이 보이면 안되기 때문에, SASRec는 현재 position보다 미래 시점에 있는 key와의 연결을 막는 causal masking을 사용합니다.
Point-Wise FFN
Attention은 이전 item representation의 weighted sum을 만듭니다. 여기에 nonlinear transformation을 추가하기 위해 각 position에 같은 two-layer FFN을 적용합니다.
여기서 FFN은 position 사이의 정보를 섞는 역할을 하지 않습니다. Position 사이의 상호작용은 어텐션을 통해 처리하고, FFN은 각 position의 latent dimension을 변환합니다.
Residual Connection, LayerNorm, Dropout
각 Self-Attention 또는 FFN 레이어에는 LN, Dropout, Residual Connection이 들어갑니다. 정규화는 Pre-Norm으로 LayerNorm을 sublayer보다 먼저 적용합니다.
임베딩에도 드롭아웃을 적용합니다. 기본 모델은 Self-Attention 블록을 2개 사용합니다.
Prediction Layer
마지막 블록의 representation과 candidate item embedding의 inner product로 relevance score를 계산합니다.
논문상에서는 input embedding과 prediction layer의 item embedding을 공유합니다. 이를 통해 모델의 parameter 수를 줄이고 overfitting을 완화할 수 있습니다. 또한 SASRec은 중간의 비선형 변환을 통해 동일한 item embedding을 사용하더라도 비대칭적인 item transition을 만들 수 있습니다. 실제 ablation에서는 두 embedding을 분리했을 때 4가지 데이터셋 모두에서 성능이 크게 감소했습니다. 논문에서는 이를
두 embedding을 분리하면 학습해야 할 파라미터 수가 증가해 과적합이 발생하기 쉬워집니다. 반면 embedding을 공유하면 파라미터 수를 줄이는 동시에 일종의 regularization 효과를 얻을 수 있습니다. SASRec은 중간의 비선형 변환을 통해 shared embedding만으로도 비대칭적인 item transition을 표현할 수 있기 때문에, embedding을 분리함으로써 얻는 이점이 크지 않습니다.
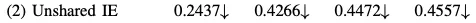
논문상에서 Explicit user embedding은 사용하지 않습니다. 사용자의 interaction history로부터 만들어진 sequence representation을 user preference로 사용합니다. 저자들은 별도의 user embedding을 추가해도 성능이 개선되지 않았다고 후술했습니다.
Objective
각 time step에서 실제 next item은 positive sample이 되고, 사용자가 interaction 하지 않은 item 중 하나를 무작위로 negative sample로 사용합니다. 학습에는 Binary cross entropy(BCE)를 목적함수를 사용하여 positive item의 score는 높이고 negative item의 score는 낮추도록 학습합니다. 한 positive와 sampled negative에 대한 형태는 다음처럼 볼 수 있습니다.
논문 구현에서는 epoch마다 각 sequence의 각 time step에 대해 negative item 하나를 무작위로 생성합니다. Padding position은 loss에서 제외됩니다.
Complexity
논문에서 제시한 parameter complexity는 다음과 같습니다.
Self-Attention과 FFN의 시간 복잡도는 다음과 같습니다.
시퀀스 길이에 대해 quadratic한 시간복잡도가 발생합니다. 논문 상에서 매우 긴 시퀀스에서는 scalability 문제가 생길 수 있다고 명시하고 있습니다.
6. Experimental Setup
Datasets
전처리 이후 데이터 통계는 다음과 같습니다. Review 또는 Rating의 존재를 implicit feedback으로 취급하고, timestamp로 시퀀스 순서를 결정합니다. 논문상에서는 User와 item 모두 interaction이 5개 미만이면 제거하였습니다.
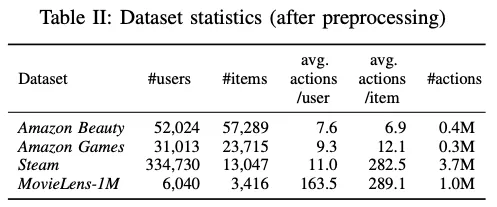
Beauty와 Games가 가장 sparse하고 MovieLens-1M이 가장 dense한 것을 확인할 수 있습니다.
각 사용자의 가장 최근 interaction을 test, 두번째로 최근 interaction을 validation, 나머지를 training에 사용합니다. 테스트시에는 training interaction과 validation interaction까지 history에 포함합니다.
Baseline
비교 모델은 세 그룹으로 구성됩니다.
- General recommendation: PopRec, BPR
- First-order MC: FMC, FPMC, TransRec
- Deep Sequential recommendation: GRU4Rec, GRU4Rec+, Caser
이 논문상에서 BPR, FMC, FPMC, TransRec는 논문 저자들이 텐서플로우와 Adam으로 구현했고, GRU4Rec, GRU4Rec+, Caser는 각 논문들의 저자가 공개한 코드를 사용하였습니다. Latent dimension은 10, 20, 30, 40, 50을 각각 검토하고, validation 성능이 20 epoch동안 개선되지 않으면 학습을 중단했습니다.
Evaluation Protocol
평가 지표는 Hit@10과 NDCG@10입니다. Hit@10은 ground-truth next item이 top 10에 포함되는지를 보고, NDCG@10은 같은 top 10 내에서도 ground-truth item이 높은 순위에 위치할수록 높은 점수를 부여합니다. 사용자마다 test item이 하나이므로, 이 구성에서 Hit@10은 Recall@10과 같습니다.
평가는 full ranking 방식이 아닙니다. 각 user마다 interaction하지 않은 item 중 100개를 random negative로 sampling하고, ground-truth item 1개를 추가한 총 101개의 candidate item을 ranking합니다. 이후 이 ranking을 기준으로 Hit@10과 NDCG@10을 계산합니다.
100 negative + 1 GT = 101 candidates
Implementation Details
기본 SASRec의 주요 설정은 다음과 같습니다.
- Self-Attention Blocks: 2
- Attention heads: 1
- Positional Embedding: learned
- Item embedding: shared(input, prediction)
- Optimizer: Adam
- Learning rate: 0.001
- Batch size: 128
- Dropout: ML-1M 0.2, others 0.5
- Maximum sequence length: ML-1M 200, others 50
원 저자의 코드는 TF 1.12와 Python 2 환경을 기준으로 작성되었습니다.
7. Main Results
Table III에서 SASRec는 4개 데이터셋의 Hit@10과 NDCG@10 총 8개 조건 모두에서 가장 높은 값을 기록했습니다.
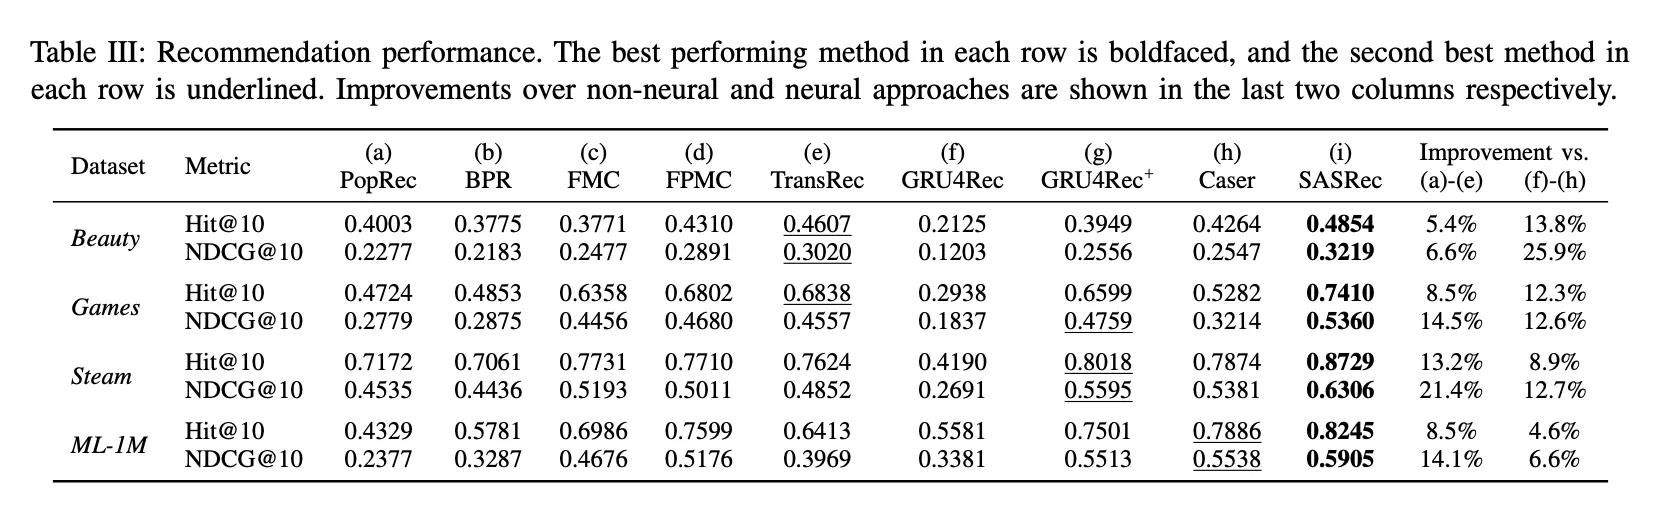
가장 강한 baseline 대비 평균적인 상대 개선폭은 Hit Rate = 6.9%, NDCG = 9.6% 입니다.
표에서 sparse 한 Beauty 데이터셋에서는 뉴럴 모델인 GRU4Rec와 Caser보다 TransRec 같은 non-neural 시계열 방법이 더 강했습니다. Dense한 ML-1M 데이터셋에서는 Caser와 GRU4Rec+가 강해집니다.
SASRec는 sparse, dense 두 환경 모두에서 가장 높은 결과를 기록했다는 부분이 논문 핵심 결과라고 볼 수 있습니다.
8. Analysis
Ablation Study
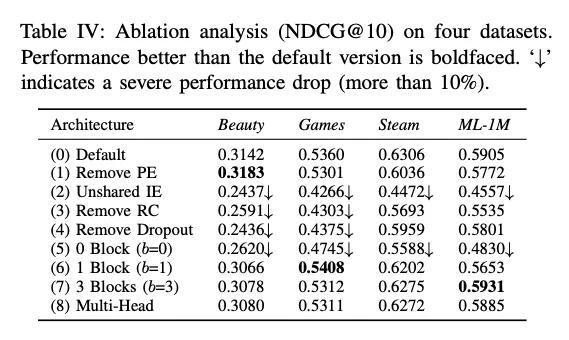
Table IV는 SASRec의 구성 요소가 실제 성능에 얼마나 영향을 주는지를 비교하고 있습니다.
Positional Embedding을 제거하면(1) 가장 sparse한 Beauty에서는 NDCG가 0.3142에서 0.3183으로 오히려 소폭 증가하지만 Games, Steam, ML-1M에서는 감소하는것을 볼 수 있습니다. Sequence가 짧고 sparse한 경우 position 정보의 이점이 크지 않을 수 있다는 저자들의 해석이 데이터에서 드러나는 부분이라고 볼 수 있습니다.
input과 output embedding 을 공유하지 않는(2) 경우 모든 데이터셋에서 10%가 넘는 큰 성능 하락이 발생하는 것을 볼 수 있습니다. 또한 Residual Connection(3)과 Dropout(4)를 제거했을때도 sparse한 Beauty와 Games에서 성능 하락이 크게 발생하는 모습을 볼 수 있습니다.
Self-Attention 블록이 0개일 때(5) 4개 데이터셋 모두에서 성능이 크게 감소합니다. 1개 블록에서도 꽤 높은 성능을 내지만 Default(0)인 2개 블록이 dense dataset에서 더 좋고, 3개로 늘린 경우(7)에서는 추가적인 이득이 거의 없는것을 확인할 수 있습니다.
논문상에서는 2-head Multi-Head Attention도 실험했지만 single-head보다 조금 더 낮은 결과가 나왔습니다. 저자들은 이를 recommendation에서 사용하는 latent dimension이 작아 head를 더 작은 subspace로 나누는것이 도움이 되지 않았을 가능성을 제시하고 있습니다.
Latent Dimension
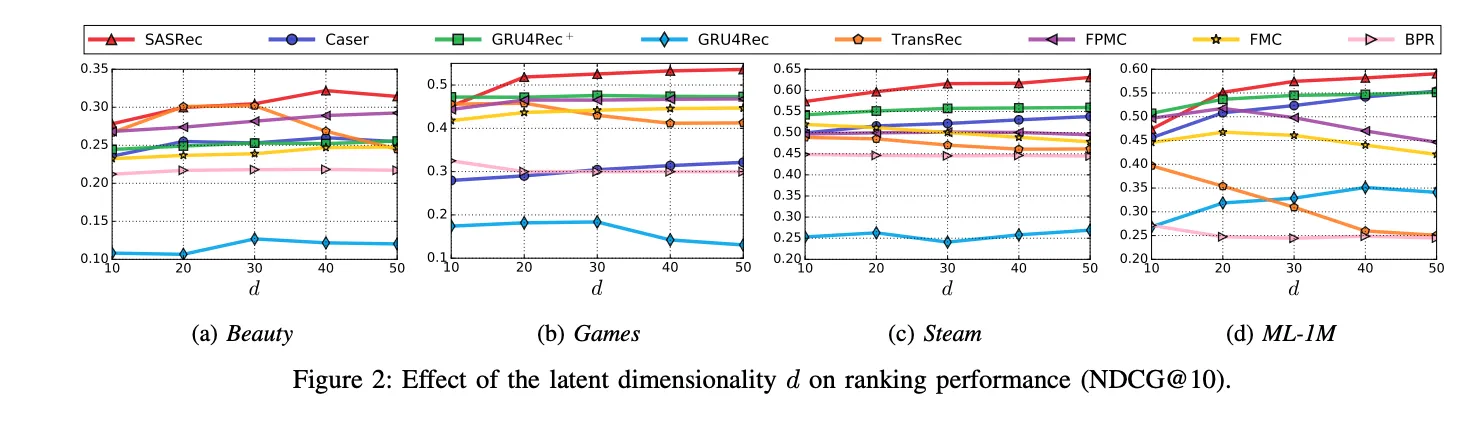
Figure 2 에서 latent dimension을 10부터 50까지 변화시키면서 ranking performance를 4개 데이터셋에서 NDCG@10 으로 측정합니다. SASRec는 대체로 차원이 커질수록 성능이 높아지는 것을 확인할 수 있으며, 실험에 사용한 4개 데이터셋에서 40 이상이면 안정적인 성능을 보입니다.
Training Efficiency
ML-1M과 GTX 1080 Ti 한장을 사용한 실험에서 SASRec의 model update는 에포크 당 1.7초가 걸렸습니다. 동일하게 최근 200개 interaction을 사용한 Caser는 19.1초, GRU4Rec+는 30.7초입니다.
이 결과는 논문 Abstract의 ‘order of magnitude more efficient’ 라는 표현을 구체적으로 뒷받침합니다. 그러나 이 수치는 해당 구현, GPU, 시퀀스 길이, 비교 조건에서 측정된 wall-clock training time(실제 경과 학습 시간)입니다. FLOPs나 추론 레이턴시가 10배 개선되었다는 뜻으로는 해석할 수 없습니다.
Scalability
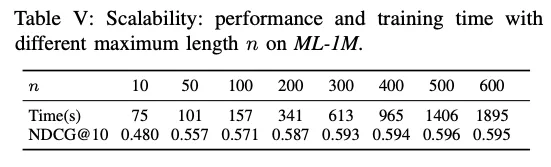
ML-1M에서 maximum sequence 길이를 늘릴수록 NDCG@10이 상승하는 것을 볼 수 있습니다. sequence 길이가 10일때 0.480, 200일 때 0.587, 500일 때 0.596이며 600에서는 0.595로 거의 포화됩니다.
Training Time 은 sequence 길이 200에서 341초, 500에서 1,406초, 600에서 1,895초로 증가합니다. 이는 self attention이 병렬화에는 유리하지만 시퀀스 길이에 대한 quadratic cost 는 여전히 유효합니다.
Attention Visualization
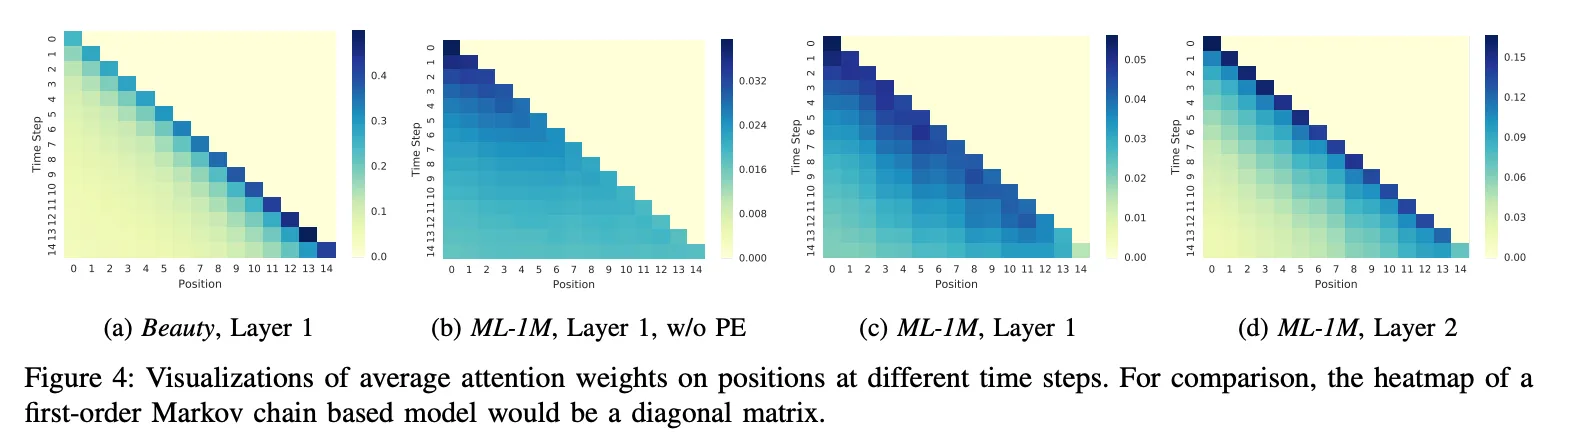
Figure 4에서 Beauty의 첫번째 레이어는 시퀀스 내의 최근 위치에 attention이 강하게 모이는 것을 시각적으로 확인할 수 있습니다. ML-1M에서는 더 먼 position에도 weight가 분산되는것을 확인할 수 있습니다. 저자들이 주장한 sparse data에서는 short-range, dense data에서는 longer-range dependency를 활용한다는 패턴과 일치합니다.
Positional Embedding(PE)을 제거한 ML-1M에서는 attention weight가 과거 위치에 비교적 균일하게 퍼진것을 볼 수 있습니다. PE를 사용하면 최근 위치를 포함한 위치별 차이가 뚜렷하게 나타납니다. 두번째 어텐션 블록(Layer 2)은 첫번째 어텐션 블록(Layer 1)보다 최근 위치에 더 집중하는 경향도 확인할 수 있습니다.
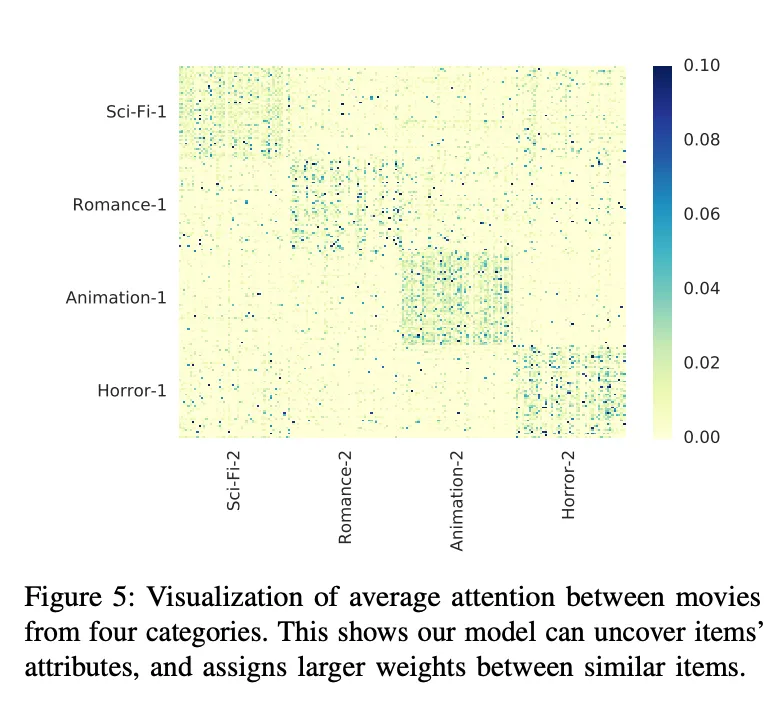
Figure 5에서는 MovieLens-1M의 Sci-Fi, Romance, Animation, Horror 4가지 카테고라에서 각각 200개 영화씩 두 집합을 만들고 카테고리 간 평균 어텐션을 비교합니다. 히트맵이 블록 대각선에 가까운 형태를 보이는데, 이는 같은 카테고리의 영화 사이에서 어텐션이 더 높았다는것을 의미합니다. 카테고리 라벨 자체를 모델에 입력하지 않았다는 점에서 item embedding과 attention이 item들 사이의 관계를 잡아냈다는 증거로 볼 수 있습니다.
9. Critical Analysis
Claims vs. Evidence
<MC와 RNN의 장점을 절충한다> 는 주장은 비교적 잘 검증되어 있습니다. sparse한 Amazon dadaset과 dense한 ML-1M을 함께 사용했고, non-neural MC 계열과 CNN/RNN 계열을 모두 비교했으며 SASRec가 모든 조건에서 가장 높은 결과를 기록했습니다.
<데이터 density에 따라 attention 범위를 적응적(adaptive)으로 바꾼다> 는 주장은 Figure 4 가 뒷받침합니다. Beauty에서는 최근 position, ML-1M에서 더 먼 position을 보는 차이가 관찰됩니다. 다만 attention visualization은 정성적 분석이며, 이 attention 패턴 자체가 성능 향상의 원인이라는 것까지 직접 검증한 실험은 아닙니다.
<효율적이다> 라는 주장은 강한 편입니다. 동일 GPU에서 epoch time과 convergence time(수렴 시간)을 직접 비교했고 10배가 넘는 차이가 확인됩니다. 반면 memory usage, inference throughput, FLOPs에 대한 실측 비교는 제시하지 않고 있습니다.
<long-range dependency를 잘 다룬다> 는 주장에는 구조적인 근거와 attention visualization이 있습니다. 그러나 dependency 길이를 통제한 합성 데이터 실험과 특정 장거리 interaction을 제거하는 간섭 설계는 보이지 않습니다. 장거리 정보가 실제 prediction에 얼마나 필요한지를 직접 분리해서 측정한 것은 아닌것으로 보입니다.
Strengths
논문의 문제 설정과 실험 구조가 잘 맞는 편이라고 생각합니다. RQ1부터 RQ4까지 recommendation performance, component ablation, efficiency와 scalability, attention behavior를 각각 분리해서 검증합니다.
ablation도 핵심 구성요소를 넓게 다루고 있습니다. positional embedding, shared item embedding, residual connection, dropout, block 수, multi-head attention을 각각 비교하여 어떤 설계가 필요한지 확인합니다. table 4
self-attention을 사용했다는 아이디어 외에도 shared item embedding, causal masking, positional embedding, no explicit user embedding, sampled BCE objective까지 설정한 문제와 next-item recommendation에 맞게 하나의 구조로 구성하였습니다.
또한 성능 자체만 측정하고 끝낸것이 아닌, training time과 sequence length scalability, attention 패턴을 분석한 점도 강점이라고 생각합니다.
Originality & Significance
Self-attention 자체는 트랜스포머(attention is all you need)에서 제안된 기술입니다. SASRec의 기여는 Self-Attetnion을 Sequential Recommendation의 메인 모델로 가져와 MC, RNN, CNN 기반 접근법과 다른 방식으로 user history를 모델링 한 데 있다고 생각합니다.
Limitations
저자들이 직접 언급한 제일 명확한 한계는 very long sequence 입니다. self-attention의 quadratic cost 때문에 클릭 로그처럼 매우 긴 시퀀스까지 그대로 확장하기는 어렵고, restricted attention이나 sequence segmentation을 향후 방향으로 제시하고 있습니다. context information인 dwell time(체류 시간), action type, location, device 등을 사용하지 않는 점도 향후 과제로 남깁니다.
평가 방식에서도 주의할 부분이 있습니다. test에서 전체 item 카탈로그를 ranking하지 않고 100개의 random negative와 GT item 하나만 사용합니다. 추가적으로 찾아본 결과, 이후 연구에서는 이런 sampled metric이 full-ranking metric의 상대적인 model ordering을 보존하지 않을 수 있다는 문제가 지적되었습니다. 따라서 table 3 의 수치는 같은 sampled protocol 안에서 비교하는 것이 적절하다고 생각합니다.
4가지 데이터셋 모두 implicit feedback 기반 오프라인 벤치마크(실제 유저 반응X) 입니다. 실제 추천시스템에서 필요한 exposure bias, online feedback loop, diversity, novelty, calibration같은 문제는 실험 범위 밖에 있습니다.
attention weight의 해석에도 한계가 존재합니다. 같은 category item 사이에서 weight가 높고 먼 positon에도 어텐션을 준다는것은 좋은 관찰이지만, 그 어텐션 weight만으로 해당 interaction이 추론의 원인이라고 확정할 수는 없습니다.
또한 여러 random seed에서의 분산도 table 3 에서는 나오지 않습니다. 결과는 단일 메트릭 값 중식으로 제시됩니다.
Reproducibility
논문에서는 preprocessing, user level lean-one-out split, negative sampling, optim, lr, batch size, dropout, maximum sequence length를 구체적으로 제공합니다. 텐서플로우로 만들어진 공식 구현 코드도 공개되어 있습니다.
10. Takeaways
SASRec의 핵심은 <얼마나 많은 과거 행동을 볼 것인가> 를 고정된 Markov order나 RNN hidden state에 맡기지 않고 Self-Attention을 통해 각 예측마다 필요한 history에 서로 다른 weight를 주도록 만든 것입니다. Sparse dataset에서는 최근 interaction이 중요하고, dense dataset에서는 더 긴 history까지 활용하는 패턴이 실제 attention visualization에서 나타나는 것을 확인할 수 있습니다. 성능, ablation, training efficiency까지 함께 보면 Self-Attention을 Sequential Recommendation의 주된 sequence modeling mechanism으로 사용할 수 있다는 것이 이 논문의 가장 큰 결과로 해석 할 수 있습니다.
Method 에서 개인적으로 기억하고 싶은 부분은 causal Self-Attention, learnable positional embedding, point-wise FFN, pre-norm 형태의 residual block, shared item embedding, BCE(이진 교차 엔트로피)와 negative sampling 입니다.