딥러닝 / 교재정리
교재정리
- Transformer Self-Attention을 기반으로 한 Transformer 구조, Encoder, Decoder, Masked Self-Attention과 Cross-Attention 정리 한빛미디어의 를 요약 정리한 글이다. Transformer는 Attention is All You Need(2017)에서 제안된 구조이다. #밑바닥부터-시작하는-딥러닝-2
- Self-Attention 일반 Attention에서 Self-Attention으로 넘어가는 관점 전환과 Q, K, V의 역할을 정리한다. 한빛미디어의 를 요약 정리한 글이다. 일반 Attention은 다음 구조를 가진다. 기준: 현재 시점의 hidden state 참조: 전체 hidden states #밑바닥부터-시작하는-딥러닝-2
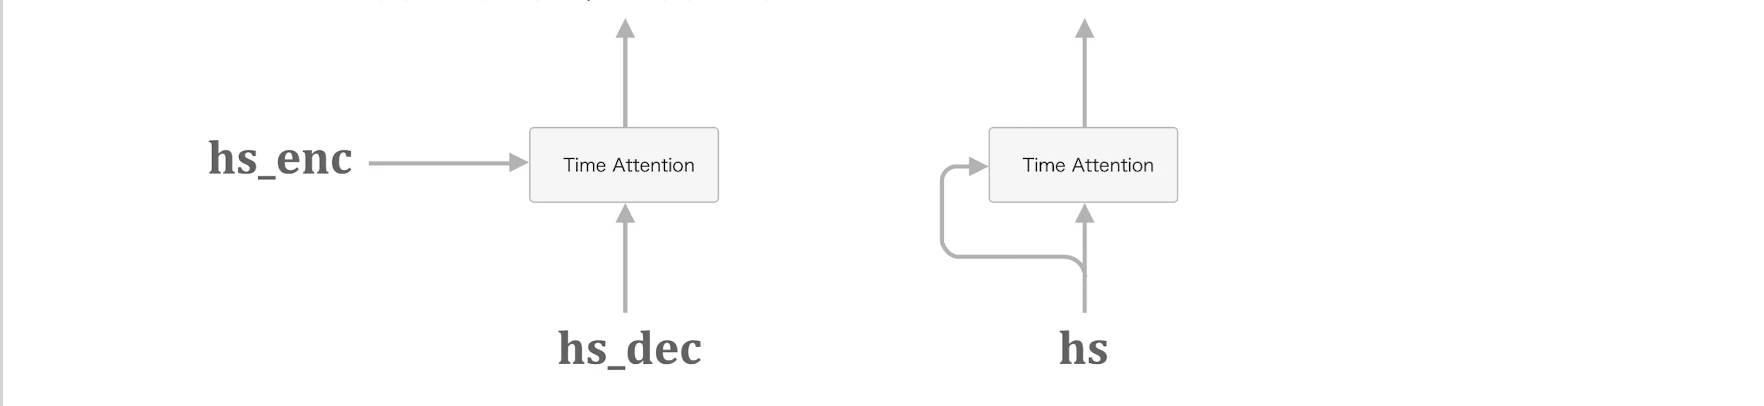
- Attention 직관 Decoder의 잠정 상태, attention score, attention weight, context vector 흐름 직관 한빛미디어의 를 요약 정리한 글이다. Attention은 Decoder가 현재 시점의 출력을 만들 때, Encoder의 전체 hidden states 중 어떤 정보를 얼마나 참고할지 학습하는 구조이다. #밑바닥부터-시작하는-딥러닝-2
- Attention seq2seq의 고정 길이 벡터 한계를 보완하는 Attention 구조와 WeightSum, AttentionWeight, TimeAttention 구현 정리 한빛미디어의 를 요약 정리한 글이다. Transformer의 출발점이 된 논문은 Attention is All You Need(2017)이다. #밑바닥부터-시작하는-딥러닝-2
- RNN 문장 생성 텐서 형상 RNN 문장 생성 과정에서 입력 임베딩, LSTM, 출력층, softmax까지의 텐서 형상을 정리한다. 한빛미디어의 를 요약 정리한 글이다. RNN 또는 LSTM 기반 언어 모델에서 문장을 생성할 때는 단어 ID 하나가 입력으로 들어가고, 모델은 다음 단어의 확률분포를 출력한다. #밑바닥부터-시작하는-딥러닝-2
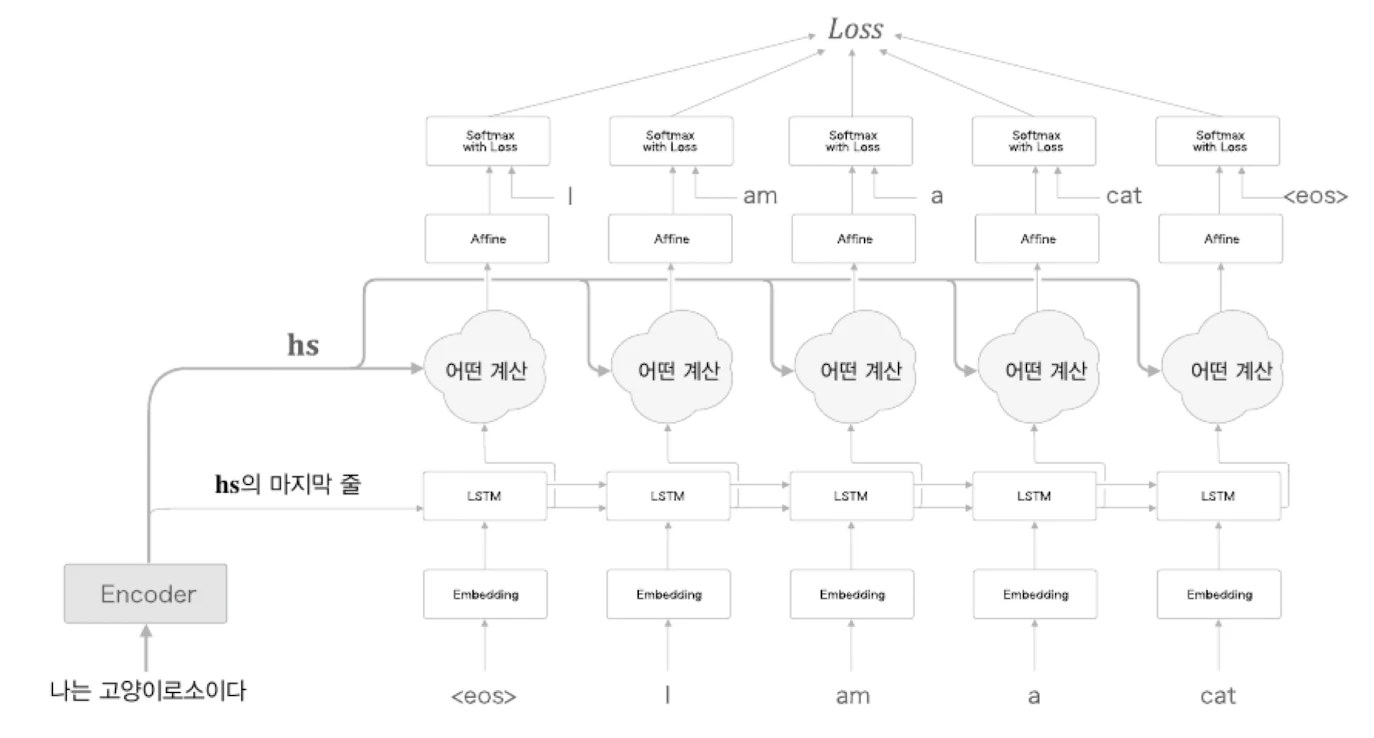
- RNN을 사용한 문장 생성 RNN 언어 모델을 이용한 문장 생성, seq2seq, Encoder-Decoder 구조와 Peeky 개선 한빛미디어의 를 요약 정리한 글이다. 언어 모델은 지금까지 주어진 단어를 바탕으로 다음에 출현할 단어의 확률분포를 출력한다. #밑바닥부터-시작하는-딥러닝-2
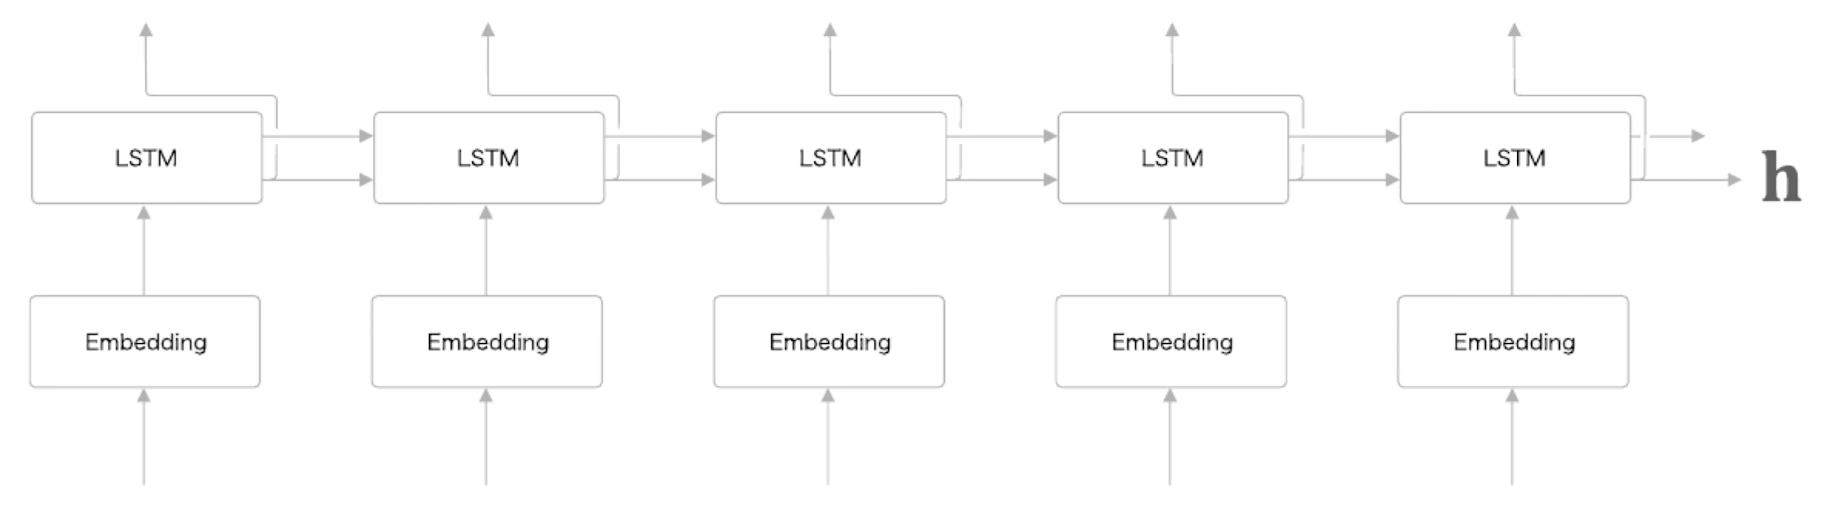
- Gated RNN 기본 RNN의 장기 의존성 문제와 LSTM의 게이트 구조, TimeLSTM 구현, RNNLM 개선 방법 한빛미디어의 를 요약 정리한 글이다. 기본 RNN은 시퀀스 데이터를 순서대로 처리할 수 있지만, 긴 시계열 데이터에서 멀리 떨어진 정보 사이의 의존 관계를 학습하기 어렵다. #밑바닥부터-시작하는-딥러닝-2
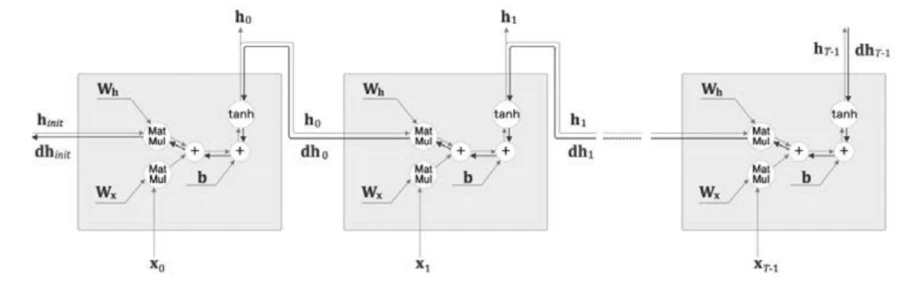
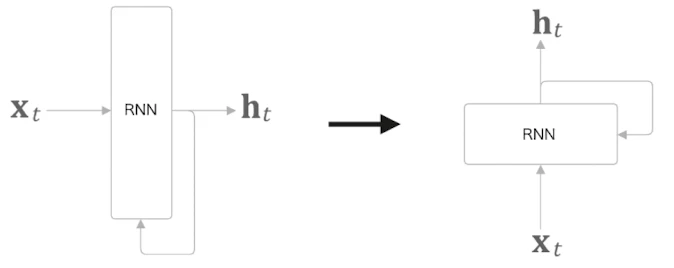
- RNN 순환 신경망의 구조, BPTT와 Truncated BPTT, TimeRNN과 RNN 언어 모델 한빛미디어의 를 요약 정리한 글이다. RNN(Recurrent Neural Network)은 시퀀스 데이터의 시간적 순서를 고려하기 위해 이전 상태 정보를 현재 계산에 반영하는 신경망이다. #밑바닥부터-시작하는-딥러닝-2
- Embedding과 Negative Sampling CBOW에서 Embedding 계층과 Negative Sampling을 사용해 계산량을 줄이는 과정 한빛미디어의 를 요약 정리한 글이다. CBOW 모델을 큰 어휘 집합에 그대로 적용하면 계산량이 매우 커진다. #밑바닥부터-시작하는-딥러닝-2
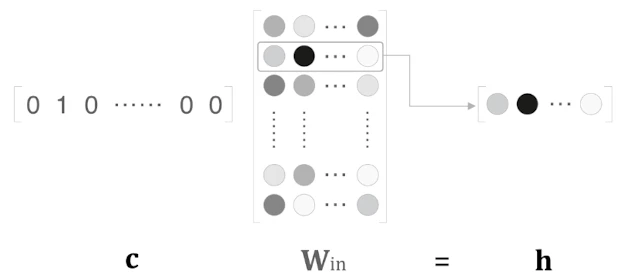
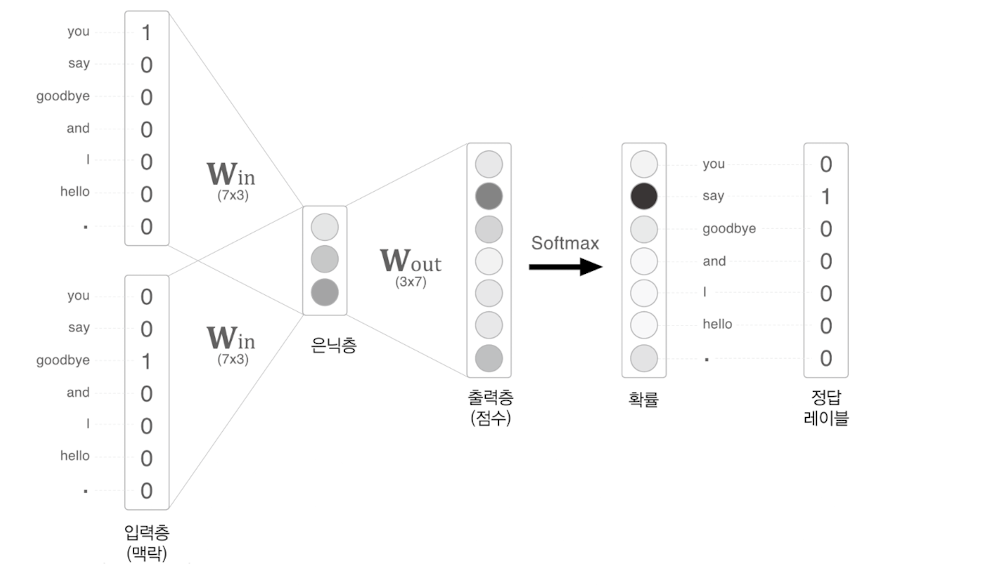
- CBOW CBOW의 구조, 임베딩 벡터와 NLL 손실, skip-gram과의 차이, 통계 기반 기법과 추론 기반 기법의 차이 한빛미디어의 를 요약 정리한 글이다. CBOW(Continuous Bag-of-Words)는 문맥(context) 단어들로부터 중앙(target) 단어를 예측하는 신경망 기반 언어 모델이다. #밑바닥부터-시작하는-딥러닝-2
- PMI, SVD 단어 동시발생 빈도의 고빈도 편향 문제, PMI와 PPMI, PPMI 행렬에 SVD를 적용해 단어 벡터를 만드는 흐름 한빛미디어의 를 요약 정리한 글이다. PMI(Pointwise Mutual Information)는 두 단어가 기대보다 얼마나 자주 함께 등장하는지를 측정하는 지표이다. #밑바닥부터-시작하는-딥러닝-2
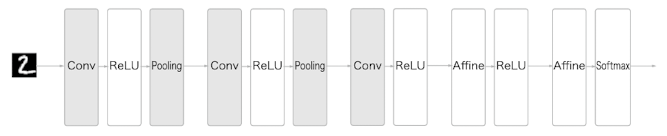
- 합성곱 신경망(CNN) CNN의 기본 구조, 합성곱 연산, 패딩, 스트라이드, 3차원 합성곱, 배치 처리와 풀링 계층 한빛미디어의 을 요약 정리한 글이다. 합성곱 신경망(CNN, Convolutional Neural Network)은 합성곱 계층과 풀링 계층이 추가된 신경망이다. #밑바닥부터-시작하는-딥러닝-1
딥러닝 / 교재정리
교재정리
- Transformer Self-Attention을 기반으로 한 Transformer 구조, Encoder, Decoder, Masked Self-Attention과 Cross-Attention 정리 한빛미디어의 를 요약 정리한 글이다. Transformer는 Attention is All You Need(2017)에서 제안된 구조이다. #밑바닥부터-시작하는-딥러닝-2
- Self-Attention 일반 Attention에서 Self-Attention으로 넘어가는 관점 전환과 Q, K, V의 역할을 정리한다. 한빛미디어의 를 요약 정리한 글이다. 일반 Attention은 다음 구조를 가진다. 기준: 현재 시점의 hidden state 참조: 전체 hidden states #밑바닥부터-시작하는-딥러닝-2
- Attention 직관 Decoder의 잠정 상태, attention score, attention weight, context vector 흐름 직관 한빛미디어의 를 요약 정리한 글이다. Attention은 Decoder가 현재 시점의 출력을 만들 때, Encoder의 전체 hidden states 중 어떤 정보를 얼마나 참고할지 학습하는 구조이다. #밑바닥부터-시작하는-딥러닝-2
- Attention seq2seq의 고정 길이 벡터 한계를 보완하는 Attention 구조와 WeightSum, AttentionWeight, TimeAttention 구현 정리 한빛미디어의 를 요약 정리한 글이다. Transformer의 출발점이 된 논문은 Attention is All You Need(2017)이다. #밑바닥부터-시작하는-딥러닝-2
- RNN 문장 생성 텐서 형상 RNN 문장 생성 과정에서 입력 임베딩, LSTM, 출력층, softmax까지의 텐서 형상을 정리한다. 한빛미디어의 를 요약 정리한 글이다. RNN 또는 LSTM 기반 언어 모델에서 문장을 생성할 때는 단어 ID 하나가 입력으로 들어가고, 모델은 다음 단어의 확률분포를 출력한다. #밑바닥부터-시작하는-딥러닝-2
- RNN을 사용한 문장 생성 RNN 언어 모델을 이용한 문장 생성, seq2seq, Encoder-Decoder 구조와 Peeky 개선 한빛미디어의 를 요약 정리한 글이다. 언어 모델은 지금까지 주어진 단어를 바탕으로 다음에 출현할 단어의 확률분포를 출력한다. #밑바닥부터-시작하는-딥러닝-2
- Gated RNN 기본 RNN의 장기 의존성 문제와 LSTM의 게이트 구조, TimeLSTM 구현, RNNLM 개선 방법 한빛미디어의 를 요약 정리한 글이다. 기본 RNN은 시퀀스 데이터를 순서대로 처리할 수 있지만, 긴 시계열 데이터에서 멀리 떨어진 정보 사이의 의존 관계를 학습하기 어렵다. #밑바닥부터-시작하는-딥러닝-2
- RNN 순환 신경망의 구조, BPTT와 Truncated BPTT, TimeRNN과 RNN 언어 모델 한빛미디어의 를 요약 정리한 글이다. RNN(Recurrent Neural Network)은 시퀀스 데이터의 시간적 순서를 고려하기 위해 이전 상태 정보를 현재 계산에 반영하는 신경망이다. #밑바닥부터-시작하는-딥러닝-2
- Embedding과 Negative Sampling CBOW에서 Embedding 계층과 Negative Sampling을 사용해 계산량을 줄이는 과정 한빛미디어의 를 요약 정리한 글이다. CBOW 모델을 큰 어휘 집합에 그대로 적용하면 계산량이 매우 커진다. #밑바닥부터-시작하는-딥러닝-2
- CBOW CBOW의 구조, 임베딩 벡터와 NLL 손실, skip-gram과의 차이, 통계 기반 기법과 추론 기반 기법의 차이 한빛미디어의 를 요약 정리한 글이다. CBOW(Continuous Bag-of-Words)는 문맥(context) 단어들로부터 중앙(target) 단어를 예측하는 신경망 기반 언어 모델이다. #밑바닥부터-시작하는-딥러닝-2
- PMI, SVD 단어 동시발생 빈도의 고빈도 편향 문제, PMI와 PPMI, PPMI 행렬에 SVD를 적용해 단어 벡터를 만드는 흐름 한빛미디어의 를 요약 정리한 글이다. PMI(Pointwise Mutual Information)는 두 단어가 기대보다 얼마나 자주 함께 등장하는지를 측정하는 지표이다. #밑바닥부터-시작하는-딥러닝-2
- 합성곱 신경망(CNN) CNN의 기본 구조, 합성곱 연산, 패딩, 스트라이드, 3차원 합성곱, 배치 처리와 풀링 계층 한빛미디어의 을 요약 정리한 글이다. 합성곱 신경망(CNN, Convolutional Neural Network)은 합성곱 계층과 풀링 계층이 추가된 신경망이다. #밑바닥부터-시작하는-딥러닝-1