딥러닝 / CS231N / ASSIGNMENT
ASSIGNMENT
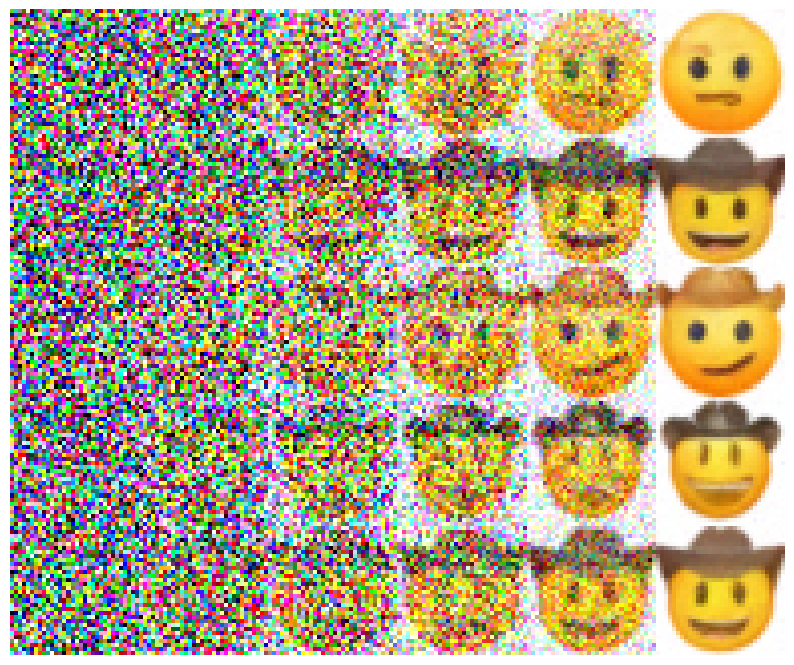
- Assignment 3-3: Denoising Diffusion Probabilistic Models Forward Diffusion, Reverse Diffusion, U-Net 기반 Noise Prediction, Reverse Sampling, Classifier-Free Guidance 구현 및 평가 이번 과제에서는 Denoising Diffusion Probabilistic Model(DDPM)의 핵심 구성요소를 구현하고, noisy image를 점진적으로 denoise하여 이미지를 생성하는 과정을 배운다. DDPM은 데이터 분포에서 바로 샘플을 생성하는 대신, 먼저 실제 이미지에 Gaussian noise를 점진적으로 추가하는 Forward Diffusion을 정의하고, 반대로 노이즈에서 이미지를 복원하는 Reverse Diffusion을 학습한다. Forward process 자체는 고정된 noise schedule에 의해 결정되며, 실제로 학습되는 부분은 각 timestep에서 noisy image를 보고 노이즈 또는 원본 이미지를 예측하는 denoising model이다. 이 denoising model로 U-Net을 사용한다. #ASSIGNMENT
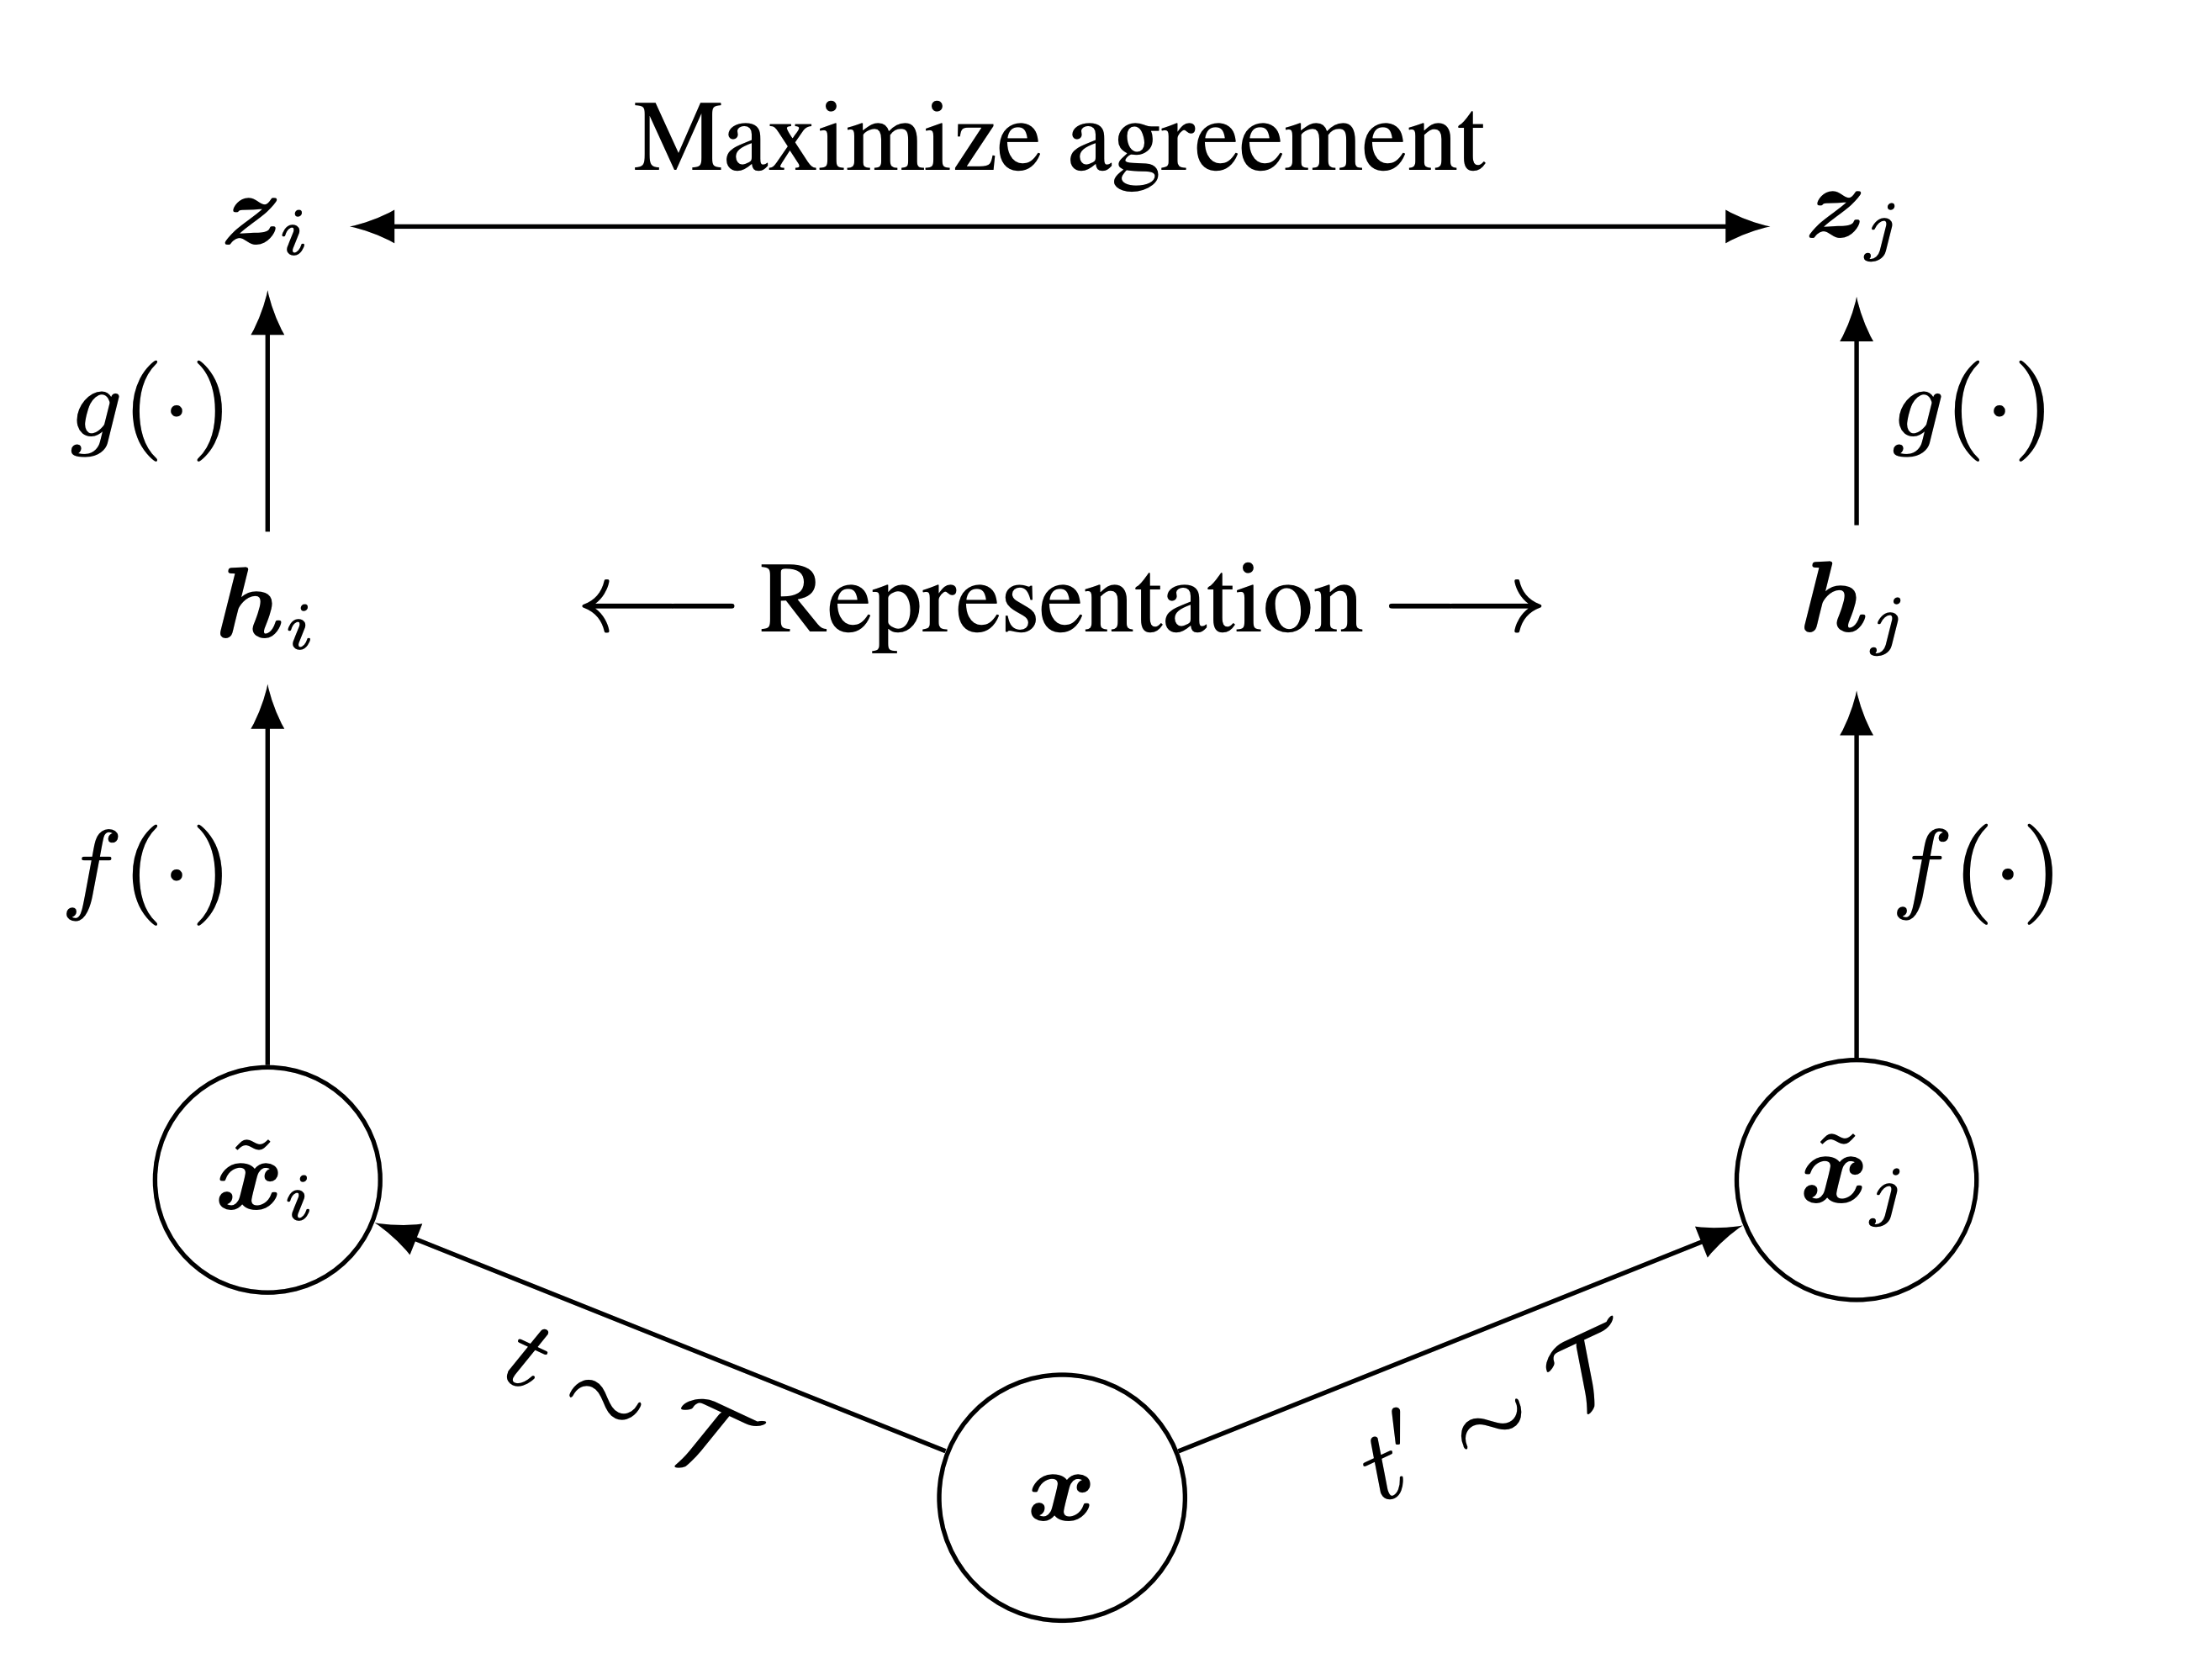
- Assignment 3-2: Self-Supervised Learning for Image Classification SimCLR의 data augmentation, NT-Xent loss 구현과 self-supervised representation의 image classification 평가 이번 과제에서는 label 없이 image representation을 학습하는 self-supervised learning과 SimCLR의 contrastive learning을 구현하고, 학습된 representation이 downstream image classification에 얼마나 유용한지 평가한다. Supervised learning은 이미지와 사람이 붙인 class label의 관계를 학습한다. 반면 self-supervised learning은 data 자체에서 학습 신호를 만든다. SimCLR에서는 같은 이미지에 서로 다른 random augmentation을 적용해 두 view를 만들고, 이 둘을 positive pair로 취급한다. Model은 positive pair의 representation을 가깝게 만들고, batch 안의 다른 이미지에서 나온 view는 멀어지게 학습한다. #ASSIGNMENT
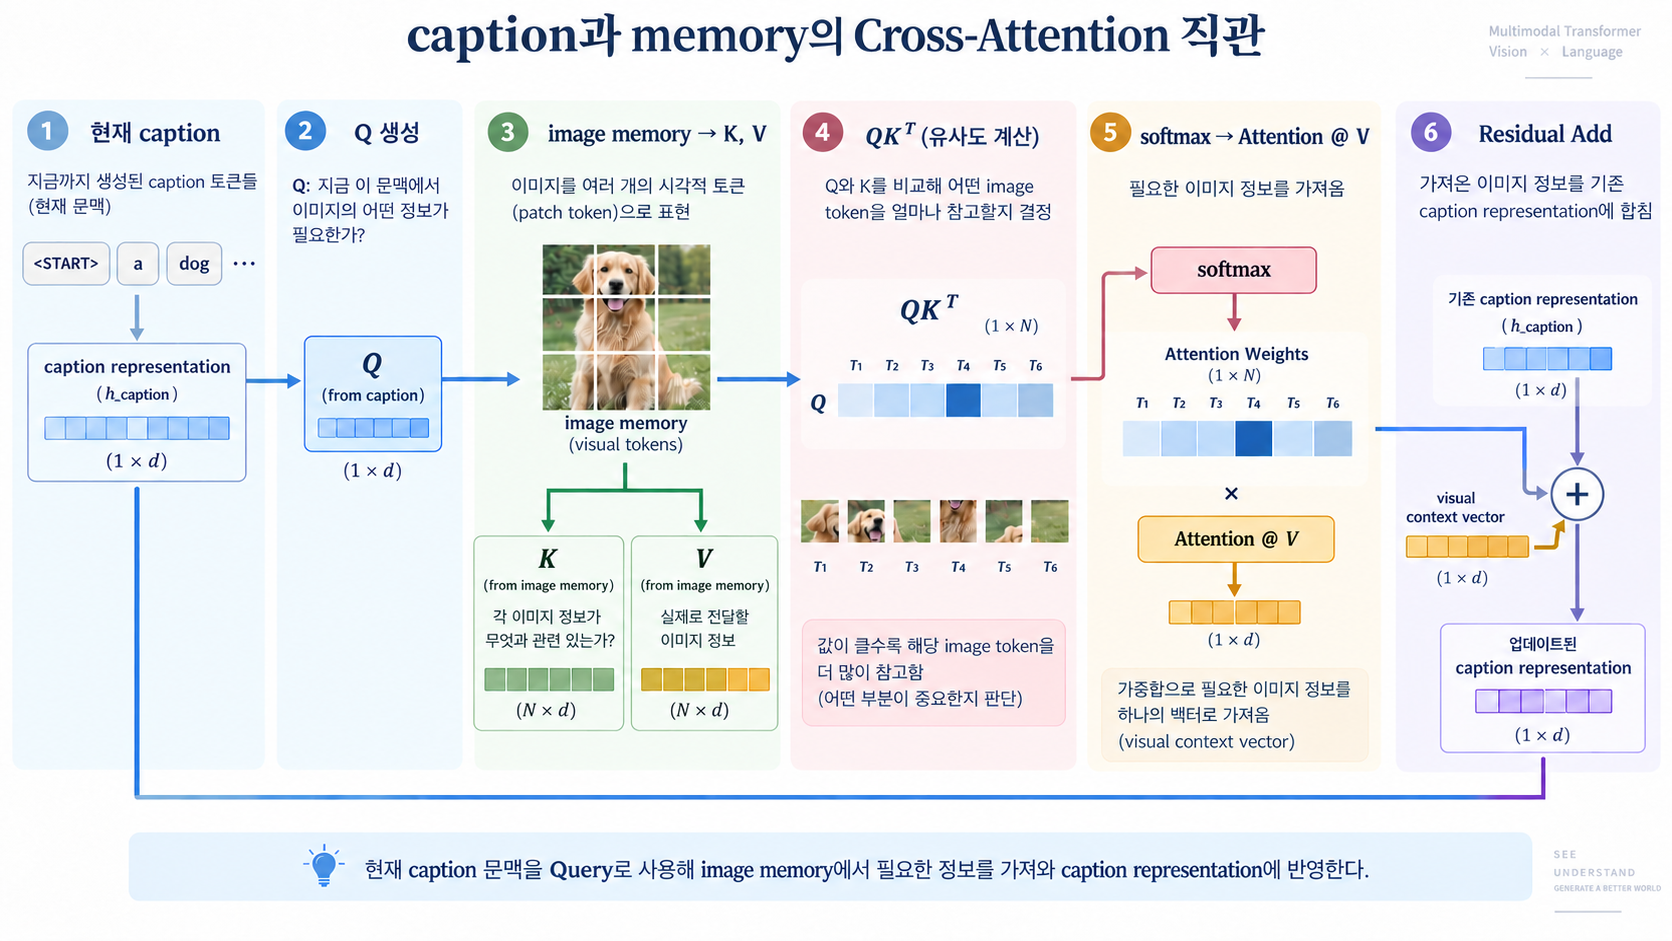
- Assignment 3-1: Image Captioning with Transformers Attention 및 Transformer Block 구현, Image Captioning Transformer 의 Multi-Headed Attention 을 구현하고, Positional Encoding 의 원리와 구현, Transformer Block 을 만들고 COCO Dataset 으로 이미지 캡셔닝과 ViT를 구현한다. Multi-Headed Attention은 embedding을 여러 head로 나누어 각 head가 서로 다른 표현 공간에서 token 사이의 관계를 포착하도록 한다. #ASSIGNMENT
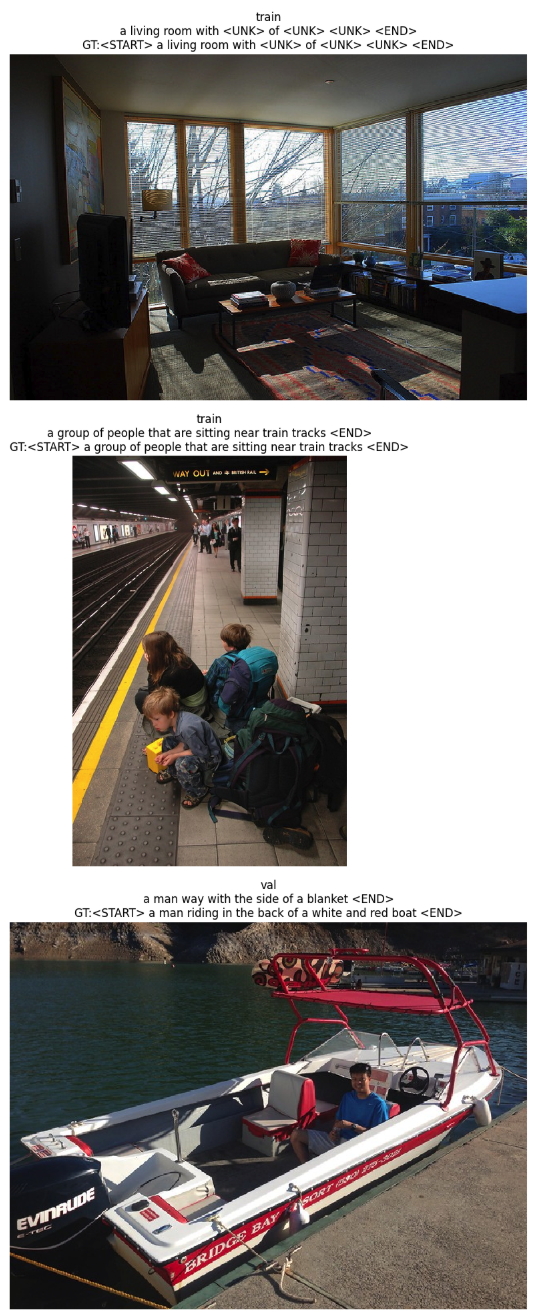
- Assignment 2-5: RNN Captioning COCO image feature와 RNN language model을 연결한 image captioning 구현 미리 추출한 image feature를 초기 hidden state로 투영하고, 한 timestep씩 어긋난 caption을 teacher forcing으로 학습하여 매 시점의 다음 token을 예측하는 RNN image captioning model을 구현한다. 이번 과제는 2014 COCO Dataset의 image-caption pair를 사용한다. Image는 ImageNet으로 사전 학습한 VGG-16의 fc7 feature를 사용하며, 4096차원 feature를 PCA로 줄인 512차원 입력을 model에 넣는다. Caption은 각 word를 integer ID로 바꾼 sequence로 처리한다. #ASSIGNMENT
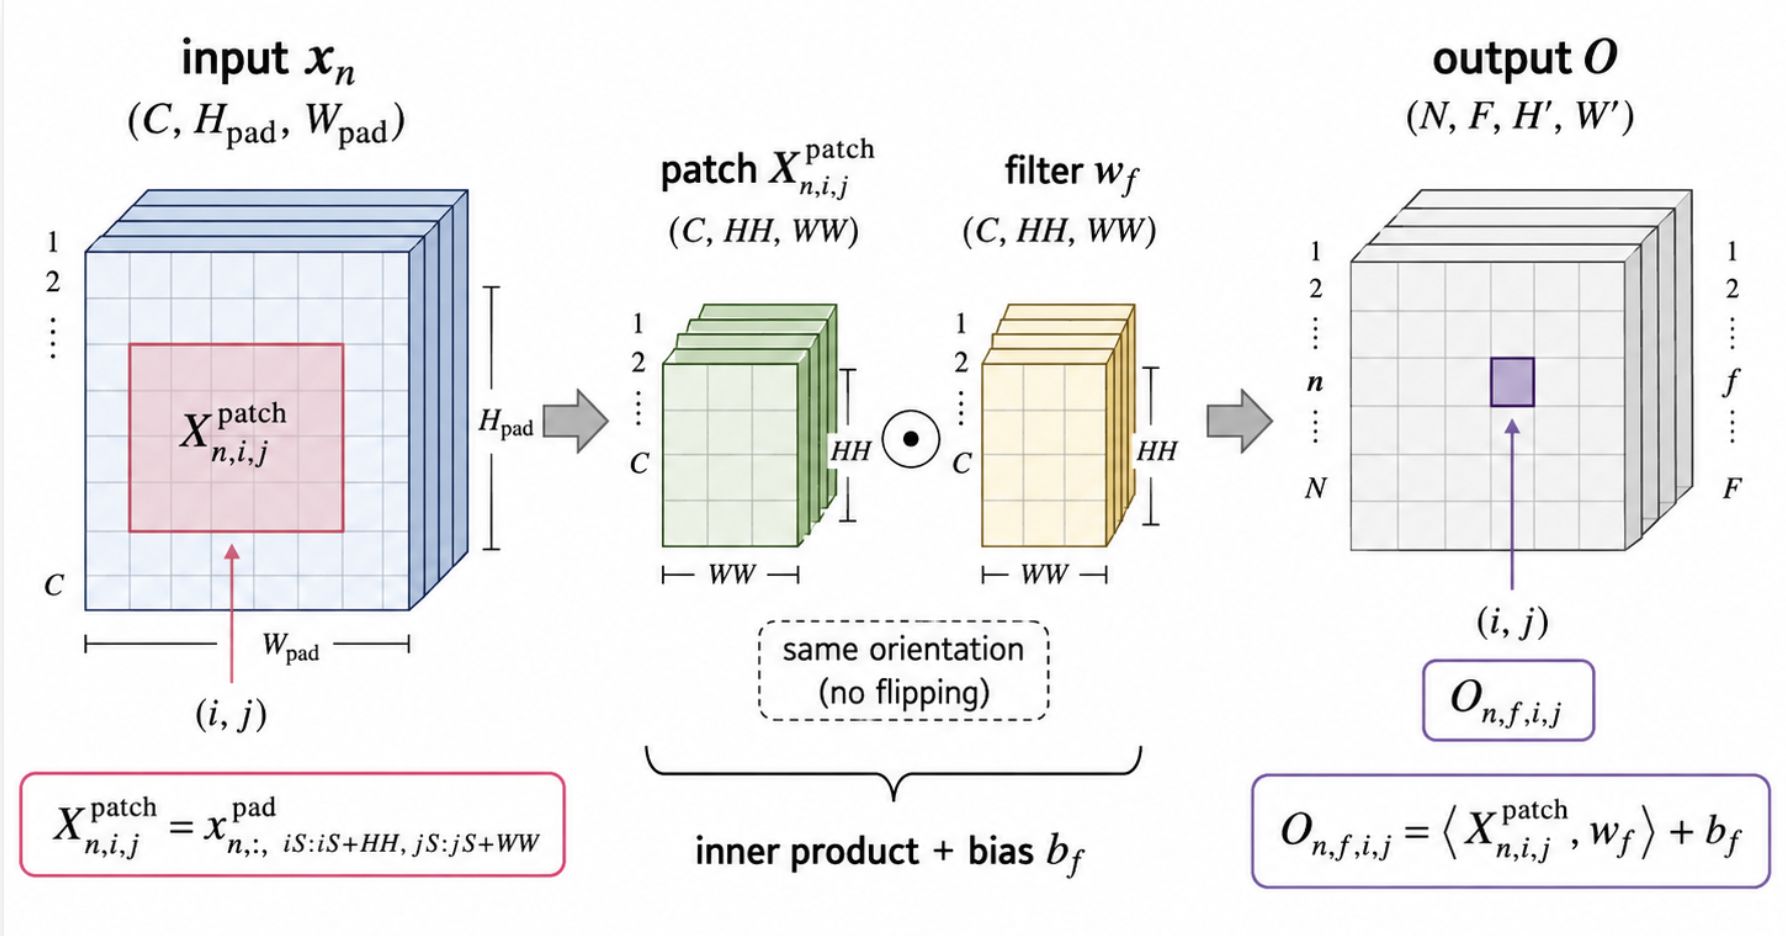
- Assignment 2-3: Convolutional Networks Convolution, Max Pooling, Spatial Batch Normalization, Group Normalization 구현 이번 과제에서는 CNN을 구성하는 convolution과 max pooling layer의 forward, backward를 직접 구현한다. 이어서 CNN의 activation shape인 에 맞춰 Spatial Batch Normalization을 구현하고, 채널을 여러 group으로 나누어 정규화하는 Spatial Group Normalization까지 구현한다. #ASSIGNMENT
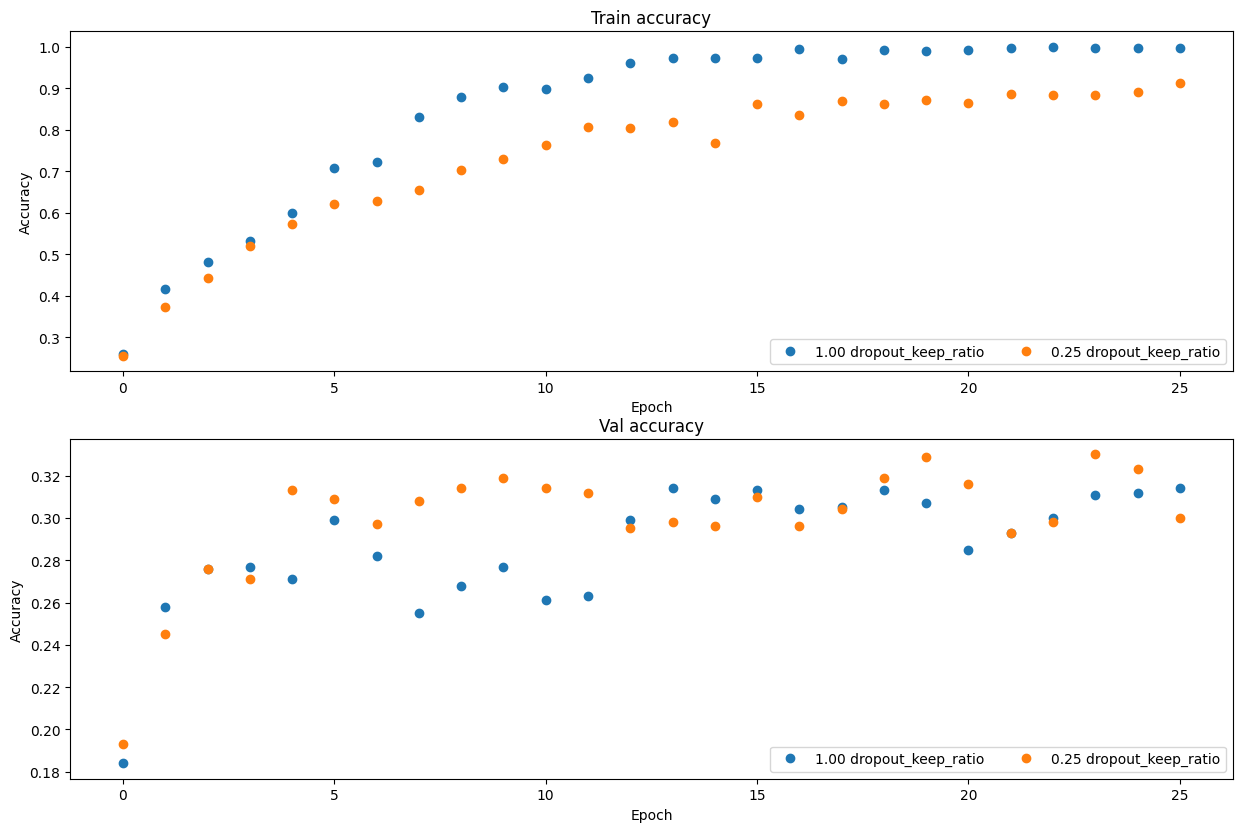
- Assignment 2-2: Dropout Dropout 개념 및 구현 드롭아웃의 개념과 효과, 순전파 및 역전파를 구현한다. 드롭아웃(Dropout)은 훈련 시 drop probability 만큼 뉴런의 출력을 무작위로 0으로 만드는 규제 기법이다. #ASSIGNMENT
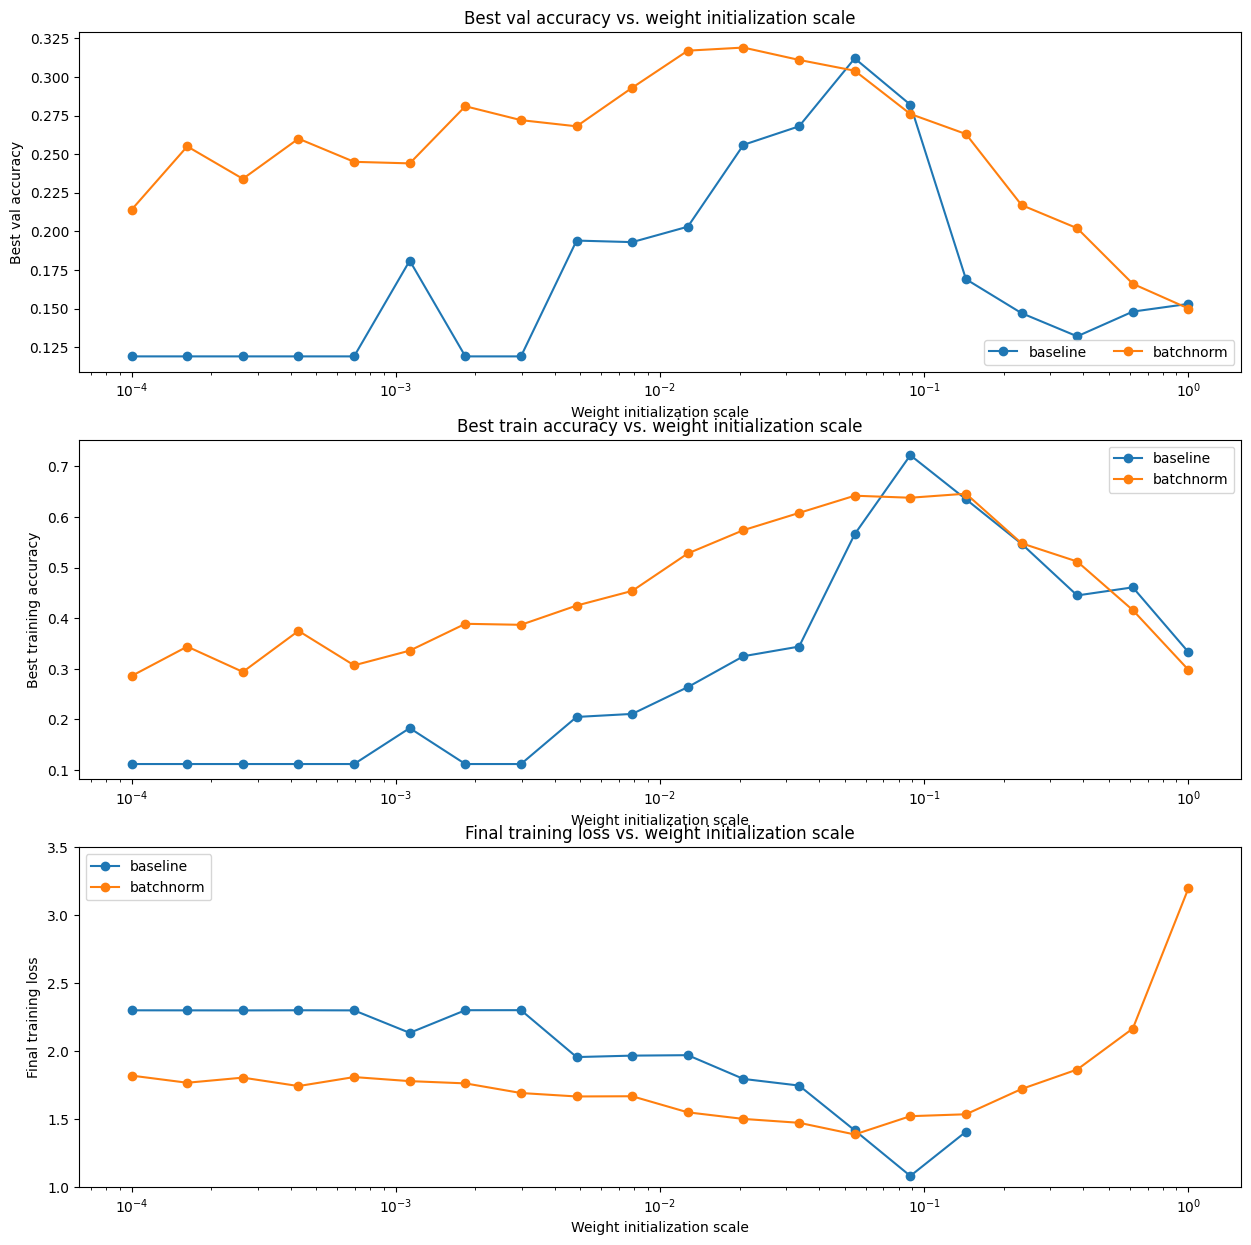
- Assignment 2-1: Batch Normalization Batch Norm, Layer Norm 이번 과제에서는 Batch Normalization 의 개념과 BatchNorm 레이어의 forward, backward 를 구현한다. 또한 Batch Norm과 Weight Initialization 의 관계, Batch Norm과 Batch Size와의 관계를 Baseline 기반으로 비교한다. #ASSIGNMENT
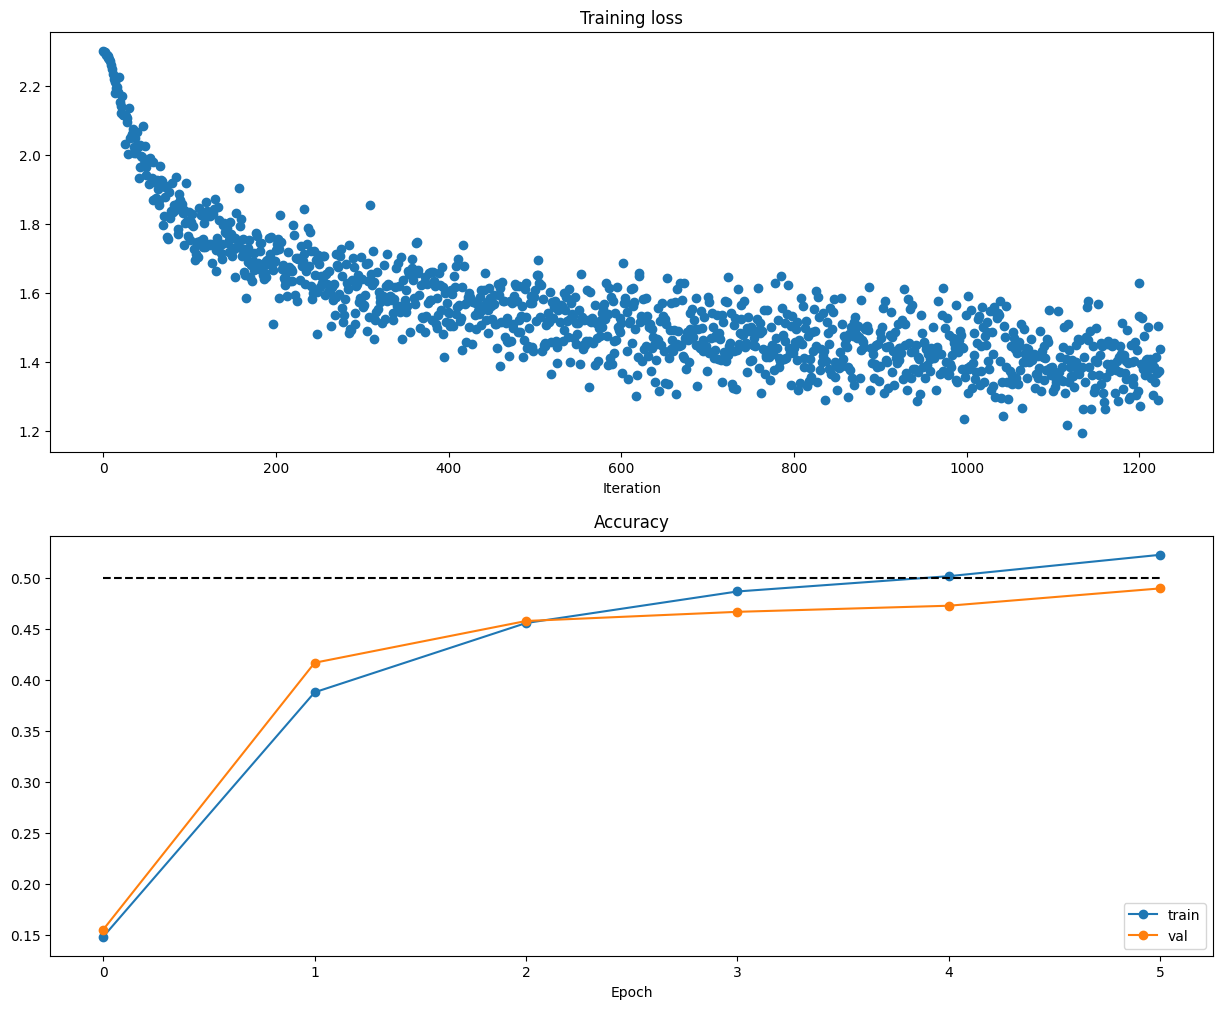
- Assignment 1-5: Training a fully connected network FullyConnectedNet 구현, Momentum, RMSProp, Adam 이번 과제에서는 임의의 개수의 hidden layer를 갖는 FullyConnectedNet을 구현하고, 여러 optimizer를 직접 구현해본다. 앞에서 만든 TwoLayerNet이 하나의 hidden layer만 갖는 구조였다면, 여기서는 hidden layer 개수를 리스트로 받아 더 깊은 fully-connected network를 구성한다. 기본 구조는 다음과 같다. #ASSIGNMENT
- Assignment 1-4: Higher Level Representations: Image Features HOG, HSV feature 추출과 feature 기반 분류기 학습 이번 과제에서는 원본 픽셀을 그대로 사용하는 대신, 이미지에서 hand-crafted feature를 추출한 뒤 분류기를 학습한다. 사용한 feature는 Histogram of Oriented Gradients, HOG와 HSV color histogram이다. 전체 흐름은 다음과 같다. 각 이미지에서 HOG feature를 추출한다. 각 이미지에서 HSV hue channel 기반 color histogram을 추출한다. 두 feature vector를 이어 붙여 하나의 feature vector로 만든다. 추출된 feature 위에서 Softmax linear classifier를 학습한다. 같은 feature 위에서 TwoLayerNet을 학습한다. #ASSIGNMENT
- Assignment 1-3: Two-Layer Neural Network 완전연결계층 구현 Fully-Connected Neural Nets 과제에서는 neural network를 구성하는 기본 layer들을 모듈 단위로 구현한다. 이번 과제에서 직접 구현한 핵심은 affineforward, affinebackward, reluforward, relubackward, softmaxloss, 그리고 이들을 조합한 TwoLayerNet이다. 전체 구조는 다음과 같다. #ASSIGNMENT
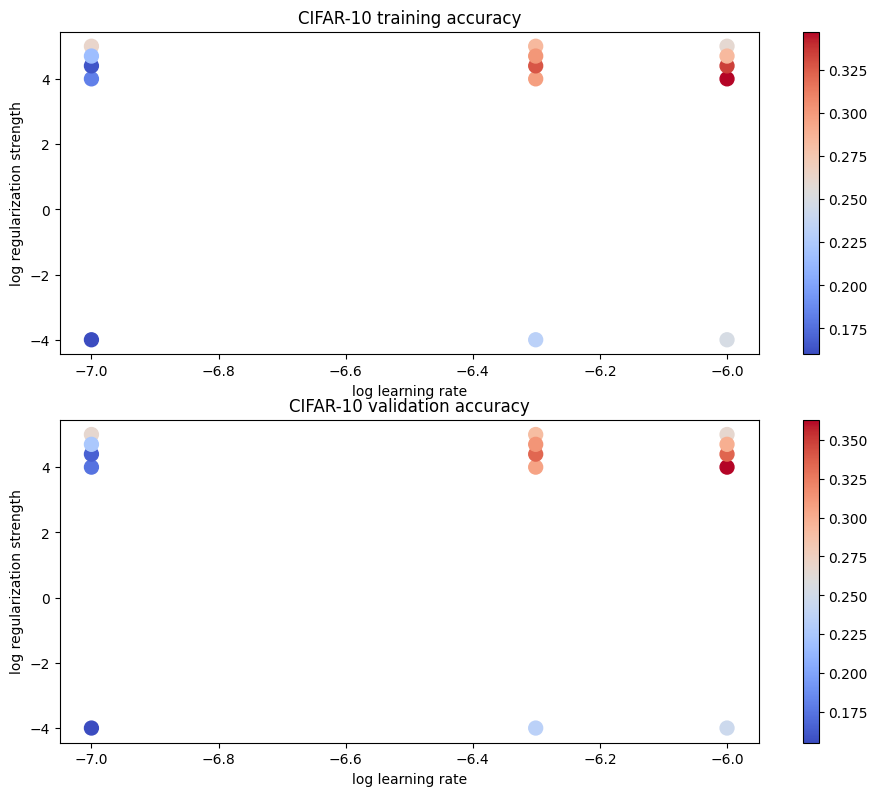
- Assignment 1-2: Implement a Softmax classifier softmaxloss 구현, SGD 구현 softmaxloss 에 대해서 이해하고, svm loss와 softmaxloss의 차이를 확인하고, SGD를 적용해서 훈련을 수행하고, 검증 데이터로 하이퍼파라미터 결정하기 softmaxloss 는 모델이 정답 클래스에 얼마나 높은 확률을 부여했는지를 기준으로 손실을 계산하는 방법이다. score를 softmax로 변환하여 각 클래스의 확률을 계산 정답 클래스의 확률이 1에 가까울수록 loss가 작아짐 SVM loss와 달리 margin을 넘겨도 정답 확률을 더 키우는 방향으로 계속 학습 수식: logit(점수): #ASSIGNMENT
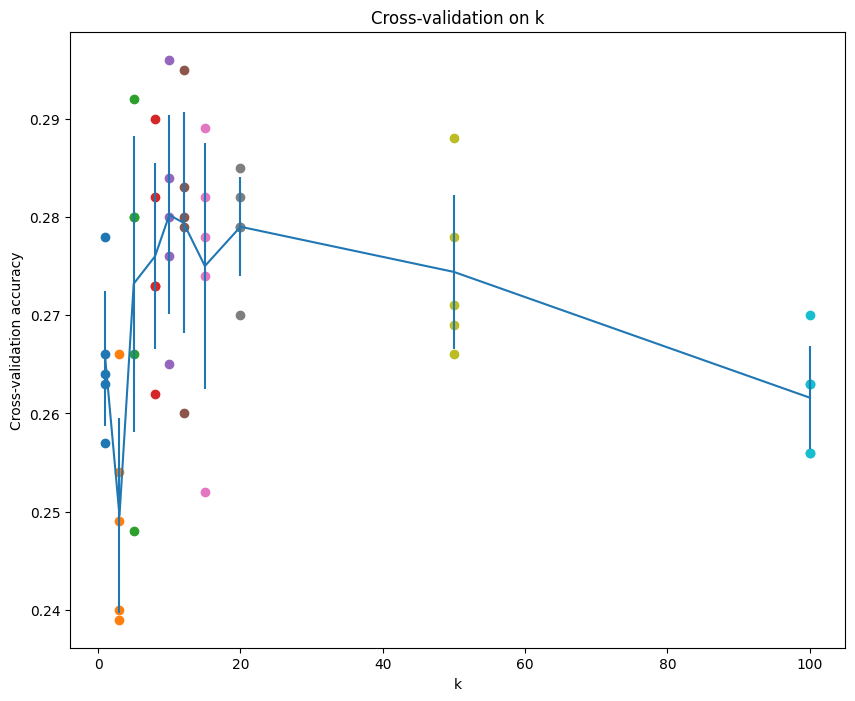
- Assignment 1-1: k-Nearest Neighbor classifier kNN 구현, training, testing, cross-validation L1, L2 distance 에 대해 이해하고, k-Nearest Neighbors(kNN) 분류기를 직접 구현하고, 학습 데이터에 대해 성능을 측정하고, Cross-Validation (k-folds) 를 이용해 최적의 하이퍼파라미터 k를 찾기 k-Nearest Neighbors(kNN)는 테스트 샘플과 훈련 샘플 간의 거리를 계산하여 가장 가까운 k개의 이웃을 찾고, 다수결을 통해 클래스를 예측하는 분류 알고리즘이다. 학습 과정이 거의 없음 (Lazy Learning) 가장 가까운 k개의 데이터로 분류 거리 척도로 주로 Euclidean Distance(L2 distance) 사용 거리 계산: #ASSIGNMENT
딥러닝 / CS231N / ASSIGNMENT
ASSIGNMENT
- Assignment 3-3: Denoising Diffusion Probabilistic Models Forward Diffusion, Reverse Diffusion, U-Net 기반 Noise Prediction, Reverse Sampling, Classifier-Free Guidance 구현 및 평가 이번 과제에서는 Denoising Diffusion Probabilistic Model(DDPM)의 핵심 구성요소를 구현하고, noisy image를 점진적으로 denoise하여 이미지를 생성하는 과정을 배운다. DDPM은 데이터 분포에서 바로 샘플을 생성하는 대신, 먼저 실제 이미지에 Gaussian noise를 점진적으로 추가하는 Forward Diffusion을 정의하고, 반대로 노이즈에서 이미지를 복원하는 Reverse Diffusion을 학습한다. Forward process 자체는 고정된 noise schedule에 의해 결정되며, 실제로 학습되는 부분은 각 timestep에서 noisy image를 보고 노이즈 또는 원본 이미지를 예측하는 denoising model이다. 이 denoising model로 U-Net을 사용한다. #ASSIGNMENT
- Assignment 3-2: Self-Supervised Learning for Image Classification SimCLR의 data augmentation, NT-Xent loss 구현과 self-supervised representation의 image classification 평가 이번 과제에서는 label 없이 image representation을 학습하는 self-supervised learning과 SimCLR의 contrastive learning을 구현하고, 학습된 representation이 downstream image classification에 얼마나 유용한지 평가한다. Supervised learning은 이미지와 사람이 붙인 class label의 관계를 학습한다. 반면 self-supervised learning은 data 자체에서 학습 신호를 만든다. SimCLR에서는 같은 이미지에 서로 다른 random augmentation을 적용해 두 view를 만들고, 이 둘을 positive pair로 취급한다. Model은 positive pair의 representation을 가깝게 만들고, batch 안의 다른 이미지에서 나온 view는 멀어지게 학습한다. #ASSIGNMENT
- Assignment 3-1: Image Captioning with Transformers Attention 및 Transformer Block 구현, Image Captioning Transformer 의 Multi-Headed Attention 을 구현하고, Positional Encoding 의 원리와 구현, Transformer Block 을 만들고 COCO Dataset 으로 이미지 캡셔닝과 ViT를 구현한다. Multi-Headed Attention은 embedding을 여러 head로 나누어 각 head가 서로 다른 표현 공간에서 token 사이의 관계를 포착하도록 한다. #ASSIGNMENT
- Assignment 2-5: RNN Captioning COCO image feature와 RNN language model을 연결한 image captioning 구현 미리 추출한 image feature를 초기 hidden state로 투영하고, 한 timestep씩 어긋난 caption을 teacher forcing으로 학습하여 매 시점의 다음 token을 예측하는 RNN image captioning model을 구현한다. 이번 과제는 2014 COCO Dataset의 image-caption pair를 사용한다. Image는 ImageNet으로 사전 학습한 VGG-16의 fc7 feature를 사용하며, 4096차원 feature를 PCA로 줄인 512차원 입력을 model에 넣는다. Caption은 각 word를 integer ID로 바꾼 sequence로 처리한다. #ASSIGNMENT
- Assignment 2-3: Convolutional Networks Convolution, Max Pooling, Spatial Batch Normalization, Group Normalization 구현 이번 과제에서는 CNN을 구성하는 convolution과 max pooling layer의 forward, backward를 직접 구현한다. 이어서 CNN의 activation shape인 에 맞춰 Spatial Batch Normalization을 구현하고, 채널을 여러 group으로 나누어 정규화하는 Spatial Group Normalization까지 구현한다. #ASSIGNMENT
- Assignment 2-2: Dropout Dropout 개념 및 구현 드롭아웃의 개념과 효과, 순전파 및 역전파를 구현한다. 드롭아웃(Dropout)은 훈련 시 drop probability 만큼 뉴런의 출력을 무작위로 0으로 만드는 규제 기법이다. #ASSIGNMENT
- Assignment 2-1: Batch Normalization Batch Norm, Layer Norm 이번 과제에서는 Batch Normalization 의 개념과 BatchNorm 레이어의 forward, backward 를 구현한다. 또한 Batch Norm과 Weight Initialization 의 관계, Batch Norm과 Batch Size와의 관계를 Baseline 기반으로 비교한다. #ASSIGNMENT
- Assignment 1-5: Training a fully connected network FullyConnectedNet 구현, Momentum, RMSProp, Adam 이번 과제에서는 임의의 개수의 hidden layer를 갖는 FullyConnectedNet을 구현하고, 여러 optimizer를 직접 구현해본다. 앞에서 만든 TwoLayerNet이 하나의 hidden layer만 갖는 구조였다면, 여기서는 hidden layer 개수를 리스트로 받아 더 깊은 fully-connected network를 구성한다. 기본 구조는 다음과 같다. #ASSIGNMENT
- Assignment 1-4: Higher Level Representations: Image Features HOG, HSV feature 추출과 feature 기반 분류기 학습 이번 과제에서는 원본 픽셀을 그대로 사용하는 대신, 이미지에서 hand-crafted feature를 추출한 뒤 분류기를 학습한다. 사용한 feature는 Histogram of Oriented Gradients, HOG와 HSV color histogram이다. 전체 흐름은 다음과 같다. 각 이미지에서 HOG feature를 추출한다. 각 이미지에서 HSV hue channel 기반 color histogram을 추출한다. 두 feature vector를 이어 붙여 하나의 feature vector로 만든다. 추출된 feature 위에서 Softmax linear classifier를 학습한다. 같은 feature 위에서 TwoLayerNet을 학습한다. #ASSIGNMENT
- Assignment 1-3: Two-Layer Neural Network 완전연결계층 구현 Fully-Connected Neural Nets 과제에서는 neural network를 구성하는 기본 layer들을 모듈 단위로 구현한다. 이번 과제에서 직접 구현한 핵심은 affineforward, affinebackward, reluforward, relubackward, softmaxloss, 그리고 이들을 조합한 TwoLayerNet이다. 전체 구조는 다음과 같다. #ASSIGNMENT
- Assignment 1-2: Implement a Softmax classifier softmaxloss 구현, SGD 구현 softmaxloss 에 대해서 이해하고, svm loss와 softmaxloss의 차이를 확인하고, SGD를 적용해서 훈련을 수행하고, 검증 데이터로 하이퍼파라미터 결정하기 softmaxloss 는 모델이 정답 클래스에 얼마나 높은 확률을 부여했는지를 기준으로 손실을 계산하는 방법이다. score를 softmax로 변환하여 각 클래스의 확률을 계산 정답 클래스의 확률이 1에 가까울수록 loss가 작아짐 SVM loss와 달리 margin을 넘겨도 정답 확률을 더 키우는 방향으로 계속 학습 수식: logit(점수): #ASSIGNMENT
- Assignment 1-1: k-Nearest Neighbor classifier kNN 구현, training, testing, cross-validation L1, L2 distance 에 대해 이해하고, k-Nearest Neighbors(kNN) 분류기를 직접 구현하고, 학습 데이터에 대해 성능을 측정하고, Cross-Validation (k-folds) 를 이용해 최적의 하이퍼파라미터 k를 찾기 k-Nearest Neighbors(kNN)는 테스트 샘플과 훈련 샘플 간의 거리를 계산하여 가장 가까운 k개의 이웃을 찾고, 다수결을 통해 클래스를 예측하는 분류 알고리즘이다. 학습 과정이 거의 없음 (Lazy Learning) 가장 가까운 k개의 데이터로 분류 거리 척도로 주로 Euclidean Distance(L2 distance) 사용 거리 계산: #ASSIGNMENT