딥러닝 / 추천시스템
추천시스템
- [Google Recommendation Systems 06] Retrieval, Scoring, Re-ranking 추천 시스템의 retrieval, scoring, re-ranking 파이프라인과 freshness, diversity, fairness Google 공식 원문: Retrieval, Scoring, Re-ranking, Course summary 대규모 추천 시스템은 corpus 전체를 하나의 복잡한 모델로 정렬하지 않는다. 수백만 개 이상의 item을 요청마다 모두 평가하면 latency와 compute 비용을 감당하기 어렵기 때문이다. 대신 대상을 단계적으로 줄이는 funnel 구조를 사용한다. Retrieval 또는 candidate generation: 전체 corpus에서 관련 가능성이 있는 candidate 수백수천 개를 빠르게 가져온다. Scoring과 ranking: 더 많은 feature와 복잡한 모델로 candidate의 relevance를 평가하고 순서를 정한다. Re-ranking: freshness, diversity, fairness, 정책 같은 추가 기준과 제약을 반영해 최종 노출 목록을 만든다. #GOOGLE-RECOMMENDATION-SYSTEMS
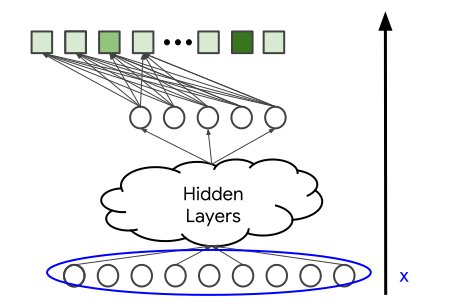
- [Google Recommendation Systems 05] Softmax DNN과 Two-Tower Softmax DNN 추천 모델의 구조와 embedding 해석, negative sampling, two-tower 모델 Google 공식 원문: Deep neural network models, Softmax training 이전 글의 matrix factorization은 사용자와 item마다 하나의 embedding을 학습하고, 두 embedding의 내적으로 선호도를 예측했다. 단순하고 대규모 corpus에도 잘 확장되지만 다음과 같은 한계가 있다. user ID와 item ID 이외의 side feature를 모델에 넣기 어렵다. 학습 데이터에 없던 새로운 user나 item을 바로 처리하기 어렵다. dot product를 그대로 사용하면 norm이 큰 인기 item이 많은 사용자에게 반복해서 추천되기 쉽다. 사용자의 현재 문맥이나 구체적인 관심사를 세밀하게 반영하기 어렵다. #GOOGLE-RECOMMENDATION-SYSTEMS
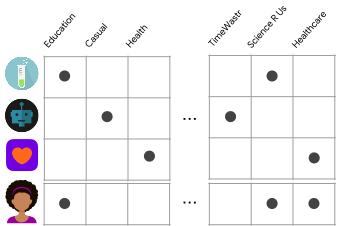
- [Google Recommendation Systems 04] Collaborative filtering과 matrix factorization User-item interaction에서 latent embedding을 학습하는 collaborative filtering과 weighted matrix factorization 공식 원문: Collaborative filtering: Basics, Matrix factorization, Advantages & disadvantages Collaborative filtering은 여러 사용자의 user–item interaction을 함께 이용해 user와 item의 latent embedding을 자동으로 학습하며, matrix factorization은 feedback matrix 를 저차원 행렬 와 의 곱으로 근사해 관측되지 않은 선호를 예측하는 대표적인 collaborative filtering 방법이다. #GOOGLE-RECOMMENDATION-SYSTEMS
- [Google Recommendation Systems 03] Content-based filtering Item feature와 user profile의 유사도로 추천하는 content-based filtering의 원리와 장단점 공식 원문: Content-based filtering: Basics, Advantages & disadvantages Content-based filtering은 item과 사용자를 같은 feature space의 vector로 표현하고 두 vector의 similarity로 candidate의 relevance를 계산하는 방법이며, 다른 사용자의 행동 없이 개인의 취향을 세밀하게 반영할 수 있지만 추천 품질이 사람이 설계한 feature와 사용자의 기존 관심사에 크게 제한된다. #GOOGLE-RECOMMENDATION-SYSTEMS
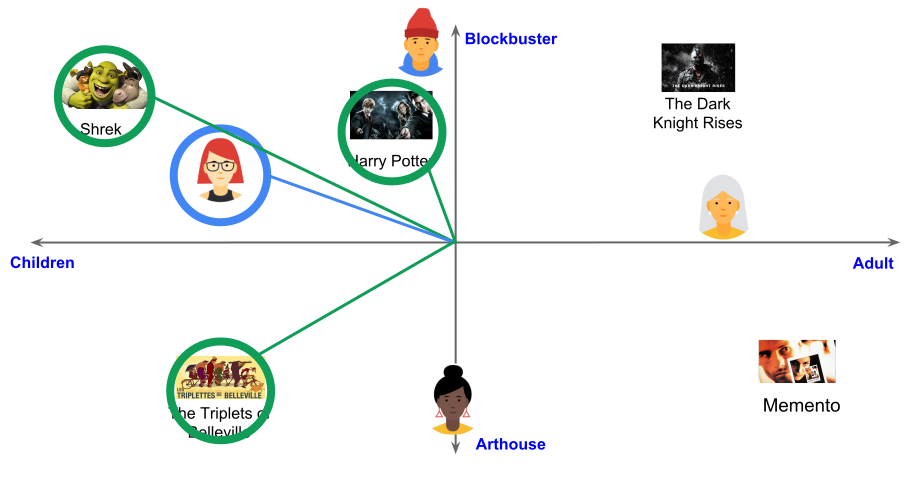
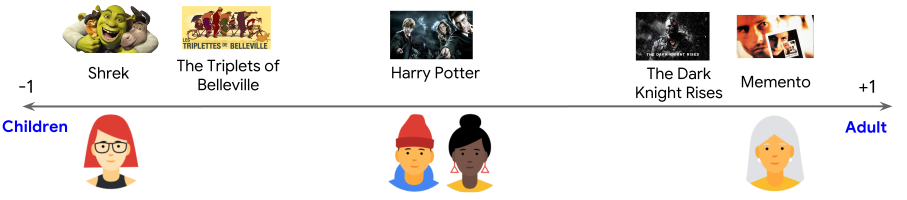
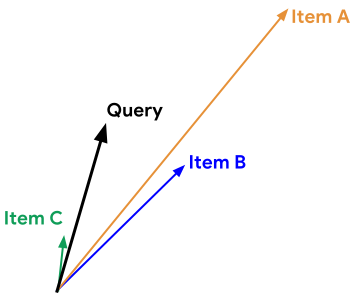
- [Google Recommendation Systems 02] Candidate generation과 embedding 추천 후보를 생성하는 두 가지 접근과 embedding 공간의 의미, cosine/dot product/Euclidean distance의 차이와 선택 기준 Google 공식 원문: Candidate generation overview Candidate generation은 전체 corpus에서 현재 query와 관련 있을 가능성이 높은 item을 빠르게 추려내는 추천 시스템의 첫 단계이다. 대규모 서비스에서는 모든 item을 정교한 scoring model에 넣을 수 없으므로, 이 단계가 수백만∼수십억 개의 item을 수백∼수천 개 수준의 후보로 줄인다. #GOOGLE-RECOMMENDATION-SYSTEMS
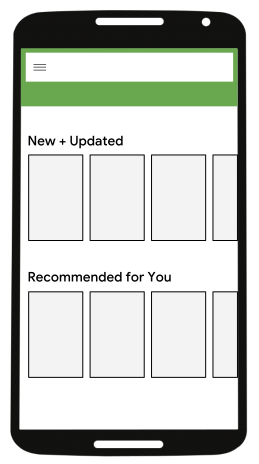
- [Google Recommendation Systems 01] 추천 시스템 개요 대규모 추천 시스템이 필요한 이유와 item, query, embedding의 의미, candidate generation부터 re-ranking까지의 전체 구조 Google 공식 원문: Recommendation Systems 과정, Large-scale recommendation systems, Terminology, Recommendation systems overview 추천 시스템은 사용 가능한 전체 콘텐츠 가운데 현재 사용자에게 보여줄 만한 item을 골라 순서를 정하는 시스템이다. YouTube가 다음에 볼 영상을 제안하거나 Google Play가 홈 화면에 앱을 배열하는 과정이 대표적인 예이다. #GOOGLE-RECOMMENDATION-SYSTEMS
딥러닝 / 추천시스템
추천시스템
- [Google Recommendation Systems 06] Retrieval, Scoring, Re-ranking 추천 시스템의 retrieval, scoring, re-ranking 파이프라인과 freshness, diversity, fairness Google 공식 원문: Retrieval, Scoring, Re-ranking, Course summary 대규모 추천 시스템은 corpus 전체를 하나의 복잡한 모델로 정렬하지 않는다. 수백만 개 이상의 item을 요청마다 모두 평가하면 latency와 compute 비용을 감당하기 어렵기 때문이다. 대신 대상을 단계적으로 줄이는 funnel 구조를 사용한다. Retrieval 또는 candidate generation: 전체 corpus에서 관련 가능성이 있는 candidate 수백수천 개를 빠르게 가져온다. Scoring과 ranking: 더 많은 feature와 복잡한 모델로 candidate의 relevance를 평가하고 순서를 정한다. Re-ranking: freshness, diversity, fairness, 정책 같은 추가 기준과 제약을 반영해 최종 노출 목록을 만든다. #GOOGLE-RECOMMENDATION-SYSTEMS
- [Google Recommendation Systems 05] Softmax DNN과 Two-Tower Softmax DNN 추천 모델의 구조와 embedding 해석, negative sampling, two-tower 모델 Google 공식 원문: Deep neural network models, Softmax training 이전 글의 matrix factorization은 사용자와 item마다 하나의 embedding을 학습하고, 두 embedding의 내적으로 선호도를 예측했다. 단순하고 대규모 corpus에도 잘 확장되지만 다음과 같은 한계가 있다. user ID와 item ID 이외의 side feature를 모델에 넣기 어렵다. 학습 데이터에 없던 새로운 user나 item을 바로 처리하기 어렵다. dot product를 그대로 사용하면 norm이 큰 인기 item이 많은 사용자에게 반복해서 추천되기 쉽다. 사용자의 현재 문맥이나 구체적인 관심사를 세밀하게 반영하기 어렵다. #GOOGLE-RECOMMENDATION-SYSTEMS
- [Google Recommendation Systems 04] Collaborative filtering과 matrix factorization User-item interaction에서 latent embedding을 학습하는 collaborative filtering과 weighted matrix factorization 공식 원문: Collaborative filtering: Basics, Matrix factorization, Advantages & disadvantages Collaborative filtering은 여러 사용자의 user–item interaction을 함께 이용해 user와 item의 latent embedding을 자동으로 학습하며, matrix factorization은 feedback matrix 를 저차원 행렬 와 의 곱으로 근사해 관측되지 않은 선호를 예측하는 대표적인 collaborative filtering 방법이다. #GOOGLE-RECOMMENDATION-SYSTEMS
- [Google Recommendation Systems 03] Content-based filtering Item feature와 user profile의 유사도로 추천하는 content-based filtering의 원리와 장단점 공식 원문: Content-based filtering: Basics, Advantages & disadvantages Content-based filtering은 item과 사용자를 같은 feature space의 vector로 표현하고 두 vector의 similarity로 candidate의 relevance를 계산하는 방법이며, 다른 사용자의 행동 없이 개인의 취향을 세밀하게 반영할 수 있지만 추천 품질이 사람이 설계한 feature와 사용자의 기존 관심사에 크게 제한된다. #GOOGLE-RECOMMENDATION-SYSTEMS
- [Google Recommendation Systems 02] Candidate generation과 embedding 추천 후보를 생성하는 두 가지 접근과 embedding 공간의 의미, cosine/dot product/Euclidean distance의 차이와 선택 기준 Google 공식 원문: Candidate generation overview Candidate generation은 전체 corpus에서 현재 query와 관련 있을 가능성이 높은 item을 빠르게 추려내는 추천 시스템의 첫 단계이다. 대규모 서비스에서는 모든 item을 정교한 scoring model에 넣을 수 없으므로, 이 단계가 수백만∼수십억 개의 item을 수백∼수천 개 수준의 후보로 줄인다. #GOOGLE-RECOMMENDATION-SYSTEMS
- [Google Recommendation Systems 01] 추천 시스템 개요 대규모 추천 시스템이 필요한 이유와 item, query, embedding의 의미, candidate generation부터 re-ranking까지의 전체 구조 Google 공식 원문: Recommendation Systems 과정, Large-scale recommendation systems, Terminology, Recommendation systems overview 추천 시스템은 사용 가능한 전체 콘텐츠 가운데 현재 사용자에게 보여줄 만한 item을 골라 순서를 정하는 시스템이다. YouTube가 다음에 볼 영상을 제안하거나 Google Play가 홈 화면에 앱을 배열하는 과정이 대표적인 예이다. #GOOGLE-RECOMMENDATION-SYSTEMS