
Overview
이번 과제에서는 CNN을 구성하는 convolution과 max pooling layer의 forward, backward를 직접 구현한다.
이어서 CNN의 activation shape인 에 맞춰 Spatial Batch Normalization을 구현하고, 채널을 여러 group으로 나누어 정규화하는 Spatial Group Normalization까지 구현한다.
핵심 아이디어
Convolution
입력 와 filter , bias 의 shape은 다음과 같다.
- 입력 :
- filter :
- bias :
은 batch size, 는 입력 채널 수, 는 filter 수이다. 와 는 filter의 높이와 너비이다.
padding을 , stride를 라고 하면 출력의 공간 크기는 다음과 같다.
따라서 출력 shape은 이다. 출력 위치 에서 사용하는 입력 patch를 다음과 같이 둔다.
출력의 한 원소는 이 patch와 filter의 inner product에 bias를 더해서 계산한다.
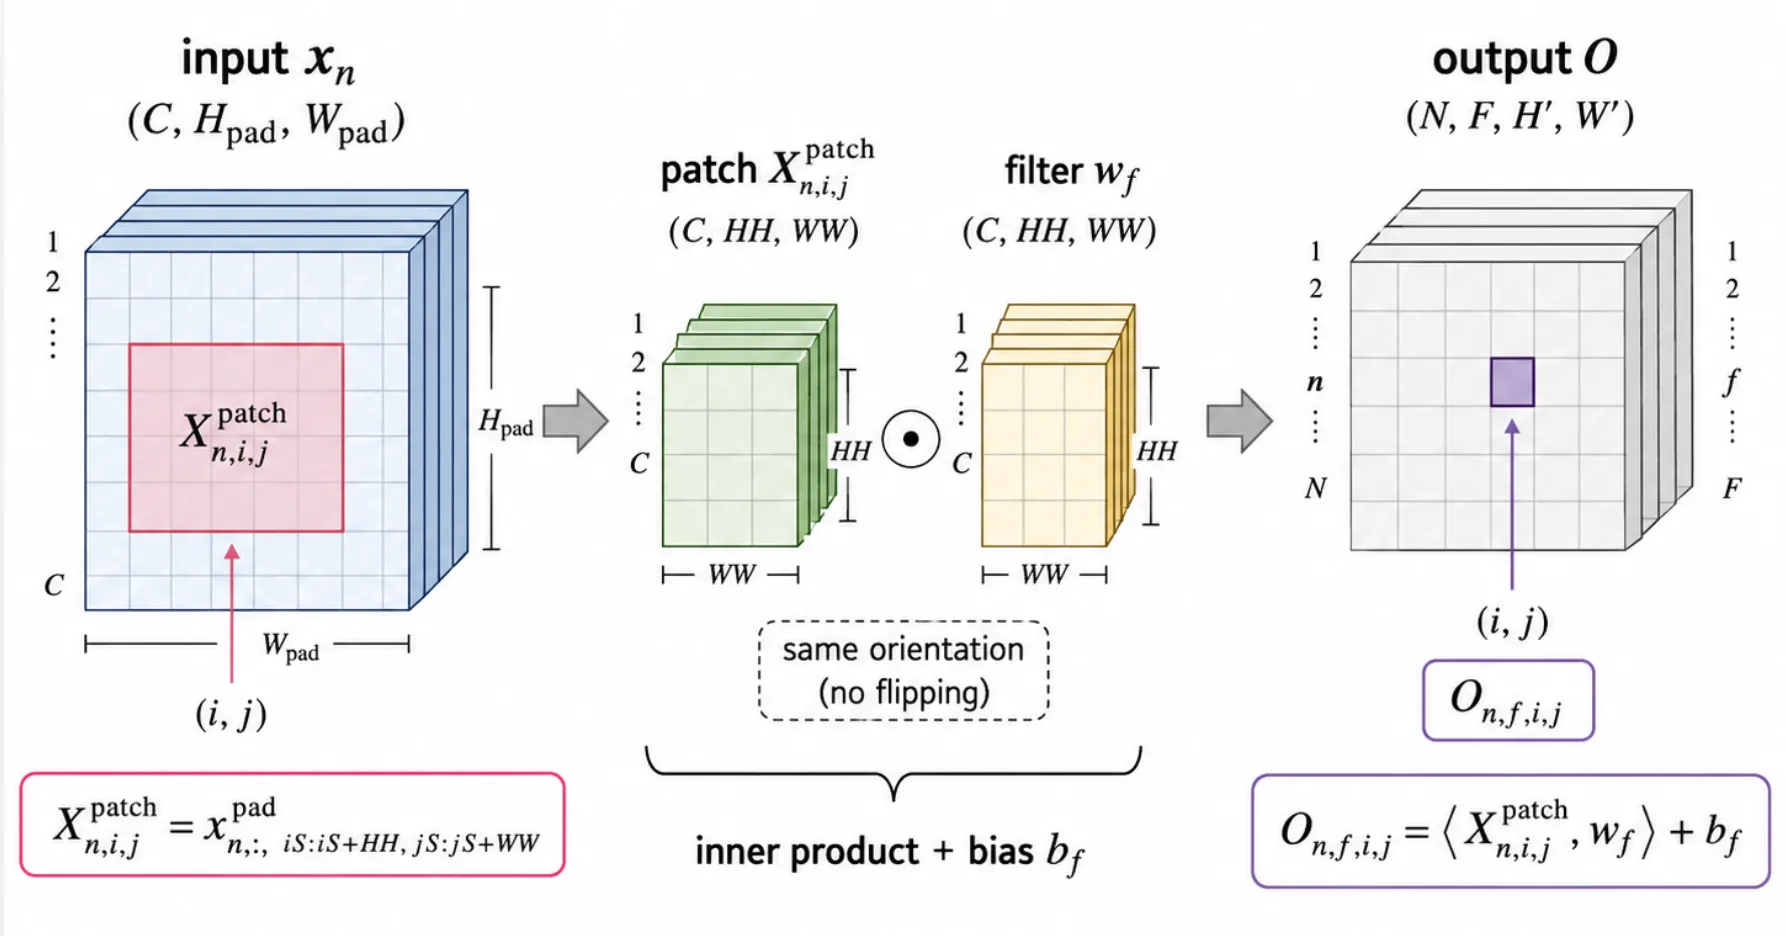
이번 naive convolution은 filter를 뒤집지 않고 입력 window와 같은 방향으로 곱한다.
Max Pooling
Max pooling은 각 pooling window에서 최댓값 하나를 선택한다. 채널 수는 유지하면서 공간 크기만 줄인다.
pooling window의 높이와 너비를 , , stride를 라고 하면 출력 크기는 다음과 같다.
backward에서는 forward에서 최댓값이었던 위치에만 upstream gradient를 전달한다.
CNN에서의 정규화 축
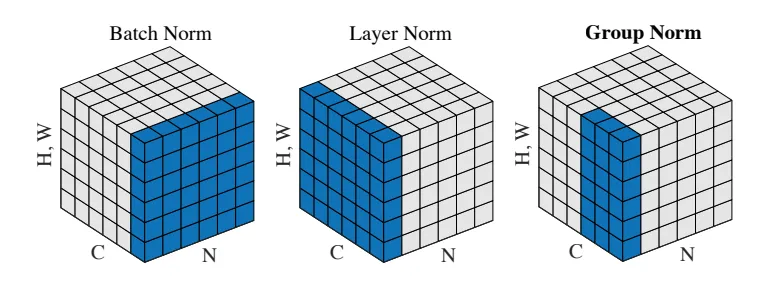
같은 activation이라도 어떤 축을 묶어 평균과 분산을 계산하는지에 따라 정규화 방식이 달라진다.
| 방법 | 고정하는 단위 | 통계를 계산하는 축 |
|---|---|---|
| Spatial BatchNorm | 채널 | |
| LayerNorm | 샘플 | |
| GroupNorm | 샘플 과 group |
Spatial BatchNorm은 동일한 채널의 모든 batch와 공간 위치를 모아 통계를 계산한다.
GroupNorm은 각 샘플의 채널을 개 group으로 나누고, group마다 독립적으로 정규화한다. 따라서 batch size에 직접 의존하지 않는다.
구현
Convolution
Forward
def conv_forward_naive(x, w, b, conv_param):
    stride = conv_param['stride']
    pad = conv_param['pad']

    N, C, H, W = x.shape
    F, _, HH, WW = w.shape
    H_out = 1 + (H + 2 * pad - HH) // stride
    W_out = 1 + (W + 2 * pad - WW) // stride

    x_pad = np.pad(
        x,
        ((0, 0), (0, 0), (pad, pad), (pad, pad))
    )

    out = np.zeros((N, F, H_out, W_out))

    for n in range(N):
        for f in range(F):
            for i in range(H_out):
                for j in range(W_out):
                    hs = i * stride
                    ws = j * stride
                    window = x_pad[
                        n,
                        :,
                        hs:hs + HH,
                        ws:ws + WW
                    ]
                    out[n, f, i, j] = np.sum(window * w[f]) + b[f]

    cache = (x, w, b, conv_param)
    return out, cache
입력 원본을 직접 수정하지 않도록 np.pad로 새로운 배열을 만든다. 이후 각 출력 위치 에 대응하는 입력 window를 잘라 filter와 곱한다.
Backward
upstream gradient dout의 한 원소는 forward의 출력 한 원소에 대응한다. 이를 다음과 같이 둔다.
각 를 해당 출력 계산에 사용된 bias, filter, 입력 patch로 다시 나누어 보낸다.
Bias는 같은 filter가 만든 모든 출력 위치에서 공유되므로 전부 더한다.
Filter gradient는 각 입력 window에 그 위치의 upstream gradient를 곱한 값을 모든 batch와 공간 위치에 대해 누적한다.
입력 gradient는 filter에 upstream gradient를 곱해 해당 입력 window 위치에 누적한다. 여러 receptive field가 겹치는 입력 위치는 여러 출력에 영향을 주었으므로 gradient도 +=로 합쳐야 한다.
def conv_backward_naive(dout, cache):
    x, w, b, conv_param = cache
    N, C, H, W = x.shape
    F, _, HH, WW = w.shape

    stride = conv_param['stride']
    pad = conv_param['pad']

    x_pad = np.pad(
        x,
        ((0, 0), (0, 0), (pad, pad), (pad, pad))
    )
    dx_pad = np.zeros_like(x_pad)
    dw = np.zeros_like(w)
    db = np.zeros_like(b)

    H_out = 1 + (H + 2 * pad - HH) // stride
    W_out = 1 + (W + 2 * pad - WW) // stride

    for n in range(N):
        for f in range(F):
            for i in range(H_out):
                for j in range(W_out):
                    hs = i * stride
                    ws = j * stride
                    window = x_pad[
                        n,
                        :,
                        hs:hs + HH,
                        ws:ws + WW
                    ]

                    db[f] += dout[n, f, i, j]
                    dw[f] += window * dout[n, f, i, j]
                    dx_pad[
                        n,
                        :,
                        hs:hs + HH,
                        ws:ws + WW
                    ] += w[f] * dout[n, f, i, j]

    if pad == 0:
        dx = dx_pad
    else:
        dx = dx_pad[:, :, pad:-pad, pad:-pad]

    return dx, dw, db
마지막에는 forward에서 추가했던 padding을 제거하여 dx를 원래 입력과 같은 shape으로 복원한다. pad == 0일 때 pad:-pad를 사용하면 0:0이 되어 빈 배열이 나오므로 별도로 분기해야 한다.
Max Pooling
Forward
def max_pool_forward_naive(x, pool_param):
    ph = pool_param['pool_height']
    pw = pool_param['pool_width']
    stride = pool_param['stride']

    N, C, H, W = x.shape
    H_out = 1 + (H - ph) // stride
    W_out = 1 + (W - pw) // stride

    out = np.zeros((N, C, H_out, W_out))

    for n in range(N):
        for c in range(C):
            for i in range(H_out):
                for j in range(W_out):
                    hs = i * stride
                    ws = j * stride
                    out[n, c, i, j] = np.max(
                        x[n, c, hs:hs + ph, ws:ws + pw]
                    )

    cache = (x, pool_param)
    return out, cache
Backward
forward에서 최댓값이었던 위치를 boolean mask로 찾고, 그 위치에만 upstream gradient를 전달한다.
def max_pool_backward_naive(dout, cache):
    x, pool_param = cache

    ph = pool_param['pool_height']
    pw = pool_param['pool_width']
    stride = pool_param['stride']

    N, C, H, W = x.shape
    H_out = 1 + (H - ph) // stride
    W_out = 1 + (W - pw) // stride
    dx = np.zeros_like(x)

    for n in range(N):
        for c in range(C):
            for i in range(H_out):
                for j in range(W_out):
                    hs = i * stride
                    ws = j * stride

                    window = x[
                        n,
                        c,
                        hs:hs + ph,
                        ws:ws + pw
                    ]
                    mask = window == np.max(window)

                    dx[
                        n,
                        c,
                        hs:hs + ph,
                        ws:ws + pw
                    ] += mask * dout[n, c, i, j]

    return dx
현재 구현은 window 안에 같은 최댓값이 여러 개 있으면 모든 위치에 같은 gradient를 전달한다. 일반적인 무작위 실수 입력에서는 동점이 드물지만, 구현에 따라 첫 번째 최댓값만 선택하거나 gradient를 나누는 규칙을 사용할 수도 있다.
Spatial Batch Normalization
Spatial BatchNorm은 채널 를 고정하고 축을 합쳐 통계를 계산한다. 직접 정규화 수식을 다시 구현하지 않고, 입력을 로 바꿔 기존 batchnorm_forward를 재사용할 수 있다.
Forward
def spatial_batchnorm_forward(x, gamma, beta, bn_param):
    N, C, H, W = x.shape

    x_convert = x.transpose(0, 2, 3, 1).reshape(-1, C)
    out, cache = batchnorm_forward(
        x_convert,
        gamma,
        beta,
        bn_param
    )

    out = out.reshape(N, H, W, C).transpose(0, 3, 1, 2)
    return out, cache
Backward
backward도 dout을 로 바꾼 뒤 기존 BatchNorm backward를 적용하고 원래 shape으로 되돌린다.
def spatial_batchnorm_backward(dout, cache):
    N, C, H, W = dout.shape

    dout_convert = dout.transpose(0, 2, 3, 1).reshape(-1, C)
    dx, dgamma, dbeta = batchnorm_backward(dout_convert, cache)
    dx = dx.reshape(N, H, W, C).transpose(0, 3, 1, 2)

    return dx, dgamma, dbeta
Spatial Group Normalization
GroupNorm은 각 샘플의 개 채널을 개 group으로 나눈다. 한 group에서 정규화하는 원소 수는 다음과 같다.
입력을 로 reshape하면 각 row가 독립적으로 정규화되어야 하는 하나의 group이 된다. 이 형태는 LayerNorm의 입력과 같으므로 기존 구현을 재사용할 수 있다.
Forward
def spatial_groupnorm_forward(x, gamma, beta, G, gn_param):
    N, C, H, W = x.shape

    x_group = x.reshape(N * G, -1)
    D = (C // G) * H * W

    ln_gamma = np.ones(D)
    ln_beta = np.zeros(D)

    x_norm, ln_cache = layernorm_forward(
        x_group,
        ln_gamma,
        ln_beta,
        gn_param
    )

    x_norm = x_norm.reshape(N, C, H, W)
    out = gamma * x_norm + beta
    cache = (G, x_norm, gamma, ln_cache)

return out, cachelayernorm_forward에는 정규화만 맡기기 위해 임시 ln_gamma=1, ln_beta=0을 사용한다. 이후 채널별로 학습되는 실제 gamma, beta를 shape으로 적용한다.
Backward
Affine transform 의 gradient를 먼저 계산한다.
그다음 dx_norm = dout * gamma를 로 바꾸고 LayerNorm backward를 통과시킨다.
def spatial_groupnorm_backward(dout, cache):
    G, x_norm, gamma, ln_cache = cache
    N, C, H, W = dout.shape

    dgamma = np.sum(
        dout * x_norm,
        axis=(0, 2, 3),
        keepdims=True
    )
    dbeta = np.sum(
        dout,
        axis=(0, 2, 3),
        keepdims=True
    )

    dx_norm = dout * gamma
    dx_group = dx_norm.reshape(N * G, -1)
    dx_group, _, _ = layernorm_backward(dx_group, ln_cache)
    dx = dx_group.reshape(N, C, H, W)

    return dx, dgamma, dbeta
추가 개념들
Convolution backward를 행렬 수준에서 보기
stride가 이고 padding이 없는 간단한 예시를 생각한다.
filter를 왼쪽 위에서부터 한 칸씩 이동시키면 출력은 다음과 같은 행렬이 된다. 계산을 단순하게 보기 위해 bias는 생략한다.
각 출력 원소는 현재 입력 window와 filter를 같은 위치끼리 곱한 뒤 모두 더한 값이다.
출력 와 upstream gradient 는 모두 이다.
Filter gradient
은 모든 출력 위치에서 공유된다. 따라서 각 위치에서 함께 곱해졌던 입력과 upstream gradient의 곱을 모두 더한다.
이는 하나가 네 출력에 모두 사용되기 때문이다.
연쇄법칙으로 적으면 하나의 filter parameter가 영향을 준 모든 출력 경로의 gradient를 합하는 형태가 된다.
나머지 filter 원소도 같은 방식으로 계산한다.
일반적으로 filter gradient는 다음과 같이 이해할 수 있다.
즉 하나의 filter weight가 사용된 모든 위치에서 입력값 × upstream gradient를 누적한 결과이다.
Input gradient
입력 원소도 자신이 사용된 모든 출력으로부터 gradient를 받아야 한다.
모서리의 은 에만 사용되지만, 중앙의 는 네 출력 모두에 영향을 준다.
| 출력 | 와 곱해진 filter weight |
|---|---|
따라서 연쇄법칙에 따라 네 경로의 gradient를 합치면 다음과 같다.
전체 입력 gradient를 원소별로 펼치면 다음과 같다.
인 에서 원래 입력과 같은 gradient를 만들어야 하므로 valid convolution이 아니라 FullConv가 필요하다. 이때 filter를 회전한다.
filter 회전은 외워서 추가하는 별도 규칙이 아니라, 하나의 입력이 여러 출력 계산에서 filter의 서로 다른 위치와 곱해졌다는 사실을 연쇄법칙으로 풀어 쓴 결과이다.
이번 naive loop에서는 회전된 filter를 직접 만들지 않는다. 각 dout[n, f, i, j]를 forward에서 사용했던 동일한 window에 w[f]와 곱해 흩뿌리고, 겹치는 위치를 더하는 방식으로 같은 dx를 계산한다.
Stride가 1보다 클 때
입력이 , filter가 , stride가 , padding이 인 경우를 생각한다. 출력 크기는 다음과 같다.
따라서 출력과 upstream gradient는 모두 이다. forward에서 filter의 왼쪽 위 좌표는 다음 네 위치만 방문한다.
stride가 이면 중간 위치도 방문하지만, stride가 이면 한 칸씩 건너뛴다. 이를 convolution 식으로 표현한 backward에서는 출력 gradient 사이에 을 삽입해 원래 간격을 복원한 dilated gradient를 생각할 수 있다.
빠진 위치는 forward 출력에 존재하지 않았으므로 그 위치에서 내려오는 gradient도 이다. stride가 라면 인접한 gradient 사이에 일반적으로 개의 을 넣는다.
Stride 2의 input gradient
dx를 convolution 형태로 계산하는 순서는 다음과 같다.
- 의 원소 사이에 을 넣어 를 만든다.
- 원래 입력 영역까지 gradient가 퍼질 수 있도록 가장자리를 padding한다.
- filter를 회전한다.
- FullConv를 수행해 입력과 같은 shape을 복원한다.
따라서 다음과 같이 정리할 수 있다.
반면 naive loop에서는 hs = i * stride, ws = j * stride로 실제 forward에서 방문했던 window에만 gradient를 누적한다. 건너뛴 출력 위치에는 애초에 반복문 항이 없으므로 별도의 dilation 배열을 만들 필요가 없다.
Stride 2의 filter gradient
stride가 커져도 하나의 filter weight는 모든 출력 위치에서 공유된다. 따라서 filter gradient의 기본 연쇄법칙은 달라지지 않는다.
예를 들어 은 stride 간격에 따라 , , , 와 곱해진다.
일반화하면 다음과 같다.
코드에서는 각 출력 위치의 입력 window 전체에 dout[n, f, i, j]를 곱한 뒤 dw[f]에 누적하므로 이 식을 그대로 구현한다.
수식과 naive loop의 대응
수식에서는 filter 회전, full convolution, gradient dilation이 눈에 띈다. 하지만 이번 구현은 각 출력 원소가 사용했던 입력 window로 gradient를 직접 되돌려 보내는 방식이라 이 배열들을 명시적으로 만들지 않는다.
| 역전파 대상 | 수식 관점 | naive loop에서의 계산 |
|---|---|---|
| 같은 filter의 모든 출력 gradient 합 | db[f] += dout[n, f, i, j] | |
| 입력 window와 의 Conv | dw[f] += window * dout[n, f, i, j] | |
| dilated 와 filter의 full 연산 | 해당 window에 w[f] * dout[n, f, i, j] 누적 |
특히 dx_pad[...] += ...에서 대입이 아니라 누적을 사용해야 한다. receptive field가 겹치면 하나의 입력이 여러 출력에 참여하므로 각 경로에서 돌아온 gradient를 모두 더해야 하기 때문이다.
Forward와 backward의 shape
각 gradient는 미분 대상과 같은 shape을 가진다.
| 값 | Shape |
|---|---|
| , | |
| , | |
| , | |
| , |
backward 구현 중 shape이 헷갈릴 때는 dx, dw, db가 각각 x, w, b와 같은 shape으로 돌아와야 한다는 점을 먼저 확인하면 된다.
참고: 딥러닝 라이브러리에서 convolution이라고 부르는 연산은 엄밀히 말하면 filter를 뒤집지 않는 cross-correlation인 경우가 많다. 이 글에서는 PDF의 표기에 맞춰 Conv와 FullConv로 적었다.