
Overview
미리 추출한 image feature를 초기 hidden state로 투영하고, 한 timestep씩 어긋난 caption을 teacher forcing으로 학습하여 매 시점의 다음 token을 예측하는 RNN image captioning model을 구현한다.
핵심 아이디어
COCO Dataset과 전처리
이번 과제는 2014 COCO Dataset의 image-caption pair를 사용한다. Image는 ImageNet으로 사전 학습한 VGG-16의 fc7 feature를 사용하며, 4096차원 feature를 PCA로 줄인 512차원 입력을 model에 넣는다. Caption은 각 word를 integer ID로 바꾼 sequence로 처리한다.
Special token
길이가 다른 caption을 하나의 minibatch로 묶기 위해 다음 special token을 사용한다.
| Token | 역할 |
|---|---|
<START> | caption 생성의 시작을 알리는 첫 입력 |
<END> | caption이 끝났음을 나타냄 |
<UNK> | vocabulary에 없는 rare word를 대신함 |
<NULL> | 짧은 caption의 남는 timestep을 채우는 padding |
<NULL>은 tensor shape을 맞추기 위한 값일 뿐 학습할 정답이 아니다. 따라서 <NULL> 위치는 mask로 제외하여 loss와 gradient를 계산하지 않는다.
네 개의 표현 공간 연결하기
Image captioning model 안에는 서로 의미가 다른 네 개의 공간이 있다.
| 공간 | 차원 | 의미 |
|---|---|---|
| Image feature space | CNN이 추출한 image 표현 | |
| Word embedding space | token을 나타내는 연속 벡터 | |
| Recurrent hidden space | image와 지금까지의 caption 정보를 담는 상태 | |
| Vocabulary space | 다음 word 후보 각각에 대한 score |
전체 계산 흐름은 다음과 같다.
텍스트 입력은 token ID에서 시작한다.
서로 다른 공간은 바로 섞지 않고 learned projection으로 연결한다. Image feature는 W_proj를 통해 RNN이 사용하는 hidden space로 옮기고, hidden state는 W_vocab을 통해 vocabulary score로 바꾼다.
Shape ledger
이 과제에서는 tensor의 rank만 보는 것보다 각 축의 역할을 함께 기록하는 것이 중요하다.
| 변수 | Shape | 의미 |
|---|---|---|
features | minibatch의 image feature | |
captions | <START>와 출력 token을 포함한 caption | |
captions_in | RNN에 넣는 입력 token | |
captions_out | 각 timestep에서 예측할 token | |
W_proj | image feature를 hidden space로 투영 | |
h0 | image에서 만든 초기 hidden state | |
W_embed | vocabulary embedding table | |
x | caption의 word embedding | |
Wx | 또는 | input-to-hidden weight |
Wh | 또는 | hidden-to-hidden weight |
h | 모든 timestep의 hidden state | |
W_vocab | hidden state를 vocabulary score로 변환 | |
scores | 모든 token 후보에 대한 logits | |
mask | loss를 계산할 유효 timestep |
과 는 각각 batch와 time을 나타내는 구조적 축이다. Linear transformation은 이 구조적 축을 보존하면서 마지막 feature 축을 바꾼다.
Caption shift와 Teacher Forcing
RNN language model은 현재 token을 입력받아 다음 token을 예측한다. 이를 위해 원래 caption을 한 timestep 차이로 나눈다.
caption:      <START> a cat sleeps <END>
captions_in:  <START> a cat sleeps
captions_out:         a cat sleeps <END>
코드에서는 다음 두 slice가 이 정렬을 만든다.
captions_in = captions[:, :-1]
captions_out = captions[:, 1:]
따라서 번째 hidden state가 맞혀야 할 정답은 같은 위치의 captions_out이다.
Training에서는 이전 시점에 model이 예측한 token이 아니라 ground-truth token을 다음 입력으로 사용한다. 이 방식을 teacher forcing이라고 한다. 덕분에 전체 captions_in을 한 번에 recurrent layer에 넣을 수 있다.
Inference에서는 정답 caption이 없으므로 <START>에서 출발해 직전 예측값을 다음 입력으로 사용한다.
Image feature는 초기 hidden state가 된다
Image feature는 매 timestep마다 반복해서 넣지 않고 initial hidden state 를 만드는 데 한 번 사용한다.
Shape은 다음과 같다.
이후 image 정보는 recurrent state를 통해 다음 timestep으로 전달된다.
즉 이 구조에서 image는 caption 생성을 시작하는 initial context이다. Transformer 기반 captioning에서 image token에 반복적으로 cross-attention하는 방식과 비교하면 정보가 주입되는 위치가 다르다.
Word embedding과 recurrent core
captions_in의 각 값은 feature가 아니라 vocabulary index이다. word_embedding_forward는 W_embed에서 해당 index의 행을 lookup한다.
따라서 captions는 integer 또는 torch.long이어야 하고, features, parameter, hidden state와 score는 floating-point tensor여야 한다. 모든 tensor를 같은 dtype으로 바꾸는 것이 아니라 index tensor와 feature tensor의 역할을 구분해야 한다.
Vanilla RNN의 한 timestep은 다음과 같다.
RNN에서는 Wx, Wh, b의 마지막 차원이 이다. LSTM은 input gate, forget gate, output gate, candidate gate를 한 번에 계산하므로 마지막 차원이 가 된다.
| Cell | Wx | Wh | b | 출력 hidden state |
|---|---|---|---|---|
| RNN | ||||
| LSTM |
는 gate 계산을 위한 내부 크기이며 최종 hidden dimension은 여전히 이다.
Temporal affine와 masked softmax loss
temporal_affine_forward는 모든 timestep의 hidden state에 같은 classifier를 적용한다.
이를 구현 관점에서 보면 를 로 펼쳐 affine transformation을 적용한 뒤 다시 로 되돌리는 것과 같다. W_vocab은 timestep마다 따로 존재하지 않고 모든 timestep에서 공유된다.
Softmax는 vocabulary 축 를 따라 계산한다.
Prediction은 가능한 모든 token의 score가 필요하므로 이고, target은 정답 token의 index만 가지므로 이다. 최종 loss는 <NULL> 위치를 mask로 제외한다.
구현
CaptioningRNN 초기화
Parameter는 image feature, word embedding, recurrent hidden state, vocabulary score 사이의 interface를 구성한다. 이 과제에서는 별도의 regularization을 사용하지 않는다.
import numpy as np
import torch
from ..rnn_layers_pytorch import *


class CaptioningRNN:
    """
    Recurrent neural network를 사용해 image feature로부터 caption을 생성한다.

    RNN은 D차원 입력 벡터를 받고 vocabulary 크기는 V이다. Sequence 길이는
    T, RNN hidden dimension은 H, word vector dimension은 W이며 minibatch
    크기는 N이다.

    CaptioningRNN에서는 regularization을 사용하지 않는다.
    """

    def __init__(
        self,
        word_to_idx,
        input_dim=512,
        wordvec_dim=128,
        hidden_dim=128,
        cell_type="rnn",
        dtype=torch.float32,
    ):
        """
        CaptioningRNN instance를 생성한다.

        Inputs:
        - word_to_idx: V개 항목으로 구성된 vocabulary dictionary이다. 각 문자열을
          [0, V) 범위의 고유한 integer에 mapping한다.
        - input_dim: 입력 image feature vector의 차원 D이다.
        - wordvec_dim: Word vector의 차원 W이다.
        - hidden_dim: RNN hidden state의 차원 H이다.
        - cell_type: 사용할 recurrent cell이며 'rnn' 또는 'lstm'이다.
        - dtype: 사용할 datatype이다. Training에는 float32, numerical gradient
          checking에는 float64를 사용한다.
        """
        if cell_type not in {"rnn", "lstm"}:
            raise ValueError('Invalid cell_type "%s"' % cell_type)

        self.cell_type = cell_type
        self.dtype = dtype
        self.word_to_idx = word_to_idx
        self.idx_to_word = {i: w for w, i in word_to_idx.items()}
        self.params = {}

        vocab_size = len(word_to_idx)

        self._null = word_to_idx["<NULL>"]
        self._start = word_to_idx.get("<START>", None)
        self._end = word_to_idx.get("<END>", None)

        # Word vector 초기화
        self.params["W_embed"] = torch.randn(vocab_size, wordvec_dim)
        self.params["W_embed"] /= 100

        # CNN feature를 hidden state로 투영하는 parameter 초기화
        self.params["W_proj"] = torch.randn(input_dim, hidden_dim)
        self.params["W_proj"] /= np.sqrt(input_dim)
        self.params["b_proj"] = torch.zeros(hidden_dim)

        # RNN parameter 초기화
        dim_mul = {"lstm": 4, "rnn": 1}[cell_type]
        self.params["Wx"] = torch.randn(wordvec_dim, dim_mul * hidden_dim)
        self.params["Wx"] /= np.sqrt(wordvec_dim)
        self.params["Wh"] = torch.randn(hidden_dim, dim_mul * hidden_dim)
        self.params["Wh"] /= np.sqrt(hidden_dim)
        self.params["b"] = torch.zeros(dim_mul * hidden_dim)

        # Hidden state를 vocabulary score로 변환하는 parameter 초기화
        self.params["W_vocab"] = torch.randn(hidden_dim, vocab_size)
        self.params["W_vocab"] /= np.sqrt(hidden_dim)
        self.params["b_vocab"] = torch.zeros(vocab_size)

        # Parameter를 지정한 dtype으로 변환
        for k, v in self.params.items():
            self.params[k] = v.to(self.dtype)
초기화 scale은 각 입력 차원의 제곱근으로 나누어 지나치게 큰 activation이 생기는 것을 줄인다. cell_type이 LSTM이면 dim_mul=4가 되어 recurrent parameter가 네 gate를 동시에 계산할 수 있는 shape을 갖는다.
Training-time loss
Training forward pass는 다음 다섯 단계이다.
- Image feature를 초기 hidden state로 투영한다.
captions_in의 token ID를 word embedding으로 바꾼다.- RNN 또는 LSTM으로 모든 timestep의 hidden state를 계산한다.
- Temporal affine transformation으로 각 timestep의 vocabulary score를 만든다.
<NULL>을 제외한 위치에서 temporal softmax loss를 계산한다.
def loss(self, features, captions):
    """
    RNN의 training-time loss를 계산한다. Image feature와 해당 image의
    ground-truth caption을 입력하고, RNN 또는 LSTM을 사용해 모든 parameter에
    대한 loss를 계산한다.

    Inputs:
    - features: Shape이 (N, D)인 image feature이다.
    - captions: Shape이 (N, T + 1)인 ground-truth caption integer array이다.
      각 원소는 0 <= y[i, t] < V 범위에 있다.

    Returns:
    - loss: Scalar loss이다.
    """
    # Caption을 두 부분으로 나눈다. captions_in은 마지막 word를 제외하고
    # RNN 입력으로 사용한다. captions_out은 첫 word를 제외하고 RNN이 생성해야
    # 하는 정답으로 사용한다. RNN은 word t를 받은 뒤 word t+1을 생성해야 하므로
    # 두 sequence는 한 timestep 어긋나 있다. captions_in의 첫 원소는 <START>이고
    # captions_out의 첫 원소는 caption의 첫 word이다.
    captions_in = captions[:, :-1]
    captions_out = captions[:, 1:]

    # <NULL> 위치에서는 loss를 계산하지 않는다.
    mask = captions_out != self._null

    # Image feature를 초기 hidden state로 변환하는 affine parameter
    W_proj, b_proj = self.params["W_proj"], self.params["b_proj"]

    # Word embedding matrix
    W_embed = self.params["W_embed"]

    # RNN의 input-to-hidden, hidden-to-hidden weight와 bias
    Wx, Wh, b = self.params["Wx"], self.params["Wh"], self.params["b"]

    # Hidden state를 vocabulary score로 변환하는 weight와 bias
    W_vocab, b_vocab = self.params["W_vocab"], self.params["b_vocab"]

    loss = 0.0

    # (N, D) @ (D, H) -> (N, H)
    h0 = affine_forward(features, W_proj, b_proj)

    # embedding. (V, W) embed (N, T) -> (N, T, W)
    x = word_embedding_forward(captions_in, W_embed)

    # (N, T, W) -> (N, T, H)
    if self.cell_type == 'rnn':
        h = rnn_forward(x, h0, Wx, Wh, b)
    elif self.cell_type == 'lstm':
        h = lstm_forward(x, h0, Wx, Wh, b)
    else:
        raise ValueError(f"Invalid cell_type: {self.cell_type}")

    # scores
    scores = temporal_affine_forward(h, W_vocab, b_vocab)

    loss = temporal_softmax_loss(
        scores,
        captions_out,
        mask,
        verbose=False
    )

return lossrnn_forward와 lstm_forward는 모든 timestep을 처리하지만, image projection과 vocabulary classifier는 cell 종류와 관계없이 동일하다. PyTorch tensor로 계산하므로 backward 함수를 직접 작성하지 않고 autograd가 parameter gradient를 추적한다.
Test-time sampling
Inference에서는 ground-truth caption을 사용할 수 없기 때문에 한 timestep씩 생성해야 한다. 첫 입력은 batch 전체에서 <START>이고, 이후에는 직전 timestep에서 score가 가장 높은 token을 다음 입력으로 사용한다.
def sample(self, features, max_length=30):
    """
    Test-time forward pass를 수행해 입력 image feature의 caption을 생성한다.

    각 timestep에서 현재 word를 embedding하고 이전 hidden state와 함께 RNN에
    넣어 다음 hidden state를 계산한다. Hidden state를 전체 vocabulary의 score로
    변환한 다음 가장 높은 score의 word를 다음 word로 선택한다. 초기 hidden
    state는 image feature의 affine transformation으로 계산하고 첫 word로
    <START> token을 사용한다.

    Inputs:
    - features: Shape이 (N, D)인 입력 image feature이다.
    - max_length: 생성할 caption의 최대 길이 T이다.

    Returns:
    - captions: Shape이 (N, max_length)인 sampled caption이다. 각 원소는
      [0, V) 범위의 integer이다. 첫 원소는 <START>가 아니라 처음 생성한 word이다.
    """
    N = features.shape[0]
    captions = self._null * torch.ones(
        (N, max_length),
        dtype=torch.long
    )

    # Parameter 가져오기
    W_proj, b_proj = self.params["W_proj"], self.params["b_proj"]
    W_embed = self.params["W_embed"]
    Wx, Wh, b = self.params["Wx"], self.params["Wh"], self.params["b"]
    W_vocab, b_vocab = self.params["W_vocab"], self.params["b_vocab"]

    # (N, D) @ (D, H) -> (N, H)
    h = affine_forward(features, W_proj, b_proj)

    # 배치의 모든 샘플이 첫 입력으로 <START>를 사용 (N,)
    prev_word = torch.full(
        (N,),
        self._start,
        dtype=torch.long,
        device=features.device
    )

    for t in range(max_length):
        # 이전 단어 임베딩 (N,) (V, W) -> (N, W)
        x = word_embedding_forward(prev_word, W_embed)

        # RNN 1 time step 진행 (N, H)
        h = rnn_step_forward(x, h, Wx, Wh, b)

        # hidden state 를 vocab score 로 변환 (N, H) @ (H, V) -> (N, V)
        scores = affine_forward(h, W_vocab, b_vocab)

        # 가장 높은 score의 단어 선택 (N,)
        next_word = torch.argmax(scores, dim=1)

        # 저장
        captions[:, t] = next_word

        # 다음 상태 입력으로 세팅
        prev_word = next_word

    return captions
Training에서는 sequence 전체를 한 번에 처리했지만 sampling에서는 현재 예측이 다음 입력을 결정하므로 rnn_forward가 아니라 rnn_step_forward를 반복 호출한다. 이 구현은 vanilla RNN sampling path에 맞춰져 있다. LSTM sampling을 지원하려면 zero cell state를 초기화하고 매 timestep에 lstm_step_forward로 hidden state와 cell state를 함께 갱신해야 한다.
Caption 결과 확인
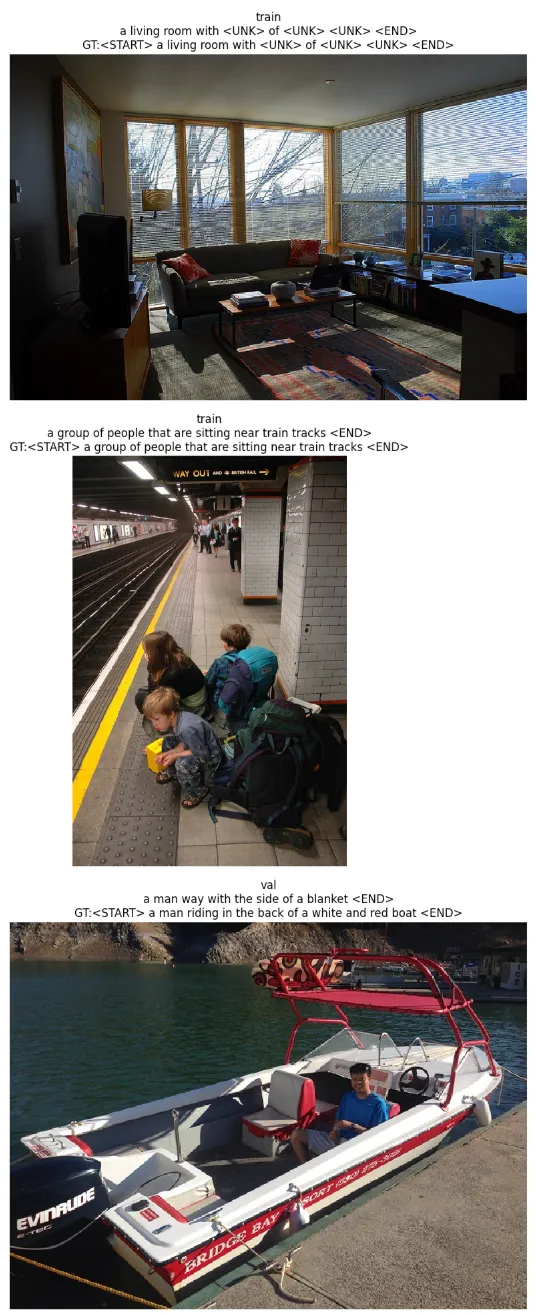
Training image에서는 장면의 큰 범주를 어느 정도 포착하지만 rare word가 <UNK>로 대체되거나 문장이 반복되는 모습이 나타난다. Validation image에서도 사람, 배, 실내와 같은 일부 시각 정보는 반영되지만 object 관계와 문장 구조가 정확하지 않은 경우가 있다.
이 결과는 image feature를 하나의 initial hidden state로 압축하는 방식, greedy decoding, 제한된 vocabulary가 함께 만드는 한계를 보여준다. 특히 torch.argmax만 사용하는 greedy decoding은 현재 timestep에서 가장 높은 score만 선택하므로 전체 문장 확률이 가장 높은 sequence를 보장하지 않는다.
추가 개념들
Character-level RNN
Word 단위 대신 character 단위로 caption을 생성하면 vocabulary 크기가 크게 줄어든다. Word-level model은 가능한 word 수가 많아 W_embed와 W_vocab의 vocabulary 관련 parameter가 커진다. Character-level model은 적은 수의 기본 문자를 조합하므로 작은 vocabulary로 새로운 word와 문자열까지 생성할 수 있다.
반면 같은 문장을 표현하는 sequence 길이 는 훨씬 길어진다. RNN은 timestep을 순서대로 처리하므로 계산 단계가 늘어나고, word보다 낮은 수준의 character 관계부터 학습해야 한다. 이 때문에 word 사이의 의미 관계와 긴 semantic dependency를 포착하기 더 어려울 수 있다.
| 구분 | 장점 | 단점 |
|---|---|---|
| Character-level | Vocabulary 관련 parameter가 작고 임의의 문자열을 조합할 수 있음 | Sequence가 길고 높은 수준의 의미 관계를 배우기 어려움 |
| Word-level | Sequence가 짧고 word 단위 의미를 직접 다룸 | Vocabulary가 크며 rare word와 unknown word 문제가 있음 |