
핵심 한 줄 정리
Attention은 query와 key의 유사도로 value를 가중합하는 연산이며, Transformer는 self-attention으로 token 사이의 정보를 섞고 FFN으로 각 token을 독립적으로 변환하는 block을 반복해 sequence를 처리한다.
중요 개념 정리
RNN encoder-decoder의 context bottleneck
Sequence-to-sequence model은 길이가 다른 두 sequence 사이의 mapping을 학습한다. 기계번역에서는 영어 문장을 입력받아 이탈리아어 문장을 출력할 수 있으며, 두 문장의 단어 수와 어순은 서로 다를 수 있다.
기본 RNN encoder-decoder는 encoder가 입력을 차례로 읽고 마지막 hidden state를 context vector 로 사용한다.
Decoder는 이전 출력 token , 이전 decoder state , context vector 를 받아 다음 state와 token을 만든다.
Encoder와 decoder는 같은 종류의 recurrent architecture를 사용할 수 있지만 parameter 와 는 서로 다르다.
문제는 길이가 얼마이든 입력 sequence 전체를 고정 길이 vector 하나로 압축해야 한다는 점이다. 가 개나 개의 float로 이루어져 있더라도 문장, 문단, 책처럼 입력이 길어질수록 정보 병목이 생긴다.
Attention은 decoder가 매 time step마다 encoder의 모든 hidden state를 다시 보고, 현재 출력에 필요한 정보를 새 context vector로 만들게 해 이 bottleneck을 완화한다.
Encoder-decoder attention
입력 문장 We see the sky를 encoder가 처리해 hidden state 를 만들었다고 하자. Decoder의 현재 state 와 각 encoder state 를 비교해 alignment score를 계산한다.
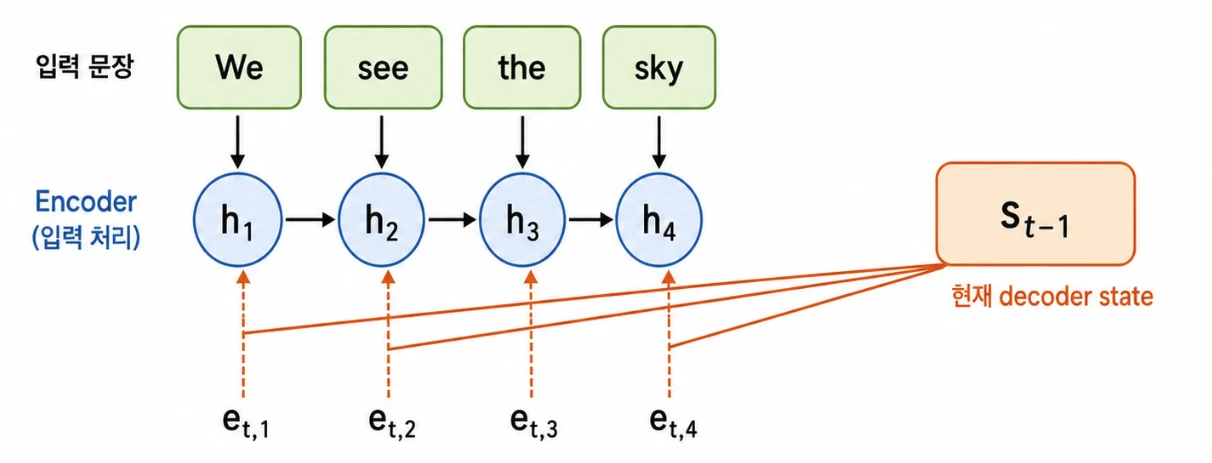
는 decoder의 번째 출력과 encoder의 번째 입력이 얼마나 관련 있는지를 나타내는 scalar이다. 가장 단순하게는 두 vector를 concatenate한 뒤 scalar를 출력하는 learnable layer를 사용할 수 있다.
Alignment score는 범위가 제한되지 않은 real number이므로 input 위치 방향으로 softmax를 적용한다.
각 decoder time step 에 대해 attention weight는 다음 조건을 만족한다.
Context vector 는 encoder hidden state의 weighted sum이다.
Decoder는 이 context vector를 이용해 다음 state와 token을 만든다.
는 RNN unit이며, vanilla RNN이나 LSTM을 사용할 수 있다.
는 고정된 하나의 vector가 아니라 decoder time step마다 새로 계산된다. 따라서 decoder는 output을 하나 만들 때마다 input sequence 전체를 다시 보고 필요한 부분을 다르게 요약할 수 있다.
예를 들어 이탈리아어 output vediamo를 만들 때는 We see에 높은 attention weight를 둘 수 있다. 관사에 해당하는 output을 만들 때는 the에 높은 weight를 둘 수 있다. 어떤 단어를 볼지는 따로 label을 주지 않으며, 최종 token prediction loss를 줄이는 과정에서 end-to-end로 학습된다.
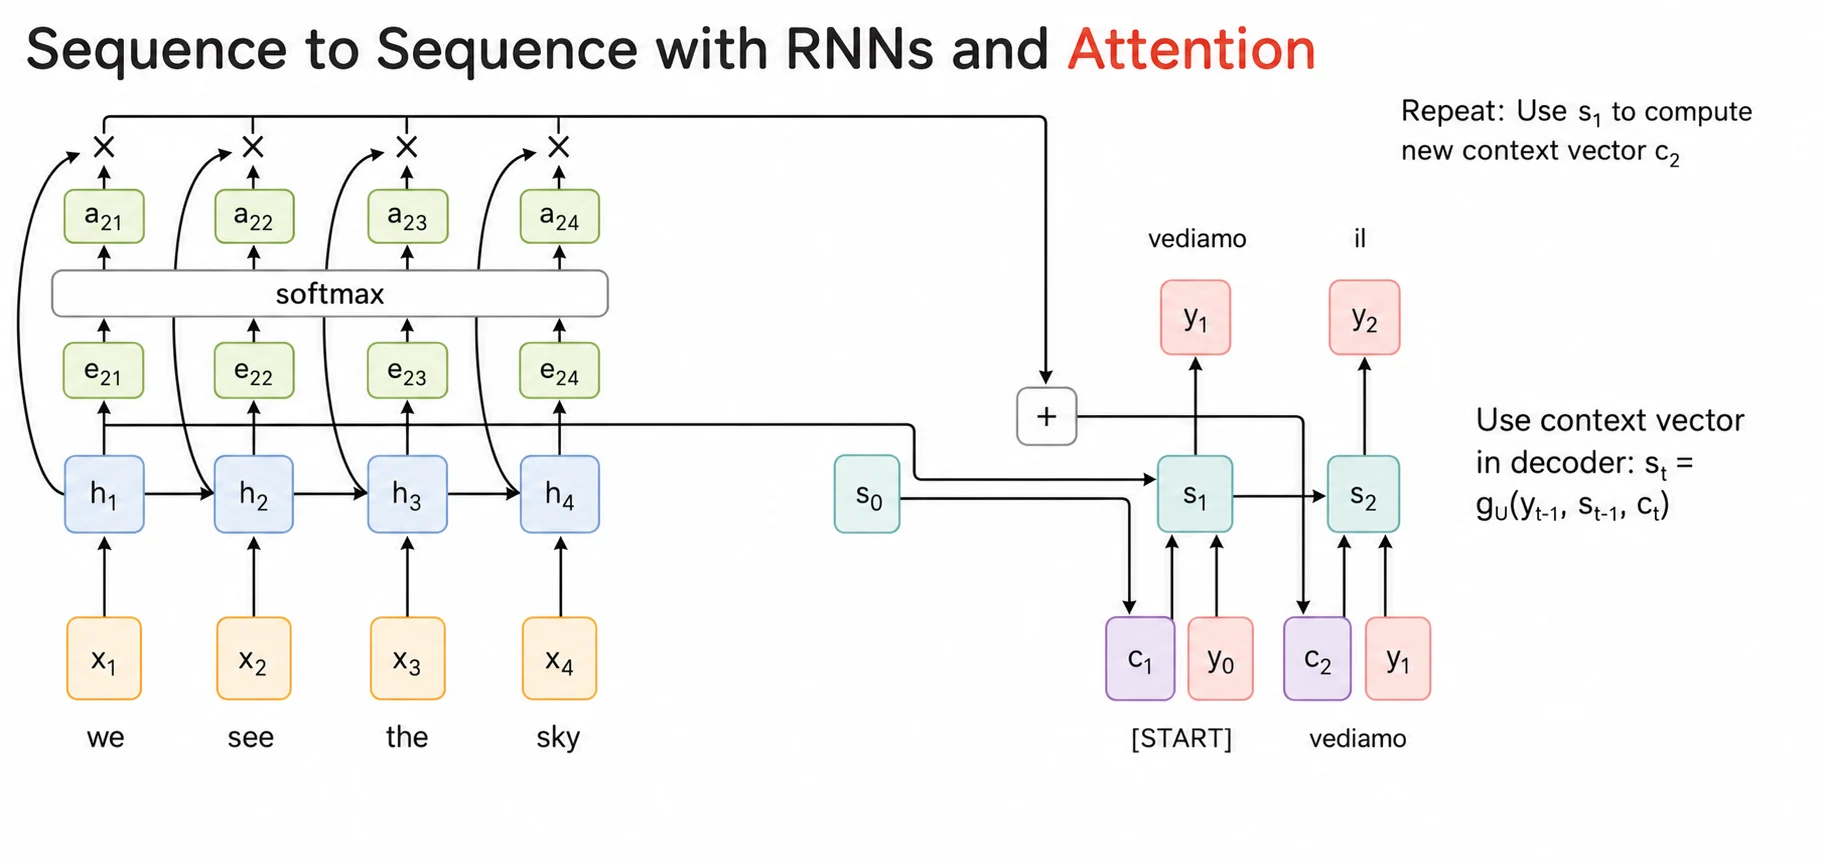
Decoder는 매 timestep마다 새로운 attention weight와 context vector를 계산하고, 이를 현재 입력 및 이전 state와 함께 사용해 다음 state와 token을 만든다.
%% title: Encoder-Decoder Attention의 Context 생성
%% caption: Decoder는 매 time step마다 현재 state를 query로 삼아 encoder state 전체의 가중합을 새로 만든다.
flowchart LR
    h1["h₁<br/>We"] --> score["Alignment Scores<br/>eₜ,ᵢ"]
    h2["h₂<br/>see"] --> score
    h3["h₃<br/>the"] --> score
    h4["h₄<br/>sky"] --> score
    state["Decoder state<br/>sₜ₋₁"] --> score
    score --> softmax["Softmax over input<br/>αₜ,ᵢ"]
    softmax --> context["Weighted Sum<br/>cₜ = Σαₜ,ᵢhᵢ"]
    context --> decoder["Decoder Step"]
    state --> decoder
    decoder --> token["Next Token yₜ"]
매우 직관적으로 설명하면, decoder time step 에서 현재 decoder state 가 encoder의 를 전부 보고 alignment score 를 만든다. 이를 softmax한 attention weight 로 들을 가중합해 context vector 를 만든다. 그리고 , , 를 사용해 와 를 만든다.
Attention map이 나타내는 것
각 output token의 attention weight를 row로 쌓으면 다음 shape의 attention map이 된다.
은 input token 수이고 은 output token 수이다. 각 row는 한 output token이 input sequence 어디를 참고했는지 나타내는 probability distribution이다.
영어 문장 The agreement on the European Economic Area was signed in August 1992를 프랑스어로 번역한 예에서는 다음 pattern이 나타났다.
- 대각선 pattern은 input과 output 단어가 같은 순서로 일대일 대응함을 나타낸다.
- 반대 방향의 대각선은 두 언어 사이의 어순이 바뀌었음을 나타낸다.
- 작은 block은 두 단어 묶음 사이에 명확한 일대일 대응이 없음을 나타낸다.
Attention map은 model이 참고한 위치를 볼 수 있게 해주지만, 그 자체가 model의 완전한 설명이나 인과 관계를 보장하는 것은 아니다. 어디에 weight를 많이 두었는지 보여주는 내부 신호로 보는 편이 정확하다.
Attention을 독립적인 연산으로 보기
RNN을 떼어내고 보면 attention은 query vector마다 data vector들을 다른 방식으로 요약하는 연산이다.
앞에서 본 encoder-decoder attention과 연결하면 각 vector는 다음과 같이 대응된다.
- Query : 현재 어떤 정보를 찾고 있는지를 나타내며, decoder state 에 해당한다.
- Data vectors : query가 참고할 정보의 집합이며, encoder states 에 해당한다.
- Output : query에 맞게 data vectors를 가중합한 결과이며, context vector 에 해당한다.
즉, decoder state 하나가 encoder states 전체를 살펴보고 현재 timestep에 필요한 정보를 context vector 하나로 요약한다.
여기서 RNN이라는 구체적인 구조를 떼어내면, attention은 하나의 query가 여러 data vectors를 참고해 query에 맞는 output 하나를 만드는 연산으로 볼 수 있다.
하나의 query 와 data vector 이 있을 때 가장 단순한 dot-product attention은 다음과 같다.
여기서 는 와 의 차원이다.
는 어떤 정보를 찾을지 정하고, 는 각 data vector를 얼마나 가져올지 정하며, 는 그 결과를 담은 query에 맞게 만들어진 요약 vector이다.
Scaled dot-product attention
Dot product는 두 vector의 유사도를 계산하는 가장 단순한 방법이지만 dimension 가 커지면 값의 크기도 커지는 문제가 있다.
와 가 평균 , 분산 인 독립적인 값이라고 가정하면 dot product는 개 항의 합이다.
이때 dot product의 분산은 대략 에 비례하고 표준편차는 에 비례한다.
Logit의 절댓값이 지나치게 커지면 softmax가 거의 one-hot처럼 포화되어 gradient가 작아진다.
이를 막기 위해 query와 key의 공통 차원 수 의 제곱근인 로 dot product를 나눈다.
이 scaling은 차원이이 커져도 score의 스케일을 비교적 일정하게 유지해 softmax의 gradient flow를 안정화한다.
여러 query를 matrix로 처리하기
개의 query와 개의 data vector를 한 번에 처리한다고 하자.
모든 query와 key 조합의 내적값은 각각 반복해서 계산하지 않고, 라는 한 번의 행렬곱으로 동시에 구할 수 있다.
각 query마다 data vector 전체에 대한 distribution이 필요하므로 마지막 axis, 즉 각 row의 개 score에 softmax를 적용한다.
각 row의 합은 이다.
Output은 attention matrix와 data matrix의 곱이다.
첫 번째 행렬곱은 모든 pair의 dot product를 계산하고, 두 번째 행렬곱은 query별 weighted sum을 계산한다.
Query, Key, Value
앞의 단순한 attention에서는 data vector 를 similarity 계산과 output weighted sum에 모두 사용했다. 두 역할을 분리하기 위해 각 data vector를 key와 value로 projection한다.
두 역할을 분리하는 이유는 어떤 data vector를 얼마나 참고할지 판단하는 정보와, 선택한 vector에서 실제로 전달할 정보가 다를 수 있기 때문이다.
Attention 분리 의 수식을 보면, X가 서로 다른 두 역할에 쓰이므로, 각각 다른 표현으로 학습할 수 있게 분리한 것으로 이해했다.
각 data vector는 Key와 Value로 각각 projection된다.
Key는 “이 위치가 어떤 정보를 가지고 있는지”를 나타내고, Value는 “그 위치에서 실제로 가져올 정보”를 나타낸다.
Query는 각 Key와 비교(유사도)되어 위치별 attention weight를 만든다.
Key는 query와 비교해 각 위치의 정보를 얼마나 참고할지 정하고, Value는 그 비율에 따라 실제로 가져올 내용을 담는다.
Shape는 다음과 같다.
Key는 query와 비교할 index 역할을 하고, value는 선택되었을 때 실제로 가져올 정보이다. 검색 과정에 비유하면 다음과 같다.
- Query: 무엇을 찾고 있는가?
- Key: 각 record가 어떤 query와 맞는가?
- Value: matching된 record에서 실제로 반환할 내용은 무엇인가?
일반적인 attention은 다음 한 식으로 정리된다.
Shape는 다음과 같이 흐른다.
와 는 사람이 key와 value의 의미를 직접 정하는 filter가 아니다. Task loss를 줄이도록 다른 parameter와 함께 gradient descent로 학습된다.
%% title: Scaled Dot-Product Attention의 Q·K·V 흐름
%% caption: Q와 K는 참조할 위치의 가중치를 만들고, 그 가중치로 V를 합성해 query별 output을 만든다.
flowchart LR
    q["Q<br/>Nq × dₖ"] --> scores["QKᵀ<br/>Nq × Nx"]
    k["K<br/>Nx × dₖ"] --> scores
    scores --> scale["÷ √dₖ<br/>+ optional mask"]
    scale --> softmax["Row-wise Softmax<br/>A: Nq × Nx"]
    softmax --> weighted["AV"]
    v["V<br/>Nx × dᵥ"] --> weighted
    weighted --> y["Y<br/>Nq × dᵥ"]
Cross-attention
Cross-attention은 query와 key/value가 서로 다른 source에서 온다.
는 query source이고 는 참고할 data source이다. Output 개수는 query 개수와 같다.
기계번역에서는 decoder state가 query가 되고 encoder state가 key와 value가 된다. Image captioning에서는 text token이 image feature를 참고할 때 cross-attention을 사용할 수 있다.
Query와 key/value가 서로 다른 입력에서 만들어지므로, 한쪽 입력이 다른 쪽 입력에서 필요한 정보를 찾아오는 작업에 적합한 구조이다.
앞에서 본 RNN 기반 seq2seq attention도 이 관점에서 보면, decoder state가 encoder states를 참고하는 cross-attention의 한 형태이다.
Self-attention
Self-attention은 query, key, value를 모두 같은 input 에서 만든다.
Projection을 거친 , , 의 shape는 다음과 같다.
강의 표기와의 대응
이 글은 query와 key의 마지막 dimension을 , value와 attention output의 마지막 dimension을 로 구분한 일반적인 표기를 사용한다. 강의에서는 세 projection의 output dimension을 하나의 으로 통일한다.
| 역할 | 이 글의 표기 | 강의 표기 |
|---|---|---|
| Input 의 마지막 dimension | ||
| Query와 Key의 마지막 dimension | ||
| Value와 output의 마지막 dimension |
따라서 강의의 single-head self-attention에서는 다음 관계가 성립한다.
까지 선택하면 input, query, key, value, output의 feature dimension이 모두 같아진다. Multi-head에서 dimension을 나누는 방식은 Multi-head self-attention에서 따로 정리한다.
각 input vector는 자기 자신을 포함한 모든 input vector를 참고해 새로운 output vector가 된다. Input과 output의 vector 개수는 모두 으로 같다.
Cross-attention에서는 한 입력이 다른 입력의 정보를 참고하지만, 하나의 sequence 내부에서도 각 input vector가 다른 input vector의 정보를 참고할 필요가 있다. Self-attention은 이를 위해 현재 input 자체를 query의 source이자 참고할 data source로 사용한다.
따라서 각 input vector를 서로 다른 역할의 , , 로 projection한다. Query는 다른 input에서 필요한 정보를 찾고, Key는 각 input과의 관련도를 계산하는 데 사용되며, Value는 실제로 전달할 정보를 담는다.
각 input vector는
: 나는 무엇을 찾을 것인가
: 나는 어떤 query와 잘 맞는가
: 나에게서 실제로 전달할 정보는 무엇인가
의 세 역할을 동시에 가진다.
RNN처럼 정보를 순차적으로 전달하지 않고 모든 input vector가 서로 직접 참고할 수 있어, 먼 위치 사이의 관계를 짧은 경로로 모델링하면서 sequence 전체를 병렬적으로 처리할 수 있다.
실제 구현에서는 , , 를 하나의 큰 matrix로 concatenate해 QKV projection을 한 번의 matrix multiplication으로 계산하는 경우가 많다. 작은 matrix multiplication 세 번보다 큰 matrix multiplication 한 번이 GPU에서 더 효율적이기 때문이다.
일반적인 , 표기에서는 shape가 다음과 같다.
강의처럼 으로 두면 다음과 같이 정리된다.
Permutation equivariance와 positional information
Self-attention 자체는 input 순서를 모른다. Input row를 permutation matrix 로 섞으면 output도 같은 방식으로 섞인다.
이 성질을 permutation equivariance라고 한다. 따라서 positional information이 없다면 self-attention은 sequence라기보다 unordered set of vectors를 처리하는 연산에 가깝다.
Language에서는 word order가 의미를 바꾸고 image에서는 patch 위치가 중요하므로 각 input에 위치 정보를 넣어야 한다. 가장 단순한 방식은 position embedding 를 token embedding에 더하는 것이다.
Position vector를 concatenate하는 방식도 가능하다.
Positional encoding이 들어간 뒤에는 같은 token이라도 어느 위치에 있는지에 따라 다른 representation을 갖는다.
Masked self-attention
일반 self-attention에서는 모든 token이 모든 token을 볼 수 있다. Autoregressive language model에서는 현재 token을 예측할 때 미래 token을 보면 정답을 미리 보는 문제가 생긴다.
Causal mask 은 미래 위치의 score를 로 바꾼다.
Softmax에서 이므로 mask된 위치의 attention weight는 이 된다.
예를 들어 input이 attention is very이고 target이 is very cool이라면 첫 output은 첫 token만 볼 수 있고, 두 번째 output은 첫 두 token만 볼 수 있다. 이 mask 덕분에 training 중 모든 위치를 병렬 계산하면서도 미래 정보를 사용하지 않는다.
Multi-head self-attention
Multi-head attention은 서로 다른 parameter를 가진 attention head를 병렬로 실행한다.
각 head의 output을 channel 방향으로 concatenate한 뒤 output projection으로 섞는다.
각 head는 같은 input을 받지만 서로 다른 weight로 초기화되고 학습되므로 서로 다른 관계를 포착할 수 있다.
Multi-head self-attention에서는 layer 바깥의 input과 output이 보통 을 유지하고, 각 head의 와 는 보통 model dimension을 head 수 로 나눈 값이 된다.
이 설정에서는 head 수가 늘어도 concatenate한 전체 dimension은 로 유지된다. 각 head가 full dimension을 갖도록 설계하면 parameter와 연산량이 늘지만, 표준 Transformer처럼 dimension을 나누면 head 수 자체가 전체 QKV parameter를 반드시 늘리지는 않는다.
전체 shape
강의 표기와 이 글의 표기는 다음과 같이 대응한다. 아래 계산에서는 기존 표기에 맞춰 과 를 사용한다.
| 강의 표기 | 이 글의 표기 |
|---|---|
개 head의 dimension을 합치면 model dimension으로 돌아온다.
Input과 fused projection matrix의 shape는 다음과 같다.
QKV projection은 하나의 큰 matrix multiplication으로 계산한다.
이 matrix multiplication의 직접적인 결과를 마지막 dimension에서 세 부분으로 split하면 projection 결과가 만들어진다.
표준 multi-head attention에서는 이므로 각 raw tensor의 마지막 dimension을 head 수 와 head dimension 로 reshape한다.
Attention 계산을 head별 batched matrix multiplication으로 처리하기 위해 head axis와 token axis를 permute한다.
따라서 attention 연산에 들어가는 tensor의 shape는 다음과 같다.
의 직접적인 결과는 가 아니라 이다. axis는 matrix multiplication에서 생기는 것이 아니라, split된 tensor의 channel dimension을 reshape하고 permute하면서 드러난다.
전체 shape 흐름은 다음과 같다.
각 head에서 의 마지막 두 axis를 transpose해 모든 token pair의 similarity를 계산한다.
각 head에서는 다음 matrix multiplication을 수행한다.
이를 개 head에 대해 batched matrix multiplication으로 동시에 처리한다.
각 query가 모든 key에 대한 distribution을 갖도록 마지막 axis에 softmax를 적용한다.
Attention weight로 Value를 가중합하면 head별 output이 만들어진다.
Head axis를 token별 channel 방향으로 합치면 다음 shape가 된다.
Token별 channel 방향이란, token 하나를 고정한 상태에서 각 head가 그 token에 대해 만든 차원 vector들을 옆으로 이어 붙이는 것이다.
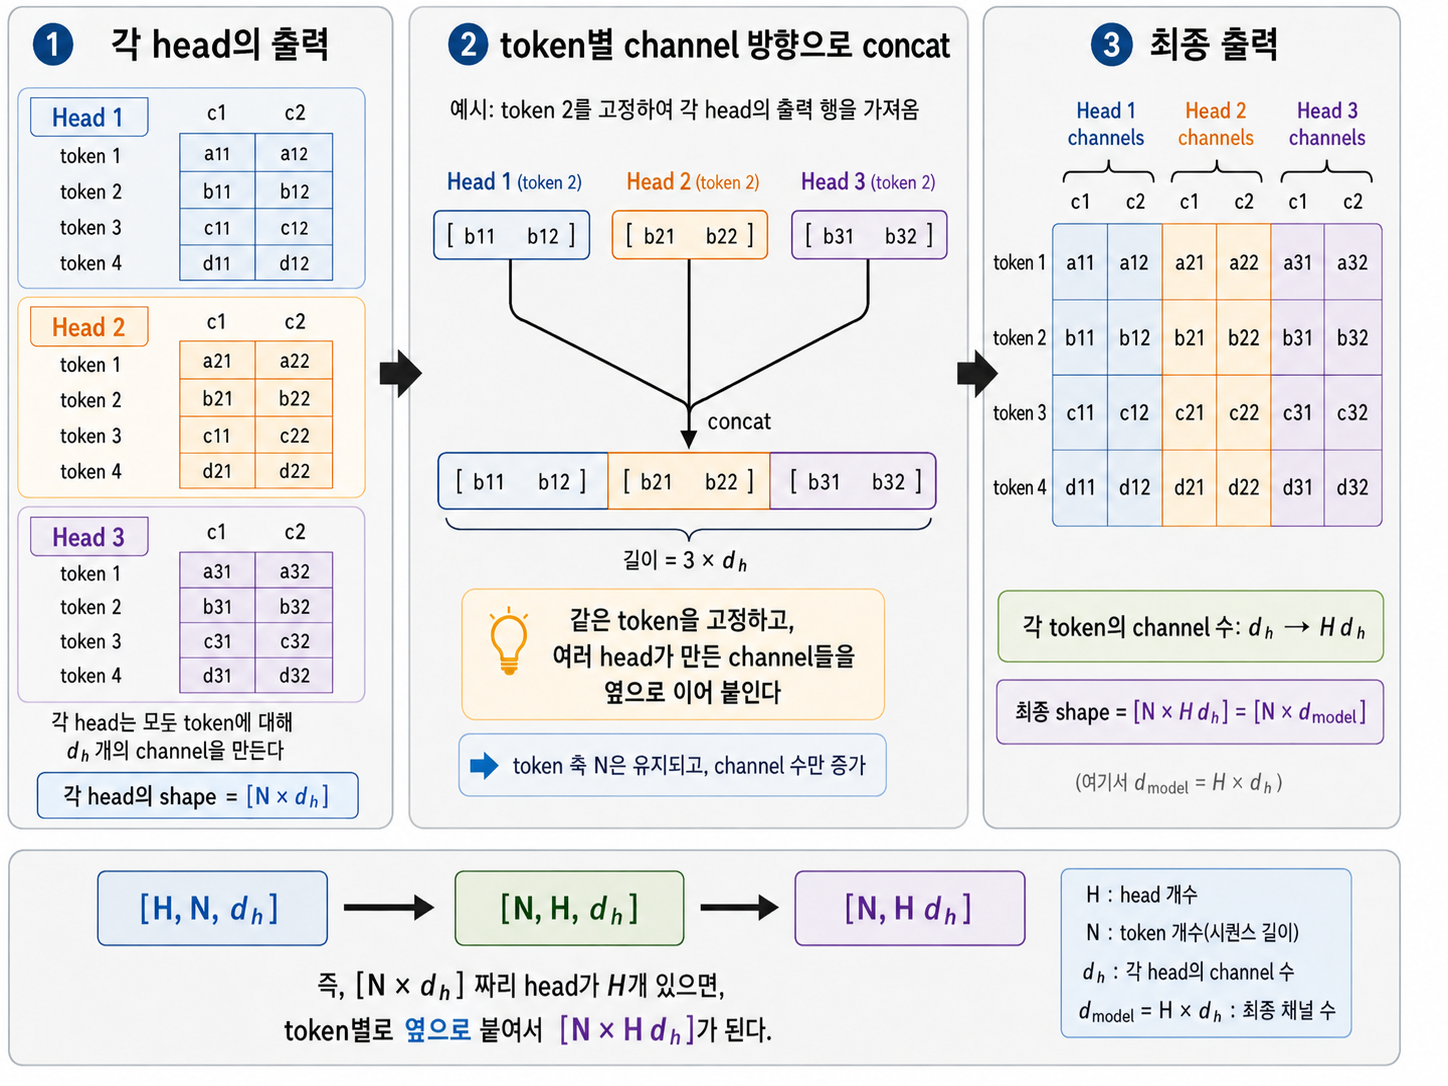
마지막으로 output projection 가 head들의 정보를 섞고 layer의 원래 dimension 로 되돌린다.
Batch dimension까지 포함하면 위 shape의 맨 앞에 가 추가된다. 예를 들어 , , 는 가 된다.
Multi-head self-attention은 크게 네 종류의 matrix multiplication으로 구현할 수 있다.
- Input에서 Q, K, V를 만드는 fused projection
- 로 similarity를 계산하는 batched matrix multiplication
- 로 weighted sum을 계산하는 batched matrix multiplication
- Head를 섞는 output projection
이 구조는 반복문 없이 GPU에서 head와 token을 병렬로 처리하기 좋다.
%% title: Multi-Head Self-Attention
%% caption: 각 head는 같은 input을 다른 QKV projection으로 보고, 결과를 concatenate한 뒤 output projection으로 다시 섞는다.
flowchart LR
    x["Input X<br/>N × d_model"] --> qkv["Fused QKV Projection"]
    qkv --> h1["Head 1<br/>Attention"]
    qkv --> h2["Head 2<br/>Attention"]
    qkv --> hh["Head H<br/>Attention"]
    h1 --> concat["Concat Heads<br/>N × d_model"]
    h2 --> concat
    hh --> concat
    concat --> wo["Output Projection Wₒ"]
    wo --> y["Output Y"]
RNN, convolution, self-attention 비교
| 연산 | 기본 구조 | 장점 | 한계 |
|---|---|---|---|
| RNN | 1차원 ordered sequence | parameter를 공유하며 가변 길이 처리 | 이전 state가 필요해 시간축 병렬화가 어려움 |
| Convolution | 차원 regular grid | local structure와 weight sharing, 높은 병렬성 | 먼 위치가 만나려면 큰 kernel이나 여러 layer가 필요함 |
| Self-attention | set of vectors | 한 layer에서 모든 vector가 상호작용하며 병렬 계산 가능 | sequence length에 대해 quadratic cost 발생 |
RNN은 가 에 의존하므로 sequence를 순서대로 처리해야 한다. Convolution은 각 위치를 병렬로 계산할 수 있지만, 한 layer가 볼 수 있는 범위는 kernel 크기로 제한된다. Self-attention은 한 layer에서 모든 token pair를 직접 연결한다.
Self-attention의 score matrix는 이다.
따라서 기본 self-attention의 compute와 attention matrix memory는 sequence length에 대해 quadratic하게 증가한다.
이 이나 처럼 커지면 큰 비용이 된다. 반면 matrix multiplication 위주라 여러 GPU와 accelerator에서 병렬화하기 쉽다는 점이 Transformer scaling의 핵심이다.
Transformer block
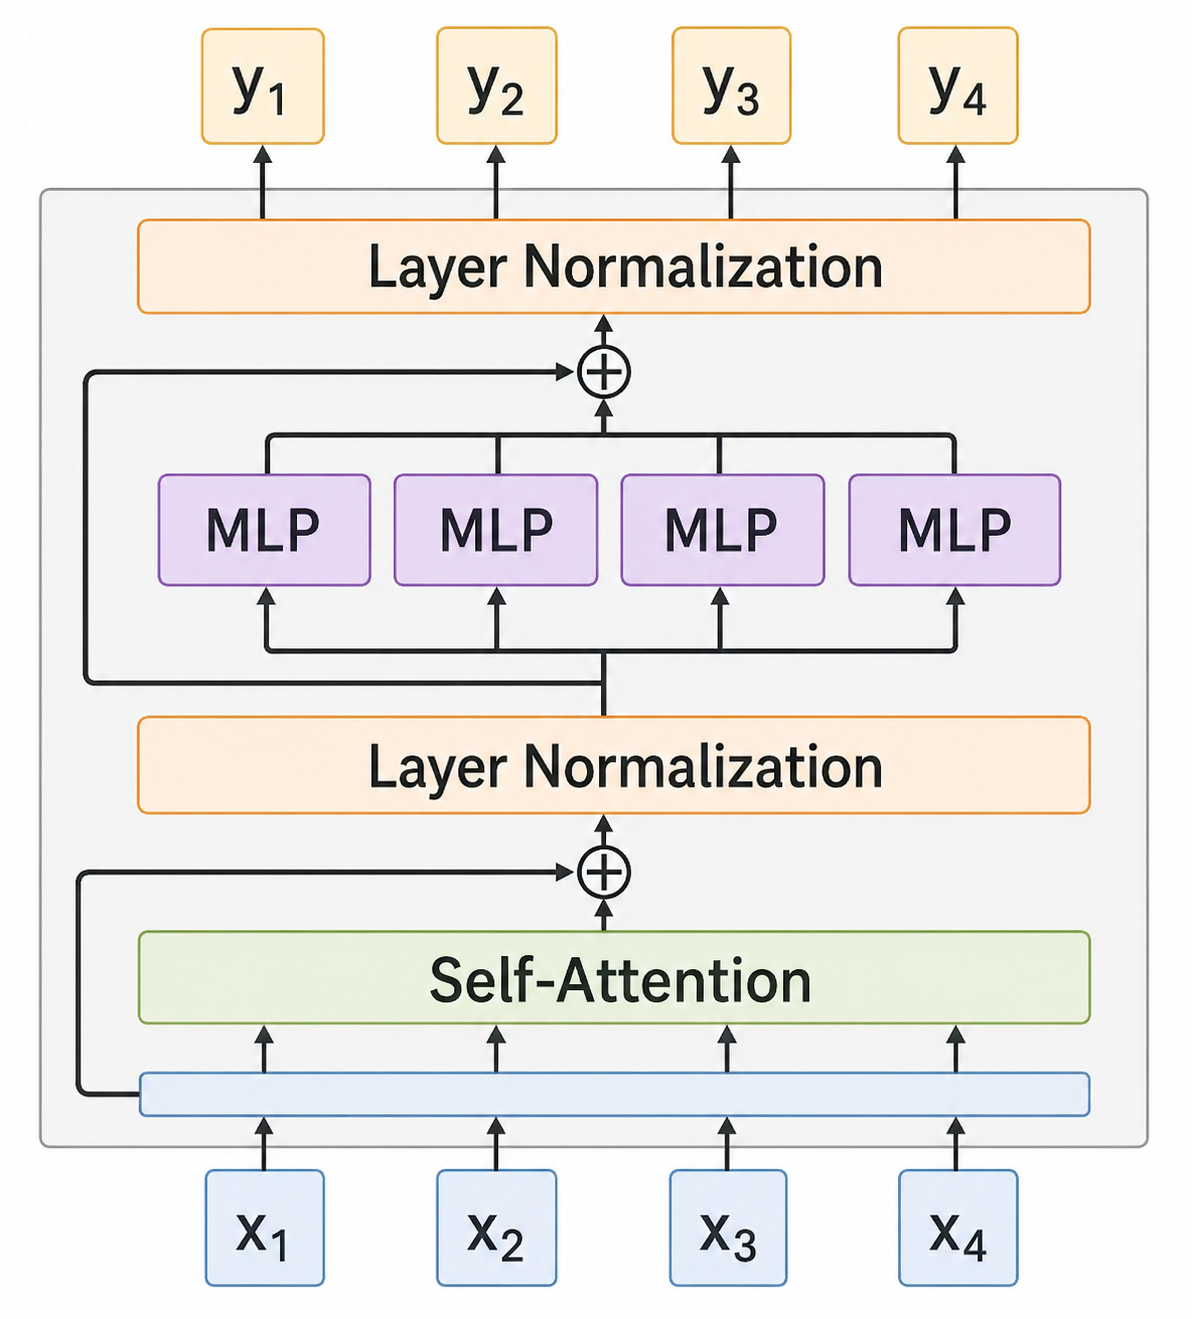
Transformer는 self-attention을 중심에 둔 architecture이다. 하나의 block은 token 사이의 정보 교환과 token별 독립 계산을 나누어 수행한다.
Self-attention sublayer
Multi-head self-attention은 각 token이 자신을 포함한 다른 token들을 참고해 새로운 representation을 만든다.
Residual connection과 LayerNorm을 적용하는 original post-norm 형태는 다음과 같다.
Residual connection은 gradient가 깊은 network를 통과하기 쉽게 하고, LayerNorm은 activation scale을 안정화한다.
Feed-forward network
Self-attention이 token 사이의 정보를 섞는다면 Feed-Forward Network, FFN은 각 token vector를 서로 독립적으로 변환한다. 모든 위치에 같은 two-layer MLP를 적용한다.
는 ReLU나 GELU 같은 nonlinearity이다. 각 token에 같은 FFN weight를 쓰지만 token끼리 FFN 안에서 직접 섞이지는 않는다.
여기서 fully connected layer는 token 사이를 연결하는 것이 아니라, 각 token 내부의 feature를 변환한다. Token vector를 row로 배치한 input이 다음과 같다고 하자.
첫 번째 linear transformation은 feature dimension을 에서 로 확장한다.
두 번째 linear transformation은 feature dimension을 다시 로 되돌린다.
두 연산에서 token 수 은 변하지 않으며 모든 token이 같은 , 를 공유한다. 직관적으로 Attention은 다른 token에서 정보를 받아오고, MLP는 각 token이 받아온 정보를 자신의 feature 안에서 계산하는 과정으로 볼 수 있다.
두 번째 residual connection과 LayerNorm을 적용하면 block output이 된다.
전체 흐름은 다음과 같다.
Transformer는 이 block을 여러 번 쌓은 network이다. 2017년 초기 Transformer 계열은 encoder와 decoder를 합해 약 12개 block을 사용했고, 큰 configuration은 약 2억 parameter 규모였다. 이후 같은 기본 구조를 수백 개 block과 훨씬 많은 parameter로 확장할 수 있었다.
최근 model에서는 LayerNorm을 sublayer 앞에 두는 pre-norm 형태도 자주 사용한다.
Post-norm과 pre-norm은 같은 부품을 사용하지만 normalization 위치가 다르며, 매우 깊은 model에서는 optimization 특성이 달라진다.
%% title: Transformer Block의 두 Sublayer
%% caption: Self-attention은 token 사이의 정보를 섞고, FFN은 각 token을 독립적으로 변환한다. 두 sublayer 모두 residual path와 normalization을 갖는다.
flowchart LR
    x["Input X"] --> mha["Multi-Head<br/>Self-Attention"]
    x --> add1(("+"))
    mha --> add1
    add1 --> norm1["LayerNorm"]
    norm1 --> ffn["Feed-Forward<br/>Network"]
    norm1 --> add2(("+"))
    ffn --> add2
    add2 --> norm2["LayerNorm"]
    norm2 --> y["Block Output Y"]
Vision Transformer
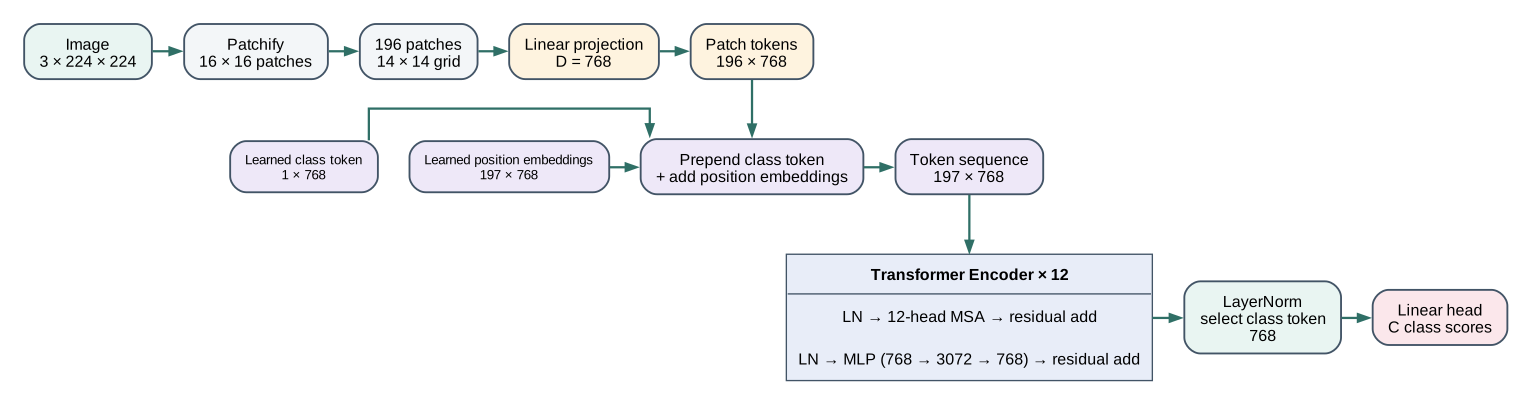
Transformer는 language뿐 아니라 image에도 사용할 수 있다. Image를 작은 patch로 나누고 각 patch를 하나의 vector로 projection하면 token sequence처럼 처리할 수 있다.
Image shape가 이고 patch size가 이면 patch 수는 다음과 같다.
각 patch를 flatten하면 dimension은 이다.
Linear projection을 적용해 Transformer input dimension으로 바꾼다.
Transformer는 input patch마다 output vector 하나를 만든다. Image classification에서는 모든 output을 pooling한 뒤 linear classifier로 class score를 계산할 수 있다.
별도의 class token을 sequence에 추가하고 그 output만 classifier에 사용하는 방식도 있다. 핵심은 image를 patch vector의 집합으로 바꿔 language token과 같은 Transformer block으로 처리한다는 점이다.
Attention과 Transformer의 큰 흐름
Attention의 발전을 연산 관점에서 보면 다음과 같다.
- RNN encoder가 입력 전체를 context vector 하나로 압축하면서 정보 병목이 생겼다.
- Decoder step마다 encoder state의 weighted sum을 다시 계산해 필요한 입력을 직접 보게 했다.
- 이 weighted retrieval을 query, key, value로 일반화해 독립적인 attention layer로 만들었다.
- Query, key, value를 같은 input에서 만들면서 self-attention이 되었다.
- 여러 self-attention head와 FFN, residual connection, LayerNorm을 묶어 Transformer block을 만들었다.
- Input을 vector 집합으로 표현할 수 있다면 text, image, audio 등 서로 다른 data에도 같은 구조를 적용할 수 있게 되었다.
Transformer의 성능을 self-attention 하나만으로 설명하기는 어렵다고 느꼈다. Self-attention은 토큰 간 정보를 직접 교환하며 문맥을 구성하고, FFN은 각 토큰의 표현을 독립적으로 비선형 변환한다.
여기에 residual connection과 normalization이 깊은 네트워크를 안정적으로 학습할 수 있도록 돕고, 연산 대부분을 행렬 연산으로 처리하기 때문에 높은 병렬 처리 효율을 얻을 수 있다.
Transformer의 강점은 이러한 구성 요소들이 서로 다른 역할을 맡으면서 반복적으로 결합된다는 데 있다고 이해했다.
과제에서 확인할 것
Scaled dot-product attention의 shape
다음 matrix multiplication의 shape를 순서대로 확인한다.
Output row 수는 query 수이고 output dimension은 value dimension이다.
Softmax axis
각 query가 모든 key에 대해 하나의 distribution을 가져야 한다. Standard row-major notation에서는 score matrix의 마지막 axis에 softmax를 적용한다.
Axis를 잘못 지정하면 각 key에 대해 query가 합쳐지는 전혀 다른 연산이 된다.
Scaling과 mask의 적용 순서
Score를 로 나눈 뒤 mask를 더하고 softmax를 적용한다.
Mask를 softmax 뒤에 단순히 곱하면 row sum이 더 이상 이 아닐 수 있다. Mask된 위치의 logit을 로 만든 뒤 softmax를 적용하는 이유이다.
Multi-head reshape
Input을 Q, K, V로 projection한 뒤 head dimension을 분리하고, attention을 계산한 뒤 다시 합쳐야 한다.
Transpose 순서를 잘못 지정하면 token axis와 head axis가 섞일 수 있으므로 각 단계의 shape를 출력해 확인하는 것이 좋다.
Positional encoding의 필요성
Positional encoding이 없는 self-attention에 permutation을 적용했을 때 output도 같은 방식으로 permutation되는지 확인한다.
이 실험은 self-attention만으로는 word order나 patch position을 알 수 없는 이유를 직접 보여준다.
Residual connection의 shape
Residual addition을 하려면 sublayer input과 output shape가 같아야 한다.
와 가 head마다 작더라도 concatenate와 output projection을 거친 최종 MHA output은 로 돌아와야 한다.
Attention map 확인
Attention matrix의 row sum이 인지, causal mask 위쪽 영역이 인지 확인한다. 간단한 token sequence에서 특정 query가 어느 key에 높은 weight를 두는지도 시각화해 보면 Q, K, V의 역할을 이해하기 쉽다.
추가로 읽어볼 내용
- Pre-Norm: normalization을 residual branch 안쪽으로 옮겨 attention이나 FFN을 적용하기 전에 수행하는 구조이다.
- RMSNorm: 평균을 빼는 과정 없이 activation의 RMS를 이용해 scale을 정규화하는 LayerNorm의 대안이다.
- SwiGLU: Swish 계열 activation과 gating을 결합한 MLP 구조이다.
- Mixture of Experts, MoE: 서로 다른 MLP expert를 개 학습하고, 각 token에는 그중 개만 선택해 적용하는 구조이다. 이때 이며, token당 연산량은 비교적 적게 늘리면서 전체 parameter 수를 크게 확장할 수 있다.