
핵심 한 줄 정리
Video understanding은 image에 time dimension을 더한 spatiotemporal data에서 appearance와 motion을 함께 표현하는 문제이며, frame pooling부터 3D CNN, optical flow 기반 two-stream network, recurrent model, space-time attention까지의 차이는 결국 temporal information을 언제 어떻게 결합하느냐에 있다.
중요 개념 정리
Video는 space와 time을 함께 가진 tensor이다
RGB image 한 장은 일반적으로 다음과 같이 표현한다.
Video는 여기에 frame을 나타내는 temporal dimension 가 추가된다.
와 는 spatial resolution이고, 는 시간 순서대로 놓인 frame 수이다. 따라서 video는 image의 단순한 집합이 아니라 시간 순서를 가진 spatiotemporal volume으로 볼 수 있다.
Image classification이 scene이나 object의 identity를 주로 예측한다면, video classification은 사람이 running, swimming, jumping 중 어떤 action을 수행하는지처럼 시간 변화가 중요한 label을 예측하는 경우가 많다.
Video classifier가 개 action class에 대한 score를 출력한다고 하면 전체 구조는 다음과 같다.
분류 loss 자체는 image classification과 같은 softmax cross-entropy를 사용할 수 있다. Video understanding의 핵심 문제는 loss보다 video에서 appearance와 motion을 보존하는 feature 를 어떻게 만들 것인지에 있다.
Video data가 큰 이유
Video는 spatial resolution뿐 아니라 frame rate만큼 data가 반복된다. 예를 들어 초당 30 frame의 video는 1초마다 image 30장을 저장해야 한다.
비압축 data를 가정한 대략적인 예시는 다음과 같다.
- Standard-definition video는 분당 약 가 필요할 수 있다.
- resolution의 video는 분당 약 까지 커질 수 있다.
실제 학습에서는 input뿐 아니라 parameter, activation, gradient도 accelerator memory에 저장해야 한다. 따라서 긴 고해상도 video 전체를 한 번에 model에 넣는 방식은 현실적이지 않다.
가장 기본적인 해결책은 spatial dimension과 temporal dimension을 모두 줄이는 것이다. 예를 들어 초 video에서 초당 5 frame만 사용하고 resolution을 로 줄이면 input을 약 까지 축소할 수 있다.
이 과정은 계산량을 줄이는 대신 다음 정보를 잃을 수 있다.
- 낮은 spatial resolution으로 인한 작은 object와 세부 texture 손실
- 낮은 frame rate로 인한 빠른 motion 손실
- 짧은 clip으로 인한 long-term context 손실
Video model의 성능과 효율은 architecture뿐 아니라 어떤 resolution, frame rate, clip length를 선택했는지에도 크게 영향을 받는다.
Sports-1M처럼 web video URL 목록으로 배포한 dataset은 원본 video가 삭제되거나 변경되면 dataset 자체가 불완전해질 수 있다. Video dataset은 image dataset보다 저장과 재현성 관리도 어렵다.
Clip 단위 학습과 video 단위 추론
몇 분 또는 몇 시간짜리 video는 일정 길이의 짧은 clip으로 나누어 처리한다. 하나의 clip이 개 frame을 포함한다면 training input은 다음과 같다.
Training에서는 긴 video에서 여러 clip을 sliding window 또는 random sampling으로 뽑아 clip classifier를 학습한다. 초기 3D CNN 계열은 보통 16개 또는 32개 frame처럼 고정된 길이의 clip을 입력받았다.
Inference에서는 긴 video에서 여러 clip을 sampling한 뒤 prediction을 평균할 수 있다. 개 clip의 class score 또는 probability를 이라고 하면 video-level prediction은 다음과 같이 만들 수 있다.
예를 들어 10개 clip의 prediction을 평균해 video-level prediction을 만들 수 있다. 다만 균일하거나 무작위로 sampling하면 중요한 action 구간을 놓칠 수 있다. 긴 video에서는 다음 frame이나 clip을 어디서 볼지 model이 결정하는 adaptive sampling도 사용할 수 있다.
Single-frame CNN은 중요한 baseline이다
가장 단순한 video classifier는 sampled frame마다 image CNN을 독립적으로 적용하는 방식이다.
는 번째 frame이고, 는 해당 frame의 feature 또는 class score이다. Frame별 score를 평균하면 video prediction을 얻을 수 있다.
이 방법은 frame의 순서를 사용하지 않으므로 명시적인 motion representation을 학습하지 못한다. 그럼에도 running처럼 한 frame의 자세와 scene만으로도 추측할 수 있는 action에서는 강한 baseline이 된다.
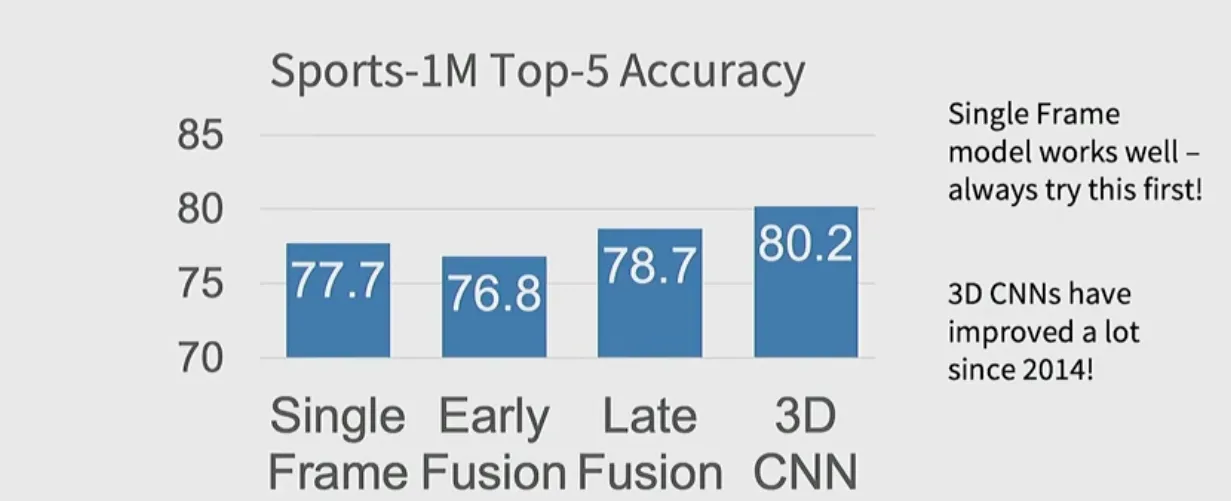
Sports-1M에서 single-frame model은 487개 sports category에 대해 video-level Top-5 accuracy 77.7%를 기록하였다. 시간 정보를 convolution에 점진적으로 결합한 Slow Fusion model도 80.2%로, 향상 폭은 약 2.5 percentage points에 그쳤다. 따라서 video model이라고 해서 static frame baseline보다 자동으로 큰 이득을 얻는 것은 아니며, 강한 frame baseline과 먼저 비교할 필요가 있다. (Karpathy, A. et al. Large-scale Video Classification with Convolutional Neural Networks. CVPR, 2014.)
Temporal information을 결합하는 세 가지 시점
Frame별 feature를 시간 축에서 언제 합치는지에 따라 early fusion, late fusion, slow fusion으로 구분할 수 있다.
| 방식 | Temporal fusion 시점 | 장점 | 한계 |
|---|---|---|---|
| Late fusion | network의 끝부분 | 기존 2D CNN을 그대로 활용하기 쉽다 | low-level motion이 깊은 feature에서 사라질 수 있다 |
| Early fusion | 첫 layer | raw frame에 가까운 motion을 바로 볼 수 있다 | 시간 정보를 한 layer에서 모두 압축한다 |
| Slow fusion | 여러 layer에 걸쳐 점진적으로 | local motion부터 long-term pattern까지 계층적으로 표현한다 | 3D operation 때문에 계산량이 크다 |
Late fusion
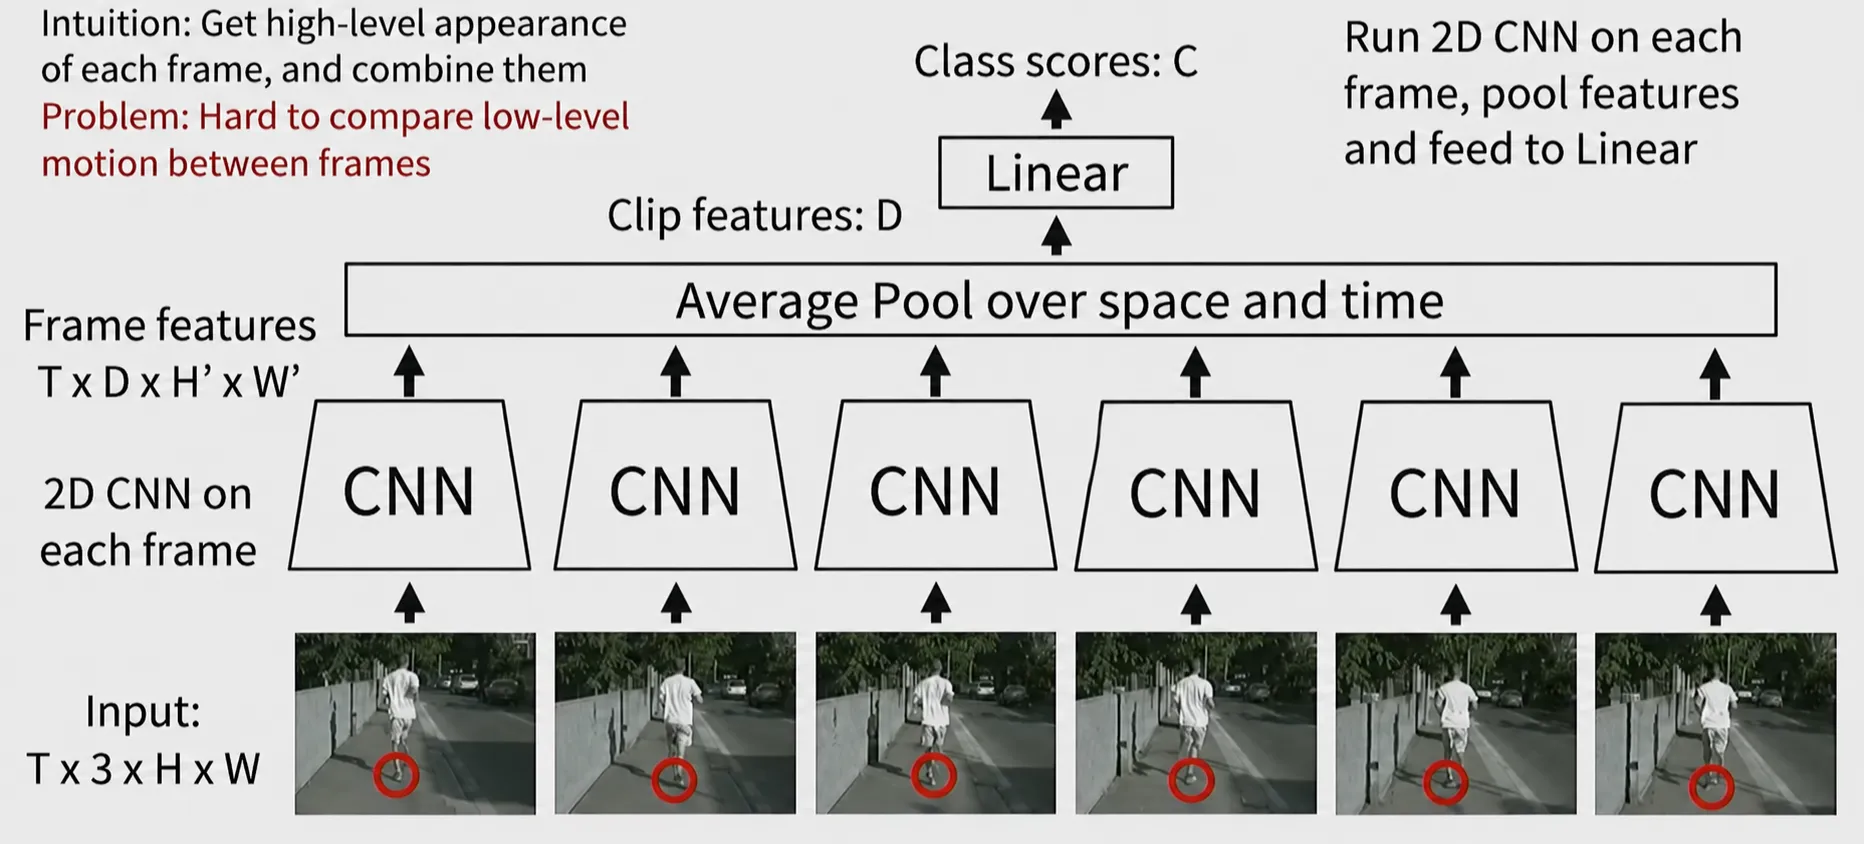
개 frame을 각각 2D CNN에 넣어 다음 feature map을 얻는다고 하자.
Feature map을 flatten한 뒤 전부 concatenate하면 feature dimension이 에 비례해 커진다.
이 vector를 MLP에 넣으면 시간 정보를 late stage에서 결합할 수 있지만, 큰 fully connected layer가 필요해 parameter가 많아진다.
더 간단한 방법은 temporal mean pooling 또는 max pooling이다.
Pooling을 사용하면 가 아니라 dimension을 유지할 수 있다. 대신 frame 순서와 순간적인 변화가 사라지고, 중요한 frame의 정보가 평균에 묻힐 수 있다.
Late fusion의 더 근본적인 한계는 각 frame을 깊은 2D CNN으로 독립 처리한 뒤에야 temporal interaction을 만든다는 점이다. 예를 들어 달리는 사람의 발이 위아래로 움직이는 패턴은 raw frame에서는 분명하지만, high-level semantic feature만 남은 뒤에는 해당 low-level motion cue가 약해질 수 있다.
Early fusion
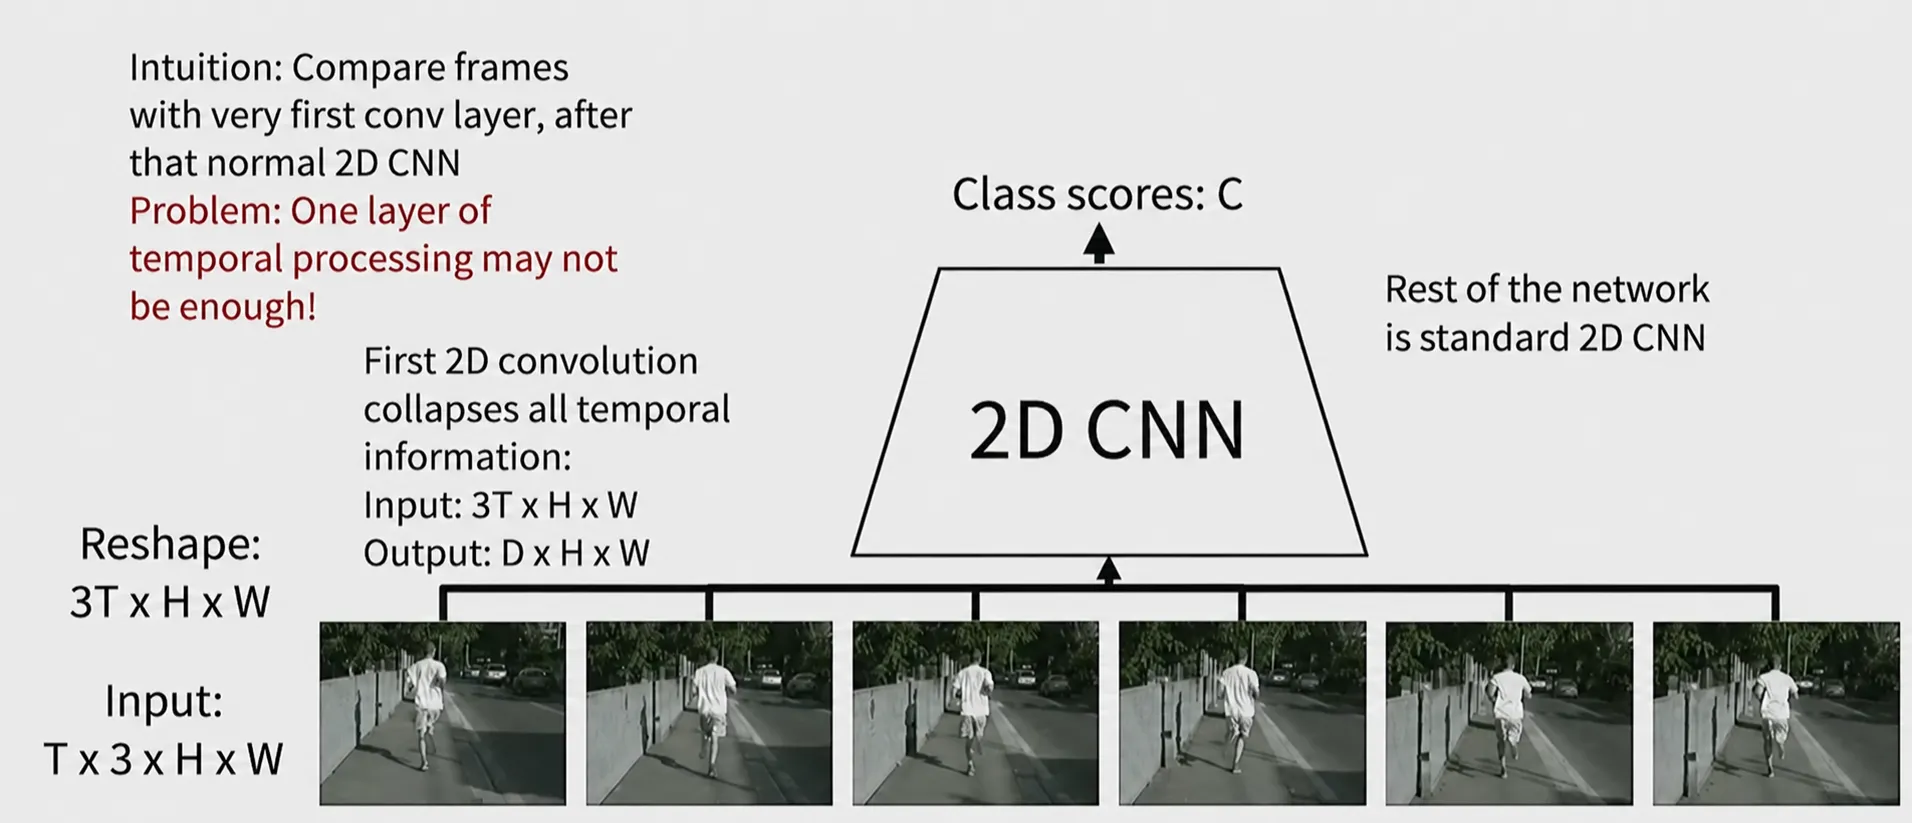
Early fusion은 개 RGB frame을 channel dimension으로 합친다.
첫 2D convolution이 channel 전체를 받아 개의 feature map으로 바꾼다.
Raw frame에 가까운 단계에서 motion을 볼 수 있지만, 첫 layer가 모든 temporal information을 한 번에 collapse한다. 또한 kernel이 특정 시간 위치 전체에 연결되므로 같은 motion이 다른 시점에 나타났을 때 동일한 filter를 재사용하기 어렵다.
Slow fusion
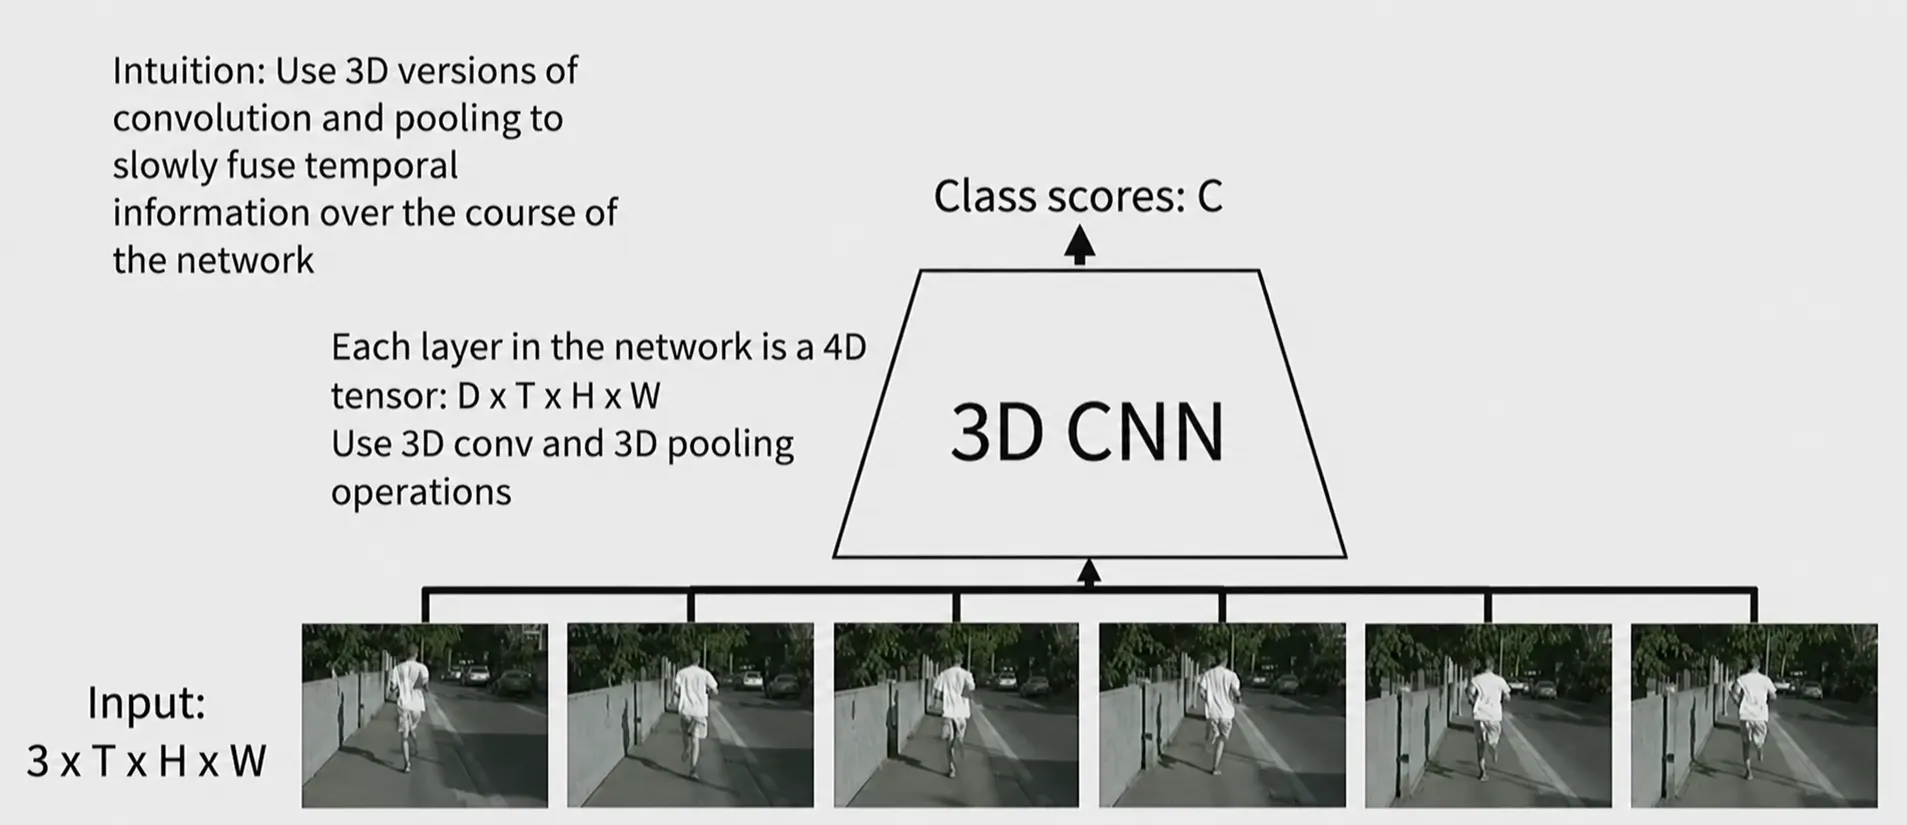
Slow fusion은 local temporal window를 보는 layer를 여러 단계 쌓아 temporal receptive field를 점진적으로 키운다. 대표적인 구현이 3D CNN이다.
낮은 layer는 짧은 구간의 local motion을 포착하고, 깊은 layer는 여러 local pattern을 조합해 더 긴 action structure를 표현한다.
%% title: Temporal Fusion을 적용하는 시점
%% caption: Early fusion은 첫 layer에서 frame 정보를 한꺼번에 결합하고, late fusion은 frame별 feature를 독립적으로 추출한 뒤 마지막에 합친다. Slow fusion은 여러 layer에 걸쳐 temporal information을 점진적으로 통합한다.

flowchart TB
    clip["Video Frames<br/>T × 3 × H × W"]

    clip --> earlyreshape["Reshape<br/>3T × H × W"]
    earlyreshape --> earlyfusion["Early Fusion<br/>First convolution"]
    earlyfusion --> earlynet["Standard 2D CNN"]

    clip --> latecnn["Frame-wise 2D CNN<br/>T × D"]
    latecnn --> late["Late Fusion<br/>Concatenate / Pool"]
    late --> latehead["Classifier"]

    clip --> slow1["3D Conv / Pool<br/>Temporal dimension preserved"]
    slow1 --> slow2["3D Conv / Pool<br/>Temporal information gradually fused"]
    slow2 --> slow3["Video Representation"]

    earlynet --> prediction["Video Prediction"]
    latehead --> prediction
    slow3 --> prediction
3D convolution
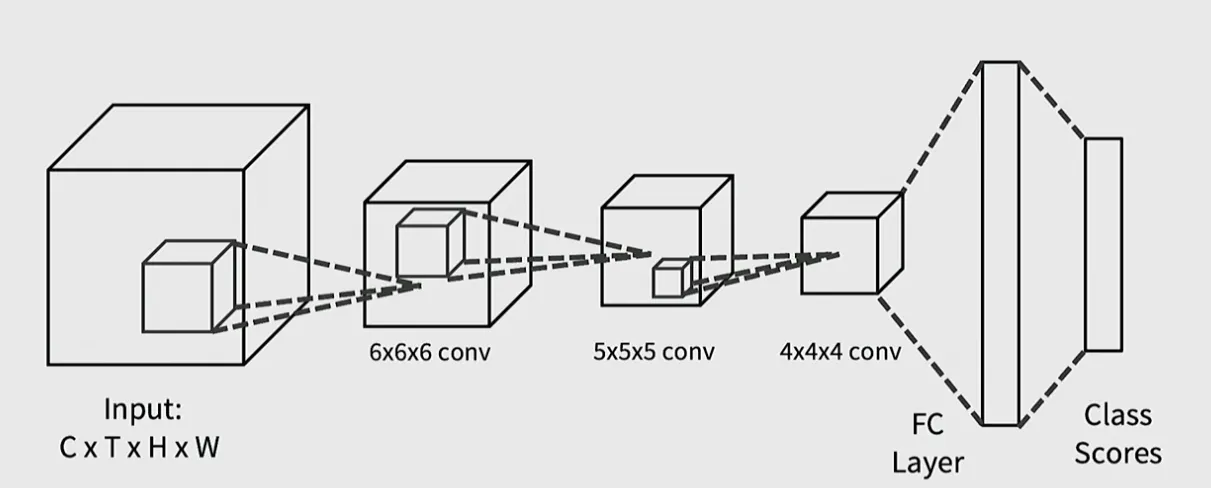
2D convolution kernel은 spatial dimension 를 따라 움직이면서 input channel 전체를 본다. 3D convolution은 여기에 temporal kernel size 를 추가한다.
Input과 output shape는 다음과 같다.
하나의 output은 local space-time volume에 대한 weighted sum이다.
Padding을 제외한 temporal output size는 다음과 같다.
는 temporal padding, 는 temporal stride이다. Spatial output size도 같은 방식으로 계산한다.
3D kernel은 전체가 아니라 짧은 frame만 보고 시간 축을 따라 slide한다. 따라서 같은 motion pattern이 clip의 어느 시점에 나타나더라도 같은 weight로 감지할 수 있다. 이것이 temporal shift invariance이다.
직관적으로 3D Conv는 같은 짧은 동작 탐지기를 시간축 전체에 재사용하기 때문에, 동작이 언제 나타나는지와 무관하게 같은 패턴으로 감지할 수 있다.
예를 들어 early fusion이 전체를 하나의 kernel로 보면 4번째 frame의 blue → orange 변화와 15번째 frame의 같은 변화를 서로 다른 위치의 weight가 처리한다. 반면 인 3D kernel은 같은 local transition filter를 모든 시점에 재사용한다.
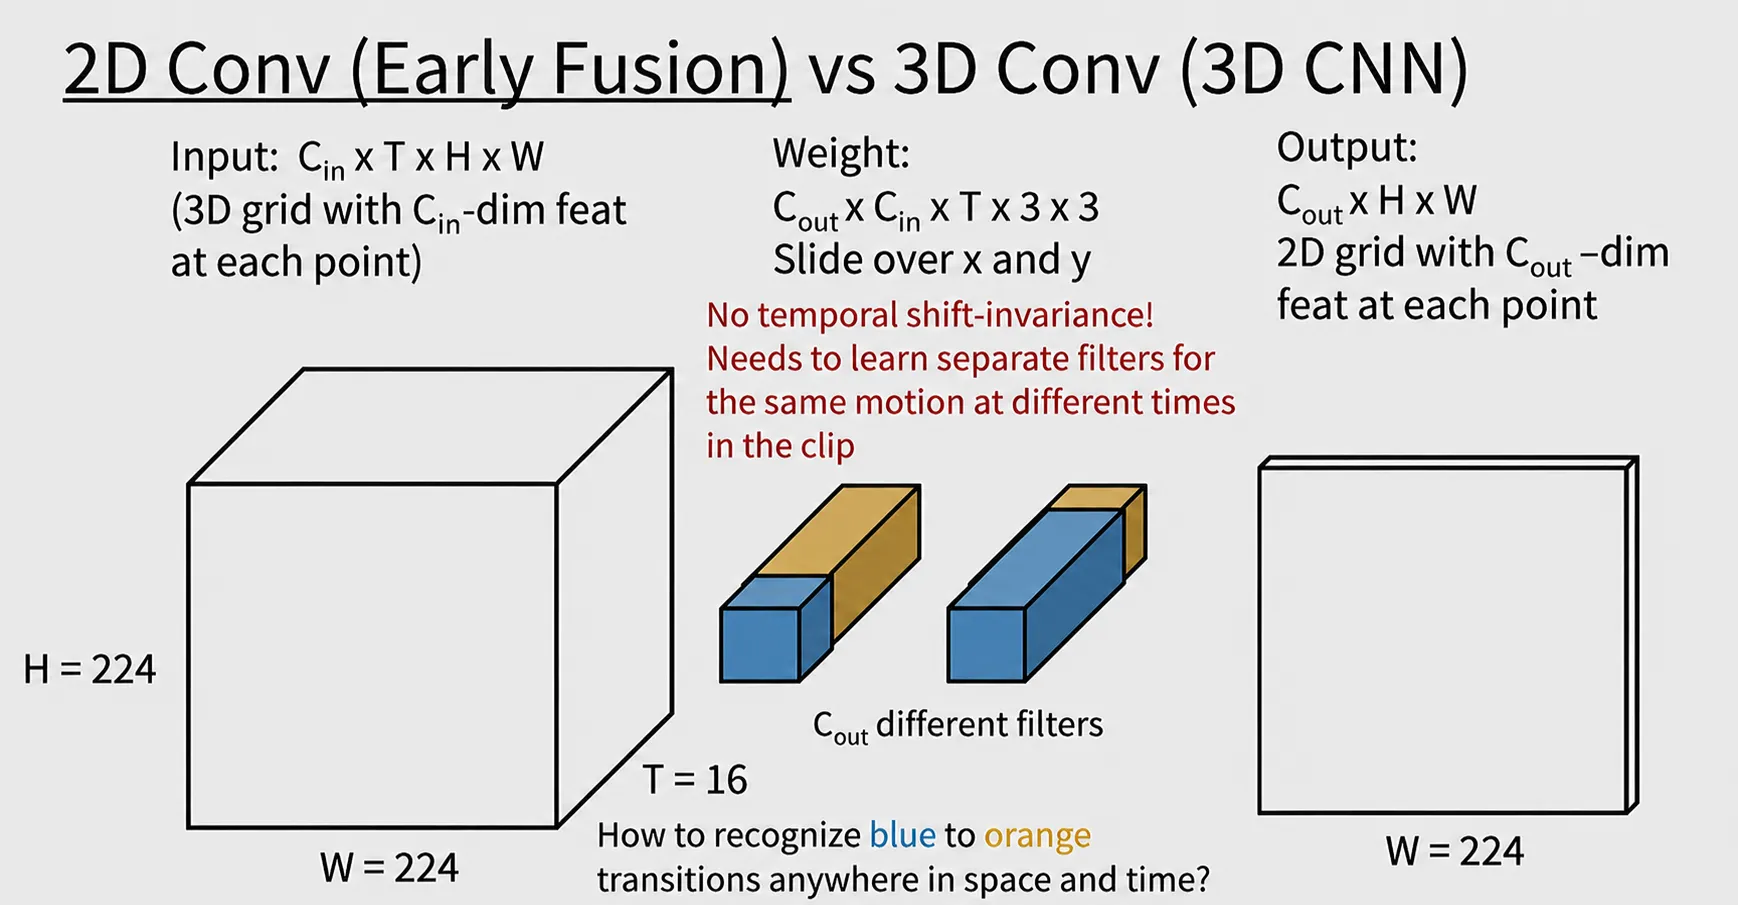
Early Fusion 2D Conv는 모든 frame을 처음부터 하나로 합쳐 처리하므로 시간축으로 kernel이 이동하지 않는다. 따라서 같은 motion이 다른 시점에 나타나면 서로 다른 weight가 대응하게 되어 temporal shift invariance를 갖기 어렵다.
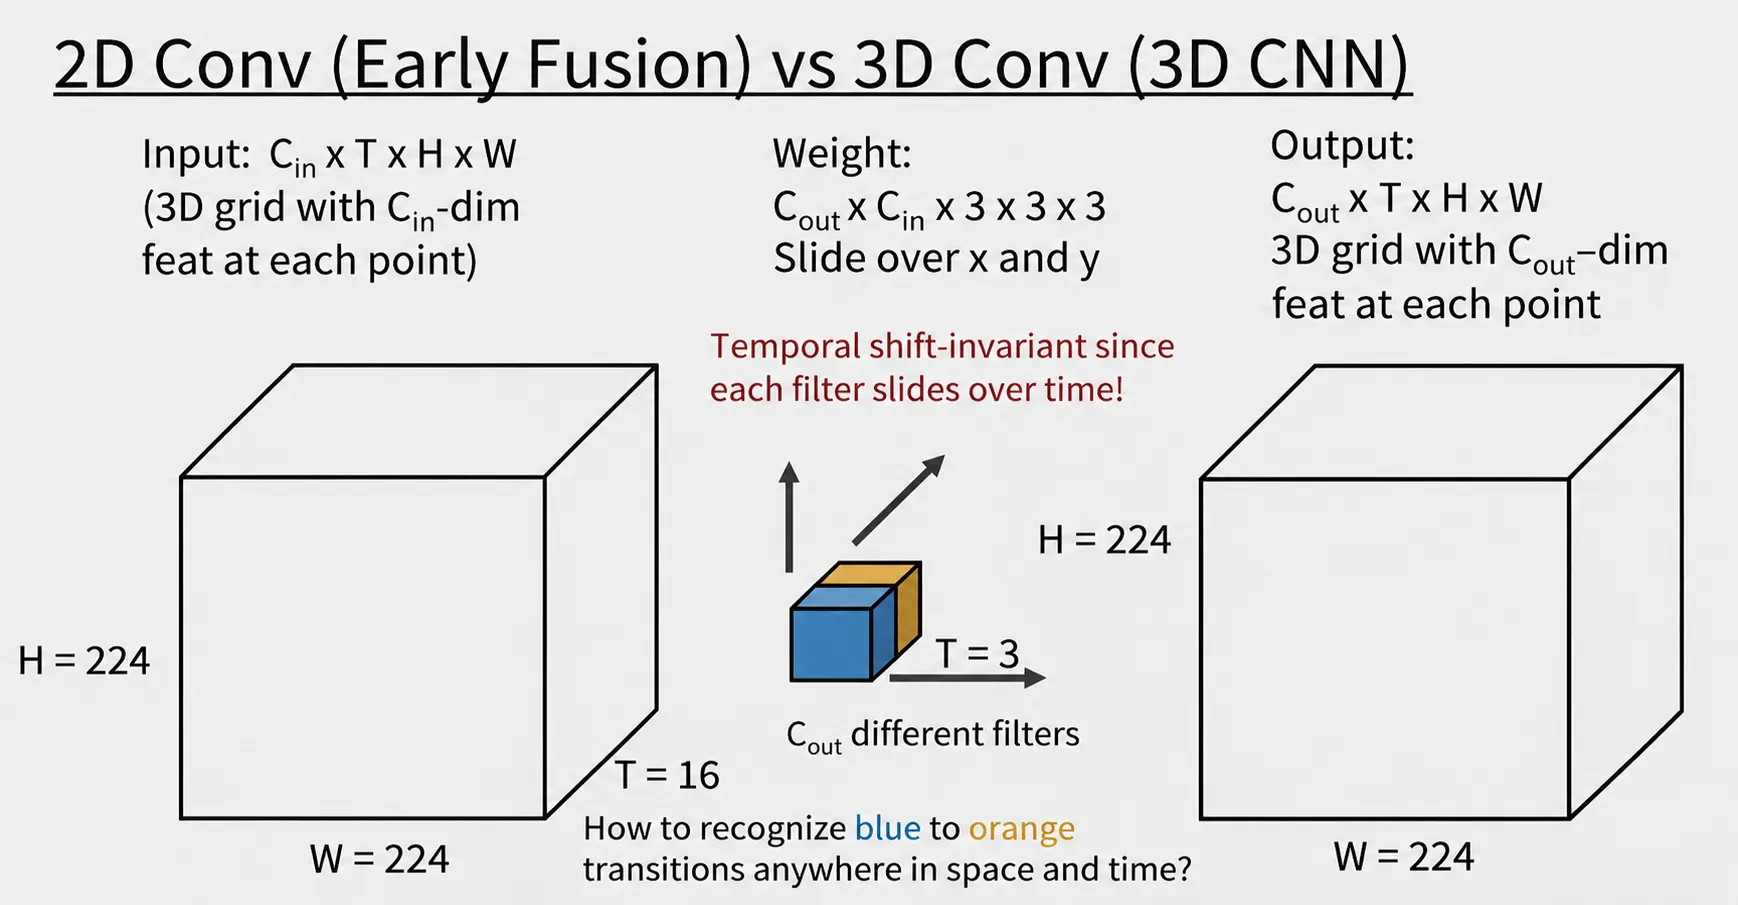
3D Conv는 짧은 frame 구간만 보는 3D kernel을 시간·높이·너비 방향으로 이동시킨다. 따라서 같은 motion이 어느 시점에 나타나더라도 동일한 weight로 감지할 수 있고, 시간 정보도 feature map에 유지된다.
title: Toy 3D CNN의 Space-Time Feature 구조
caption: Shape는 N × C × T × H × W 순서이다. Conv3d는 K3×3×3 / S1 / P1, MaxPool3d는 K2×2×2 / S2를 사용하며, 실제 forward pass에서 각 module의 input과 output shape를 기록한 그래프이다.
source: /blog-assets/deep-learning/cs231n/lecture-10/toy-3d-cnn-torchview.svg
Receptive field로 비교하는 fusion 방식
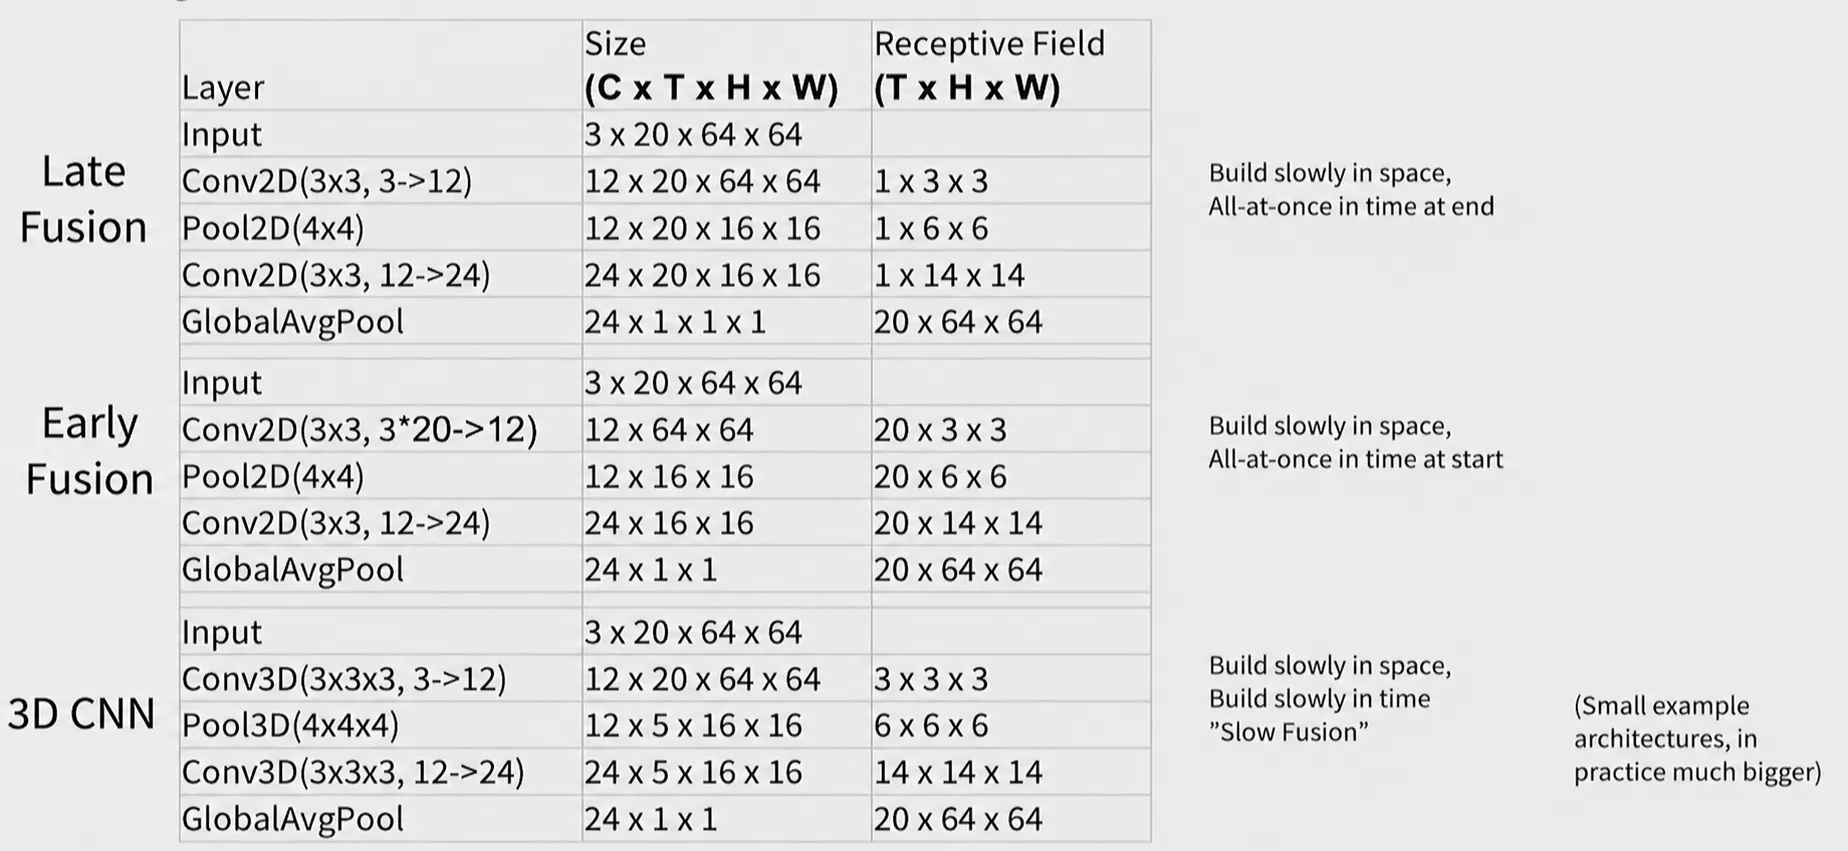
Fusion 방식을 비교하기 위해 다음 toy input을 생각해 보자.
각 방식의 receptive field 확장은 다음처럼 이해할 수 있다.
- Late fusion은 2D convolution으로 spatial receptive field만 키우며 temporal length 20을 유지하다가, 마지막 global pooling에서 시간 축 전체를 한 번에 합친다.
- Early fusion은 첫 layer에서 을 channel처럼 취급해 temporal receptive field를 1에서 20으로 즉시 키우고, 이후에는 spatial receptive field만 확장한다.
- 3D CNN은 3D convolution과 pooling으로 spatial receptive field와 temporal receptive field를 여러 layer에 걸쳐 함께 키운다.
즉 early fusion과 3D CNN 모두 frame 여러 장을 보지만, weight sharing 방식이 다르다. 3D CNN은 local temporal kernel을 sliding하므로 시간 이동에 대해 더 효율적인 representation을 만든다.
C3D와 3D CNN의 계산 비용
C3D는 VGG와 비슷한 구조의 layer를 3D로 확장한 초기 video model이다. 주로 convolution과 pooling을 사용하고, Sports-1M에서 pretraining한 feature extractor가 널리 사용되었다.
3D convolution은 spatial dimension뿐 아니라 temporal dimension에서도 kernel을 이동하므로 계산량이 크다. 한 번의 forward pass 계산량을 비교하면 다음과 같다.
| Model | 계산량 |
|---|---|
| AlexNet | |
| VGG-16 | |
| C3D |
C3D는 VGG-16의 약 배 계산량을 사용한다. Video architecture에서는 accuracy뿐 아니라 clip length, resolution, sampling 수, GFLOPs까지 함께 비교해야 한다.
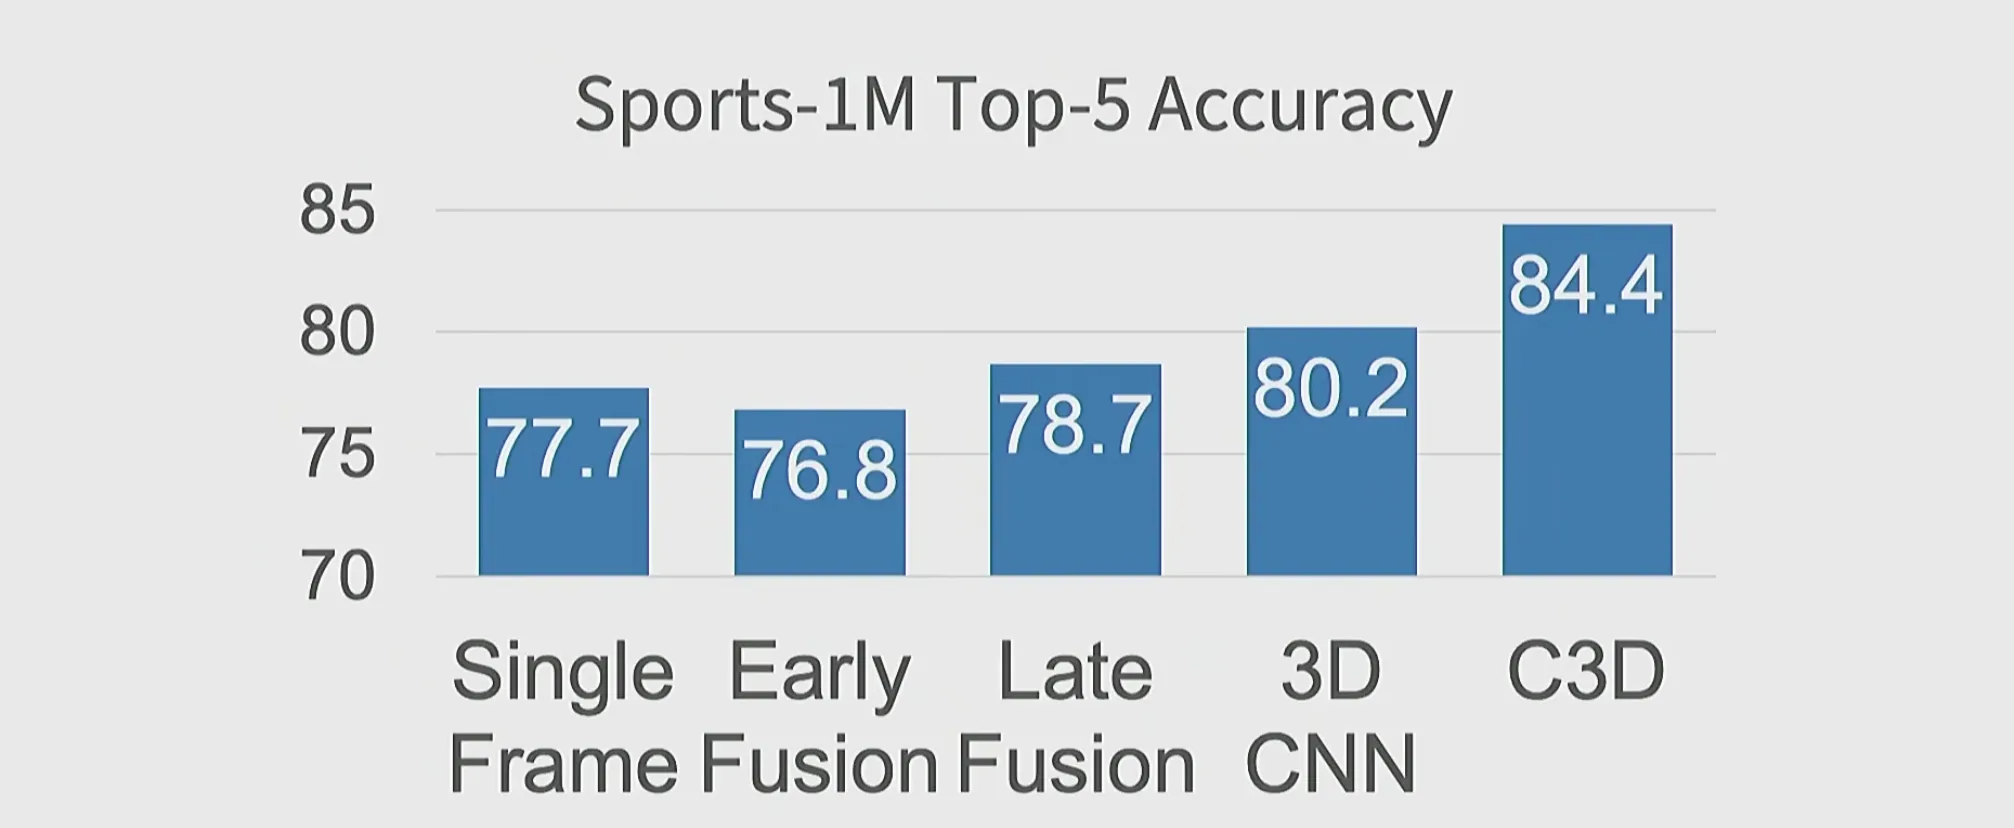
C3D (Tran et al., 2015)
Appearance와 motion은 서로 다른 정보이다
Action은 appearance만으로 판단할 수 있는 경우도 있지만, motion 자체가 더 직접적인 단서가 되기도 한다. 사람의 관절 위치를 점으로만 표시해 texture와 background를 제거해도 sitting 같은 action을 알아볼 수 있다는 예가 이를 보여준다.
Appearance stream은 object, background, scene을 잘 표현한다. Motion stream은 위치가 시간에 따라 어떻게 변하는지를 표현한다. 두 정보의 inductive bias가 다르므로 separate network로 처리한 뒤 합치는 two-stream architecture가 제안되었다.
Optical flow
Optical flow는 인접한 두 frame 사이에서 각 pixel이 어디로 이동했는지 나타내는 2차원 vector field이다.
와 는 각각 horizontal displacement와 vertical displacement이다. 기본적인 brightness constancy 가정은 같은 물체의 pixel intensity가 이동 전후에 크게 변하지 않는다는 것이다.
이 식만으로는 한 pixel의 두 displacement를 유일하게 정할 수 없으므로 실제 optical flow algorithm은 주변 motion의 smoothness 같은 추가 가정을 사용한다.
Optical flow는 RGB appearance를 직접 담기보다 pixel의 horizontal·vertical motion을 명시적으로 표현한다. 따라서 background texture에 과도하게 의존하지 않고 action에 필요한 movement를 볼 수 있다.
Two-stream network
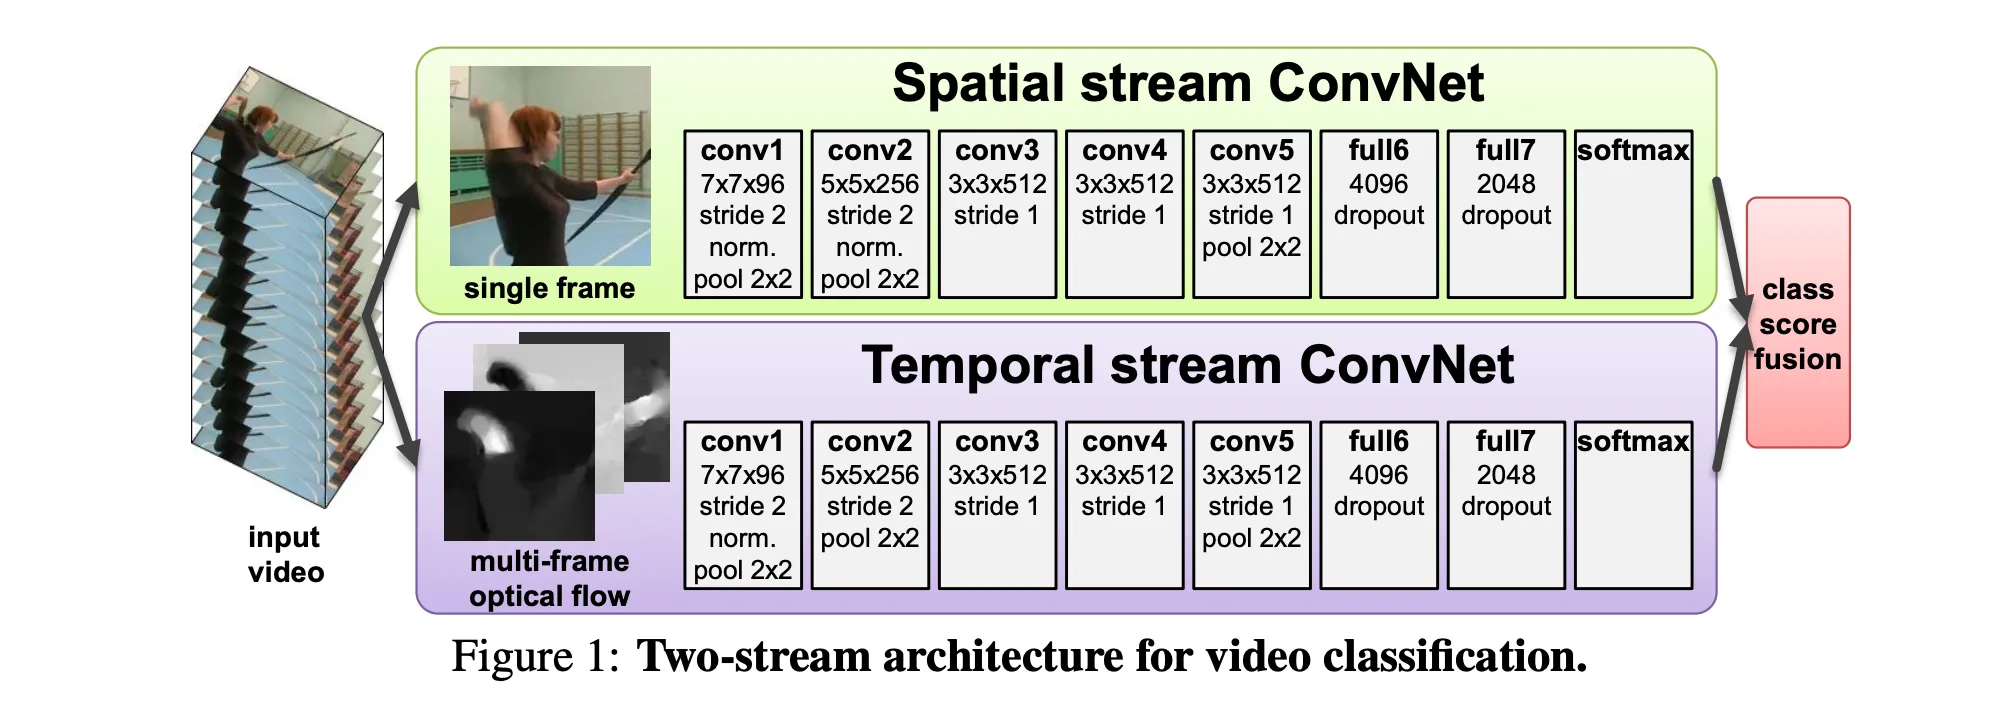
Two-stream network는 video를 spatial stream과 temporal stream으로 나눈다.
- Spatial stream은 RGB frame을 입력받아 appearance를 학습한다.
- Temporal stream은 연속 frame에서 계산한 optical flow의 map을 쌓아 motion을 학습한다.
- 두 stream의 class score를 평균하거나 결합해 최종 prediction을 만든다.
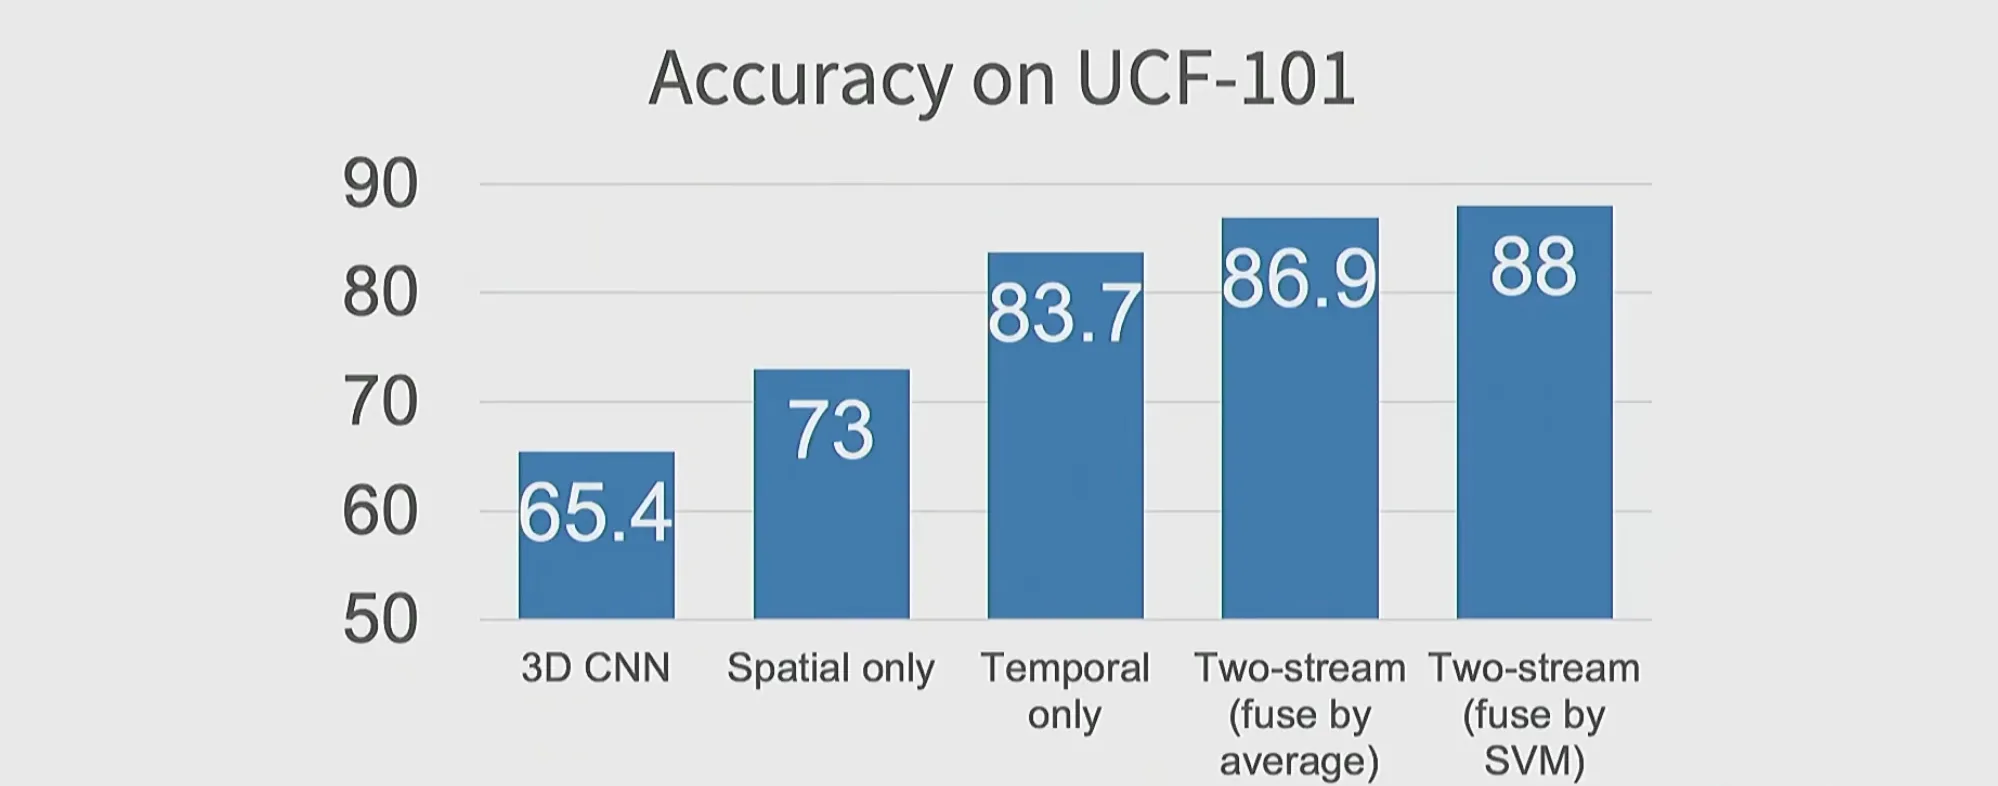
UCF-101은 101개의 action category를 가진 dataset이다. 초기 two-stream 실험에서는 temporal-only stream이 spatial-only stream보다 높은 성능을 보였으며, 두 stream을 결합하면 더 좋아졌다.
Motion stream은 정적인 scene/background 정보가 많이 제거되므로, action과 우연히 상관된 배경이나 appearance를 shortcut으로 학습하기 어렵다. 따라서 appearance stream보다 scene bias와 background overfitting이 적을 수 있다.
Optical flow를 미리 계산해야 한다는 점은 two-stream network의 큰 비용이다. Flow 추정 자체가 별도의 computation을 요구하며, end-to-end video model과 분리될 수 있다.
%% title: Two-Stream Video Network
%% caption: RGB stream은 물체와 배경의 appearance를 보고, optical-flow stream은 frame 사이 motion을 본 뒤 두 예측을 합친다.
flowchart LR
    video["Video Clip"] --> rgb["RGB Frames"]
    video --> flowcalc["Optical Flow<br/>(u, v)"]
    rgb --> spatial["Spatial CNN<br/>Appearance"]
    flowcalc --> temporal["Temporal CNN<br/>Motion"]
    spatial --> fuse["Score or Feature Fusion"]
    temporal --> fuse
    fuse --> action["Action Class"]
Long-term temporal structure
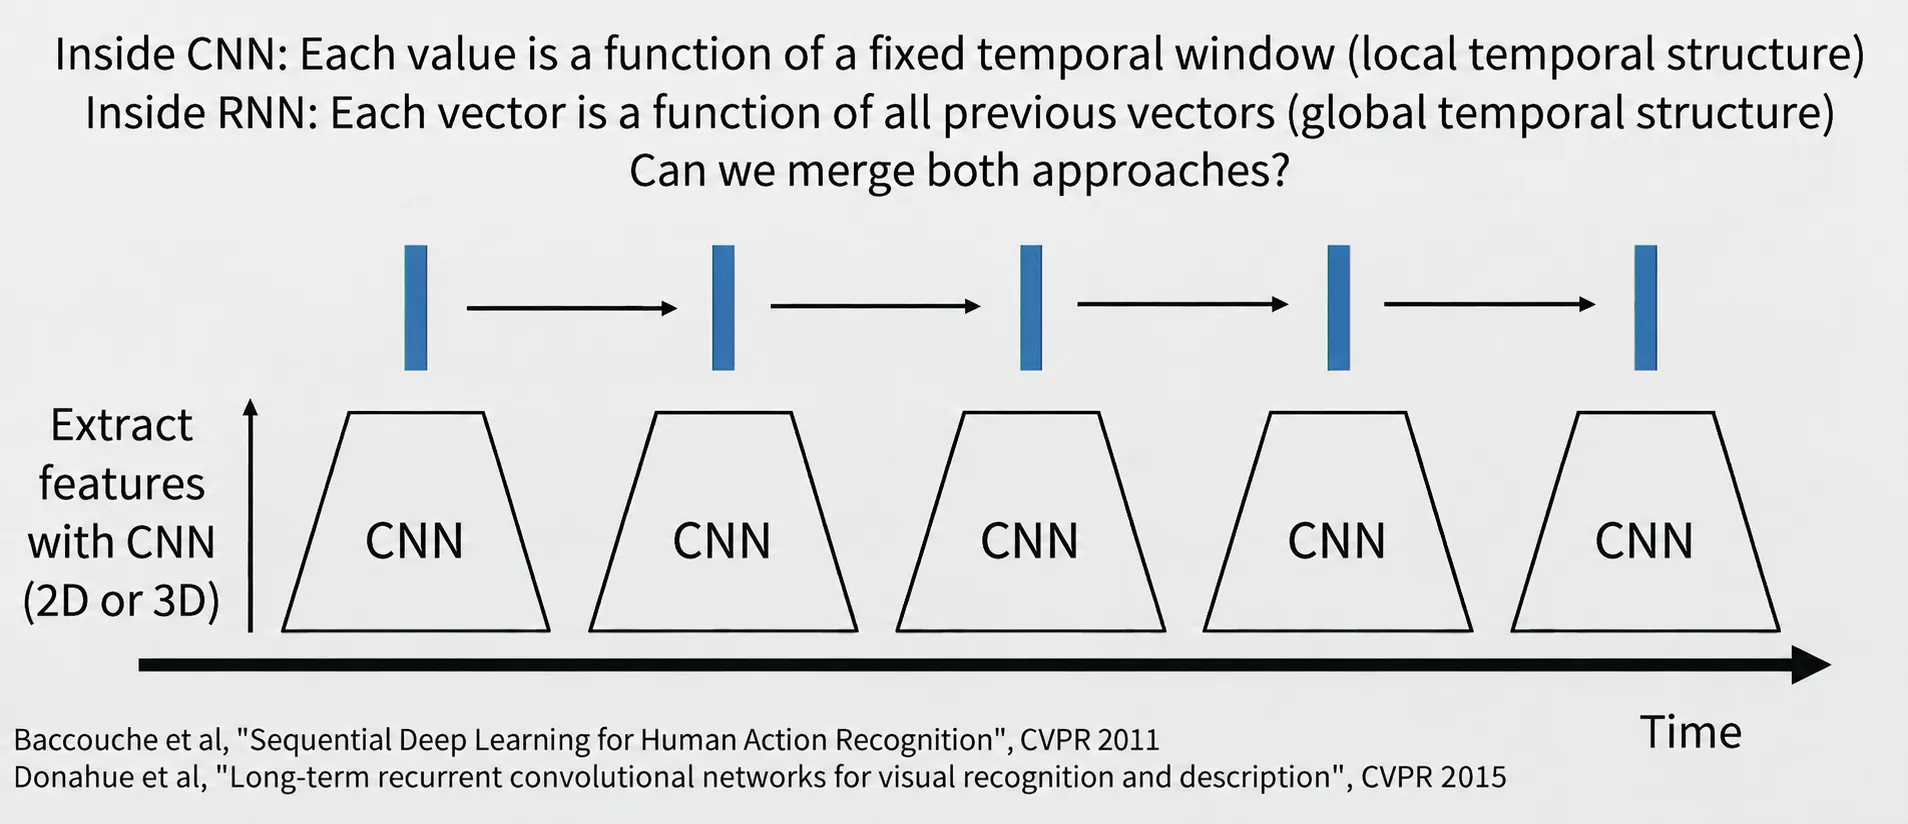
3D CNN은 고정 길이 clip 안의 local motion을 잘 표현하지만 긴 video 전체의 순서를 직접 다루기에는 input size가 크다. 한 가지 방법은 frame 또는 clip마다 CNN feature를 만들고 그 sequence를 RNN이나 LSTM에 입력하는 것이다.
Video-level classification은 마지막 hidden state 또는 모든 state를 pooling한 representation으로 수행할 수 있다.
이는 sequence 전체에서 하나의 label을 내는 many-to-one 구조이다. Frame마다 prediction이 필요한 경우에는 각 에서 output을 만드는 many-to-many 구조를 사용한다.
CNN과 RNN을 모두 포함한 긴 model을 처음부터 end-to-end로 학습하면 memory와 gradient propagation 부담이 크다. 초기 접근에서는 image 또는 short clip으로 pretrained CNN을 feature extractor로 고정하고 recurrent part를 별도로 학습하기도 하였다.
Convolutional recurrent network
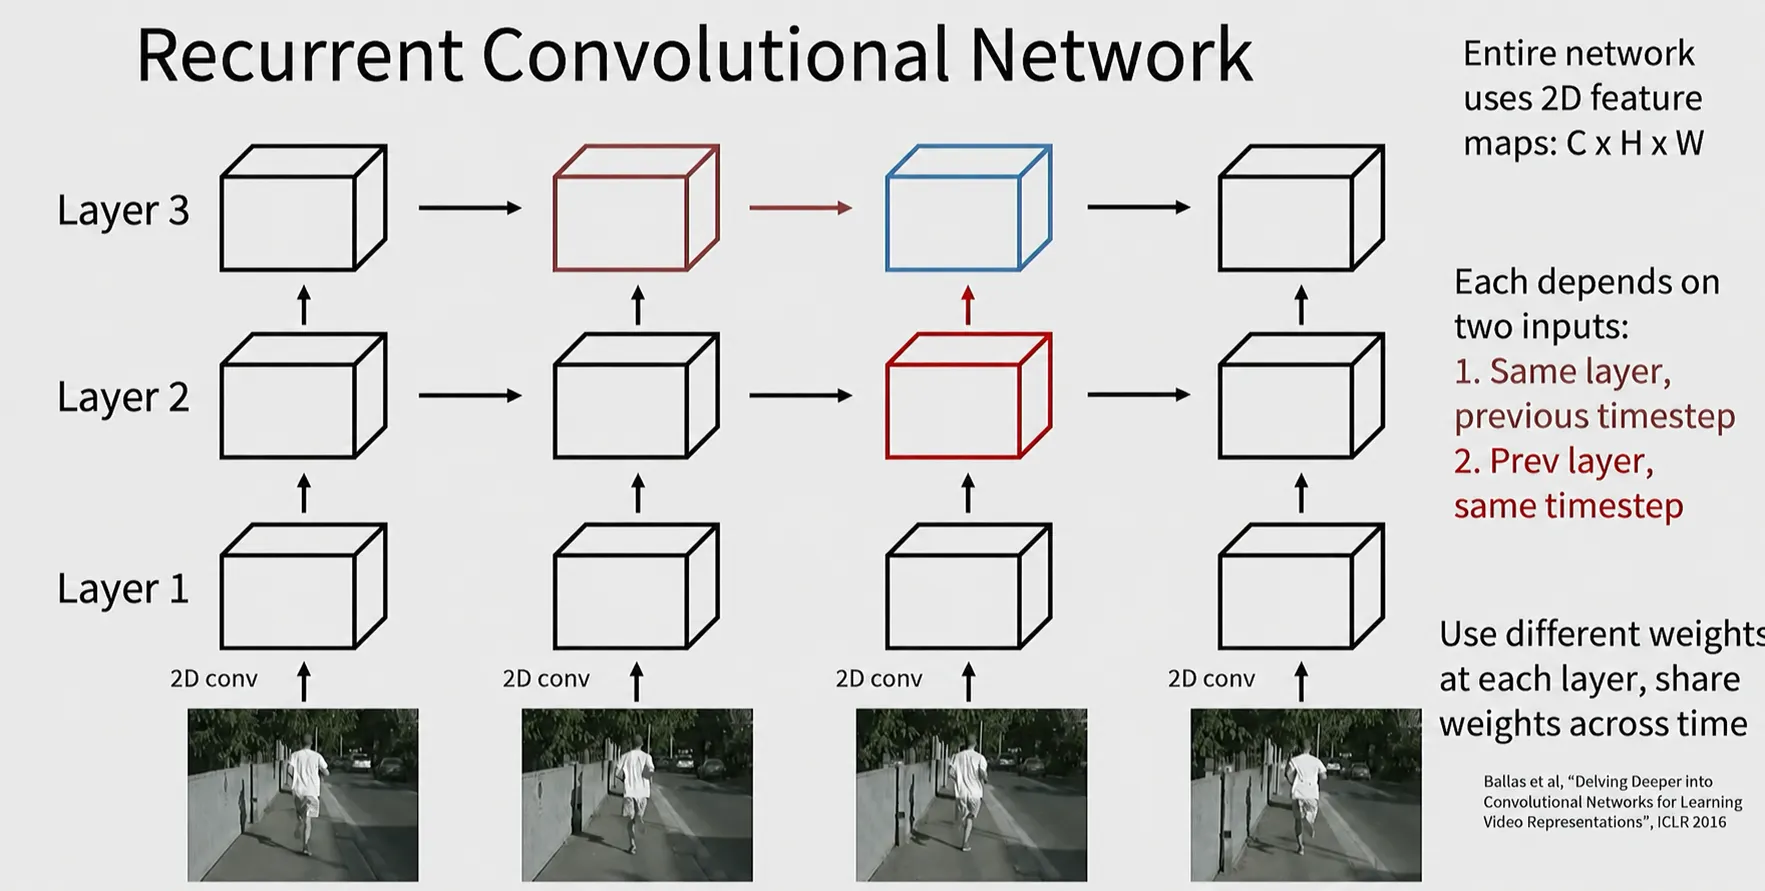
일반 RNN은 hidden state를 vector로 표현한다. Convolutional RNN은 spatial feature map을 hidden state로 유지하고 matrix multiplication을 convolution으로 바꾼다.
는 2D convolution이다. 는 layer 의 time step 에 해당하는 spatial hidden state이다.
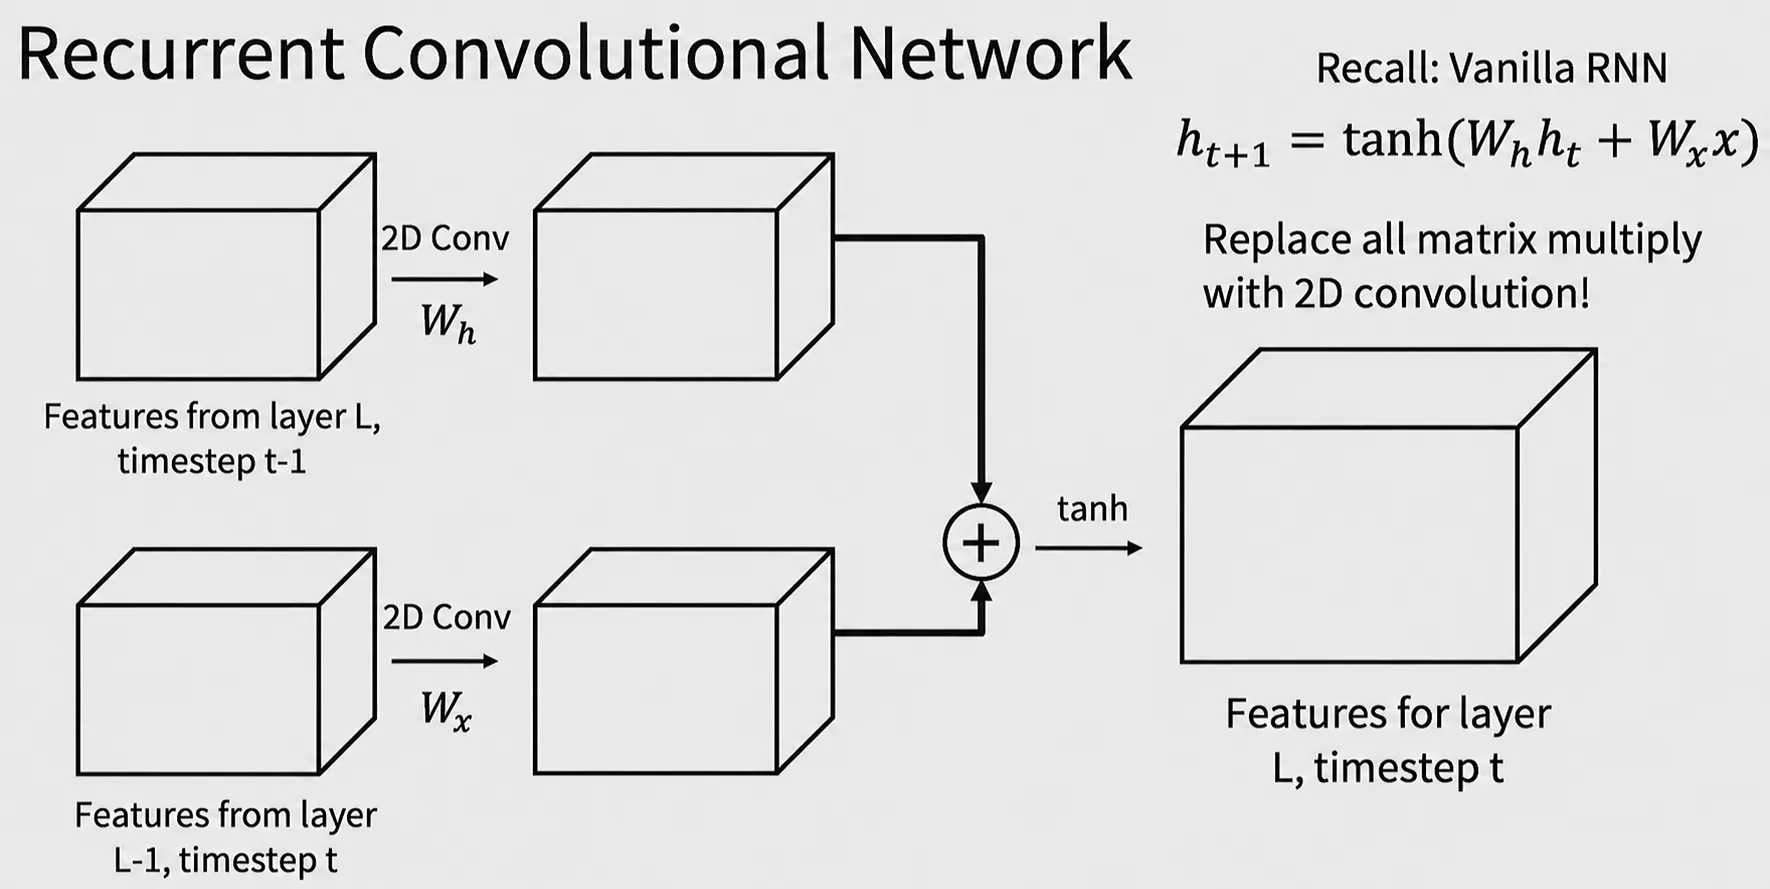
현재 state는 다음 두 정보를 함께 받는다.
- 같은 layer의 이전 time step인
- 이전 layer의 같은 time step인
이 구조는 spatial layout을 유지하면서 temporal recurrence를 만들며, 같은 원리를 ConvGRU나 ConvLSTM에도 적용할 수 있다. 하지만 time step을 순차적으로 계산해야 하므로 긴 video에서 parallelization이 어렵다.
직관적으로, CNN이 각 시점의 영상에서 특징을 뽑고, 각 층은 현재 시점의 아래 층 특징과 이전 시점의 같은 층 특징을 함께 받아 시간에 따른 정보를 이어간다.
Space-time self-attention과 non-local block
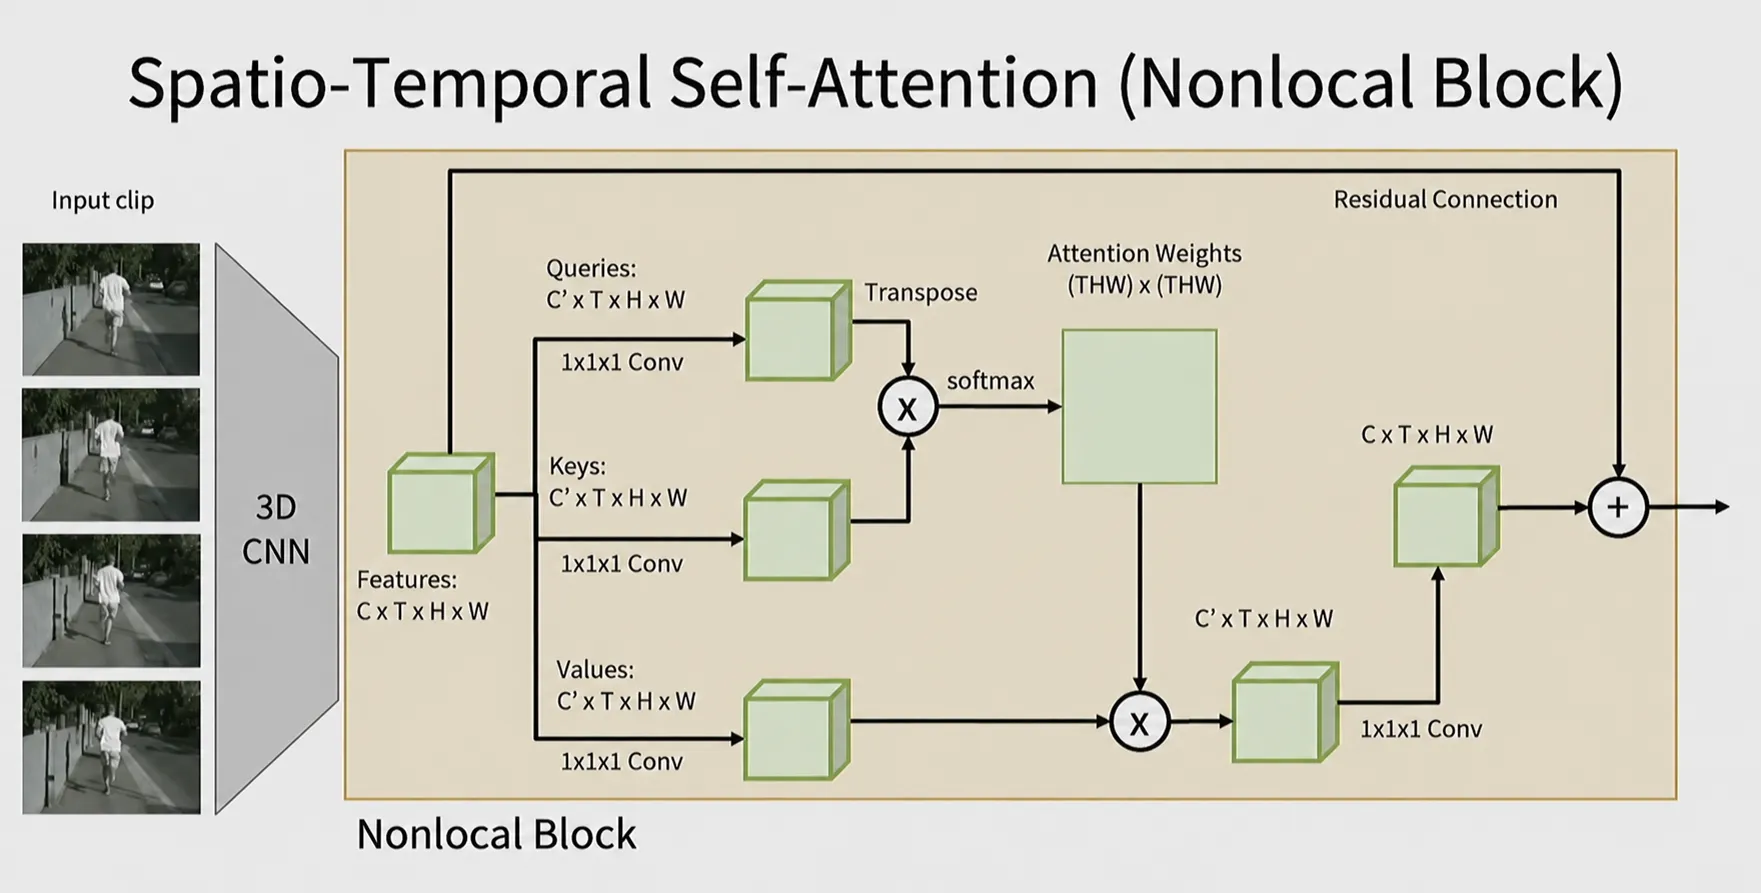
Nonlocal Block은 각 위치가 주변 영역만 보는 convolution과 달리, 전체 시공간 위치와의 관계를 계산해 멀리 떨어진 정보까지 직접 모으는 구조이다.
Self-attention은 멀리 떨어진 두 위치를 한 layer에서 직접 연결할 수 있고 모든 token을 병렬로 처리할 수 있다. Video feature map을 다음과 같이 얻었다고 하자.
위치를 flatten하면 token 수는 다음과 같다.
convolution으로 channel을 projection해 query, key, value를 만든다.
Space-time attention은 다음과 같이 계산한다.
는 서로 다른 시간과 공간 위치 사이의 관계를 나타낸다. Output을 다시 shape로 바꾸고 projection한 뒤 residual connection으로 input에 더할 수 있다.
3D CNN의 local kernel과 달리 non-local block은 한 번에 전체 space-time 위치를 연결한다.
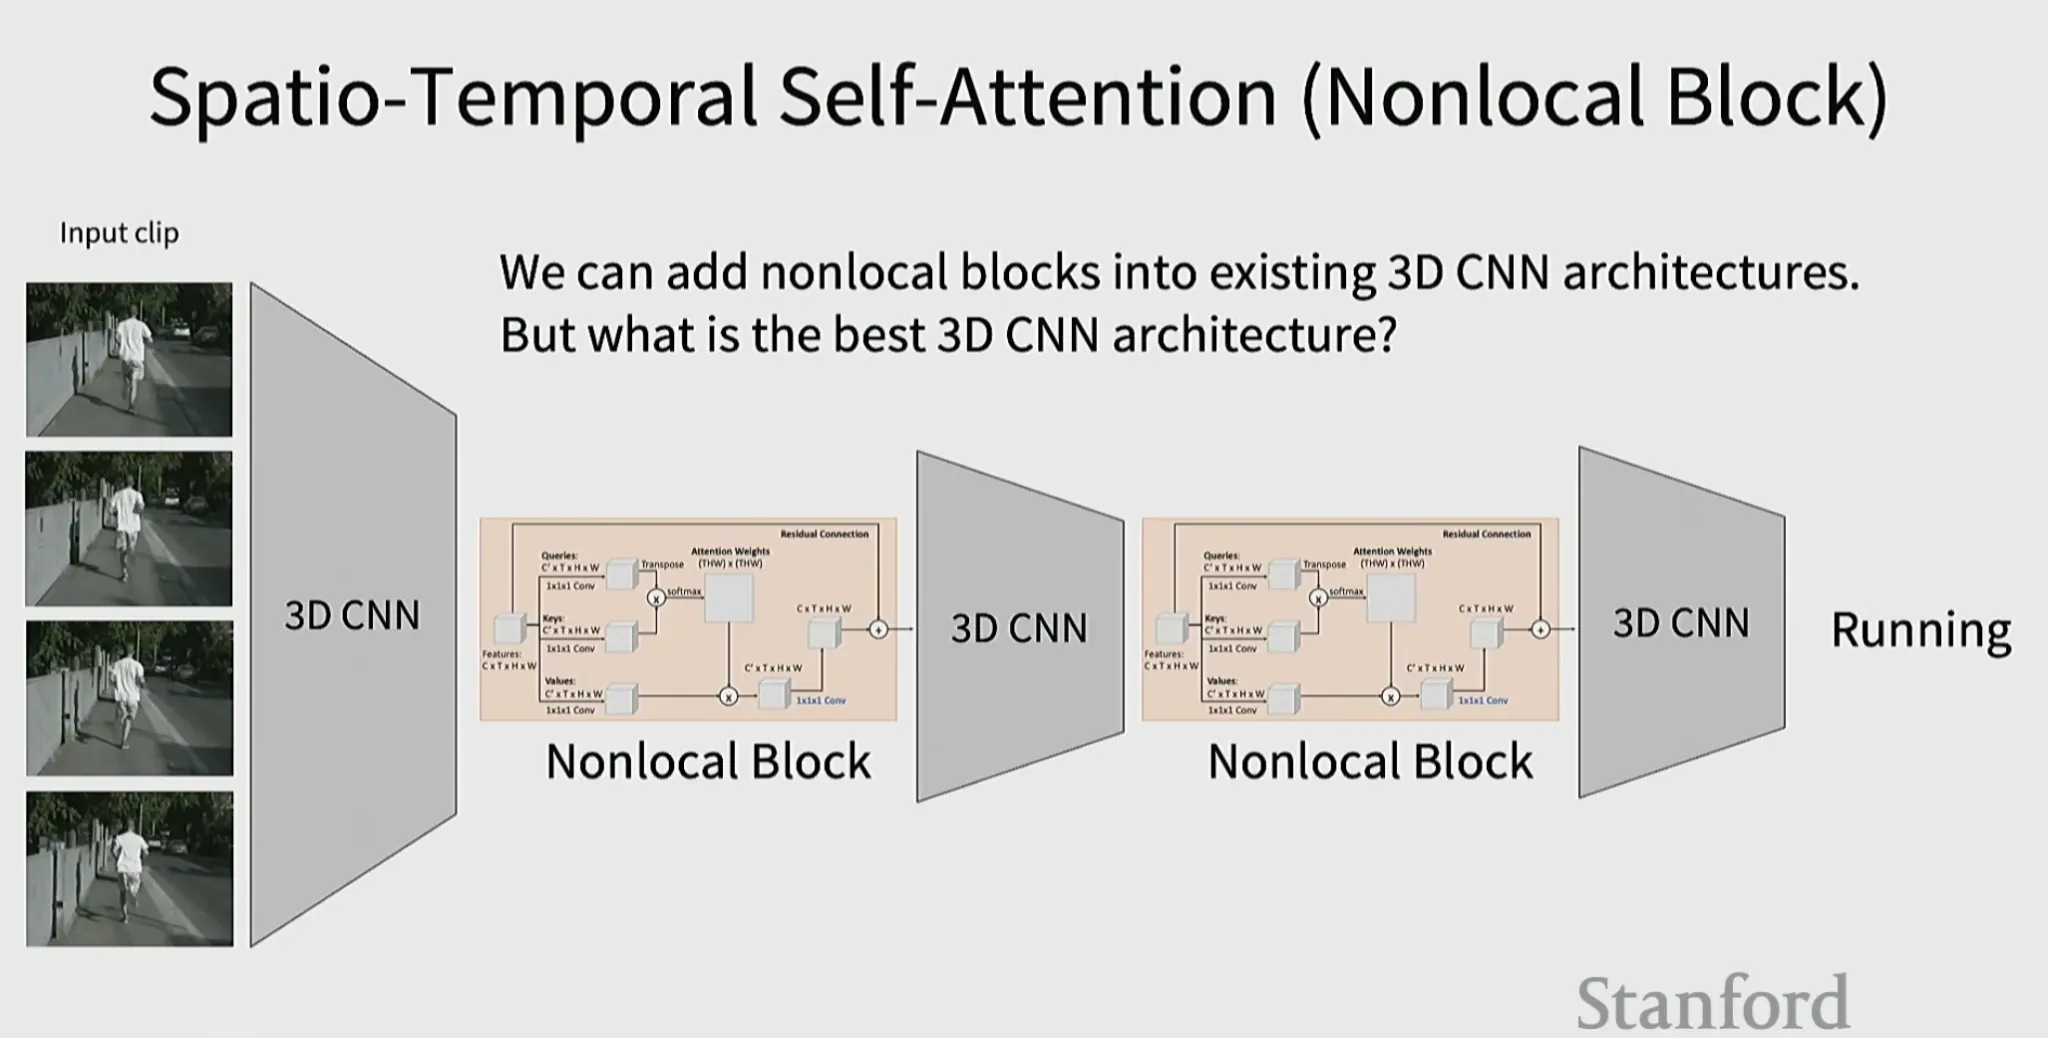
기존 3D CNN 사이에 독립적인 block으로 삽입할 수도 있다.
다만 full attention의 memory와 computation은 token 수의 제곱에 비례한다.
고해상도와 긴 clip에서는 비용이 매우 커지므로 spatial attention과 temporal attention을 분리하는 factorized attention이나 token 수를 줄이는 방법을 사용한다.
I3D: 2D CNN을 3D로 inflate하기
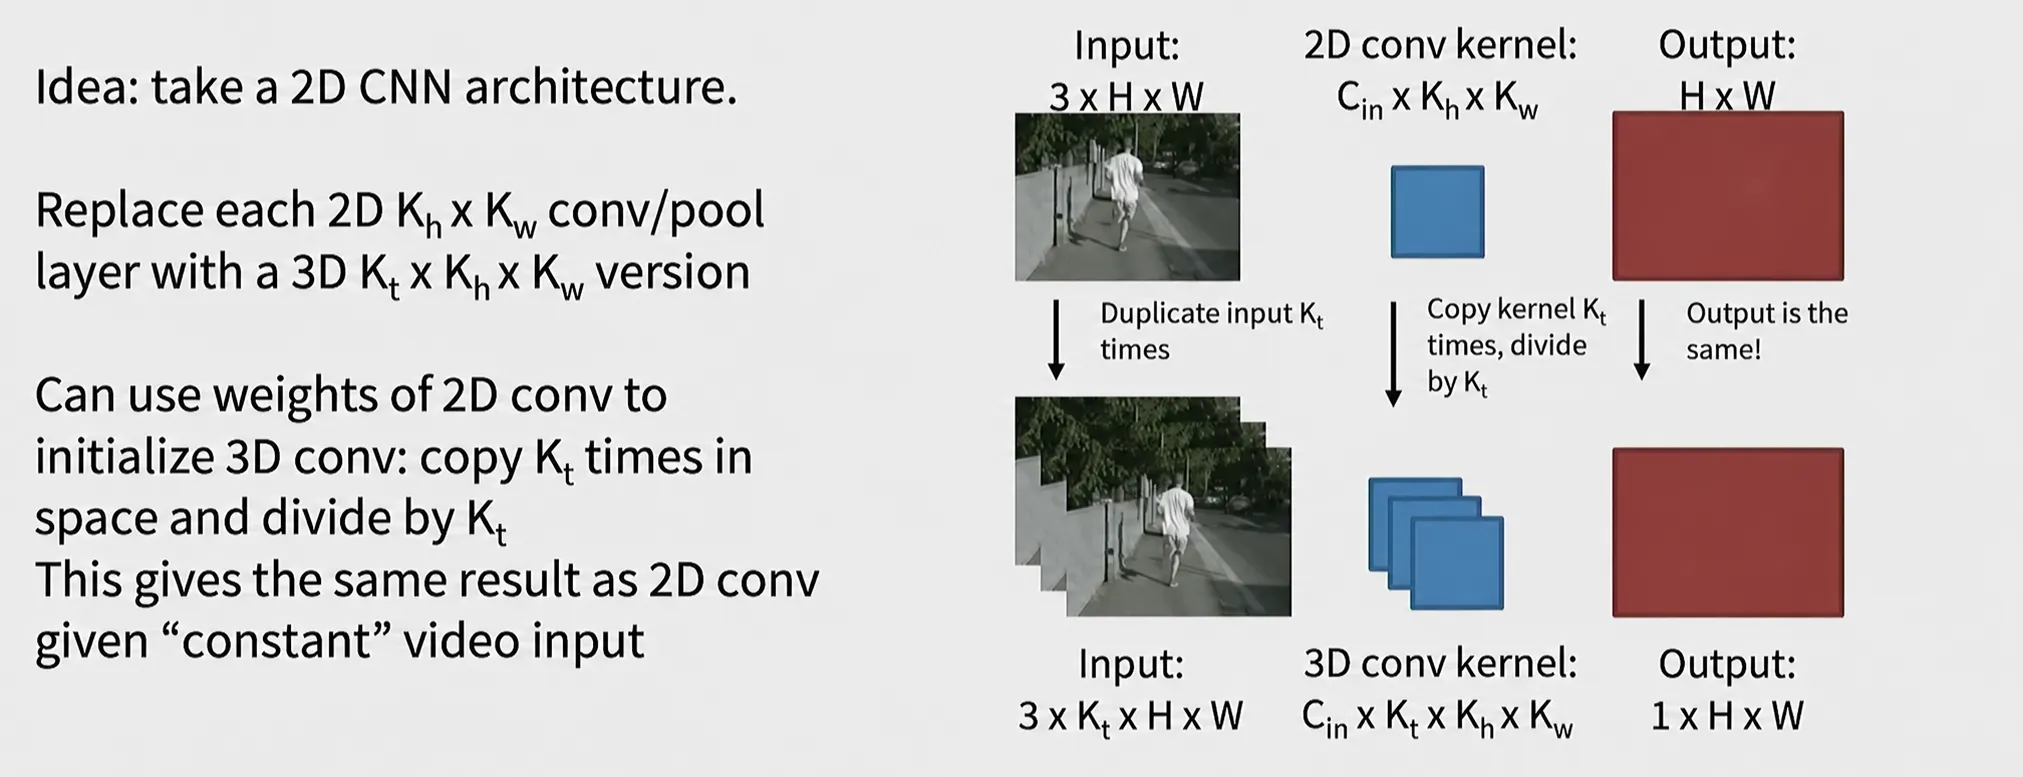
I3D는 검증된 2D CNN architecture와 pretrained weight를 video model로 재사용하는 방법이다. 의 2D convolution을 의 3D convolution으로 바꾼다.
2D kernel을 라고 하면 temporal axis로 번 복사하고 각 slice를 로 나눈다.
같은 image가 frame 동안 반복되는 constant video라면 각 temporal slice의 contribution이 합쳐져 원래 2D convolution과 같은 output을 만든다.
따라서 image-pretrained weight를 합리적인 초기값으로 사용할 수 있고, 이후 video data에서 fine-tuning한다. Architecture뿐 아니라 2D representation까지 transfer한다는 점이 핵심이다. I3D를 RGB appearance stream과 optical-flow stream 모두에 적용할 수도 있다.
%% title: I3D의 2D Filter Inflation
%% caption: ImageNet으로 학습한 2D spatial filter를 시간 축으로 복제하고 크기를 조정해, 초기에는 static image CNN과 비슷한 응답을 내는 3D filter로 확장한다.
flowchart LR
    w2d["Pretrained 2D Filter<br/>K_h × K_w"] --> repeat["Repeat along Time<br/>K_t slices"]
    repeat --> scale["Scale by 1 / Kₜ"]
    scale --> w3d["Inflated 3D Filter<br/>K_t × K_h × K_w"]
    frames["Video Clip"] --> i3d["I3D Network"]
    w3d --> i3d
    i3d --> features["Space-Time Features"]
    features --> prediction["Video Prediction"]
Video Transformer와 scalable pretraining
Video Transformer는 frame을 spatial patch와 temporal segment로 나누어 token sequence로 만들고 attention으로 관계를 학습한다. Full space-time attention은 비싸므로 다음과 같은 구조가 자주 사용된다.
- Spatial attention과 temporal attention을 별도로 수행하는 factorized attention
- 일부 token만 유지하거나 coarse-to-fine하게 처리하는 efficient attention
- Masked video token을 복원하는 masked autoencoder pretraining
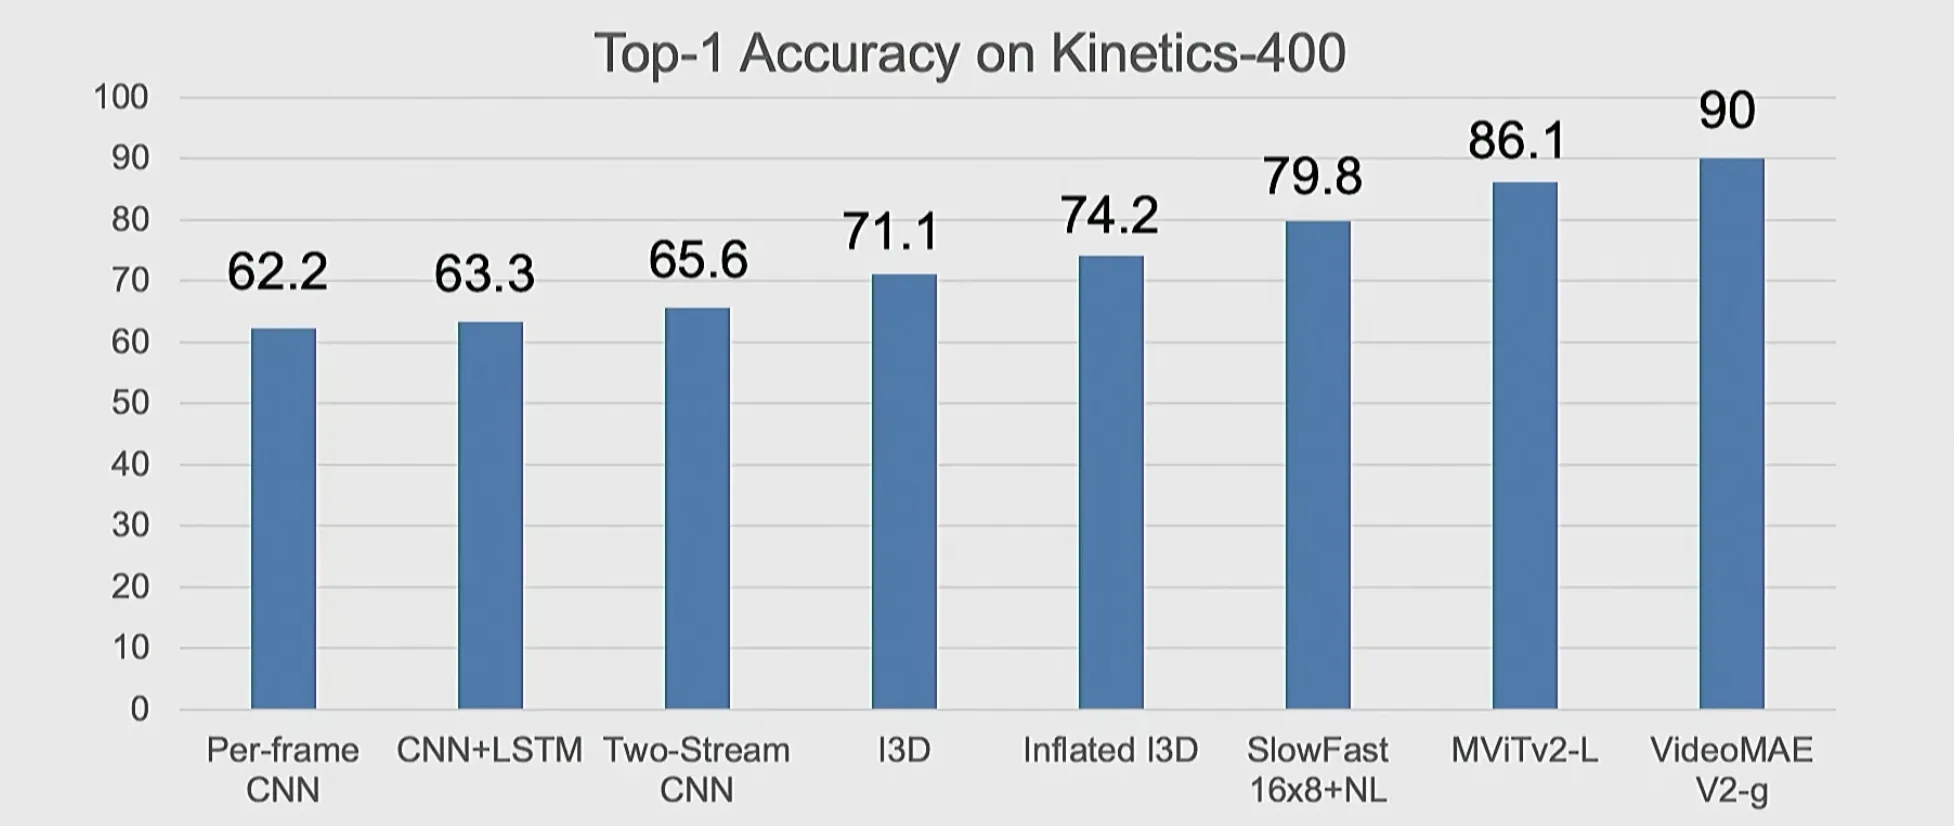
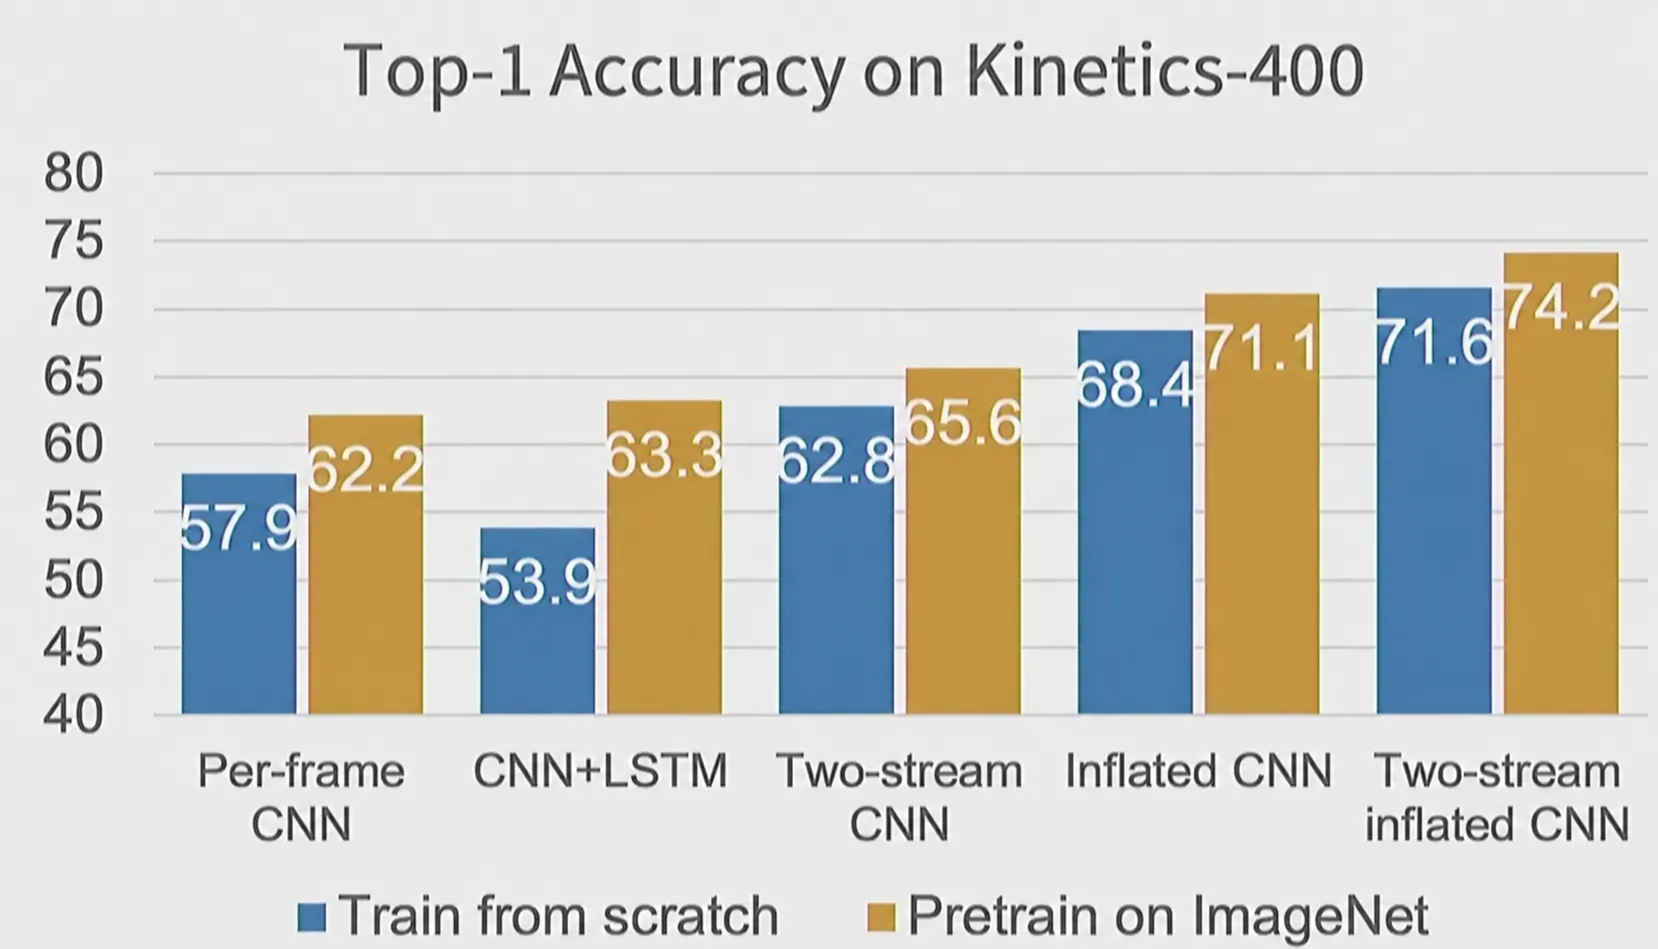
Kinetics-400의 성능 흐름을 보면 single-frame baseline의 약 에서 이후 video encoder의 약 수준까지 발전하였다. Dataset, view sampling, pretraining에 따라 수치의 의미가 달라지므로 architecture만 보고 직접 비교하면 안 된다.
Video model visualization
Activation maximization
Activation maximization은 특정 뉴런이나 convolution filter가 어떤 입력에 가장 강하게 반응하는지를 시각화하는 방법이다.
먼저 random noise에서 시작한 뒤, 관심 있는 filter의 activation을 계산한다. 이후 입력 이미지나 영상을 gradient ascent로 조금씩 수정해서 해당 activation이 더 커지도록 만든다. 이 과정을 반복하면 결과적으로 그 filter가 가장 선호하는 입력 패턴을 얻을 수 있다.
여기서 는 입력 에 대한 특정 unit 의 activation이고, 는 결과가 지나치게 noisy하거나 비현실적으로 변하는 것을 막기 위한 regularization이다.
과정은 다음과 같이 볼 수 있다.
random noise -> 특정 filter의 activation 계산 -> 입력을 gradient ascent로 수정 -> activation 증가 -> 반복 -> 해당 filter가 가장 강하게 반응하는 입력 획득
실제 영상에서 중요한 부분을 찾는 방식이라기보단 모델에게 직접 어떤 입력을 보여주면 이 unit이 가장 좋아하는지를 역으로 물어보는 방식이다.
Image classifier에서 특정 class score를 높이는 input을 gradient ascent로 찾듯이 video model에도 activation maximization을 적용할 수 있다.
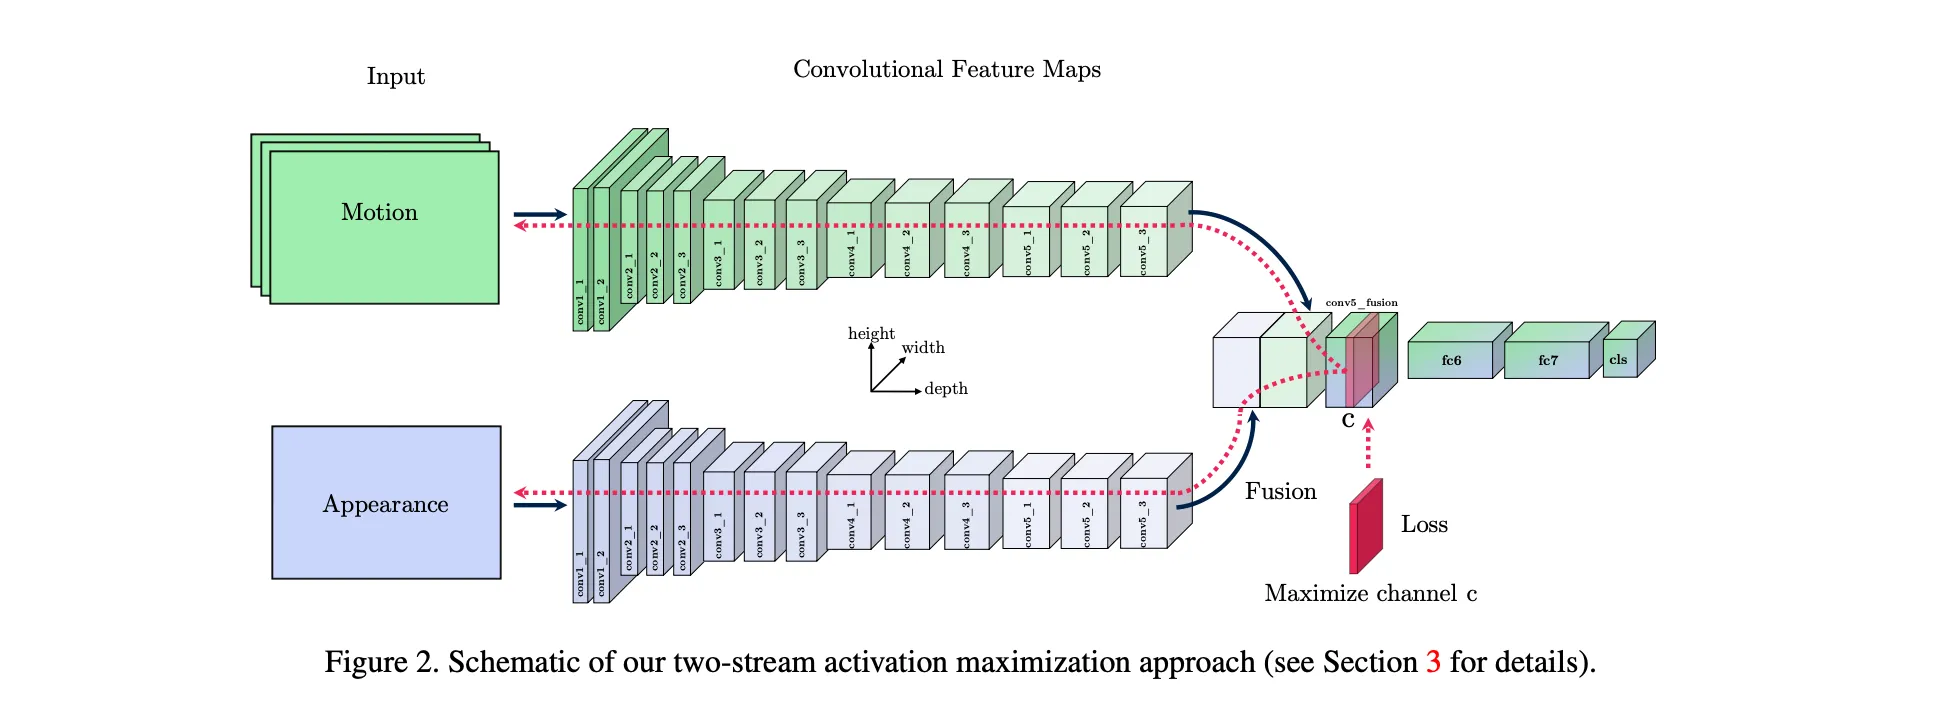
Class 의 score를 라고 하면 input video를 다음 방향으로 갱신한다.
Two-stream model에서는 appearance input과 optical-flow input을 각각 최적화할 수 있다. Flow가 시간에 따라 지나치게 불규칙하게 변하지 않도록 temporal smoothness constraint를 추가하면 model이 선호하는 motion pattern을 더 분명하게 볼 수 있다.
CleanAndJerk unit 시각화
이 그림은 마지막 분류층에서 CleanAndJerk class에 강하게 반응하는 unit이 어떤 appearance와 motion pattern을 선호하는지를 activation maximization으로 시각화한 결과이다. 첫 번째 열은 appearance를, 가운데 네 열은 서로 다른 temporal variation regularization 값에서 얻은 motion pattern을, 마지막 열은 실제 test video의 예시를 보여준다.
appearance
appearance column은 이 unit이 역도 동작을 인식할 때 선호하는 정적인 시각 패턴을 보여준다. 바벨의 원판과 막대, 그리고 이를 다루는 사람의 형태가 추상적으로 나타난다.
즉 이 unit은 단순한 사람 모양만 보는 것이 아니라, 역도 장비와 사람의 조합 같은 appearance cue에도 반응한다고 볼 수 있다.
은 시간에 따른 변화에 가장 강한 제약을 둔 경우이다. 그래서 motion pattern이 비교적 천천히, 부드럽게 변하며, 바벨을 들고 균형을 잡거나 준비하는 동작처럼 보인다.
이 경우에는 빠른 폭발적 동작보다는 안정적이고 지속적인 motion structure가 강조된다.
에서는 시간 변화 제약이 다소 완화된다. 여전히 전체적인 구조는 유지되지만, motion이 조금 더 뚜렷해지고 동작의 진행 방향이 더 분명하게 드러난다.
즉 느린 preparation 단계와 실제 lift 사이의 중간적인 temporal pattern으로 볼 수 있다.
에서는 motion이 더 자유롭게 변한다. 바벨과 사람의 상호작용이 더 강하게 드러나고, 들어 올리는 동작의 역동성이 커진다.
이 단계에서는 정적인 자세보다 동작의 전개 자체가 더 중요하게 반영된다.
은 temporal regularization이 사실상 없는 경우이다. 따라서 가장 빠르고 큰 motion variation이 허용되며, 바벨을 빠르게 위로 밀어 올리는 폭발적인 움직임이 나타난다.
이 결과는 같은 unit이 느린 균형 동작뿐 아니라, 역도의 핵심인 빠른 overhead lift motion에도 강하게 반응한다는 점을 보여준다.
test video
마지막 열은 test set에서 해당 class의 실제 video 예시이다. 앞의 시각화 결과와 비교하면, 이 unit이 바벨의 appearance와 사람의 body motion을 함께 이용해 CleanAndJerk를 표현하고 있음을 확인할 수 있다.
이 unit은 특정 한 자세만 외우는 것이 아니라 역도 동작을 구성하는 정적 cue와 동적 cue를 함께 활용하는 방향으로 학습된 것으로 볼 수 있다.
weightliftingclass를 시각화한 예에서는 motion stream에서 bar가 흔들리는 움직임과 머리 위로 밀어 올리는 움직임이 나타났다. 이는 model이 background만 외운 것이 아니라 action에 필요한 temporal cue도 사용하고 있음을 확인하는 방법이다.
Temporal action localization
Clip classification은 clip 전체에 하나의 action label을 부여한다. 긴 video에서는 action이 언제 시작하고 끝나는지도 찾아야 한다.
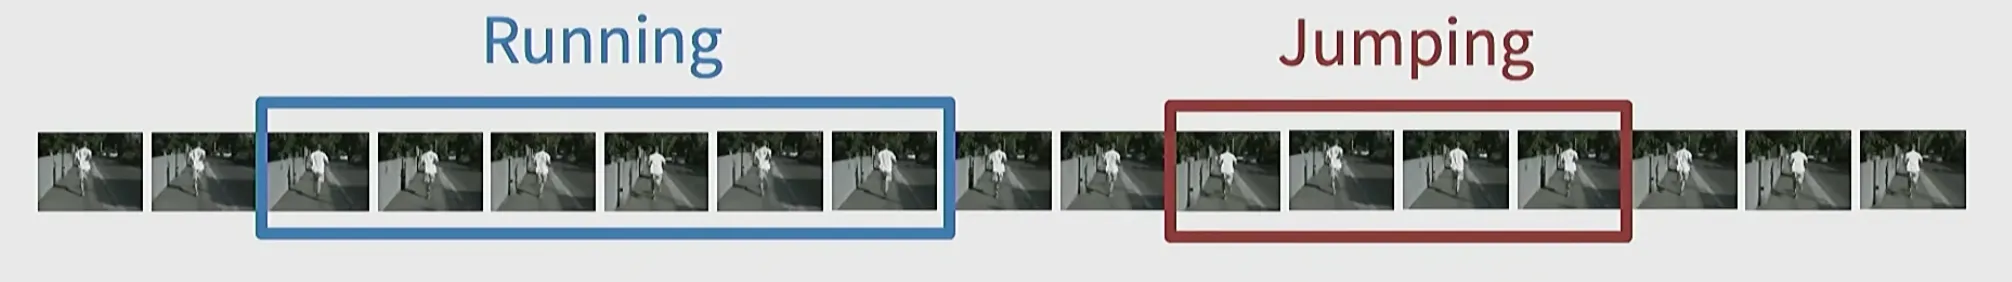
Temporal action localization은 긴 영상 안에서 특정 action이 언제 시작하고 언제 끝나는지를 찾아내고, 그 action의 종류까지 분류하는 문제이다.
Temporal action localization의 prediction은 다음과 같다.
와 는 action segment의 경계이고, 는 class, 는 confidence score이다. Object detection의 bounding box 대신 time interval을 예측한다고 볼 수 있다.
Faster R-CNN과 비슷하게 temporal proposal을 생성하고 각 proposal의 class와 boundary를 보정할 수 있다. Evaluation에는 spatial IoU와 같은 형태의 temporal IoU를 사용한다.
Spatiotemporal action detection은 여기서 한 단계 더 나아가 action의 시간 구간뿐 아니라 각 frame에서 사람이 있는 spatial region까지 함께 찾는다. Output은 시간에 따라 이어지는 bounding box인 tube 형태가 된다.
Audio-visual video understanding
Video에는 RGB frame과 motion 외에도 audio가 포함된다. 웃음소리나 짖는 소리는 visual ambiguity를 줄이고 event와 emotion을 이해하는 단서가 된다.
대표적인 multimodal task는 visually guided audio source separation이다. 여러 source가 섞인 audio 에서 visual object나 speaker feature를 조건으로 각 source를 분리한다.
는 번째 speaker나 instrument의 visual feature이다. 사람의 입 움직임이나 악기의 움직임을 audio spectrum과 연결하면 특정 speaker 또는 instrument의 소리를 분리할 수 있다.
Audio-visual Transformer는 video patch와 audio spectrogram patch를 함께 token으로 만들어 cross-modal relation을 학습할 수 있다. 두 modality에서 일부 patch를 가리고 복원하는 masked autoencoder 방식도 사용할 수 있다.
Efficient, egocentric, and foundation video models
긴 video의 모든 clip과 modality를 처리할 필요는 없다. Efficient video understanding은 다음 선택 자체를 학습 대상으로 삼는다.
- 어떤 clip이 prediction에 중요한가?
- 몇 개의 clip을 처리할 것인가?
- RGB, optical flow, audio 중 어떤 modality를 사용할 것인가?
- Low-resolution preview 뒤 어느 구간을 high-resolution으로 볼 것인가?
Audio를 cheap preview signal로 사용해 중요한 순간을 찾고, 해당 clip에만 무거운 visual encoder를 적용할 수도 있다.
Egocentric video는 사용자의 시점에서 기록되므로 손-object interaction, 대화 상대, 누가 말하고 듣는지 같은 social interaction이 중요하다. Smart glasses에는 camera뿐 아니라 microphone array와 여러 sensor가 함께 들어갈 수 있어 multimodal modeling이 자연스럽다.
Video foundation model은 video를 token 또는 embedding으로 바꾸어 language model의 representation과 연결한다. 이를 통해 action classification뿐 아니라 video captioning, question answering, event retrieval처럼 text로 질의하고 응답하는 task로 확장할 수 있다.
Video architecture의 전체 흐름
| 방법 | Input representation | Temporal modeling | 주요 특징 |
|---|---|---|---|
| Single-frame CNN | Sampled RGB frame | Score 또는 feature 평균 | 단순하지만 강한 baseline |
| Late fusion | Frame별 high-level feature | 끝부분에서 concatenate/pooling | 저렴하지만 motion 손실 가능 |
| Early fusion | channel image | 첫 layer에서 전체 time 결합 | Low-level cue를 보지만 temporal sharing이 약함 |
| 3D CNN | RGB clip | Local 3D kernel을 계층적으로 쌓음 | Temporal shift invariance와 slow fusion |
| Two-stream network | RGB + optical flow | Appearance와 motion을 별도 학습 | Motion inductive bias가 명확함 |
| CNN-RNN | Frame/clip feature sequence | Recurrent hidden state | Long-term order를 표현하지만 순차 계산 필요 |
| Non-local/Transformer | Space-time token | Self-attention | Long-range relation과 parallelism, 높은 attention 비용 |
| Audio-visual model | Video + spectrogram | Cross-modal fusion | Visual ambiguity를 sound로 보완 |